Gemini 4 Neon과 Claude Opus 5.5의 코딩 성능과 비용 비교
같은 에디터와 각사의 에이전트에서 나온 공개 평가를 비교합니다. 통과한 패치당 비용을 기준으로 모델을 바꿀 조건을 정하세요.
 EvoLink Team제품 팀
목차
high부터 실행해 보세요. 이미 검증한 저장소 워크플로에는 Claude Opus 5.5를 비교 기준으로 두세요. Neon은 여러 파일을 수정하는 평가에서 경쟁력이 있고 표준 입출력 단가도 낮습니다. 바꾸기 전에 첫 시도 통과율, 검토 시간, 팀에서 쓰는 도구가 그대로 지원되는지 확인하세요. CursorBench 4.1 · Google API 요금 · Anthropic 요금실제 개발 환경에서 Gemini 4 Neon과 Claude Opus 5.5 비교하기
| 현재 환경 | 시험 방법 | 판단 기준 |
|---|---|---|
| 같은 에디터에서 두 모델 사용 가능 | 에디터, 도구, 리뷰 흐름을 고정하고 모델만 변경 | 통과한 패치, 총비용, 리뷰어 개입 |
| 팀에서 Claude Code를 많이 사용 | Claude Code와 Opus, Antigravity와 Neon 전체 구성을 비교 | 저장소 지침 준수, 권한, 업무 인계 |
| 애플리케이션에서 API를 사용 | 같은 작업, 승인된 도구, 검증 절차를 적용 | 올바른 도구 호출, 유효한 패치, 실패 복구 |
| 드물고 위험한 마이그레이션을 처리 | Neon으로 이전 작업을 재실행하거나 별도 브랜치에서 시험 | 호환성 검사와 수작업 수정량 |
두 코딩 평가는 각각 무엇을 측정할까
xhigh는 59점과 작업당 6.86달러, Claude Code의 Opus 5.5 max는 58점과 12.61달러였습니다. 반올림한 점수이며 모델과 도구 조합 전체의 결과입니다. CursorBench 4.1은 같은 에디터 환경에서 다른 비교를 제공합니다. Artificial Analysis 평가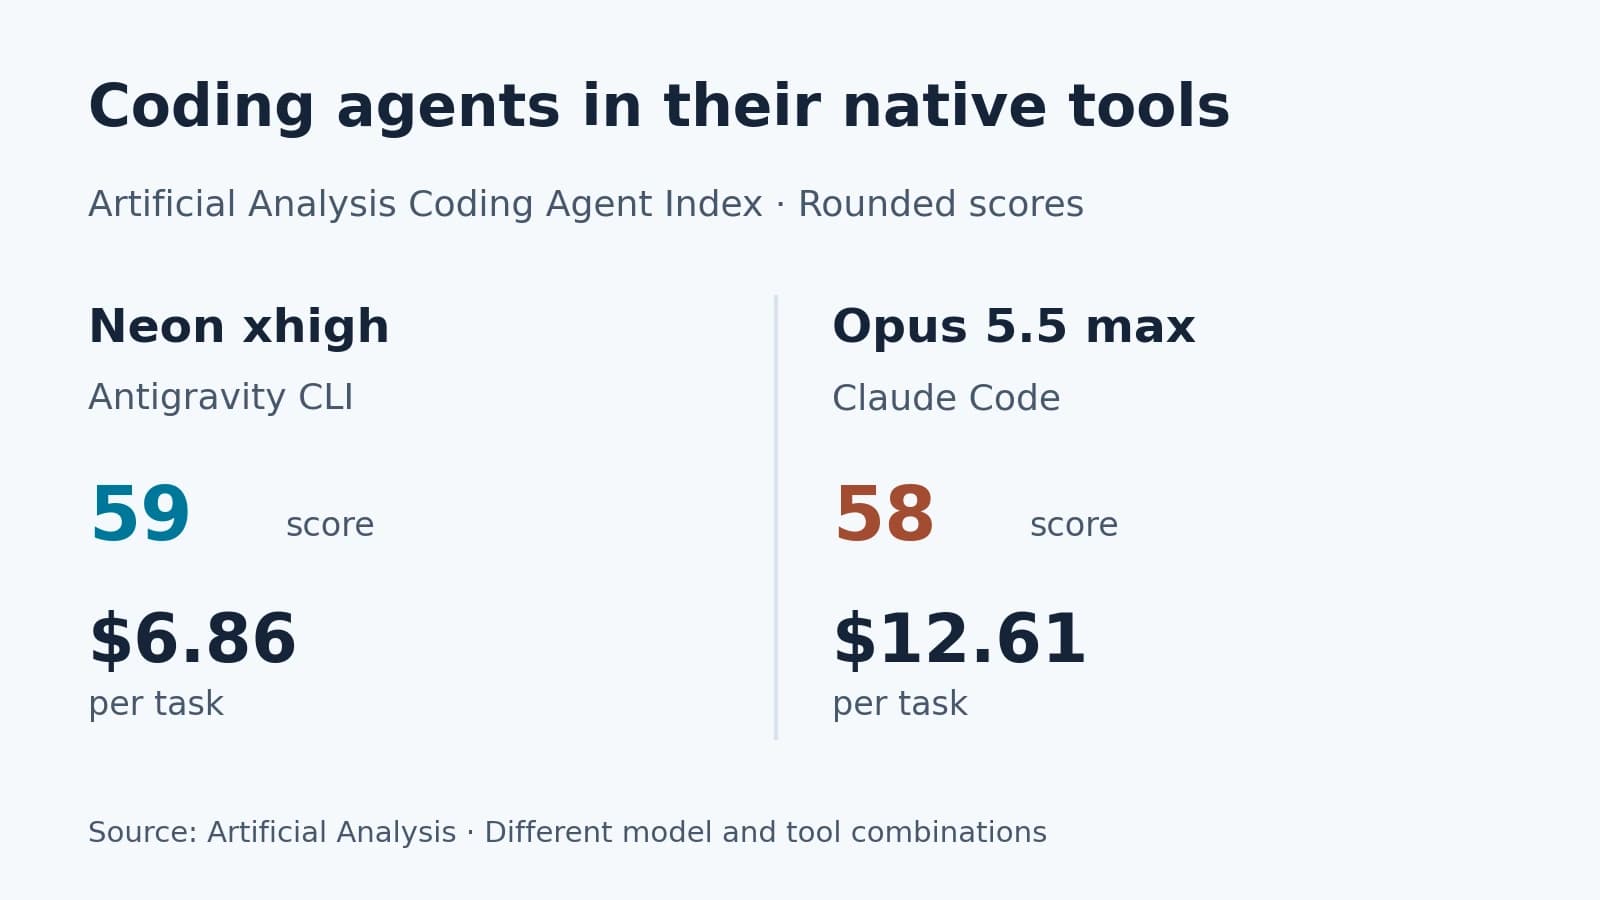
| CursorBench 4.1 설정 | 점수 | 평가에 표시된 작업당 비용 |
|---|---|---|
Neon medium | 57.7% | $3.07 |
Opus 5.5 high | 54.5% | $3.87 |
Neon high | 63.7% | $6.54 |
Opus 5.5 xhigh | 56.7% | $6.54 |
Neon xhigh | 65.4% | $10.67 |
Opus 5.5 max | 58.1% | $11.88 |
high는 시험을 시작하기 좋은 설정입니다. Google의 공개 평가에서는 Terminal-Bench 4.1과 FrontierCode 2.0에서 Opus가 근소하게 앞섭니다. 어려운 터미널 디버깅이나 바로 병합할 수준의 저장소 변경이 많다면 그러한 작업을 재시험에 꼭 포함하세요. 벤치마크로 시험할 작업을 고르고 자체 검수 기준으로 전환을 결정합니다. CursorBench 수치는 2026년 11월 19일에 확인했습니다. CursorBench · Google DeepMind 평가에이전트 실행 환경이 점수에 미치는 영향
| SWE-sweep 설정 | Neon | Opus 5.5 |
|---|---|---|
| 공급자별 에이전트 환경 | 39.0% | 10.1% |
| 공통 mini-SWE 환경 | 12.8% | 3.6% |

실행 환경을 바꾸면 점수와 모델 간 격차가 달라집니다. Google에 따르면 Antigravity CLI는 저장소 검색을 하위 에이전트에 나눠 병렬로 수행할 수 있습니다. SWE-sweep과 같은 버그 탐지 과제에 적합한 기능입니다. 모델만 교체한다면 가능하면 실행 환경을 고정하세요. IDE도 바꾼다면 동일한 권한과 범위에서 두 도구 체인을 비교하고, 익숙해지는 시간과 코드 검토 시간도 기록하세요.
통과한 패치당 비용 계산하기
코딩 작업 100건을 가정한 예시입니다. 합계에는 실패한 시도와 재시도에 든 비용도 포함됩니다.
| 연결 경로 | API 총비용 | 통과한 패치 | 통과한 패치당 API 비용 |
|---|---|---|---|
| Neon | $45 | 75 | $0.60 |
| Opus 5.5 | $60 | 90 | $0.67 |
| Neon, 통과한 패치가 줄어든 경우 | $45 | 65 | $0.69 |
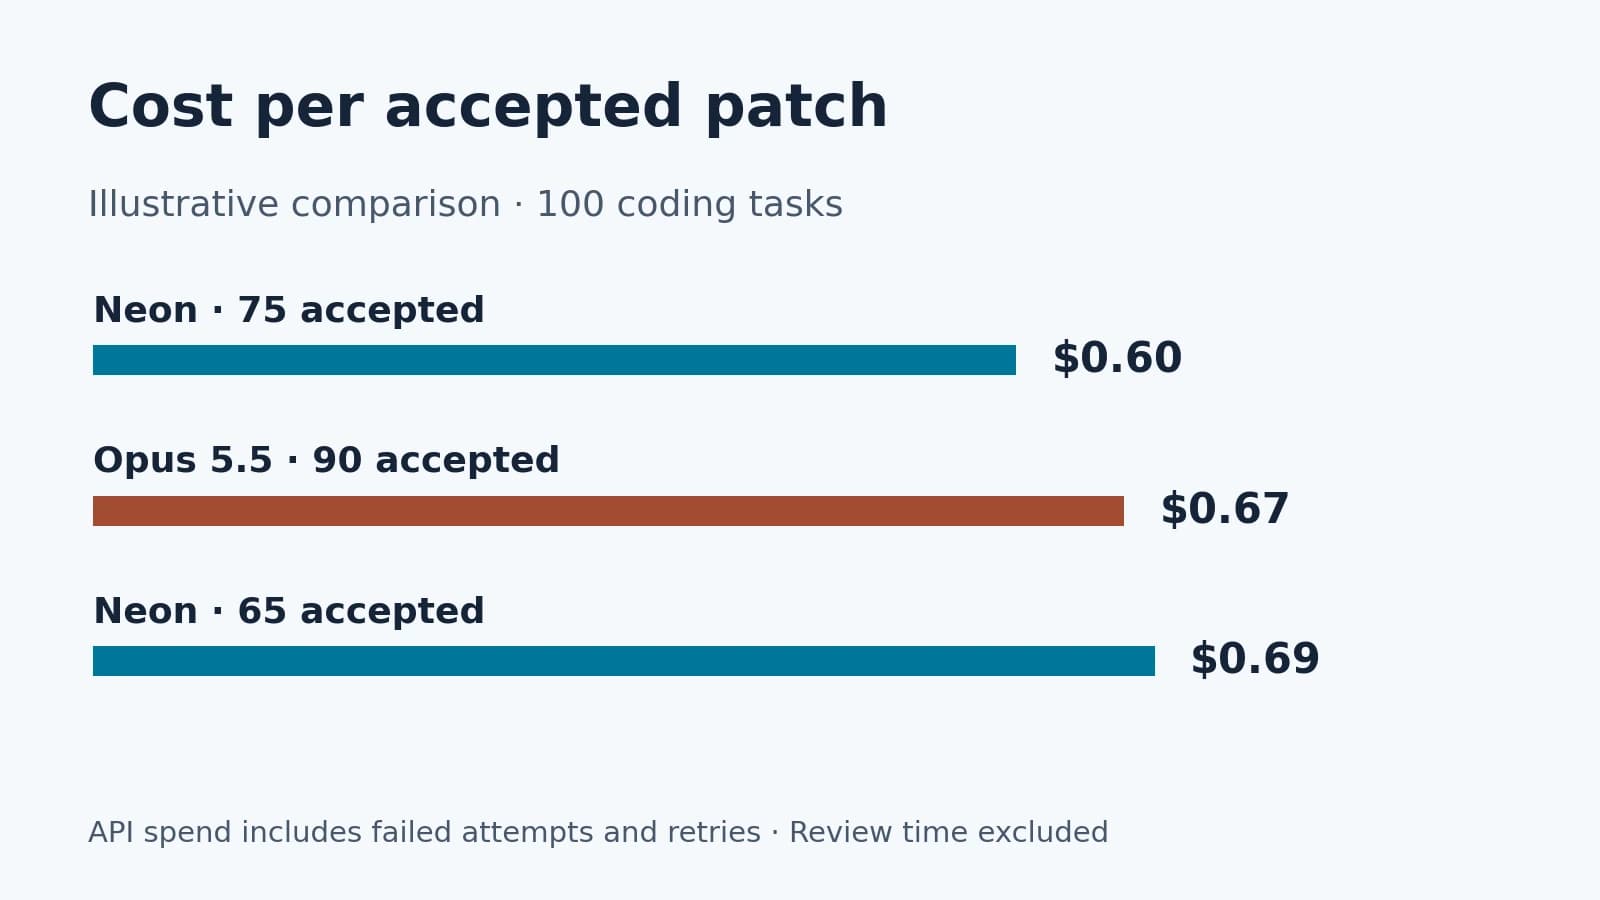
Neon에 똑같이 45달러를 쓰더라도 통과율이 낮아지면 통과한 패치당 비용이 Opus 5.5보다 높아질 수 있습니다. API 비용에 검토 시간과 수동 수정도 함께 반영하세요. 공유 인터페이스의 호환성 요구를 놓치면 수정에 API 호출보다 많은 비용이 들 수 있습니다.
공급자를 바꾸기 전에 API 연동 비교하기
high가 기본입니다. Opus 5.5는 적응형 추론을 쓰고 medium이 기본입니다. 직접 지정한 설정과 배포할 기본값을 함께 비교하세요. 공급자 간 단계의 이름이 같아도 계산량은 다를 수 있습니다. Google Neon 개발자 가이드 · Anthropic 모델 문서| 연동 요소 | Gemini 4 Neon | Claude Opus 5.5 |
|---|---|---|
| 네이티브 API 장문 출력 | 동기 요청은 기본적으로 추론과 출력을 합쳐 65,536토큰. 지원되는 흐름에서 장문 생성 | Anthropic이 안내한 최대 출력 128K |
| 캐시 동작 | Standard에서 암시적 적중 입력 100만 토큰당 0.15달러 | 100만 토큰당 읽기 0.20달러, 5분 쓰기 5달러 또는 1시간 쓰기 8달러 |
| 여러 턴의 도구 상태 | 선택한 API에 맞춰 Google 상호작용 상태 또는 사고 서명 유지 | Claude Messages의 도구 결과와 추론 상태 형식 사용 |
전환 여부를 판단할 수 있는 비교 테스트 설계하기
재현 방법을 알고 있는 간헐적 테스트 실패처럼 자주 들어오는 티켓 유형을 고릅니다. 두 에이전트에 같은 브랜치, 티켓 설명, 도구 이용 권한, 제한 시간, 테스트 명령을 주세요. 각각의 시도를 격리하고 가능하면 모델 이름을 가린 채 같은 체크리스트로 변경 사항을 검토합니다.
패치를 검토하기 전에 합격 기준 설정하기
결과를 측정할 수 있는 대표 티켓을 몇 개 고릅니다. 시작 리비전, 의존성 잠금 파일, 저장소 지침, 사용 도구와 중단 규칙을 고정합니다. 기존 Claude Code 흐름에 성공을 돕는 훅이나 명령이 있다면 기록하세요. 모델 자체를 비교할 때는 해당 검사를 모델에 묶이지 않는 실행기에서 재현할 수 있습니다.
| 평가 항목 | 구체적인 통과 기준 |
|---|---|
| 기능 | 수정 전에 원래 오류가 재현되고 수정 후 대상 테스트 통과 |
| 호환성 | 기존 예제가 통과하고 오래된 입력이나 클라이언트가 의도한 대로 동작 |
| 범위 | 변경이 티켓 범위에 맞고 일반적인 검증 절차를 끄지 않음 |
| 복구 | 도구 중단 시 남은 작업을 알리고 부작용을 만드는 행동을 중복 실행하지 않음 |
원래 작업별로 첫 결과와 최종 결과, 리뷰 가능한 diff까지의 시간, 청구 토큰과 리뷰 소요 분을 한 줄에 기록합니다. 두 번째 시도에서 해결됐다면 둘 다 계산하고 리뷰어가 새 근거를 줬는지도 남기세요. 복구 비용을 보면 Opus에 남길 작업과 Neon으로 옮길 티켓을 고를 수 있습니다.
자주 묻는 질문
Neon의 코딩 성능이 Opus 5.5보다 좋은가요?
인용한 CursorBench 설정에서는 Neon이 앞섰고, 일부 터미널과 저장소 평가에서는 Opus가 앞섰습니다. 업무에 가장 가까운 평가를 보세요.
Neon이 더 저렴한가요?
표준 입력·출력 단가가 25% 낮습니다. 통과한 작업당 비용은 사용량, 캐시, 재시도, 리뷰에 따라 달라집니다.
양쪽 모두 최고 추론 단계로 비교할까요?
어려운 사례에는 최고 설정도 포함하세요. 일상 트래픽은 예산과 지연 시간 조건에 맞는 단계로 비교합니다.
에디터를 바꾸지 않고 비교할 수 있나요?
같은 에디터에서 양쪽 모델과 필요한 기능을 제공한다면 가능합니다. 중요한 변수 하나를 고정할 수 있습니다.
실행 중인 에이전트의 모델 이름만 바꾸면 되나요?
먼저 연동 방식을 확인하세요. 도구 메시지, 추론 설정, 상태 처리 방법은 공급자 API마다 다를 수 있습니다.
어떤 작업으로 먼저 테스트하나요?
반복해서 들어오고 재현 가능하며 검수 기준이 명확한 티켓을 선택하세요. 같은 유형이 다시 들어왔을 때 어느 모델에 맡길지 판단할 수 있습니다.