Claude Fable 5.2 출시: 코딩·추론·에이전트 업데이트
Fable 5.2의 코딩·추론 개선, 하드웨어와 게임 데모, 표준 단가 20% 인하, 추론 강도 선택과 API 마이그레이션 확인 사항을 살펴봅니다.
 EvoLink Team제품 팀
목차
실제 관건은 긴 프로젝트를 계속 진전시킬 수 있는가입니다. 기존 코드를 이해하고 문제를 나누며 도구를 실행하고 결과를 검증한 뒤, 오류가 생기면 접근을 바꿔야 합니다. 답변이 자세해지는 것과 프로젝트를 납품하기 쉬워지는 것은 다른 성과입니다. 후자는 도구, 실행 시간, 사람의 수정, 최종 청구액까지 함께 평가해야 합니다.
Claude 제품군에서 Fable 5.2의 위치
Fable은 지속적인 추론이 필요한 어려운 기술 작업을 대상으로 합니다. Anthropic은 대부분의 작업을 최신 Opus 모델로 시작하고, Opus의 추론 강도를 높인 평가에서도 요구사항을 충족하지 못할 때 Fable 5.2로 전환하도록 권장합니다.
스타일 변경, 일반적인 API 구현, 명확한 규칙에 따른 문서 정리라면 이미 안정적으로 성공하는 모델이 경제적일 수 있습니다. 복잡한 의존성, 설계 대안, 반복 검증이 필요한 일에서는 더 강한 모델이 기여할 여지가 커집니다. 마이그레이션은 데이터 구조, 업무 동작, 배포, 성능 제약을 함께 고려해야 합니다. 잘못된 판단과 재작업을 한 번 줄이는 것이 요청 한 건의 가격보다 중요할 수 있습니다.
Mythos 5.2는 같은 기반 모델을 사용합니다. Fable에는 사이버 보안과 생물학 분야의 보호 장치가 있어 더 넓게 제공되며, Mythos는 Anthropic의 검증 프로그램에서 승인받은 조직에 제공됩니다. 해당 분야의 성과는 어느 모델에서 나온 결과인지 구분해야 합니다.
100만 토큰 컨텍스트와 최대 128K 출력
claude-fable-5-2**입니다. 100만 토큰 컨텍스트, 최대 128K 출력 토큰을 지원하며 텍스트와 이미지를 입력받아 텍스트로 출력합니다. 적응형 사고는 항상 켜져 있고 API의 기본 추론 강도는 high입니다.저장소 작업에는 인터페이스 정의, 구현, 테스트, 과거 설계 자료를, 연구에는 여러 보고서와 데이터 정의를 함께 제공할 수 있습니다. 자료를 전달하는 방식은 여전히 중요합니다. 유용한 입력에는 다음이 담겨야 합니다.
- 결과물: 실행 가능한 코드, 마이그레이션 계획, 완성된 분석 등.
- 필수 제약: 인터페이스 호환성, 데이터 일관성, 지연 시간 등.
- 검증 도구: 테스트, 타입 검사, 빌드, 데이터 검증 스크립트 등.
- 모델이 결정할 수 있는 부분과 사람이 판단해야 할 절충안.
명확한 목표와 실행 가능한 검증이 있어야 진행 상황을 판단하기 쉽습니다. 컨텍스트 용량은 작업 공간이고, 과제의 구조는 그 공간을 어떻게 쓰는지 결정합니다.
Fable 5.2의 코딩·추론·차트 이해 개선
Anthropic이 공개한 결과는 기술 작업의 여러 부분을 다룹니다. 아래 그림은 FrontierCode 2.0, FrontierSWE v2, 도구를 사용한 Humanity's Last Exam, 도구 없이 수행한 Chartography를 비교합니다.
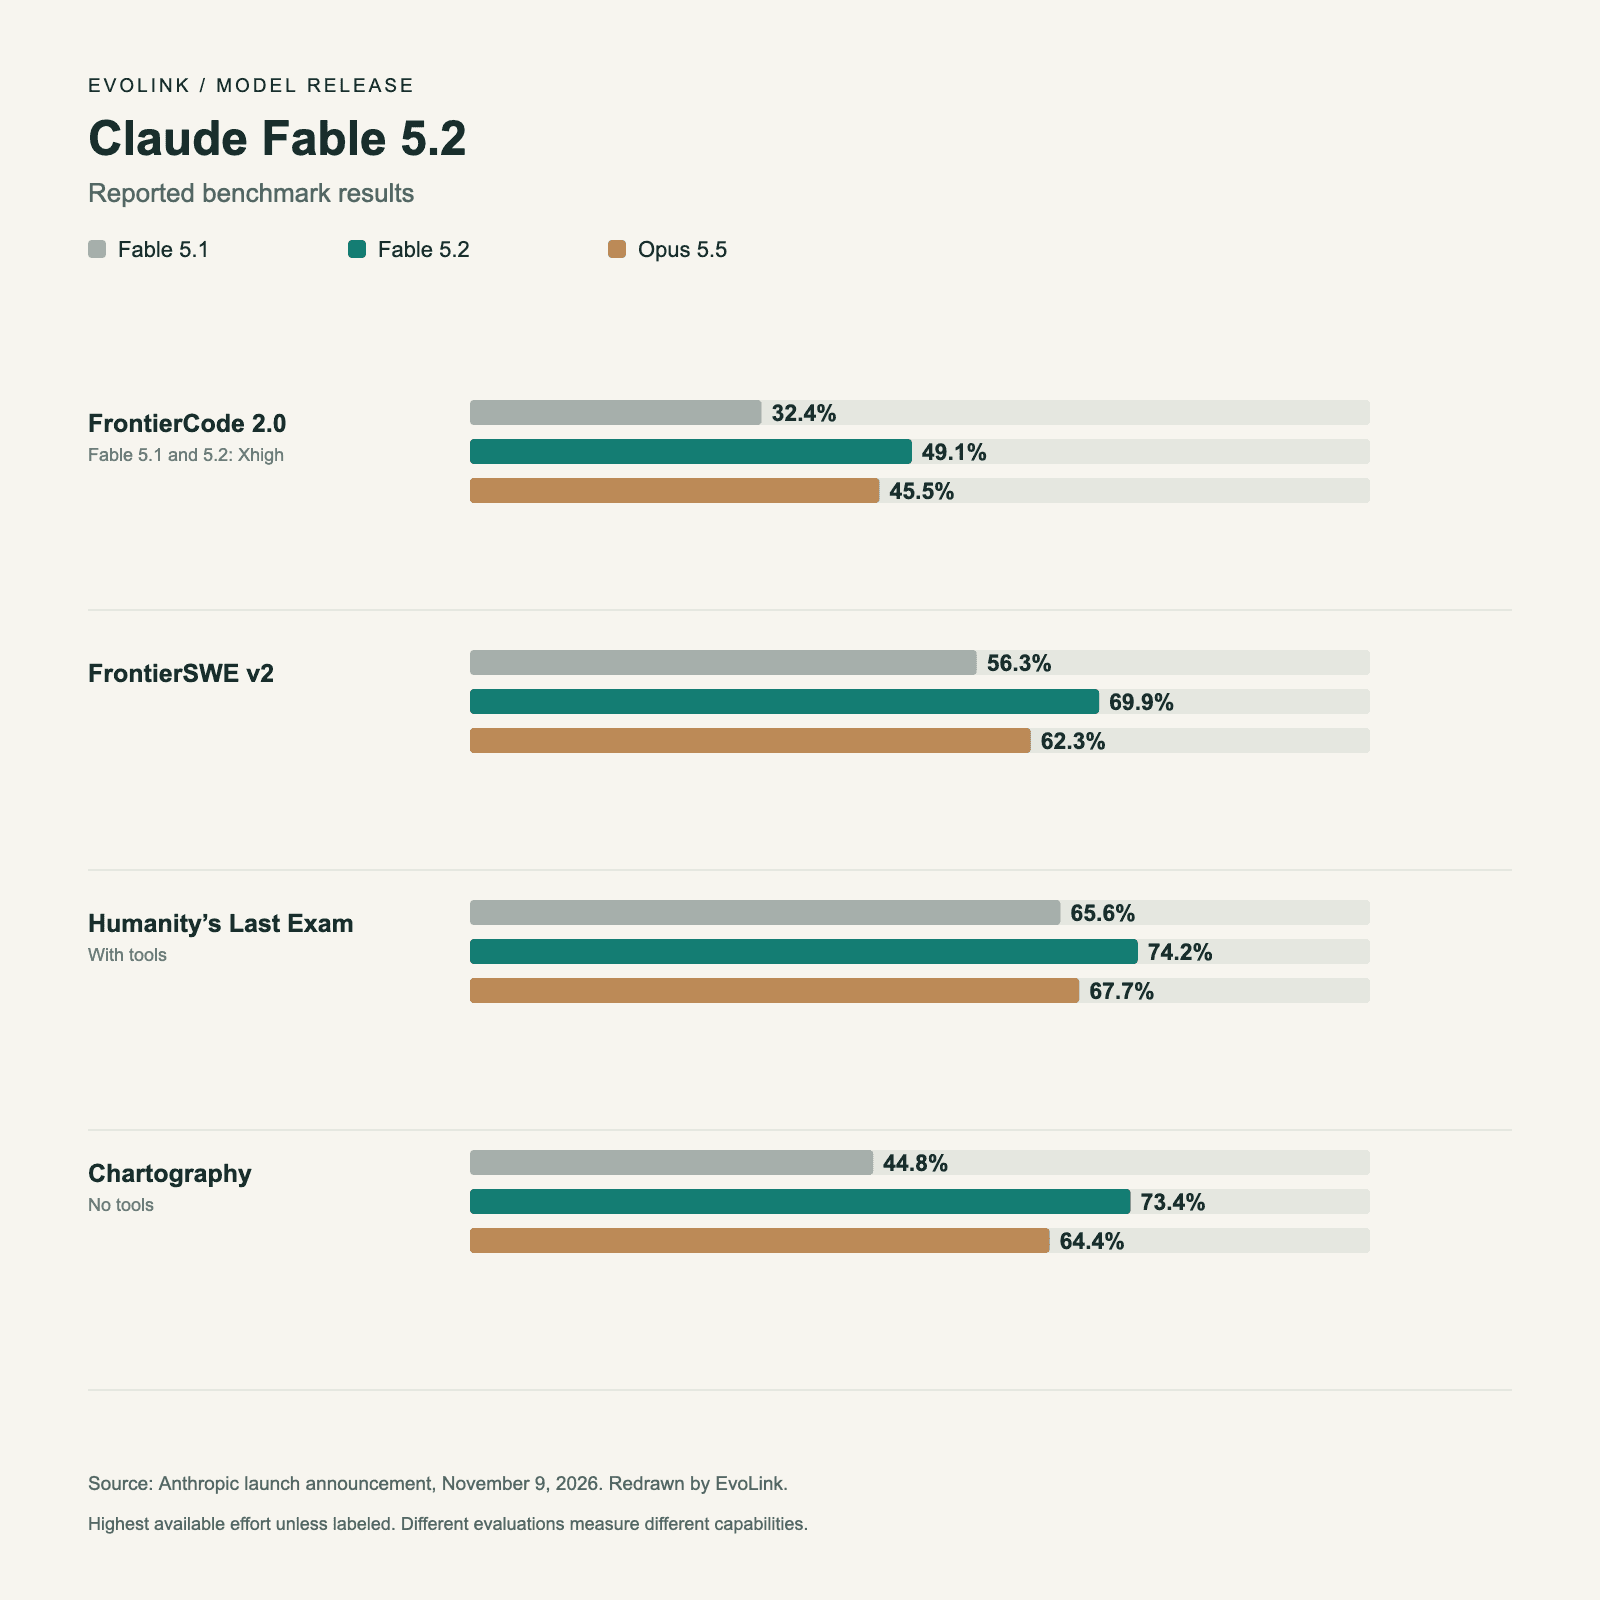
실제 프로젝트에는 코딩, 다단계 분석, 차트 정보 추출이 함께 등장합니다. 개발자는 성능 곡선과 오류 로그로 병목을 찾고, 연구자는 차트를 읽은 뒤 설명을 코드로 검증하며, 제품팀은 시각 자료를 대화형 인터페이스로 구현할 수 있습니다.
평가에는 팀이 실제로 쓰는 입력을 넣으세요. 스크린샷, 차트, 코드를 함께 다룬다면 세 가지를 모두 포함합니다. 텍스트 프롬프트 하나로는 전체 워크플로의 중요한 차이를 놓칠 수 있습니다.
하드웨어 시제품이 보여 주는 여러 단계의 엔지니어링
Anthropic과 Diode는 Fable 5.2에 USB 회의용 스피커폰, 가정용 음성 도우미 허브, 휴대용 가상 반려동물을 설계하도록 했습니다. 모델은 사양, 회로도, 부품 배치, PCB 배선, 케이스, 펌웨어를 담당했습니다. Diode 엔지니어가 제작과 시험을 수행했고, Anthropic에 따르면 세 제품 모두 회로 수정 없이 작동했습니다.
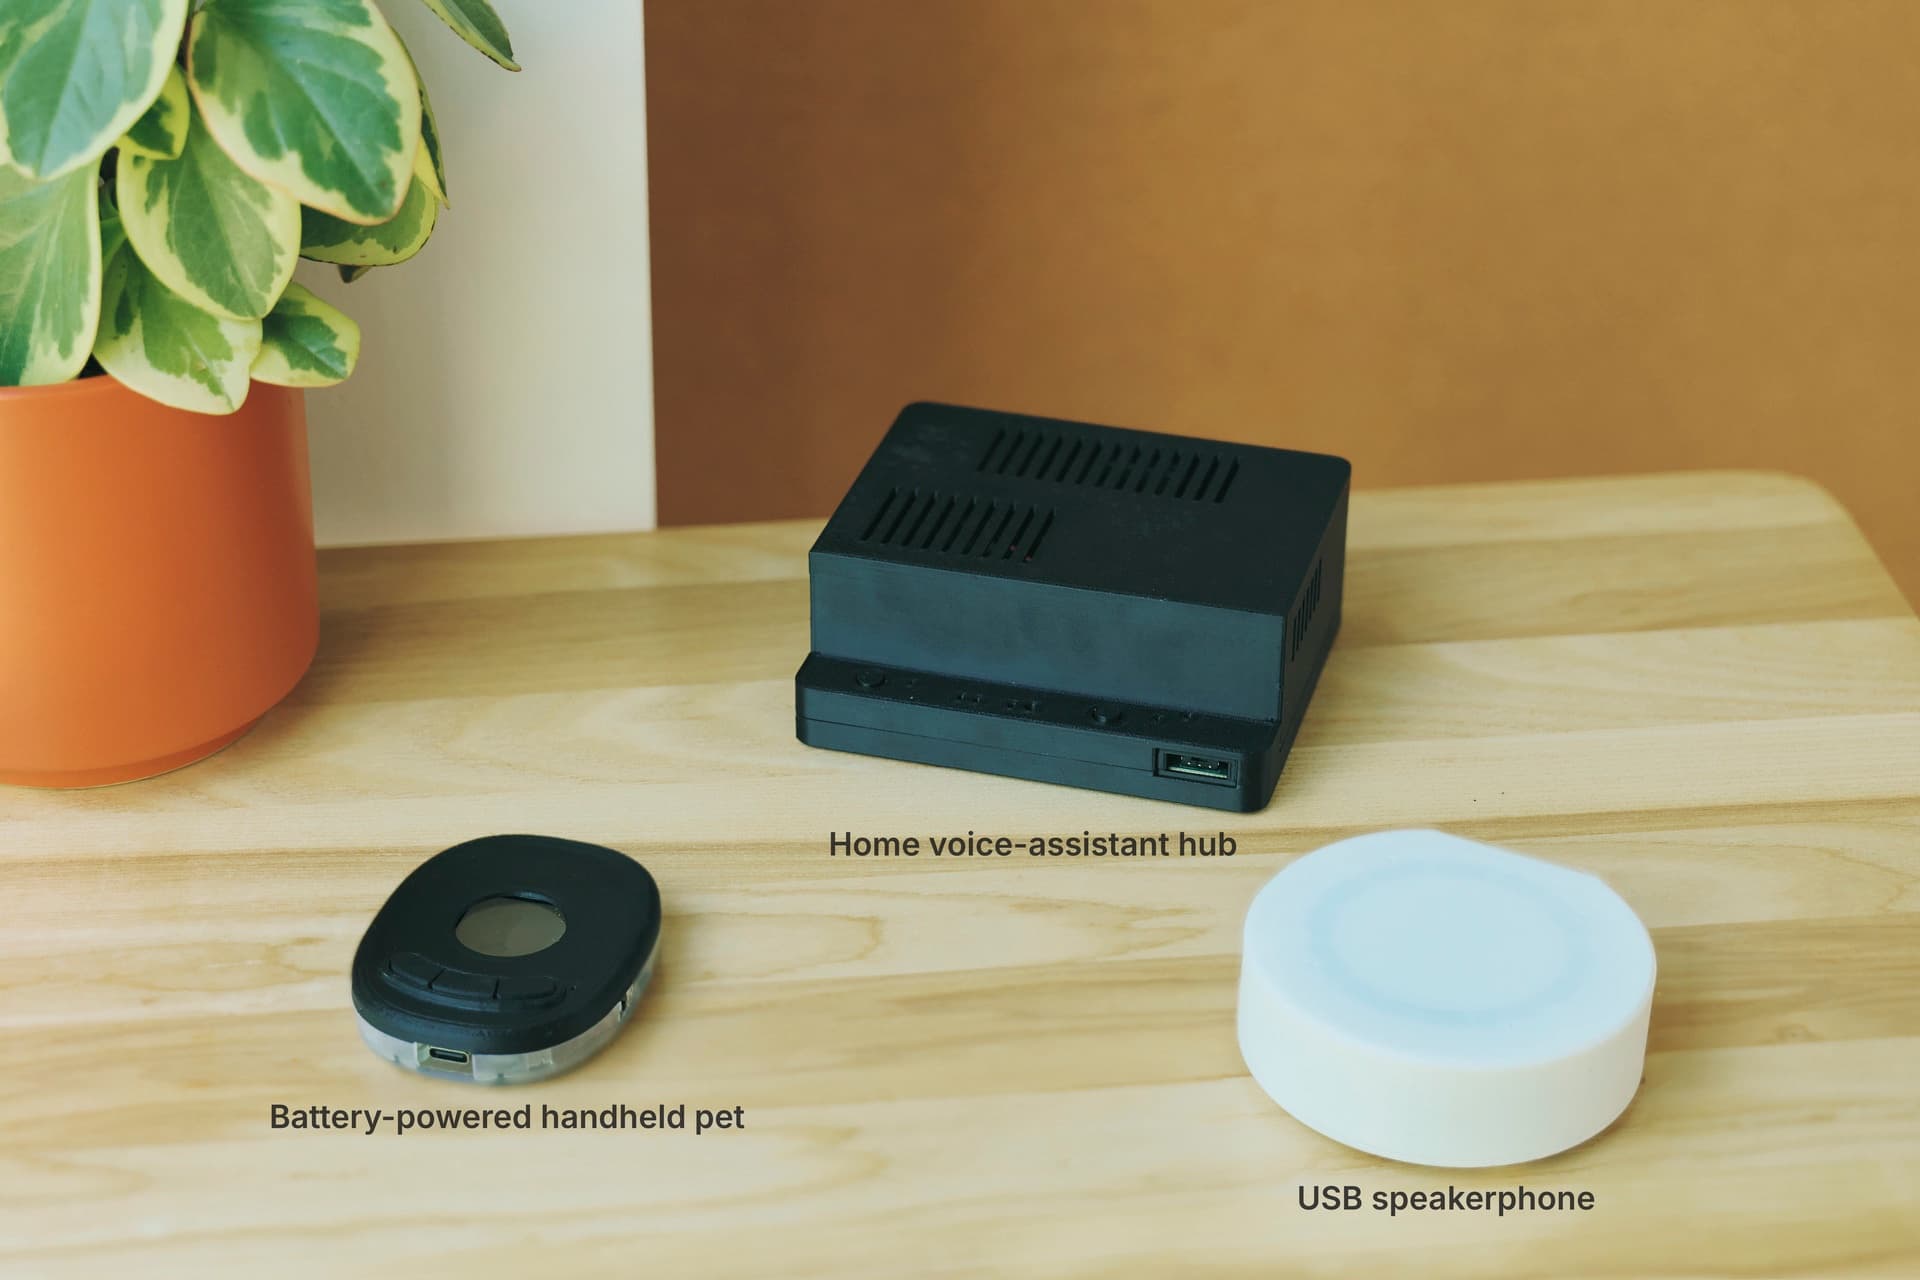
부품 위치는 배선에, 커넥터는 케이스 개구부에, 조립 방식은 기구 설계에 영향을 줍니다. 한 단계에서 타당한 결정이 다음 단계의 문제로 이어질 수 있습니다. 이 사례는 제약과 후속 영향을 프로젝트 내내 추적하는 가치를 보여 줍니다.
아직 시제품입니다. 전기적 검증, 안테나 조정, 열 시험, 인증이 남아 있고 대량생산용 설계가 아닙니다. 작동하는 시제품 이후에도 제품 엔지니어링이 필요합니다. 소프트웨어팀도 실행되는 코드 외에 배포, 모니터링, 롤백, 유지보수를 고려했는지 같은 방식으로 점검할 수 있습니다.
1,000개 에이전트의 장시간 협업 실험
시스템 측면의 핵심은 서로 의존하는 작업을 맡고 진행을 공유하며 결과를 제출하고 부분 성과를 합치는 방식입니다. 공유 상태와 신뢰할 수 있는 검증이 작업의 지속을 돕습니다. 대규모 코드 이전에는 공통 인터페이스, 중복 수정 방지, 통합 테스트가 필요합니다. 연구를 나눌 때도 분석을 합치려면 데이터 정의가 일치해야 합니다.
에이전트 수를 늘리기 전에 독립적으로 완료하고 명확히 검증할 수 있는 하위 작업부터 찾으세요. 동시 실행에는 조정 비용이 들며, 작업 경계는 에이전트 수만큼 중요합니다.
게임과 인터랙티브 데모로 확인하는 능력
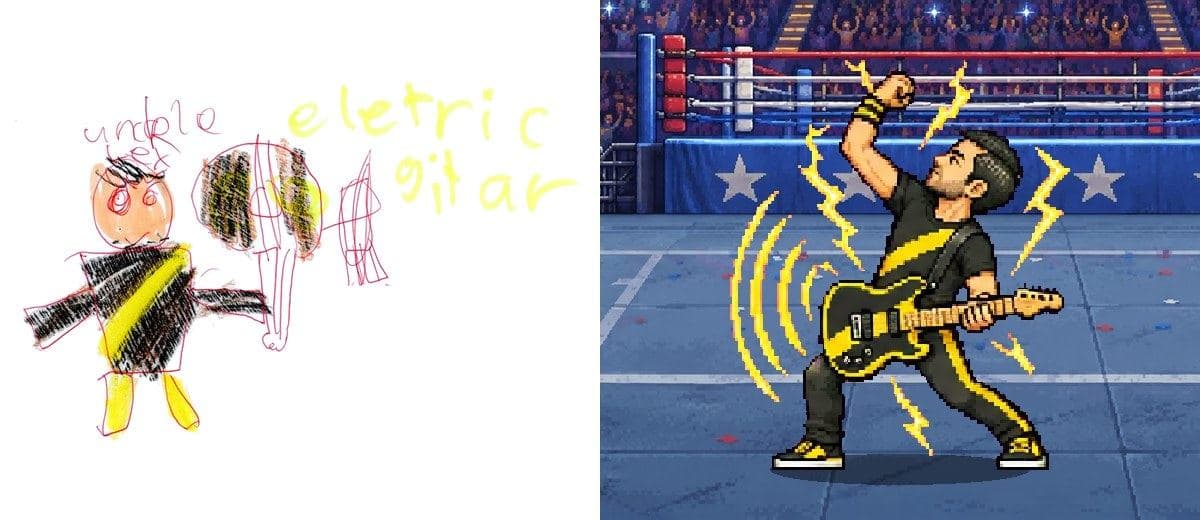
이 사례의 매력은 캐릭터, 이야기, 목표를 코드, 미디어 도구 호출, 테스트로 계속 발전시키는 제작 과정입니다. 교육 도구, 인터랙티브 데모, 브랜드 경험을 만드는 팀이라면 매개변수를 조정하는 제품 설명이나 직접 조작하는 절차 시뮬레이션으로 아이디어가 잘 전달되는지 시험할 수 있습니다.
외형뿐 아니라 상호작용 피드백, 안정성, 수정 편의성도 확인하세요. 시제품은 여러 번 바뀌므로 편집 가능한 소스와 정돈된 자산 구조가 후속 수정 비용에 영향을 줍니다.
표준 단가 20% 인하와 Fast mode의 속도 선택
Anthropic이 공개한 표준 단가는 Fable 5.1보다 20% 낮습니다.
| 100만 토큰당 미국 달러 | Fable 5.1 표준 | Fable 5.2 표준 | Fable 5.2 Fast mode |
|---|---|---|---|
| 입력 | $10 | $8 | $16 |
| 출력 | $50 | $40 | $80 |
대기 자체에 비용이 있는 대화형 디버깅에서는 Fast mode가 유용할 수 있습니다. 대기열로 처리할 수 있는 백그라운드 작업은 절약한 시간이 높은 요금을 정당화하는지 비교해야 합니다.
캐시와 전체 작업 청구액도 확인해야 한다
에이전트는 프로젝트 배경과 도구 정의를 여러 요청에서 재사용할 수 있습니다. 캐시 조건을 만족하면 일반 입력과 다른 방식으로 과금됩니다. 게임 사례의 많은 캐시 읽기도 토큰 종류를 구분해야 하는 이유입니다.
일반 입력, 캐시 쓰기, 캐시 읽기, 출력을 따로 기록하고, 외부 도구 요금과 사람의 재작업을 더해 수용 가능한 결과물의 비용을 평가하세요. 단가 인하는 기초 비용을 개선하지만 최종 절감액은 작업 실행 방식에 달려 있습니다.
추론 강도도 모델 선택의 일부
low, medium, high, xhigh, max를 제공하며 API 기본값은 high입니다. Anthropic은 High부터 시작하고, 어려운 작업에서 효과를 측정한 후 Xhigh를 시험하며, Max는 능력 한계를 탐색하거나 시간·토큰 비용이 덜 중요한 드문 작업에 쓰도록 권장합니다.2026년 11월 10일 확인한 Artificial Analysis 결과는 다음과 같습니다.
| 설정 | Intelligence Index | 평가 작업당 가중 평균 비용 |
|---|---|---|
| Medium | 56 | $3.80 |
| High | 62 | $9.08 |
| Max | 65 | $26.54 |
모두 Default Fallback 설정입니다. 비용과 작업은 AA의 평가 및 계산 기준에 해당하며 일반 사용자 작업 견적이 아닙니다. 이 시점의 결과에서 High에서 Max로 올리면 점수가 오르지만 평가 비용도 크게 증가합니다.
입력, 도구, 수용 기준을 고정한 채 추론 강도를 바꾸세요. 요구사항을 처음 충족하는 설정과 추가 예산으로 실제 결과가 개선되는지 확인합니다. 일상적인 정보 정리와 복잡한 의존성 이전은 서로 다른 설정이 적합할 수 있습니다.
업그레이드할 때 기존 프롬프트도 점검하기
Anthropic 가이드는 상시 지침의 '서브에이전트를 더 사용하라'는 요구가 불필요한 위임을 유발할 수 있다고 설명합니다. 프롬프트에 적은 큰 토큰 예산도 소비에 영향을 줍니다. 일부 코딩 시험에서는 그 문구를 제거했을 때 비슷한 성능으로 비용이 줄었습니다. 이는 텍스트로 제시한 예산에 대한 관찰이며 API의 task budgets 기능에 대한 결론은 아닙니다.
모든 작업에 병렬 실행, 가능한 모든 대안 검토, 누적된 중복 규칙이 필요한지 확인하세요. 명확한 완료 조건이 평가를 돕습니다. 원래 프롬프트를 보존하고 변경을 하나씩 품질, 지출, 실행 동작으로 비교해야 모델 효과와 워크플로 효과를 구분할 수 있습니다.
프로덕션 연동에서 확인할 변경점
공식 채널에는 Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS가 있습니다. 채널별 모델 ID, 기능, 과금은 해당 문서에서 확인해야 합니다.
기존 연동은 다음 네 가지를 점검해야 합니다.
- 대화 기록: 시스템 프롬프트, 도구, 이전 메시지를 바꾸면 반환한 사고 블록이 무효화될 수 있습니다. 접두사 검사는 모든 계정에 적용됩니다. 유효하지 않은 블록을
prefix_mismatch_behavior설정 없이 다시 보내면 400 오류가 발생합니다. - 모델 전환: Claude API에서 Fable 5.2 대화를 Opus 5.5로 바꾸면 Fable의 사고 블록은 삭제되지만 요청은 성공할 수 있습니다.
- Computer use: Amazon Bedrock을 제외하면 기존
computer_20251124도구에서 새 도구 모음으로 이전해야 합니다. - Advisor: Fable 5.2 실행 모델은 호환되는 Fable 5.2 또는 Mythos 5.2 advisor가 필요합니다.
통합 API 게이트웨이로 관리할 때도 매개변수 전달, 과금, 긴 대화의 모델 전환 시 기록 처리 방식을 점검하세요. 프로덕션 워크플로에 직접 영향을 주는 동작입니다.
어떤 팀이 Fable 5.2를 먼저 평가해야 할까?
Fable 5.1 사용자는 품질과 비용 기록이 있는 작업부터 완료율, 수정량, 지출을 비교할 수 있습니다. Opus 중심 팀은 반복적으로 막히는 작업부터 시작하면 됩니다. 여러 차례 수정해도 테스트를 통과하지 못하는 코드나 서로 연결된 제약을 충족하지 못하는 계획이 그 예입니다.
에이전트 제품팀은 계획, 어려운 분석, 중요한 결과 검토에 Fable을 쓰고 명확한 실행 단계는 경제적인 모델에 맡기는 구성을 평가할 수 있습니다. 도입 전에 정보 전달과 전체 비용을 함께 측정해야 합니다.
일상 작업 하나, 알려진 어려운 문제 하나, 장시간 프로젝트 하나로 시작하세요. 결과물 품질, 소요 시간, 총지출, 사람의 수정량을 비교해 기본 모델, 상위 모델 전환 조건, 추론 강도를 정합니다. Fable 5.2는 더 높은 능력 한계와 낮은 표준 단가를 제공합니다. 익숙한 작업에서 그 변화가 안정적이고 감당 가능한 납품으로 이어지는 지점을 찾을 수 있습니다.
자주 묻는 질문
Claude Fable 5.2는 언제 출시됐고 5.1에서 무엇이 달라졌나요?
Fable 5.2 출시를 계기로 사용 중인 Opus 5.5를 바꿔야 하나요?
Fable 5.2와 Mythos 5.2는 어떻게 다른가요?
Fable 5.1보다 20% 낮아진 단가는 전체 작업 비용에 어떤 영향을 주나요?
Fable 5.2가 이미지나 동영상을 직접 생성하나요?
100만 토큰 컨텍스트와 128K 출력은 긴 작업에서 무엇을 의미하나요?
Fable 5.2 출시에서 안내한 이용 채널은 무엇인가요?
claude-fable-5-2입니다. 공식 채널에는 Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS도 있습니다. 채널별 식별자, 기능, 과금을 확인해야 합니다. EvoLink에서는 Fable 5.2 모델 페이지에서 현재 연동 정보와 요금을 확인할 수 있습니다. 외부 경로는 매개변수와 대화 기록의 호환성도 별도로 검증해야 합니다. 공식 제공 정보추론 강도는 어떤 설정으로 시작해야 하나요?
high이며 low, medium, high, xhigh, max를 제공합니다. High부터 시작해 같은 입력, 도구, 수용 기준으로 다른 수준을 비교하세요. 어려운 작업에서 이득을 측정한 뒤 Xhigh를 시험하고, 추가 시간과 토큰을 들여 능력 한계를 탐색할 가치가 있을 때 Max를 사용합니다. 추론 강도 지침업그레이드 후 기존 대화에서 400 오류가 발생하는 이유는 무엇인가요?
prefix_mismatch_behavior 설정 없이 다시 보내면 400 오류가 납니다. 이전할 때 사고 기록 처리와 접두사 불일치 시 문서화된 동작을 확인하세요. 별개의 동작으로 Claude API에서 Fable 5.2를 Opus 5.5로 전환하면 요청이 성공해도 사고 블록이 삭제될 수 있습니다. 마이그레이션 변경점