Gemini 4 Hydrogen vs Gemini 3.8 Flash : faut-il migrer ?
Décider d’un passage à Hydrogen : contexte partagé, réflexion par défaut, cache, évaluation équitable, coût complet et retour arrière.
 EvoLink TeamÉquipe produit
Dans cet article
Cet article ne présente aucun benchmark contrôlé de workload EvoLink. Il associe différences documentées et méthode reproductible d’évaluation et de déploiement. Il doit aider à décider avant de modifier le trafic de production, plutôt que désigner un vainqueur général à partir de démonstrations communautaires.
Définir le type de migration dont vous avez besoin
Une chaîne de classification stable et un agent de programmation peuvent mener à des conclusions différentes sur le même modèle. Le classificateur peut avoir peu de marge de qualité restante, tandis que les échecs au premier essai d’un agent peuvent justifier une réponse plus coûteuse. Traitez ces cas comme des décisions de routage distinctes.
| Situation actuelle | Première décision | Preuve nécessaire pour changer |
|---|---|---|
| 3.8 atteint les objectifs de qualité, de coût et de délai | Le conserver comme témoin | Une amélioration précise ayant une valeur métier |
| Échecs répétés sur des documents ou du code | Tester Hydrogen sur ces catégories d’échec | Des résultats corrects et validés, pas une explication plus convaincante |
| Les tâches exigent plus que le plafond de réponse actuel | Étudier l’architecture de sortie longue | Continuation prise en charge, budgets cumulés et gestion des interruptions |
| Le client dépend de caches explicites | Auditer la compatibilité avant le test | Une stratégie de cache implicite fonctionnelle et un rapprochement correct de l’utilisation |
| Le trafic mélange tâches simples et difficiles | Évaluer par catégorie | Comparaisons d’erreurs, de latence et de dépenses totales par catégorie |
Gemini 4 Hydrogen vs Gemini 3.8 Flash : différences de migration
| Domaine | Référence 3.8 Flash | Changement Hydrogen | Vérification de migration |
|---|---|---|---|
| Contexte | Limites séparées de 1M en entrée et 64K en sortie | Une fenêtre de 1 048 576 tokens partagée entre entrée, réflexion et sortie | Réserver de la place à la réponse plutôt que remplir l’entrée |
| Réflexion | low, medium, high ; valeur par défaut medium dans la comparaison Google | Ajout de xhigh ; high devient la valeur par défaut chez le fournisseur | Fixer explicitement une valeur prise en charge par la route |
| Sortie longue | Plafond documenté de 65 536 | Le décodage long peut dépasser une étape synchrone de 65 536 tokens | Persister l’état de continuation et rapprocher l’utilisation totale |
| Cache | Les anciens clients peuvent créer et référencer un cache explicite | Création explicite non prise en charge | Supprimer cette dépendance et mesurer les succès du cache implicite |
| Échantillonnage | Le code existant peut envoyer des paramètres d’échantillonnage | Google indique que les valeurs personnalisées temperature, top_p et top_k sont ignorées | Ne plus supposer qu’elles règlent le comportement d’Hydrogen |
| Déclaration des outils | D’anciens wrappers de prompt peuvent demander des « appels d’outils » en JSON sous forme de texte brut | Google avertit que cela peut provoquer MALFORMED_FUNCTION_CALL si aucun outil natif n’est déclaré | Déclarer des outils de fonction ou un schéma de sortie structurée ; respecter le contrat de requête de la passerelle choisie |
| Historique des outils | L’état géré par le client dépend du protocole | Préserver les tours du modèle et signatures de réflexion comme documenté | Tester plusieurs tours, pas seulement la première requête |
Le contexte partagé est le piège le plus facile à manquer : une requête proche de l’ancienne limite d’entrée séparée peut laisser trop peu de place dans la fenêtre partagée d’Hydrogen. Indépendamment de cette fenêtre, le plafond de sortie choisi limite ensemble les tokens de réflexion et de réponse. Abaisser ce plafond ne récupère pas de capacité de réponse visible lorsque la réflexion le consomme. Vérifiez à la fois l’espace restant dans la fenêtre partagée et le plafond configuré, ainsi que le motif de fin et l’utilisation, avant d’attribuer une réponse plus courte à une intelligence moindre.
Le cache mérite son propre test de compatibilité. Un préfixe répété permet éventuellement une réutilisation implicite ; il ne garantit ni un cache préchauffé, ni sa validité, ni son transfert entre modèles. Testez des préfixes récurrents et variables et utilisez les lectures de cache observées. Ne fondez pas le budget de migration sur des succès hypothétiques.
Comparer une tâche complète plutôt qu’une démonstration choisie
Un test utile regroupe des tâches réellement exécutées, des critères de validation écrits et un environnement fixe. Les trois exemples ci-dessous sont des plans d’évaluation, pas des résultats mesurés des modèles.
Programmation : un correctif qui passe l’exécution et la revue
Choisissez un bug assorti d’un test de non-régression, par exemple conserver un filtre entre plusieurs pages de résultats. Figez révision du dépôt, dépendances, fichiers autorisés et instructions. Donnez aux deux modèles les mêmes preuves pertinentes, accès aux tests et limites d’autorisation.
Une réussite exige le comportement attendu, sans régression inacceptable ni modification hors sujet. Consignez tests, corrections du réviseur et nombre de tours nécessaires à un correctif utilisable. Si un modèle propose vite une solution élégante mais défectueuse, il ne bat pas un correctif plus lent qui est validé. Comparez le temps après tests et corrections, tout en conservant le délai du premier token comme mesure distincte de réactivité.
Incluez au moins un cas dont les preuves sont incomplètes. Un modèle qui demande le contrat manquant ne devrait pas être pénalisé pour avoir refusé de l’inventer ; fixez cette règle de notation avant de lire les réponses.
Extraction : des champs exacts avec leurs preuves
Utilisez une fiche produit ou un contrat de service avec un schéma fixe et une référence annotée. Incluez conversion d’unités, champs absents et conflit entre deux versions. Les modèles doivent voir la même source et recevoir les mêmes consignes pour les valeurs manquantes.
Distinguez l’exactitude par champ de la validation du dossier complet. Un seul montant critique erroné peut invalider un dossier par ailleurs correct. Le schéma est nécessaire mais ne prouve pas l’exactitude factuelle. Marquez explicitement les sorties à réviser pour ne pas confondre une abstention prudente et un dossier automatiquement terminé.
Agents : achever correctement les outils malgré les échecs
Créez des réponses d’outils déterministes pour une recherche, un timeout et un refus de permission. Consignez arguments valides, opérations achevées et réponses finales véridiques. Prévoir un appel d’outil n’est pas achever une tâche ; une réponse inventée après un timeout doit échouer.
Gardez les outils d’évaluation en lecture seule ou simulés. En mode fantôme, ne déclenchez pas un second paiement, remboursement ou message client parce que les deux modèles le proposent. L’application impose idempotence, autorisations et responsabilité de l’exécution indépendamment du modèle choisi.
Rendre les configurations comparables sans masquer leurs différences
Exécutez deux comparaisons complémentaires. D’abord, évaluez pour chaque modèle la configuration que vous déploieriez réellement. Cela répond à la question de production. Ensuite, si c’est pris en charge, rapprochez les niveaux de réflexion et limites de tâche pour comprendre l’origine du changement. Publiez les deux configurations ; des champs portant le même nom ne rendent pas les paramètres identiques.
Comparer Hydrogen en low avec 3.8 en high peut être pertinent pour une politique produit, mais ne constitue pas une mesure contrôlée de vitesse à réflexion égale. Les valeurs par défaut sont particulièrement risquées : le passage documenté de medium à high modifie silencieusement l’expérience.
Figez le jeu de tâches avant d’observer les résultats. Séparez cas simples, typiques et sujets aux échecs. Reliez les poids à leur fréquence en production ou déclarez un jeu de diagnostic non pondéré. Sinon, l’ajout de nombreux exemples faciles peut masquer une régression sur un workflow rare et coûteux.
| Données d’évaluation | Informations à conserver | Intérêt |
|---|---|---|
| Tâche et référence | ID de tâche, version de l’entrée, résultat attendu, règles d’erreur critique | Stabiliser les annotations et le périmètre |
| Contrat de requête | modèle demandé, identité retournée si disponible, canal, réflexion, budget, outils | Exposer les valeurs par défaut et différences de routage |
| Résultat | validation au premier essai, validation finale, catégorie d’échec, état de revue | Empêcher le style de remplacer l’exactitude |
| Temps | premier token, fin de génération, instant du résultat validé | Distinguer réactivité et achèvement |
| Utilisation | entrée hors cache, lectures de cache, sortie visible, réflexion, recherches et nouvelles tentatives | Permettre un rapprochement complet de la facture |
| Contexte de déploiement | version de l’application, réponses d’outils de test, concurrence et timeout | Rendre les changements reproductibles |
Répétez les tâches variables si nécessaire et indiquez leur variabilité. Un petit échantillon peut révéler une régression évidente, sans prouver la stabilité de la latence en queue de distribution ni un taux d’erreurs rares. Déterminez taille d’échantillon et fenêtre de production selon l’échec à détecter. Une mesure absente reste absente, elle ne vaut pas zéro.
Calculer le seuil de rentabilité du travail validé
Pour une référence fournisseur datée, les tarifs Google Standard vérifiés le 12 novembre placent Hydrogen à $1.50 en entrée et $7.50 en sortie par million de tokens, contre $0.75 et $3.75 pour 3.8 Flash jusqu’au 31 décembre 2026. Ces deux tarifs actuels par token sont deux fois plus élevés, sans prouver un coût par tâche doublé. Google affiche des tarifs de $1.50 et $7.50 pour 3.8 à partir du 1er janvier 2027. Revérifiez la période d’application, le cache et les conditions des outils ; ce sont des tarifs de référence du fournisseur direct, pas des devis pour un compte EvoLink.
Conservez une seule définition :
coût API par tâche validée = toutes les dépenses API et outils du lot / tâches validéesLe numérateur inclut essais infructueux, nouvelles tentatives et appels de repli. Comptez chaque ID de tâche d’origine au plus une fois au dénominateur. Distinguez les tâches achevées des demandes de précision ou des cas à réviser qui restent inachevés malgré une gestion sûre, sauf si le contrat de tâche défini à l’avance considère cette issue elle-même comme un résultat achevé. Si le dénominateur vaut zéro, le résultat est indéfini, pas avantageux. Publiez aussi la proportion de tâches ayant abouti, puisqu’une politique rejetant les cas difficiles peut réduire la dépense sans fournir un travail équivalent. Si les corrections humaines comptent, présentez un coût combiné distinct en utilisant le même coût unitaire du travail, par exemple en dollars par minute de revue, mais la fréquence et la durée de revue réellement observées pour chaque route.
| Scénario pour 1 000 tâches entrantes | Dépenses API/outils totales | Tâches validées | Coût par tâche validée |
|---|---|---|---|
| Référence fonctionnelle | $8 | 800 | $0.0100 |
| Candidat A | $12 | 960 | $0.0125 |
| Candidat B | $9 | 960 | $0.009375 |
Le candidat A livre davantage de tâches validées, mais ne coûte pas moins cher par tâche validée. Son adoption peut rester intéressante si la couverture supplémentaire a de la valeur ; c’est un choix métier, pas une économie démontrée. Le candidat B améliore les deux mesures dans les hypothèses données. Aucune ligne ne prédit le comportement réel d’un modèle.
c_H / a_H < c_F / a_F, où c est la dépense API/outils moyenne par tâche entrante et a la fraction validée avec la même grille. Utilisez les dépenses réelles du parcours complet. Ne remplacez pas c par le prix d’une seule réponse si la politique prévoit plusieurs essais.Rapprochez aussi les catégories de tokens. Si l’utilisation du prompt inclut des succès de cache, retranchez-les avant de remplir l’entrée hors cache du calculateur. Si le raisonnement est déjà dans completion_tokens, ne l’ajoutez pas deux fois. Les champs natifs et compatibles doivent être mappés séparément vers les mêmes catégories de facturation.
Passer du rejeu au mode fantôme, puis à un canary réversible
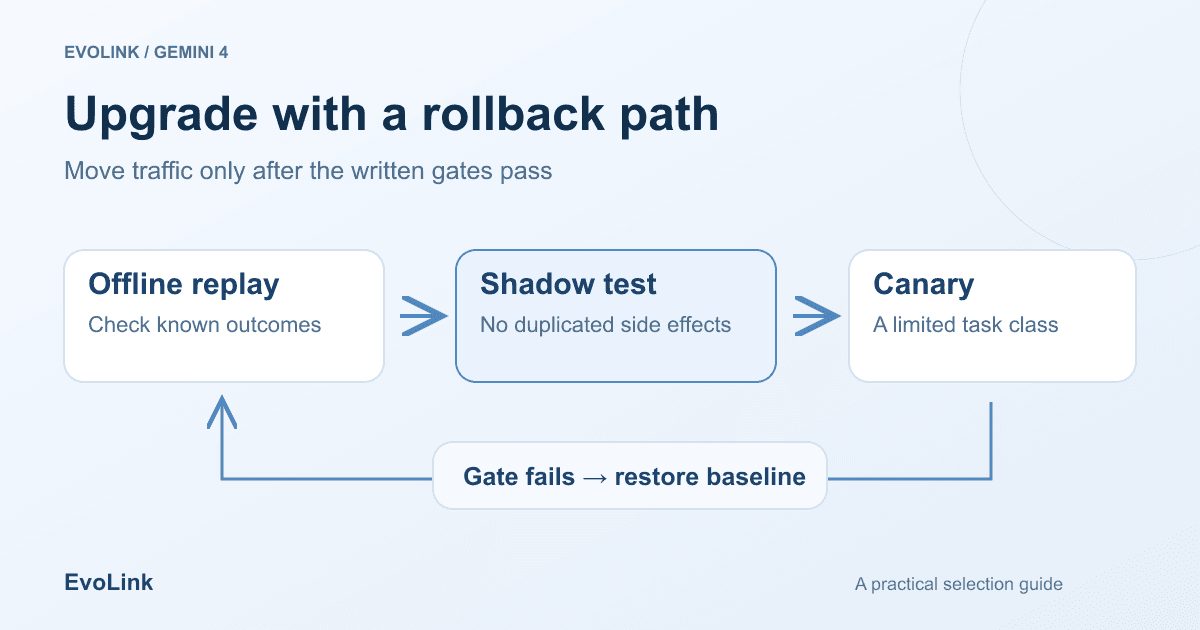
L’API unifiée d’EvoLink réduit le travail nécessaire pour garder plusieurs choix de modèles disponibles. L’application reste responsable de l’évaluation, de la répartition du trafic et du repli. Ce guide ne décrit ni migration automatique ni politique intégrée qui choisit toujours le modèle aboutissant au coût minimal.
Quand rester sur 3.8 est-il justifié ?
Conservez 3.8 lorsqu’il passe la validation et que le candidat ajoute coût ou risque sans bénéfice matériel. C’est particulièrement raisonnable pour des tâches stables avec peu de marge d’exactitude restante, un budget de latence sensible aux changements de réflexion ou un client dont le cache et l’état doivent être revus avant migration.
FAQ
Hydrogen est-il meilleur que Gemini 3.8 Flash ?
Google recommande la migration, mais cet article ne démontre aucun vainqueur universel. Évaluez résultats validés, erreurs critiques, temps d’achèvement et coût du parcours complet sur vos tâches.
Faut-il migrer immédiatement après la sortie ?
Aucune échéance de migration n’est établie ici. Gardez une référence fonctionnelle pendant la validation du candidat et vérifiez séparément les annonces de dépréciation.
Changer l’identifiant du modèle suffit-il ?
Cela commence la sélection, sans résoudre budget de contexte partagé, valeurs de réflexion par défaut, caches explicites, état des outils ou sorties longues. Vérifiez ces éléments pour le protocole choisi.
Peut-on comparer les niveaux de réflexion par défaut ?
Oui, pour comparer des politiques de déploiement prévues, à condition d’indiquer la différence. Ce n’est pas un benchmark à réglages égaux. Ajoutez une comparaison contrôlée avec des niveaux explicitement définis lorsqu’ils sont pris en charge.
Puis-je réutiliser un cache explicite créé pour 3.8 ?
N’en dépendez pas : le guide de migration Hydrogen supprime le cache explicite. Validez le comportement implicite de la passerelle et rapprochez l’utilisation réelle.
Un flux plus rapide signifie-t-il une tâche achevée plus vite ?
Pas nécessairement. Tests, exécution des outils, reprises et révision peuvent dominer l’attente. Distinguez premier token et résultat validé.
Comment éviter de compter deux fois le coût de réflexion ?
Mappez les champs vers les catégories facturables du protocole. Le raisonnement détaillé à l’intérieur de completion_tokens est déjà inclus. Ajoutez la réflexion native séparée uniquement si elle est exclue du compte de sortie visible.
Qu’est-ce qui doit déclencher un retour arrière ?
Des violations prédéfinies des limites d’erreur critique, de qualité, de coût par tâche validée ou de temps d’achèvement. Restaurez l’ancien modèle avec sa configuration compatible, puis enquêtez avec les journaux de tâches.
Sources et notes de vérification
- Migration Hydrogen chez Google : valeurs par défaut du fournisseur, changements de cache et de contexte.
- Spécifications Google d’Hydrogen : limites et capacités du nouveau modèle.
- Spécifications Google de 3.8 Flash : référence précédente.
- Tarifs de l’API Google Gemini : référence commerciale propre au canal.
- Référence API native EvoLink Gemini : contrat de requête de la passerelle.
Vérifié le 12 novembre 2026. Les tâches, seuils et exemples en dollars sont des méthodes analytiques, pas des tests contrôlés de modèles. Pendant le déploiement, utilisez les tarifs actuels de votre compte EvoLink et les réglages pris en charge par la route choisie.