Gemini 4 Hydrogen vs Argon : quel modèle pour quelle tâche ?
Un guide de routage en production entre Hydrogen et Argon : répartition des tâches, coût complet, signaux d’escalade et limites du repli.
 EvoLink TeamÉquipe produit
Dans cet article
Aucun résultat contrôlé Hydrogen-versus-Argon sur un workload n’est présenté ici. La référence fonctionnelle vient des documents du fournisseur ; politiques, exemples et formules sont des conseils de conception applicative.
Dans les recommandations de sélection de Google, Hydrogen est un candidat pour la programmation courante, le travail documentaire multimodal et l’exécution parallèle ; Argon est positionné pour les tâches avancées de longue haleine. C’est le positionnement du fournisseur, pas une répartition mesurée de votre trafic. Un service travaillant sur un dépôt peut, par exemple, évaluer les modifications courantes couvertes par des tests sur une route et l’analyse d’échecs entre modules sur une autre, avec la même révision du dépôt et les mêmes contrôles de validation. Ne déployez l’une ou l’autre affectation que si les résultats la justifient.
Gemini 4 Hydrogen vs Argon : capacités et limites communes
| Critère | Hydrogen chez le fournisseur | Argon chez le fournisseur | À vérifier sur EvoLink |
|---|---|---|---|
| Contexte partagé | 1 048 576 tokens entre entrée, réflexion et sortie | Même conception de fenêtre partagée | Limites du protocole et place restante après l’entrée |
| Sortie longue | Décodage long au-delà d’une étape synchrone | Décodage long pris en charge | Continuation native ; ne pas en déduire la compatibilité de l’autre protocole |
| Réflexion | low, medium, high, xhigh ; valeur par défaut high | low, medium, high ; valeur par défaut medium dans la comparaison Google | Valeurs prises en charge et réglage explicitement choisi |
| Étape sans streaming | Google documente jusqu’à 65 536 | Google compare une limite REST de 32 768 | Contrat réel de la passerelle et comportement du SDK |
| Outils et sorties structurées | Capacités prises en charge | Capacités prises en charge | Schémas, signatures de réflexion, erreurs et exécution des outils |
| Prix | Modèle et calendrier commercial distincts | Modèle et calendrier commercial distincts | Tarif du compte, entrée en cache et outils compris |
xhigh, proposé par le fournisseur, comme activé tant que la documentation de la route ne le confirme pas. De même, une différence de limite REST chez Google ne prouve pas que votre passerelle applique silencieusement cette même différence.N’en faites pas un récit d’architecture spéculative. « Argon distillé » n’est établi ni par une échelle de prix, ni par un nom d’élément, ni par des réponses similaires. Pour l’exploitation, ce sont l’interface prise en charge et la qualité des tâches validées sous votre configuration qui comptent.
Choisir une route selon le coût d’un échec
Partez du contrat de sortie et des conséquences d’une erreur. Un modèle peut être un bon premier candidat pour une tâche sans constituer la route la plus sûre pour une variante plus importante. Enregistrez les catégories séparément pour qu’une moyenne ne masque pas une erreur critique.
| Workload | Politique d’évaluation initiale | Test de validation | Quand la politique initiale ne suffit plus |
|---|---|---|---|
| Extraction de champs fixes dans un document | Tester Hydrogen face à la route actuelle | Champs requis, valeurs exactes, unités et preuves sources | Erreur sur des champs critiques ou ambiguïté non résolue |
| Maintenance de dépôt | Comparer les deux sur des tâches reproductibles | Tests réussis, périmètre respecté, revue acceptable | Échecs difficiles persistants qu’Argon résout de façon démontrable |
| Agent avec plusieurs étapes d’outils | Commencer par la route qui atteint déjà l’objectif, puis tester l’autre | Outils autorisés achevés et réponse fidèle aux résultats | Échecs répétés de requêtes valides malgré des outils fiables |
| Rapport long ou spécification générée | Vérifier contexte et continuation avant de choisir le modèle | Sections complètes, références valides, sortie reprenable | Reprise incorrecte du client ou preuves manquantes |
| Décision à fort impact sans vérité de référence automatique | Exiger une procédure de revue documentée | Grille examinée par un humain et contrôles d’erreurs critiques | Aucun modèle ne peut fournir les preuves ou l’autorité nécessaires |
Pour l’extraction, il ne s’agit pas de savoir si Argon paraît plus prudent, mais s’il corrige un échec précis face à une référence. Pour le code, vérifiez s’il répare le comportement sans nouvelle régression. Pour un agent, distinguez une erreur de modèle d’une panne d’outil : changer de modèle ne rétablit pas une base de données indisponible et n’accorde aucune permission manquante.
« Exécutant » ou « vérificateur » désigne un rôle proposé dans l’application, pas un niveau de capacité garanti par le nom. Évaluez aussi le vérificateur. Deux modèles peuvent s’accorder sur une réponse non étayée ; cet accord n’est pas une source de vérité indépendante.
Choisir entre routage direct et escalade
Trois politiques constituent des points de départ utiles. Comparez-les sur la même population de tâches entrantes, avec la même définition du travail validé.
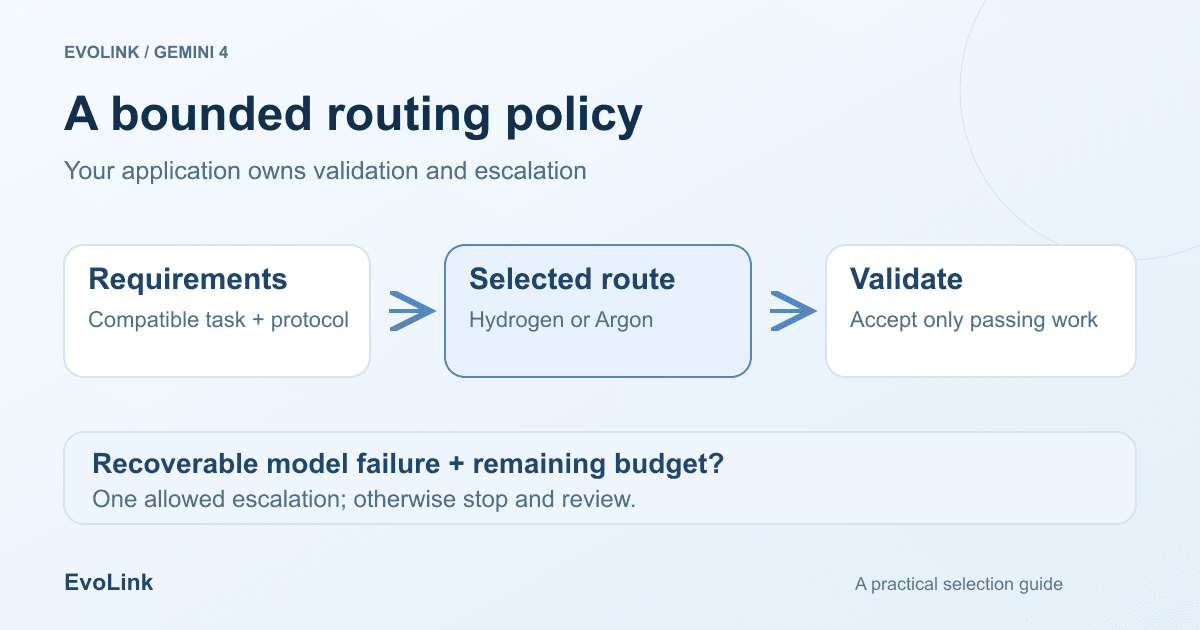
Un arbre de décision pratique suit cet ordre :
- Vérifier les exigences bloquantes. Le protocole accepte-t-il l’entrée, expose-t-il l’outil et prend-il en charge la sortie voulue ? Écartez les routes incompatibles avant de comparer la qualité.
- Utiliser les résultats évalués par catégorie. Choisissez la route directe qui respecte qualité, latence et coût pour cette catégorie. Sans ces preuves, lancez une évaluation bornée plutôt que supposer un vainqueur.
- Valider la réponse. Appliquez contrôles de schéma, exécution, preuves et autorisations. N’acceptez que ce qui satisfait les exigences.
- Classer l’échec. Preuves manquantes, outils indisponibles, permissions refusées, données mal formées et véritable erreur de raisonnement demandent des traitements différents.
- Escalader uniquement un échec de modèle récupérable. Transmettez les preuves d’origine pertinentes et le retour de validation, vérifiez temps et budget restants, puis autorisez la seconde tentative.
- S’arrêter à la limite de la politique. Si le second essai échoue, renvoyez un état explicite incomplet/à réviser. Ne faites pas tourner les modèles jusqu’à obtenir une réponse convaincante.
Ce sont des conseils d’orchestration applicative. Ils ne décrivent pas une fonction intégrée d’EvoLink évaluant automatiquement les réponses ou envoyant chaque échec vers un meilleur modèle.
Chiffrer la route complète, échecs compris
Pour une politique d’escalade, définissez :
c_H: coût API/outils complet moyen de l’étape Hydrogen par tâche entrante, nouvelles tentatives autorisées de cette étape comprises ;r: fraction de toutes les tâches entrantes qui atteignent réellement Argon ;c_A: coût API/outils complet moyen de l’étape Argon pour une tâche escaladée ;a: fraction des tâches d’origine qui satisfont finalement la grille de validation commune.
On obtient :
coût API/outils moyen par tâche entrante = c_H + r × c_Acoût API/outils par tâche validée = (c_H + r × c_A) / aLa seconde expression est indéfinie si a vaut zéro. Si vous comptez le temps de revue, ajoutez explicitement son coût attendu plutôt que présenter l’API seule comme le coût métier total. Population et règles de validation doivent rester identiques entre politiques.
Affectez la validation facturable par un modèle à l’étape qui l’appelle. Si un modèle ou un service distinct évalue la réponse en dehors de ces étapes, ajoutez son coût attendu au numérateur avant de diviser par le taux de validation. Présentez séparément l’exécution locale de tests ou les autres coûts d’infrastructure lorsqu’ils sortent de votre définition des dépenses API/outils.
| Politique | Dépenses API/outils totales | Tâches d’origine validées | Coût API/outils par tâche validée |
|---|---|---|---|
| Hydrogen seul | $6 | 800 | $0.0075 |
| Argon seul | $12 | 960 | $0.0125 |
| Hydrogen puis Argon pour 200 tâches à $0.012 chacune | $8.40 | 950 | Environ $0.00884 |
Pour la troisième ligne, $6 + 200 × $0.012 = $8.40. Si Hydrogen a validé 800 tâches d’origine, un total de 950 signifie que 150 des 200 escalades ont apporté une tâche validée supplémentaire. Ce sont des hypothèses illustratives, pas des taux observés, des prix de modèles ou une promesse d’économie. Les résultats de chaque politique sont supposés séparément et ne proviennent pas d’un test apparié déterministe : l’escalade peut utiliser le retour de validation et un contexte de requête différent. Mesurez son succès et c_A sur le sous-ensemble réellement escaladé, sans les déduire de la moyenne des appels directs à Argon. Cet exemple suppose une validation locale sans frais supplémentaires d’API de modèle ; ajoutez tout coût de validateur facturable comme décrit plus haut.
La politique peut vite perdre son intérêt. Si trop de tâches sont escaladées, la première étape ajoute du coût avant la route que vous auriez choisie directement. Si le validateur manque les mauvaises réponses, le taux annoncé est trompeur. S’il rejette des réponses justes, les escalades inutiles coûtent du temps et de l’argent. Testez le validateur face à des cas annotés par des humains ou des références exécutables.
La latence change aussi. Une tâche escaladée traverse successivement première étape, validation et deuxième étape. Ne faites pas la moyenne de deux p95 mesurés séparément pour l’appeler p95 de la route. Mesurez le délai de bout en bout de la politique réelle et distinguez les cas escaladés, afin qu’une majorité rapide ne masque pas une longue traîne d’échecs lents.
Définir des signaux d’escalade auditables
Un signal utile correspond à une exigence de tâche non satisfaite. Une autoévaluation vague comme « je ne suis pas sûr » peut être un élément à examiner, mais ne doit pas autoriser une dépense illimitée.
| Signal | Première action | Quand un autre modèle est raisonnable | Condition d’arrêt |
|---|---|---|---|
| Échec d’un schéma ou contrôle de type requis | Vérifier requête et schéma | La requête valide reste insatisfaite et l’alternative a réussi cette catégorie d’échec en évaluation | Une escalade autorisée ou budget atteint |
| Échec d’un test exécutable | Conserver résultat du test et contexte d’origine pertinent | Une correction au niveau du modèle est plausible et sûre à essayer | Échec persistant ou élargissement du périmètre |
| Référence non étayée | Vérifier que la source contient la réponse | Une autre interprétation n’aide que si les preuves existent | Preuves absentes : les demander ou faire réviser |
| Timeout d’outil | Appliquer la politique de reprise du service | Un changement de modèle ne rétablit pas le service | Timeout ou échéance atteint |
| Permission refusée | Respecter le refus | Ne jamais contourner l’autorisation avec un autre modèle | Arrêter l’opération non autorisée |
| Contexte trop grand | Réduire/récupérer les preuves utiles ou changer le workflow | Seulement si l’autre route offre réellement une capacité compatible | Aucune route ne convient sûrement |
Par exemple, un script de migration généré qui échoue à un test reproductible peut transmettre cet échec à une tentative Argon. Une réponse d’outil « permission denied » ne doit pas suivre ce chemin. Une signature PDF illisible ne devient pas une preuve fiable parce qu’un second modèle devine le même nom.
Évitez les écritures répétées pendant l’escalade. Si une première tentative a peut-être déjà exécuté l’opération, rapprochez son état avant de réessayer. Conservez les identifiants d’idempotence et laissez la couche d’exécution responsable des effets de bord. Le choix de modèle ne supprime pas la frontière transactionnelle de l’application.
Préserver l’état sans supposer sa portabilité
previous_interaction_id, un token de continuation natif ou un objet d’état soit accepté par un endpoint de passerelle distinct.Pour une escalade gérée par l’application, construisez la requête suivante avec les preuves d’origine autorisées et une description explicite de l’échec. Ne faites pas des conclusions non étayées du premier modèle une vérité de référence. Si le transfert d’état n’est pas documenté, commencez une nouvelle requête prise en charge et comptez l’entrée répétée ; masquer ce coût fausserait le comparatif.
Nommez et versionnez les configurations. Une cible de retour arrière comprend modèle, niveau de réflexion pris en charge, version du prompt, schéma et politique d’outils. Vous évitez ainsi de restaurer un modèle tout en gardant un réglage que le repli refuse.
Déployer la politique avant d’en faire le choix par défaut
Évaluez les deux routes directes avant la cascade. Sans cela, vous ne saurez pas si la couche supplémentaire apporte une amélioration. Figez un ensemble annoté de tâches ordinaires, difficiles et d’échecs connus, puis testez Hydrogen direct, Argon direct et le parcours d’escalade proposé. Enregistrez tous les essais sous l’ID de la tâche d’origine.
Examinez les désaccords entre modèle et validateur. Révisez les erreurs critiques même si le coût moyen s’améliore. Le contrôle doit rester assez indépendant pour détecter les réponses fausses mais assurées ; un vérificateur qui répète simplement l’explication initiale n’est pas un garde-fou solide.
Exécutez ensuite une politique fantôme autorisée, sans effets de bord. Confirmez distribution réelle des entrées, gestion d’état, fréquence effective d’escalade et utilisation complète. Passez alors à un canary limité avec seuils écrits pour erreurs critiques, coût par tâche validée, délai et actions d’outils. Gardez une route directe immédiatement sélectionnable et un opérateur capable de désactiver la politique.
Ne forcez pas toutes les requêtes dans la cascade. Les catégories connues comme difficiles peuvent être moins chères et plus rapides sur une route directe. Les tâches simples déjà validées peuvent se passer du second modèle. Sans tests de validation fiables, une revue humaine ou un résultat clairement incomplet peut être préférable à un autre essai automatique.
FAQ
Toutes les tâches doivent-elles commencer par Hydrogen parce que ses tokens coûtent moins cher ?
Non. Testez coût complet et résultats. Une tâche presque toujours escaladée peut être mieux servie directement par sa route éprouvée.
Hydrogen est-il une version distillée d’Argon ?
Aucune preuve primaire de cette architecture n’est établie ici. Utilisez identité documentée et comportement pris en charge plutôt que déduire l’entraînement du positionnement.
Argon donne-t-il toujours une meilleure réponse ?
Aucun résultat universel de ce type n’est établi. Comparez les deux à une référence propre à la tâche, cas difficiles et erreurs critiques compris.
Une sortie longue justifie-t-elle Argon plutôt qu’Hydrogen ?
Les deux modèles du fournisseur documentent le décodage long. Vérifiez contexte partagé, limites par étape et continuation du protocole choisi ; une fonction commune n’est pas un avantage exclusif d’Argon.
Quand faut-il passer à Argon ?
Lorsqu’un échec de modèle détectable et récupérable subsiste, que l’évaluation montre l’utilité de l’alternative pour ce cas et qu’il reste temps et budget. Permissions ou preuves manquantes demandent une autre réponse.
Le second modèle peut-il vérifier automatiquement le premier ?
Il peut participer à une revue proposée, mais l’accord ne prouve pas l’exactitude. Évaluez le vérificateur et utilisez au besoin tests exécutables, preuves sources ou revue humaine.
Puis-je réutiliser historique, cache et continuation entre modèles ?
Seulement là où le protocole le documente. Préservez correctement l’historique, ne déplacez pas aveuglément les tokens propres à un modèle et comptez l’entrée répétée si vous repartez sur une nouvelle requête.
Quand arrêter les nouvelles tentatives ?
À la limite écrite d’essais, de temps ou de dépenses, ou lorsqu’un nouvel appel ne peut pas corriger l’échec. Renvoyez un état clair incomplet/à réviser plutôt qu’une boucle sans fin entre modèles.
Sources et limites des affirmations
- Spécifications Google d’Hydrogen.
- Spécifications Google d’Argon.
- Migration Hydrogen entre modèles chez Google.
- Tarifs de l’API Google Gemini.
- Référence native EvoLink Gemini.
Vérifié le 12 novembre 2026. Les spécifications du fournisseur sont propres au canal. Affectations de tâches, règles de routage et exemple des 1 000 tâches sont des propositions de conception, pas un benchmark publié ni une description d’un routage automatique EvoLink.