Gemini 4 Hydrogen est sorti : fonctions et adoption
Gemini 4 Hydrogen est disponible sur EvoLink. Reliez ses entrées multimodales, sa réflexion réglable et son contexte partagé à vos tâches de code, documents et outils.
 EvoLink TeamÉquipe produit
Dans cet article
gemini-4-hydrogen. Pour une équipe qui choisit ses modèles via EvoLink, la question utile est désormais de savoir quelle tâche mérite une évaluation contrôlée. Un nouveau nom ne justifie pas à lui seul le remplacement d’une route qui fonctionne.Ce que la sortie confirme réellement
La publication change les éléments disponibles. Les articles précédents décrivaient un nom de code de la famille Flash et des apparitions en tests à l’aveugle ; la documentation datée de Google établit maintenant l’existence d’un modèle public. Utilisez l’identifiant documenté plutôt qu’un alias Arena supposé. « Gemini 4 Flash » peut expliquer comment un lecteur a découvert le sujet, sans devenir un identifiant de requête inventé ni une affirmation sur l’architecture du modèle.
| Question | Fait confirmé chez le fournisseur | Conséquence pour l’application |
|---|---|---|
| Que peut-il lire ? | Google liste texte, images, audio, vidéo et PDF | Définir un contrat de sortie et évaluer chaque type d’entrée séparément |
| Que renvoie-t-il ? | Du texte, avec sorties structurées et appels de fonctions | Valider les données ; votre application autorise et exécute ses propres outils de fonction |
| Quel est le budget de contexte ? | 1 048 576 tokens partagés entre entrée, réflexion et sortie | Réserver de la place pour la réponse avant de remplir le contexte |
| Quelle longueur de réponse ? | Une étape synchrone autorise jusqu’à 65 536 tokens de réflexion et de réponse au total ; le décodage long prolonge le workflow | Traiter les longues générations comme un processus reprenable |
| Comment régler la réflexion ? | Le fournisseur documente low, medium, high et xhigh ; high est la valeur par défaut | Fixer explicitement un niveau pris en charge et mesurer son coût complet |
| Comment fonctionne le cache ? | Cache implicite ; création explicite de cache non prise en charge | Réexaminer les intégrations fondées sur des caches explicites |
xhigh chez le fournisseur ne démontre pas à lui seul que ce paramètre est pris en charge par la passerelle. Vérifiez également le protocole pour les formats de fichiers réservés à l’API native et la gestion des sorties longues.Des fonctions Gemini 4 Hydrogen à relier à des tâches vérifiables
Une capacité compte lorsqu’elle modifie une tâche que vous pouvez vérifier. « Accepte les images » ne définit pas une politique de traitement documentaire, et « appelle des fonctions » ne mesure pas l’achèvement d’un agent. Commencez par une tâche délimitée, un contrat de sortie clair et une méthode pour rejeter les réponses plausibles mais incorrectes.
Compréhension documentaire : produire un enregistrement vérifié à partir des preuves
Imaginez une application d’intégration de fournisseurs qui lit une spécification produit de plusieurs pages. Elle pourrait extraire les températures de fonctionnement, les certifications et la page justifiant chaque valeur. Demandez des références aux sources et une représentation explicite des données absentes ; n’invitez pas le modèle à compléter un tableau incomplet avec ses connaissances générales.
Le contrat de validation comporte trois niveaux. D’abord, la réponse respecte le schéma. Ensuite, chaque valeur correspond au document fourni, unités et réserves comprises. Enfin, l’application gère les absences et contradictions : envoyer un tableau illisible en révision, distinguer « non indiqué » de « non pris en charge » et rejeter une référence pointant vers la mauvaise page. Un enregistrement syntaxiquement valide peut échouer aux deux autres niveaux.
C’est une bonne première évaluation parce que les erreurs de champ sont vérifiables. Incluez des pages numérisées, des versions contradictoires et des champs absents, pas seulement des exemples propres. Suivez les enregistrements validés, le taux de révision manuelle et l’utilisation facturée de toutes les tentatives. Un contexte plus large peut contenir davantage de preuves, sans garantir que le modèle résolve correctement les conflits de version.
Programmation : juger une modification qui fonctionne, pas une démonstration séduisante
Pour un assistant de programmation, choisissez une petite tâche de dépôt dont le comportement est observable : corriger la pagination sans perdre un filtre, ou ajouter une protection d’idempotence autour d’un endpoint existant. Consignez la révision de départ, la commande de test, les fichiers autorisés et les contraintes. Exécutez la modification dans un bac à sable utilisant les mêmes versions de dépendances que la référence.
La tâche réussit lorsque le comportement attendu fonctionne, que les tests pertinents passent et que la modification reste dans le périmètre. Une belle interface qui perd la navigation au clavier ou un correctif plausible supprimant un contrôle de validation doit échouer. Mesurez le temps jusqu’à un résultat révisable, y compris installation, échecs de tests et tours de correction. Le temps de génération ne représente qu’une partie de l’attente de l’utilisateur.
Ne confondez pas une animation produite par du code avec une génération vidéo native. La sortie documentée d’Hydrogen est du texte. Du code peut créer un résultat visuel ou interactif, mais il faut encore l’exécuter et l’inspecter.
Workflows avec outils : exiger une action autorisée et achevée
Un agent de support pourrait lire une commande, vérifier son expédition et proposer une réponse au client. Évaluez s’il choisit un outil autorisé, fournit des identifiants valides, interprète le résultat et s’arrête lorsque des informations manquent. Pour vos propres outils de fonction, l’application, et non le modèle, vérifie les droits et effectue les actions ayant des effets de bord. Les outils gérés par le fournisseur, comme Google Search, ont leur propre contrat d’exécution et de facturation.
Conservez les exigences du protocole concernant l’historique et les signatures de réflexion. Incluez un timeout d’outil et un refus d’autorisation dans le jeu de test. Le modèle ne doit pas inventer un état d’expédition après un échec de recherche ni répéter aveuglément une écriture. Distinguez tâches achevées et escalades sûres : un refus correct peut être préférable à une fausse confirmation convaincante.
| Workflow | Preuves à conserver | Échec qui doit empêcher l’acceptation automatique |
|---|---|---|
| Extraction de documents produit | Page source, unités, schéma et valeurs de référence | Valeur sans preuve, version contradictoire ou document illisible |
| Modification d’un dépôt | Révision de départ, correctif, sortie des tests et critères de revue | Régressions, élargissement du périmètre ou échec d’exécution |
| Agent de suivi de commande | Arguments d’outil, résultat d’autorisation et réponse de l’outil | Action non autorisée, statut inventé ou boucle d’outils incomplète |
Le contexte partagé change le budget des tâches longues
À titre de calcul de capacité, 800 000 tokens d’entrée laissent au maximum 248 576 tokens pour réflexion et sortie dans une fenêtre de 1 048 576 tokens. Instructions système, définitions d’outils et autres éléments comptabilisés réduisent cet espace s’ils étaient absents de l’estimation initiale. Il s’agit d’arithmétique, pas d’une réponse observée du modèle ni d’une taille de prompt recommandée.
Avant d’activer une fonction de sortie longue, répondez à ces questions opérationnelles : où stocker la sortie partielle, que faire après une déconnexion, comment éviter d’ajouter deux fois le même segment et quand considérer un document partiel comme inutilisable ? Les motifs d’arrêt, l’utilisation cumulée et une échéance globale doivent faire partie de l’implémentation. Une limite d’un million de tokens ne supprime pas ces exigences.
La réflexion règle le travail, sans garantir la qualité
xhigh chez le fournisseur donne un réglage supplémentaire à évaluer. Il n’impose pas un nouveau réglage par défaut à toutes les applications et ne prouve pas qu’une passerelle l’expose. Google recommande de réserver le niveau supérieur aux tâches difficiles et signale un coût en tokens et une latence accrus. Vérifiez d’abord les contrôles pris en charge sur la route choisie.Pour l’extraction, comparez exactitude des champs et taux de valeurs non étayées. Pour le code, comparez tests et tours de correction. Pour les outils, comparez opérations achevées et gestion sûre des échecs. Modifiez le niveau de réflexion en gardant les mêmes critères de validation. Conservez un réglage parce qu’il aide la tâche, pas parce que son nom paraît plus puissant.
Fixez la configuration explicitement pendant les comparaisons. Sinon, un changement de valeur par défaut peut être pris pour un progrès de génération. Le plafond de sortie comprend aussi la réflexion : une requête peut épuiser son budget avant de produire assez de texte visible. Consignez le budget demandé et l’utilisation retournée pour distinguer une réponse tronquée d’un manque de connaissances.
La disponibilité dépend du canal concerné
| Canal, vérifié le 12 novembre | Ce que les preuves disponibles établissent | Vérification nécessaire avant d’en dépendre |
|---|---|---|
| API Google Gemini | Disponibilité générale officielle et identifiant documenté | Éligibilité du projet, quotas, conditions et surface API |
| Google AI Studio | Le guide de migration officiel mentionne l’accès | Accès réel de votre compte et conditions d’utilisation |
| Application Gemini grand public | Les témoignages sont propres à certains comptes | Compte, région et fonctions actuellement disponibles |
| Produit Antigravity pour ordinateur | Un sélecteur de modèles est un signal produit distinct | Modèle réellement retourné et droits du compte |
| Agent Antigravity géré par Google | Les notes officielles désignent Hydrogen comme modèle par défaut | Contrat de l’agent géré ; cela ne prouve rien pour tous les produits Antigravity |
| EvoLink | Hydrogen est disponible via l’API unifiée | Tarifs actuels du compte, protocole choisi et réglages pris en charge |
Ce tableau évite deux confusions fréquentes. Un abonnement grand public n’est pas un contrat de facturation API. Et une nouvelle fonction du fournisseur ne prouve pas qu’une passerelle a implémenté chaque paramètre. EvoLink fournit un point d’intégration cohérent pour comparer et choisir des routes prises en charge ; les contrôles et limites propres à chaque canal subsistent.
Estimer la tâche achevée plutôt que sa première réponse
Pour préparer l’application, additionnez entrée hors cache, lectures de cache, sortie facturable et frais d’outils sur toutes les tentatives. Séparez le coût des corrections humaines si vous le mesurez. Divisez la somme pertinente par les tâches validées et publiez aussi le taux d’échec, afin que le rejet de tâches difficiles ne fasse pas paraître une route artificiellement efficace.
Organiser une première évaluation délimitée
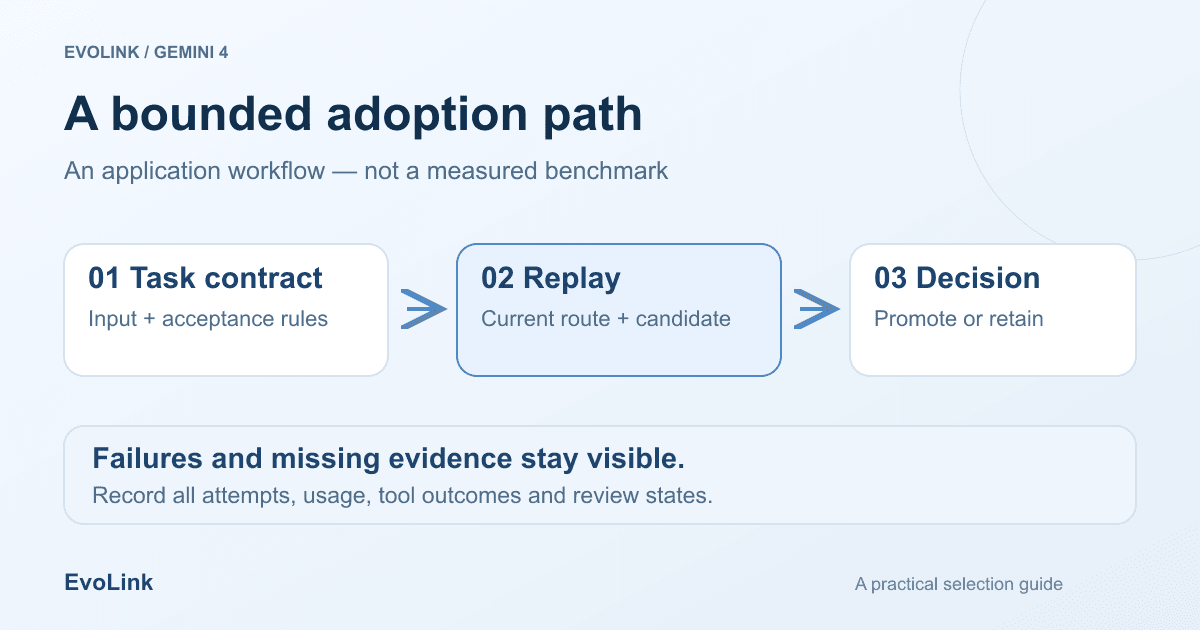
Commencez par un workload dont vous savez expliquer les échecs. Un dossier d’évaluation utile contient entrées, critères de validation, sorties de référence actuelles, catégories d’échec, jeux de réponses d’outils et budget. Gardez les sources sensibles dans le cadre de votre politique de traitement des données ; le lancement d’un modèle ne justifie pas de changer cette politique.
Rejouez le workload sur le modèle actuel et le candidat Hydrogen. Incluez cas ordinaires et échecs connus, enregistrez la configuration de chaque tentative et notez les résultats selon les critères écrits. Examinez les désaccords : un score agrégé plus élevé peut masquer une régression critique dans une catégorie rare mais importante.
Ne promouvez que la catégorie de tâches qui satisfait vos exigences. Un petit périmètre en production doit disposer d’un repli configuré, d’un budget d’erreur et d’un responsable capable de désactiver le candidat. Laissez le trafic sans rapport sur sa route qui fonctionne. Ce sont des recommandations de déploiement pour l’application, pas une affirmation qu’EvoLink évalue ou gère le repli automatiquement.
FAQ
Quand Gemini 4 Hydrogen est-il sorti ?
Les notes de version de l’API Gemini indiquent une disponibilité générale le 12 novembre 2026. L’accès et les conditions commerciales dépendent toujours du produit et du compte utilisés.
Hydrogen correspond-il au Gemini 4 Flash des rumeurs ?
Flash est un repère historique utile pour la recherche, mais utilisez le nom public Gemini 4 Hydrogen et son identifiant documenté. Un alias communautaire ne prouve ni une architecture, ni un identifiant supplémentaire utilisable, ni l’identité d’un ancien test à l’aveugle.
Est-il automatiquement disponible dans tous les produits Gemini ?
Une seule note de version ne le prouve pas. API Google, AI Studio, applications grand public, agents gérés, produits IDE et passerelles demandent des vérifications distinctes.
Génère-t-il des images, du son ou de la vidéo ?
Google documente des entrées multimodales et une sortie texte. Comprendre des médias ou produire du code qui affiche une animation diffère de la génération native d’images, de son ou de vidéo.
Faut-il toujours choisir xhigh ?
Uniquement sur une route qui le prend en charge, lorsque les résultats mesurés justifient le temps et les tokens supplémentaires. Les réglages documentés de l’intégration EvoLink doivent être vérifiés indépendamment de l’annonce du fournisseur.
Une requête ordinaire peut-elle renvoyer un million de tokens de réponse ?
Ne prenez pas le plafond du décodage long pour une garantie de réponse unique. Entrée et réflexion partagent la fenêtre ; une longue sortie exige le mécanisme de continuation ou d’arrière-plan pris en charge par l’API concernée.
Dois-je remplacer immédiatement 3.8 Flash ou Argon ?
Conservez une route qui fonctionne jusqu’à ce qu’une évaluation représentative justifie un changement. Les deux guides traitent de décisions différentes : remplacer une référence et répartir des tâches entre modèles.
Par où commencer sur EvoLink ?
Ouvrez la page d’Hydrogen, déjà disponible sur EvoLink, vérifiez les tarifs actuels de votre compte, définissez l’entrée et le contrat de validation, puis exécutez une première tâche bornée avec le protocole pris en charge.
Sources et limites des affirmations
- Notes de version de l’API Google Gemini : date de sortie et cycle de vie chez le fournisseur.
- Spécifications Google d’Hydrogen : modalités, contexte et capacités de référence.
- Changements et migration Hydrogen chez Google : réflexion et conception du décodage long.
- Tarifs Standard de Google : référence commerciale du fournisseur, vérifiée le 12 novembre 2026.
- Documentation native EvoLink : référence du protocole de passerelle.
Les workflows proposés sont des contrats de validation. Ils ne constituent ni des benchmarks Hydrogen publiés, ni des tests d’accès d’un compte, ni des économies mesurées dans une application.