
Kimi K3.1 Pro レビュー:コーディング、3D、調査能力
Kimi K3.1 Pro のコード修正、Blender・CAD、データ分析、推論の待ち時間を、公開評価と具体的なタスクから解説します。
 EvoLink Team
目次
Kimi K3.1 Pro の公開テストでは、コード修正やデータ調査の成功例に加え、ブラウザーでの検証不足やデータのグループ分けの誤りも確認されています。Moonshot AI の公式 3D 作例からは、Blender や CAD ツールを使って、構造を持つシーンやオブジェクトを作成する様子も分かります。
実務で知りたいのは、成果物がどの程度機能するのか、何を確認すべきか、最終回答までにどれだけ時間がかかるのかという点です。Artificial Analysis、Atomic Agent、PacBench、Plotly の具体的な結果を、Moonshot AI の公式作例と合わせて見ていきます。
Kimi K3.1 Pro レビュー:コーディング、エージェント、推論の評価
Artificial Analysis が 2026 年 10 月 23 日に公開した評価は、ターミナル操作、SaaS ワークフロー、知識労働、難度の高い推論問題を対象としています。
| 評価 | K3.1 Pro の結果 | 主な評価対象 |
|---|---|---|
| Terminal-Bench 4.0 | 67% | ターミナル環境でのコーディングと操作 |
| AutomationBench-AA | 73% | エージェントによる SaaS ワークフローの実行 |
| GDPval-AA | 1,846 Elo | 知識労働の成果物に対する相対評価 |
| Humanity’s Last Exam | 52% | 高難度の知識・推論問題 |
この四つは、それぞれ別の仕事を見ています。ターミナルと SaaS のタスクでは環境内で操作する能力を、知識労働の評価では成果物を確認します。難問への回答では、複雑な推論を経て正解に到達する力が加わります。ある分野で好成績でも、ワークフローの別の段階に弱点が残ることはあります。
開発者にとって、この違いはコーディングのベンチマークと生成アプリの印象が食い違う理由になります。リポジトリの課題を解くには、ファイルを読み、修正し、検査を実行し、失敗を解釈します。対話型アプリの納品には、さらに操作、描画、起動後に利用者が体験する動作が加わります。以下の事例では、その違いを具体的に確認できます。
コーディング:コード修正と長時間のタスク
Python の修正課題で比較した low と max
Atomic Agent は、意図的に五つの不具合と二つの未実装機能を入れた Python パッケージを使ってテストしました。未実装だったのは決済処理関数とコマンドラインツールです。指示は短く、タスクファイルを読み、作業を完了し、テストが通るまで実行するというものでした。各実行では Atomic Agent v0.6.9 を使い、課題とツールをそろえています。
推論設定ごとに三回実行し、各回で 32 件の非公開アサーションを確認しました。これは作業中にエージェントが参照できるテストとは別の検査です。両設定ともすべて通過しました。
| 設定 | 三回の実行で通過したアサーション | 平均時間 | 平均モデル呼び出し回数 |
|---|---|---|---|
| Low | 96/96 | 2.2 分 | 19 回 |
| Max | 96/96 | 4.9 分 | 28 回 |
この課題では low の方が効率的でした。公表された平均値から計算すると、max は約 2.2 倍の時間と約 47% 多いモデル呼び出しを要し、検査の通過結果は同じでした。
コード修正では、完成したパッチを比較するのが有用です。求めた動作を直したか、公開インターフェースを維持したか、無関係な変更を避けたか。推論を増やす価値は、こうした結果が改善したときにあります。説明の長さやツール呼び出し回数は実行の特徴であり、それだけでパッチが良くなるわけではありません。
長いタスクの途中で診断を切り替える
シミュレーターの基盤は human-atlas 解剖モデルで、296 個の骨格コンポーネントと 402 個の筋肉コンポーネントを含みます。Moonshot は、モデルが開ループの動力学テストで腕の動きの問題を調べ、その後に計算を直して再学習したと説明しています。
相互に依存するシステムでは、この順序に意味があります。誤ったシミュレーションでコントローラーを学習させることも、壊れた依存関係やテスト用データに合わせてアプリを調整してしまうこともあります。外側の処理を繰り返し改善しても、根本の欠陥が残る場合があります。この事例では、学習目標から、学習環境を定義するシミュレーターへと調査が移っています。
長い開発タスクでの前進には、依存関係を読む、数値上の前提を検証する、新しい結果を受けて当初の説明を改めるといった診断の転換も含まれます。成果物には、変更ファイル、テストコマンド、測定結果などを残し、別の開発者が作業を引き継げるようにする必要があります。
生成ゲームに残ったブラウザー検証の不足
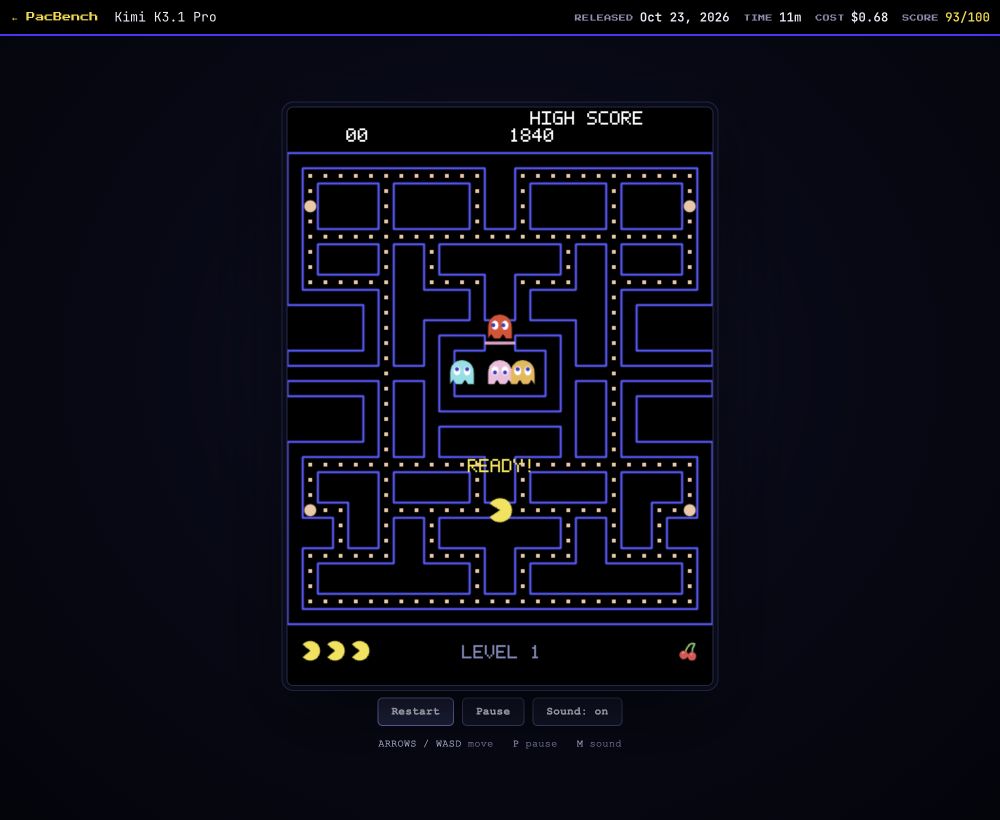
PacBench の K3.1 Pro の記録では high を使用し、モデル応答は 17 回、所要時間は約 11.5 分でした。生成された Pac-Man は実行記録とともに公開され、実際に遊べます。
評価者は正常だった部分も挙げています。昔ながらの 28×31 の迷路、244 個すべてのドットへの到達、検査したフレームレートで移動が止まらないことです。これにより、残った不具合を単なる「動く・動かない」以上の具体性で捉えられます。
残っていたのはブラウザーでの検証です。Node の代替環境はゲームの状態遷移を試せても、キーボードフォーカスやバックグラウンドタブの音はブラウザー固有の動作です。対話型の成果物では、勝利条件の確認と実際のプレイ体験の確認は、別々に完了すべき作業です。
3D モデリング:Blender、CAD と成果物の確認
CAD ベンチマークは何を再構築するのか
指標の Voxel IoU は、生成形状と参照形状のボクセル空間内での重なりを測ります。形の類似度を示す値であり、そのまま実制作に使えるアセットの割合ではありません。もっともらしい画像を作る課題より、物体の構造を復元する課題に近いものです。
見える形から編集可能なアセットへ
個別のアセットは、次の三つの観点から確認できます。
| 観点 | 確認する内容 |
|---|---|
| 全体の形 | 輪郭、比率、空間配置 |
| 局所的な構造 | 接続、遮蔽、対称性、細部 |
| 実際の利用 | ソースファイル、寸法、トポロジー、書き出し結果 |
アセットの確認項目:本記事で整理。
機械部品では、接続部が意図した位置で合っているか、寸法を変えても関係が維持されるかが確認のポイントです。建築シーンでは、繰り返しの部材、開口部、空間の配置を見ます。一つの視点では隠れる交差や接続の欠落を見つけるための検査です。
納品形式も重要です。プレビューは外観の確認に、編集可能なファイルは後の修正に、書き出しデータは別ツールでの利用に役立ちます。最初に必要な形式を指定しておくと、見栄えのよい展示と、次の人が作業を続けられるアセットを区別しやすくなります。
データ分析:Plotly の 42/43 とグループ分けの誤り
モデルは 42 問に合格し、隠れたパターンの五問とデータ品質の三問をすべて通過しました。
質問に書かれていない問題を見つける
データ品質の課題では、K3.1 Pro が重複行や月末最終日の欠損を見つけ、廃止済みでデータのない風車と、実際の発電量がゼロの風車を区別したと Plotly は報告しています。単純集計では似て見えても、これらは別のデータ状態です。
隠れたパターンの問題では、見つける対象を正確に指定されないまま関係を調べる必要もあります。前のクエリの発見に応じて次を決める探索的分析に関わる結果です。
小さなグループ分けの誤りが答えを変える
これでは比較する母集団が変わります。ファームウェア未導入の記録がある場合、「このファームウェアではない」と「別のファームウェアを使っている」は同じグループではありません。未導入状態のデータを加えた時点で、統計検定の前に比較基準が変化しています。
分析手法が慎重に見えても、答えている問いがすでにずれている場合があります。確認は母集団から始めます。各群に何が入り、何が除外され、欠損値が何を意味するか。その後に計算を確認し、説明文が実際のフィルターに対応しているかを見ます。グループが業務上の定義に合って初めて、計算は意図した問いに答えます。
財務モデルと調査の成果物
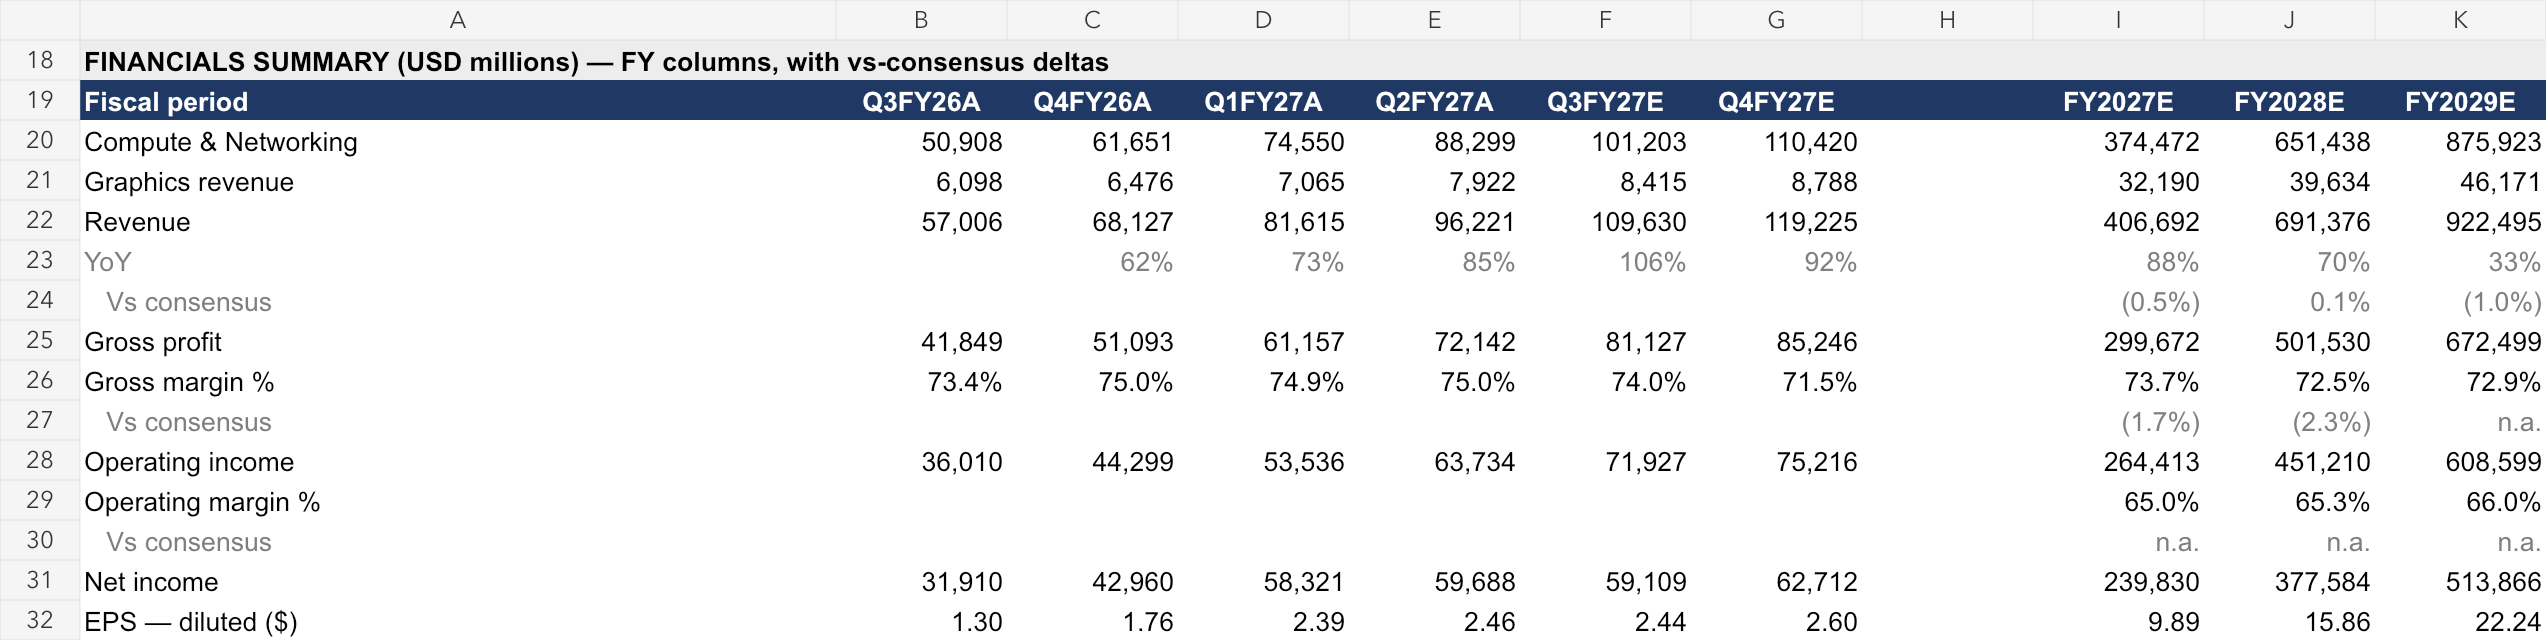
NVDA の画像には、四半期・年度の列と、売上高、利益、利益率、希薄化後一株当たり利益が並んでいます。財務サマリーの使いやすさは、主要数値を背後の前提や補助シートまでたどれるかに左右されます。
モデル用ワークブックでは、一つの予測値について前提から数式参照を経由し、サマリーまでたどります。会計期間が一致しているか、前提の変更で意図した出力が更新されるかを確認します。レポートやスライドでは、重要な主張を出典まで追い、図表と文章の結論が同じ期間・定義を使っているかを確かめます。
こうしたファイルは、調査の納品が長い回答を書くこと以上の仕事だと示しています。ワークブックには数値上の依存関係が、スライドには論証の順序が、レポートには結論を裏付ける追跡可能な根拠が必要です。人が確認し、修正できる形式に関係を整理することも、モデルの役割に含まれます。
画像・動画理解:実用時の確認項目
- グラフでは数値、単位、統計上の定義を合わせて確認する。
- 空間に関わる課題では物体の位置関係を確認する。
- 動画ではフレームをまたぐ動作順序や状態変化をテストする。
グラフの課題では、読み取りと解釈の違いが表れます。二つの数値を抽出しても、単位、期間、母集団が違えば、それで終わりではありません。有用な回答には、値を正しい軸、凡例、周辺説明に結び付ける必要があります。
content にメッセージ要素の配列を要求し、画像は base64 またはアップロード済みファイル参照で渡します。動画処理はキーフレーム単位で説明されており、枚数や解像度が入力サイズに影響します。詳細は視覚入力ガイドにあります。動画では、故障前に何が変化したか、どの動作が先だったかなど、一枚の画像ではなく順序が答えを左右する事例を選びます。本記事の公開テストは主にコーディングとデータ分析に関するものです。視覚アプリには、実際に認識させたい出来事や細部に対応した事例が必要です。
推論の待ち時間:最終回答が出るまで
2026 年 10 月 24 日、AIHubMix はハッシュマップの説明と Python コードを求める一つのプロンプトを使い、標準 Pro を low で三回実行しました。最初の推論トークンと最初の最終回答トークンでは、待ち時間に大きな差がありました。
最初の推論トークンと最終回答トークンまでの待ち時間
標準 Pro · 一つのプロンプト · low · 三回実行
- 最初の推論トークン
- 3.6–4.5 秒
- 最初の最終回答トークン
- 71–91 秒
リクエスト開始からの秒数
これらの実行では、生成トークンの約 85%–90% を推論が占め、一回は 8,192 生成トークンの上限に達しました。最終回答しか表示しない画面では、モデルが推論をストリーム出力していても、何も進んでいないように見える場合があります。
ストリームの進行と使える回答の違い
体験を分ける時間は三つあります。ストリームが始まる時点、最終回答の本文が始まる時点、回答が完了する時点です。接続が正常でも、使える答えを待つ時間は残ります。最初のトークンが速くても、待ち時間全体が短いとは限りません。
対話型アプリでは、利用者が実際に送るプロンプトで三つの時点を測ります。推論レベルと生成上限も記録し、速いが途中で切れた回答と、完了した回答を区別します。バックグラウンド処理では、最初の文字が出る速さより、完了時の品質や総時間が重要な場合があります。
reasoning_content、最終回答の差分に content を使います。アプリは処理状況と、表示・解析する答えを分けられます。複数ターンのツール処理では、クイックスタートは、最終回答の本文だけでなく、完全な assistant メッセージと対応するツール結果の保持も求めています。待ち時間の測定は、こうしてエージェントの動作とつながります。アプリが管理するのは、ツール要求、返された観測、最終回答を含む継続的なタスクです。推論レベルはその一つの調整項目であり、正しく納品できるかは検証やメッセージ処理にも依存します。
Kimi K3.1 Pro はどんなタスクに向くのか
事例ごとに重視すべき点は異なります。
| 能力 | 公開情報が裏付けること | 残る限界 |
|---|---|---|
| コーディングと長いタスク | 修正の完了と継続的なデバッグ | 大規模プロジェクトでの信頼性は実際の環境で要検証 |
| 3D と空間推論 | ツールによるシーンや物体の構築 | 形状の重なりだけではトポロジーや書き出し品質は分からない |
| データ分析と調査 | Plotly の専門テストでの好成績 | グループ定義や前提には誤りが残り得る |
| 視覚理解 | 画像・動画入力の公式対応 | これらのテストは専門的な視覚課題の精度を示さない |
| 推論と実行 | 多くの推論とツール利用 | 追加の推論で時間が増えても、測定結果が改善しない場合がある |
上記で取り上げた出典の整理。
まずは評価できるコード修正やデータ分析から始めます。修正では元の失敗ケースを保存し、最終 diff を確認します。分析では既知の答えを用意し、欠損や例外状態も含めます。3D の納品ではプレビューを見る前に、ソースと書き出し形式を合意します。
最終品質、実行時間、ツール呼び出し、トークン使用量を比較してから、より自由度の高い仕事に広げます。Atomic の low/max 比較、PacBench のブラウザー検証不足、Plotly のグループ分けの誤りは、それぞれ具体的な確認項目になります。評価を、モデルが実際に担う仕事へ結び付けるための材料です。
よくある質問
Kimi K3.1 Pro は編集可能な 3D モデルを作れますか?
コーディングでは low と max のどちらを選ぶべきですか?
代表的なタスクで両方を比較します。Atomic Agent の Python 実験では同じアサーションを通過し、low は平均 2.2 分・19 回、max は 4.9 分・28 回の呼び出しでした。追加の時間や使用量に見合うほどパッチや合格率が改善するときに、推論を増やします。
Kimi K3.1 Pro がストリーミング中なのに最終回答が出ないのはなぜですか?
Plotly で 42/43 なら、調査の結論をそのまま使えますか?
Plotly の合成風力発電データでの好成績です。失敗したファームウェアの問題は、母集団やグループ定義の確認が依然重要だと示しています。別のデータでは、欠損値、期間、数式、出典を確認してから結論を使ってください。


