
Kimi K3.1 ProとK3を比較:どのタスクで移行すべきか

K3から何が変わるのか
MoonshotはK3へより多くの計算を使って事後学習を施したと説明しています。長文脈と視覚理解は継続です。動作の違いが自分の成果物を改善するかが判断軸になります。
| 項目 | Kimi K3 | Kimi K3.1 Pro | 判断への影響 |
|---|---|---|---|
| 位置づけ | 従来の基準 | 追加の事後学習 | 既存K3結果を基準として保存 |
| 文脈 | 1,048,576 tokens | 1,048,576 tokens | 文脈拡大を移行理由にしない |
| 対象作業 | コードと長いタスク | 公式はコード、3D、調査改善を強調 | 実負荷の弱点を試す |
| 提供形態 | 現行K3ルート | ProとPro Highspeed | バリアントを明示的に選ぶ |
| ゲートウェイ費用 | K3の現行アカウント料金 | K3.1の現行アカウント料金 | 同じアカウントの条件で比較 |
独立した発表時評価で分かること
Artificial Analysisが2026年10月23日に公開したスナップショットで、基準はK3のmax設定です。EvoLinkによる測定ではありません。
| 指標 | K3 | K3.1 Pro | 読み方 |
|---|---|---|---|
| Intelligence Index | 44 | 55 | この総合評価で11点向上 |
| Indexタスク当たりの出力 | 約48,000 tokens | 約55,000 tokens | 生成増が単価低下を相殺する可能性 |
| Indexタスク当たり費用 | Proとおおむね同じ | 約$1.98 | この評価の記録で、自分の予算ではない |
単価の低下はタスク費用の低下ではない
2026年10月24日に確認したMoonshot国際参考料金は、通常入力/出力の100万トークン当たりK3が$3/$15、Proが$2/$10です。提供元の直接利用時の標準料金でありEvoLinkアカウントの見積もりではありません。キャッシュ、ツール、税、再試行を別に考えます。
| 条件 | 通常入力 | 課金出力 | 参考費用 |
|---|---|---|---|
| K3基準 | 100,000 | 10,000 | $0.45 |
| Pro、同じトークン数 | 100,000 | 10,000 | $0.30 |
| Pro、生成量が増加 | 100,000 | 25,000 | $0.45 |
2行目の節約は量を固定した場合だけです。3行目はツールや再試行の前に基準と同額になります。本番では検収済みの成果物を得る費用を測ります。
accepted_task_cost =
  (initial_call_costs + retry_costs + fallback_costs + tool_fees + review_cost)
/ accepted_deliverablesワークロードごとに判断する
| 負荷 | Proを試す条件 | 現行ルートを残す条件 |
|---|---|---|
| リポジトリ修正 | K3が停滞、修正を繰り返す、テストを外す | パッチ品質と予算が既に目標内 |
| 長文書 | 相互確認や出力の完全性が弱い | 抽出や検索が実際のボトルネック |
| 対話型アプリ | 完了品質が重要でProが応答条件を満たす | 待機が長すぎる。Highspeedは別に測る |
| バッチ・反復 | 同じ標本で検収済み成果物当たりの総費用が改善 | 推論や確認の増加が節約を消す |
Highspeedは別の提供判断です。公式の約2–3倍の出力速度は、ビルド、ツール反復、エージェント全体を同じ倍率で短縮しません。Proの品質と請求を先に測り、生成が遅延を支配する場合にHighspeedを比較します。
置き換えを検証できる記録にする
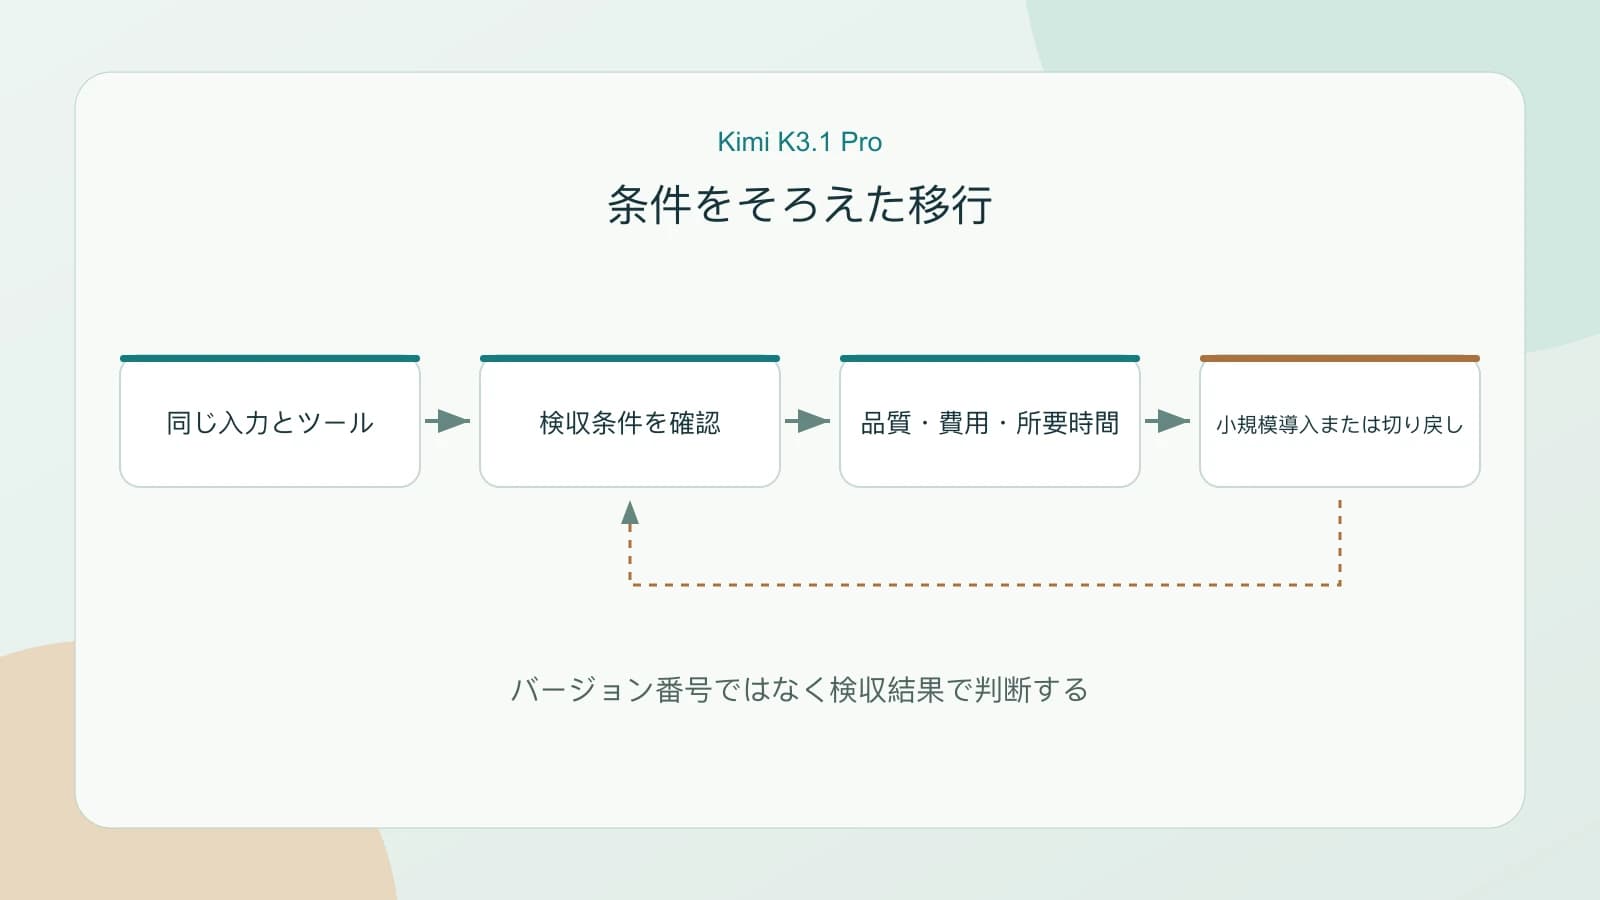
コミットや文書集合、プロンプト、ツール、検収テストを固定し、モデルを別々に実行します。各実行内では助手とツールの状態全体を維持しますが、モデルや推論設定を変えて古い会話を引き継ぎ、条件を統制した比較と呼ばないでください。
| 記録 | 保存する項目 |
|---|---|
| 設定 | 正確なモデル、effort、出力予算、ルート |
| Usage | 通常入力、キャッシュ読み取り、TTL別書き込み、課金出力、ツール回数 |
| 品質 | テスト、引用精度、成果物検査、残存欠陥 |
| 運用 | 初回応答、総時間、再試行、失敗 |
| 費用 | アカウントへの請求、フォールバック、測定した確認作業 |
返却usageに従ってキャッシュ区分を分け、書き込みを通常入力に二重計上しません。キー、プロトコル、画像アップロードは選択サービスの契約に合わせます。リクエスト形状の互換性は動作の同一性を保証しません。
合格した負荷だけを段階導入する
まず利用者トラフィックを移さず比較し、結果を見る前に品質下限、支出上限、遅延目標を決めます。達成後に小さな範囲を移し、旧設定を切り戻し用に保持します。一度の良い回答ではなく、実トラフィックの失敗と請求を観察して広げます。
テスト合格でも手動修正が増えるパッチなら、その確認費用を計上します。文書の表が抽出段階で落ちていたら、モデルの前に抽出を直します。こうした反例で本当の原因を見失わずに済みます。
FAQ
K3.1 Proは必ずK3より良いですか?
いいえ。発表時評価は試す根拠であり、品質、費用、時間の条件を満たす必要があります。
文脈は大きくなりましたか?
いいえ。両方1,048,576 tokensで、入力、推論、出力が共有します。
安い単価なら請求も必ず安くなりますか?
いいえ。出力量、キャッシュ、ツール、再試行、確認が検収済み成果物当たりの総費用を変えます。例の仮定を確認してください。
最初からHighspeedにすべきですか?
応答要件がProを除外しない限り、先に基準を測ります。同じタスクと現行料金でHighspeedを比較します。
推論の強度はどれを選びますか?
文書の設定を自分のテストで比較します。別設定の点数からlow/high/maxの品質を推定しません。
既存会話をそのまま使えますか?
実行内の必要なツール状態は保持します。モデルや推論設定を変える際は別の比較を始め、サービス要件を確認します。
K3を残すべきなのはいつですか?
検証済みルートが目標を満たし、代替が品質または検収済み成果物当たりの総費用の改善を示していない場合です。
EvoLinkでの直接対照試験を含みますか?
含みません。出典付き評価、構成した算例、評価手順を組み合わせています。空の試験記録は測定結果ではありません。

