Gemini 4 Neon と Claude Opus 5.5 を比較。コーディング性能と費用
同じエディターと各社のエージェントでの公開評価を比較します。合格パッチ当たりの費用から、切り替える条件を整理します。
 EvoLink Team製品チーム
目次
high で試します。既に安定しているリポジトリの作業フローでは、Claude Opus 5.5 を比較基準にします。 Neon は複数ファイルの修正で競争力があり、標準の入出力単価も低めです。切り替える前に、初回の合格率、レビュー時間、既存ツールが使えるかを測ります。 CursorBench 4.1 · Google API 料金 · Anthropic の料金実際の開発環境で Gemini 4 Neon と Claude Opus 5.5 を比べる
| 現在の構成 | 試すこと | 判断材料 |
|---|---|---|
| 一つのエディターで両モデルを選べる | エディター、ツール、レビュー手順を固定してモデルを変える | 合格したパッチ、総費用、レビュー担当者の介入 |
| チームが主に Claude Code を使っている | Claude Code と Opus、Antigravity と Neon の構成全体を比べる | リポジトリ内の指示、権限、作業の引き継ぎ |
| アプリから API で呼び出す | 同じタスク、許可済みツール、検証手順を使う | ツール実行の正しさ、パッチの有効性、失敗からの復帰 |
| 頻度が低くリスクの高い移行を扱っている | Neon を過去事例の再実行か隔離ブランチで試す | 互換性チェックと手作業の手戻り |
二つのコーディング評価が測るもの
xhigh と Antigravity CLI の組み合わせが 59 点で平均 6.86 米ドル/タスク、Opus 5.5 max と Claude Code が 58 点で 12.61 米ドルでした。スコアは丸めた値で、モデルとツールの組み合わせ全体を評価しています。CursorBench 4.1 では同じエディター環境から別の比較ができます。 Artificial Analysis の評価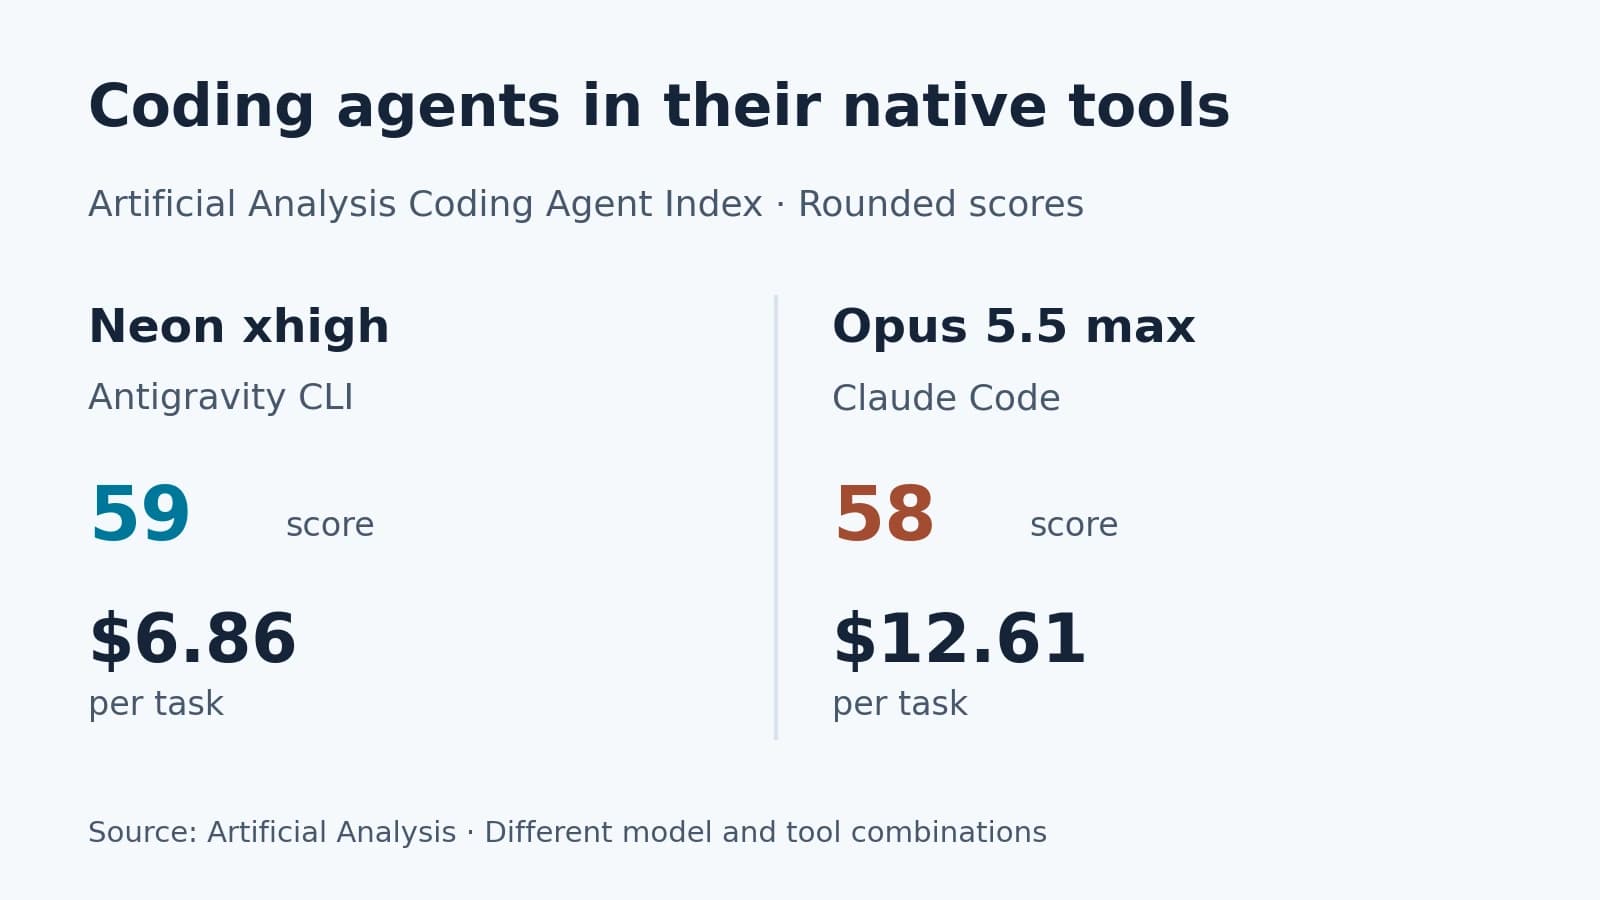
| CursorBench 4.1 の設定 | スコア | 評価上のタスク単価 |
|---|---|---|
Neon medium | 57.7% | $3.07 |
Opus 5.5 high | 54.5% | $3.87 |
Neon high | 63.7% | $6.54 |
Opus 5.5 xhigh | 56.7% | $6.54 |
Neon xhigh | 65.4% | $10.67 |
Opus 5.5 max | 58.1% | $11.88 |
high が有力な試験候補です。一方、Google の公表資料では Terminal-Bench 4.1 と FrontierCode 2.0 で Opus が少し上回ります。難しい端末デバッグや、そのままマージできる水準の変更が多いチームは、過去の同種タスクを再テストに加えてください。公開評価は課題選びに使い、切り替えは社内の合格条件で決めます。CursorBench の数値は 2026 年 11 月 19 日時点で確認しました。 CursorBench · Google DeepMind の評価エージェントの実行環境はスコアにどれだけ影響するか
| SWE-sweep の構成 | Neon | Opus 5.5 |
|---|---|---|
| 提供元ごとの実行環境 | 39.0% | 10.1% |
| 共通の mini-SWE 実行環境 | 12.8% | 3.6% |

実行環境を変えると、スコア自体もモデル間の差も変わります。Google によると、Antigravity CLI はリポジトリの探索をサブエージェントに分担させられます。SWE-sweep のような不具合の発見を測る評価に向く機能です。モデルの入れ替えを検討するなら、可能な限り実行環境をそろえます。IDE ごと選ぶなら、権限と作業範囲をそろえてツール全体を比較し、習得やレビューにかかる時間も記録します。
合格パッチ当たりの費用を計算する
100 件のコーディング作業を想定した例です。費用の合計に、失敗した試行と再試行も含めています。
| 接続先 | API の総費用 | 合格パッチ数 | 合格パッチ当たりの API 費用 |
|---|---|---|---|
| Neon | $45 | 75 | $0.60 |
| Opus 5.5 | $60 | 90 | $0.67 |
| Neon、合格数が少ないケース | $45 | 65 | $0.69 |
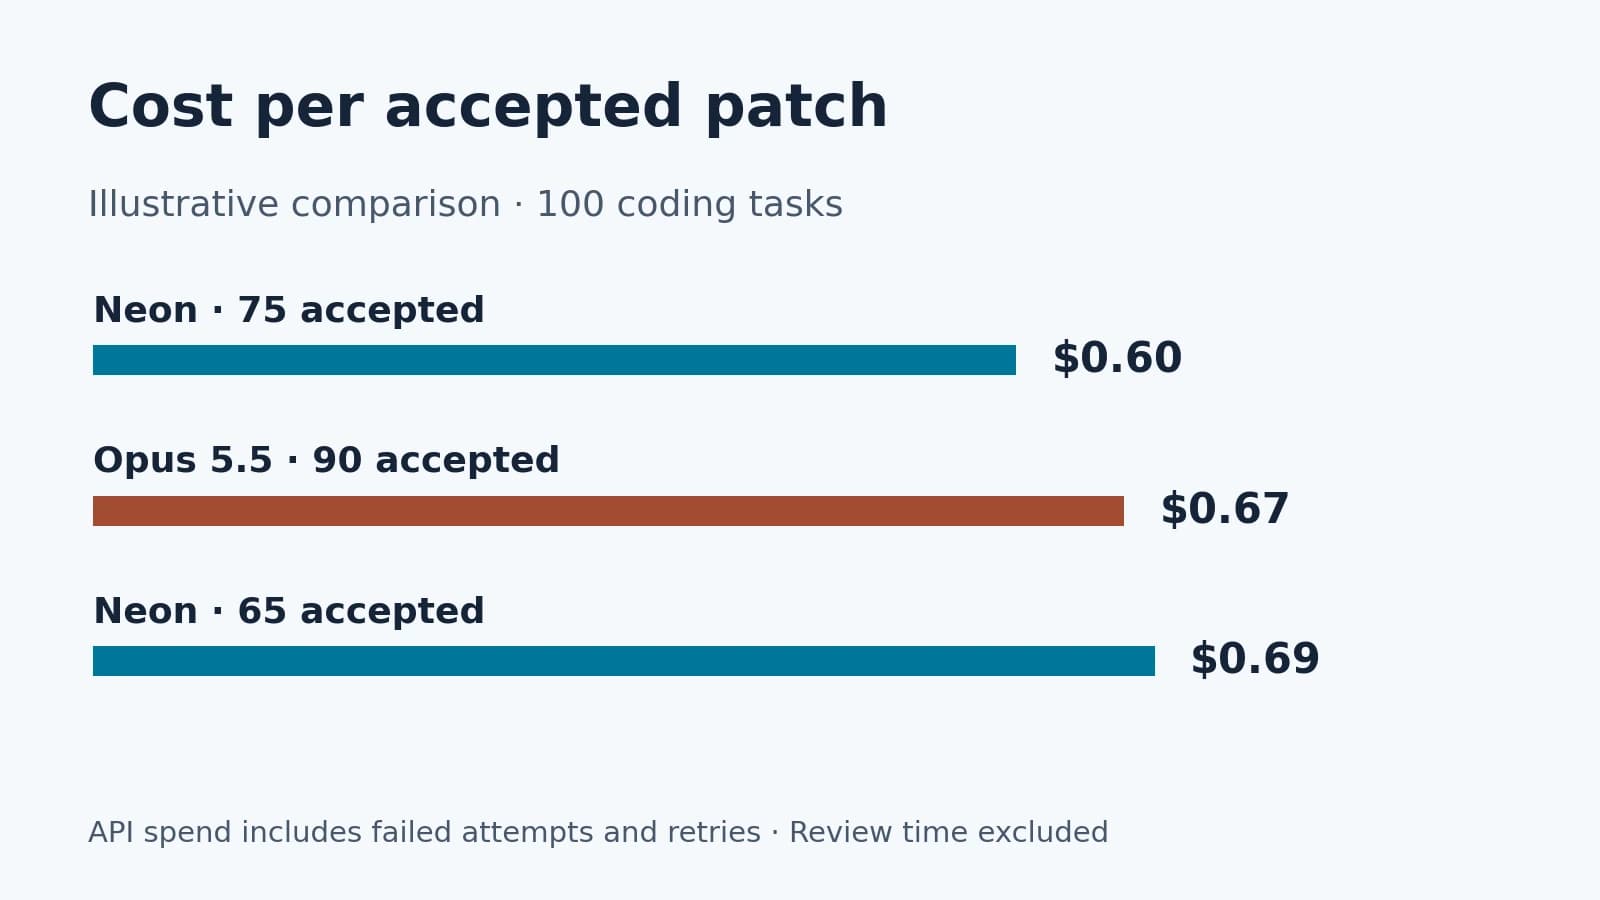
Neon の支払いが同じ 45 米ドルでも、合格率が落ちると合格パッチ当たりの費用が Opus 5.5 を上回ることがあります。API 費用にレビューや手直しの時間も加えて判断します。共有インターフェースの互換性を見落とすと、修正に呼び出し自体より大きな費用がかかることがあります。
プロバイダーの切り替え前に API 連携を確認する
high。Opus 5.5 の適応型思考は medium が既定です。明示設定と本番で使う既定設定の両方を確認します。段階の名前が同じでも、計算量がそろうとは限りません。 Google Neon 開発ガイド · Anthropic のモデル仕様| 連携の確認点 | Gemini 4 Neon | Claude Opus 5.5 |
|---|---|---|
| ネイティブ API の長い出力 | 同期リクエストの既定は思考と出力を合わせて 65,536 トークン。対応する方式で長文生成 | Anthropic は最大 128K と記載 |
| キャッシュ | 暗黙的ヒットで標準は100万キャッシュ入力トークン当たり $0.15 | 100万トークン当たり読み取り $0.20、5分の書き込み $5、1時間の書き込み $8 |
| 複数ターンのツール状態 | 利用するインターフェースの対話状態または思考署名を保持 | Claude Messages のツール結果と思考状態の仕様に従う |
切り替えの判断に使える比較を設計する
再現方法が分かっている不安定なテストの修正など、繰り返し発生するチケットを選びます。同じブランチ、チケットの説明、ツール権限、制限時間、テストコマンドを渡し、試行は互いに隔離します。可能ならモデル名を隠し、同じチェックリストで差分をレビューします。
パッチを見る前に合格基準を決める
結果の測れる代表的なチケットを数件選び、リビジョン、依存関係のロックファイル、リポジトリの指示、ツール、停止条件をそろえます。Claude Code の既存設定では、成功に寄与するフックとコマンドを確認します。モデル自体を比べるなら、中立のテストランナーでも同じチェックができるようにします。
| 採点項目 | 合格条件 |
|---|---|
| 機能 | 変更前に障害が再現し、変更後に対象のテストを通過 |
| 互換性 | 既存テストを通過し、以前に保存した入力や旧クライアントの動きを維持 |
| 変更範囲 | チケットの範囲に収まり、広い検査項目を無効にしていない |
| 復旧 | ツール停止時に未完了箇所を報告し、副作用のある処理を重複実行しない |
チケットごとに初回と最終の結果、レビューできる差分までの時間、課金トークン、レビュー分数をまとめます。再試行で解決した場合は両方を計上し、担当者が追加の情報を渡したかも記録します。復旧の費用が見えると、Opus を残す仕事と Neon に移す仕事を判断できます。
よくある質問
コーディングでは Neon が Opus 5.5 より優れていますか?
掲載した CursorBench 設定では Neon が上位ですが、端末やリポジトリの一部の評価では Opus が上です。自分のタスクと近い試験を見てください。
Neon の方が安いですか?
標準の入出力単価は 25% 低いです。合格タスク当たりの費用は使用量、キャッシュ、再試行、レビューで変わります。
両方を最高レベルで比較すべきですか?
難しいケースには最高レベルの試験も加えます。通常のリクエストでは予算と待ち時間に合う設定で比較します。
エディターを変えずに比較できますか?
両モデルと必要な機能を同じエディターが提供していれば可能です。主要な変数を一つ固定できます。
稼働中のエージェントはモデル名だけで切り替えられますか?
まず接続方式を確認します。ツールのメッセージ形式、思考設定や状態の保持方法は API ごとに異なる場合があります。
最初に何を試せばいいですか?
再発し、再現可能で、合格条件が明確なチケットを選びます。次に同じ種類のチケットが発生したときの接続先を判断できます。