Gemini 4 Carbon vs Claude Fable 5.2:コーディング・推論・タスク費用を比較
Carbon と Fable 5.2 をリポジトリ評価、CursorBench の推論レベル、タスク総費用で比較。EvoLink で主力・上位モデル・レビューを分担する方法を解説します。
 EvoLink Team製品チーム
目次
根拠は 2 種類あります。現在の CursorBench では Carbon が Fable max に近い成績を、より低い掲載費用で達成しています。一方、Anthropic 公開のリポジトリ開発評価では Fable が上回っています。得意分野はタスクや推論レベルで変わるため、それぞれの担当範囲を決めることが重要です。
Carbon と Fable はタスクから選ぶ
| 解決したい課題 | 最初の候補 | 継続利用を判断する基準 |
|---|---|---|
| 複数ファイルの複雑な変更を、消費を抑えて進めたい | Carbon medium | テストに通り、変更が許容でき、タスク全体が予算内に収まる |
| モジュールをまたぐ移行や、手作業のやり直しが大きい難しいバグ | Fable 5.2 | 案の作り直し、見落とし、人手の調査時間が減るか |
| 複数ツールを使う業務フロー | Carbon を評価し、既存モデルと比較 | 操作順序、引数、最終的な業務状態が正しい |
| 日常業務は安定し、ときどき難題がある | 主力を維持して上位モデルへの経路を追加 | 既存フローが実際に詰まった問題を解決できるか |
| 別モデルが生成したコードのレビュー | 異なるモデルで独立レビュー | 指摘が再現可能で、修正後の回帰テストに通り、誤検知が管理可能 |
この表は最初に試す順序です。Carbon の低い基本単価は予算の基準作りに向き、Fable のリポジトリ評価は失敗コストの高いコード作業で先に試す根拠になります。レビュー用モデルは現在の実装モデルを踏まえて選び、実装と検証を同じ判断だけに依存させないようにします。
例えば、決済サービスの再構成で冪等性と従来のリトライ挙動を維持する必要がある場合です。旧インターフェースの制約を認識し、検証可能な移行案を出し、回帰テストを補えるかが重要になります。よりよい設計で数時間の手戻りを省けるなら、トークン単価の比重は下がります。
コーディング評価はどう選択を裏付ける?
一部のリポジトリ開発評価では Fable が上位
Anthropic の Fable 5.2 公開表には、両モデルが共通して参加する次の項目があります。
| 評価タスク | Gemini 4 Carbon | Claude Fable 5.2 |
|---|---|---|
| FrontierSWE v2:リポジトリでのソフトウェア開発 | 61.2% | 69.9% |
| FrontierCode 2.0:コード変更がマージ可能な水準に達するか | 41.1%、medium | 49.1%、xhigh |
| AutomationBench:業務フロー | 53.9% | 51.4% |
| OSWorld 2.1:オフラインのデスクトップ操作サブセット、部分点あり | 81.5% | 89.3% |
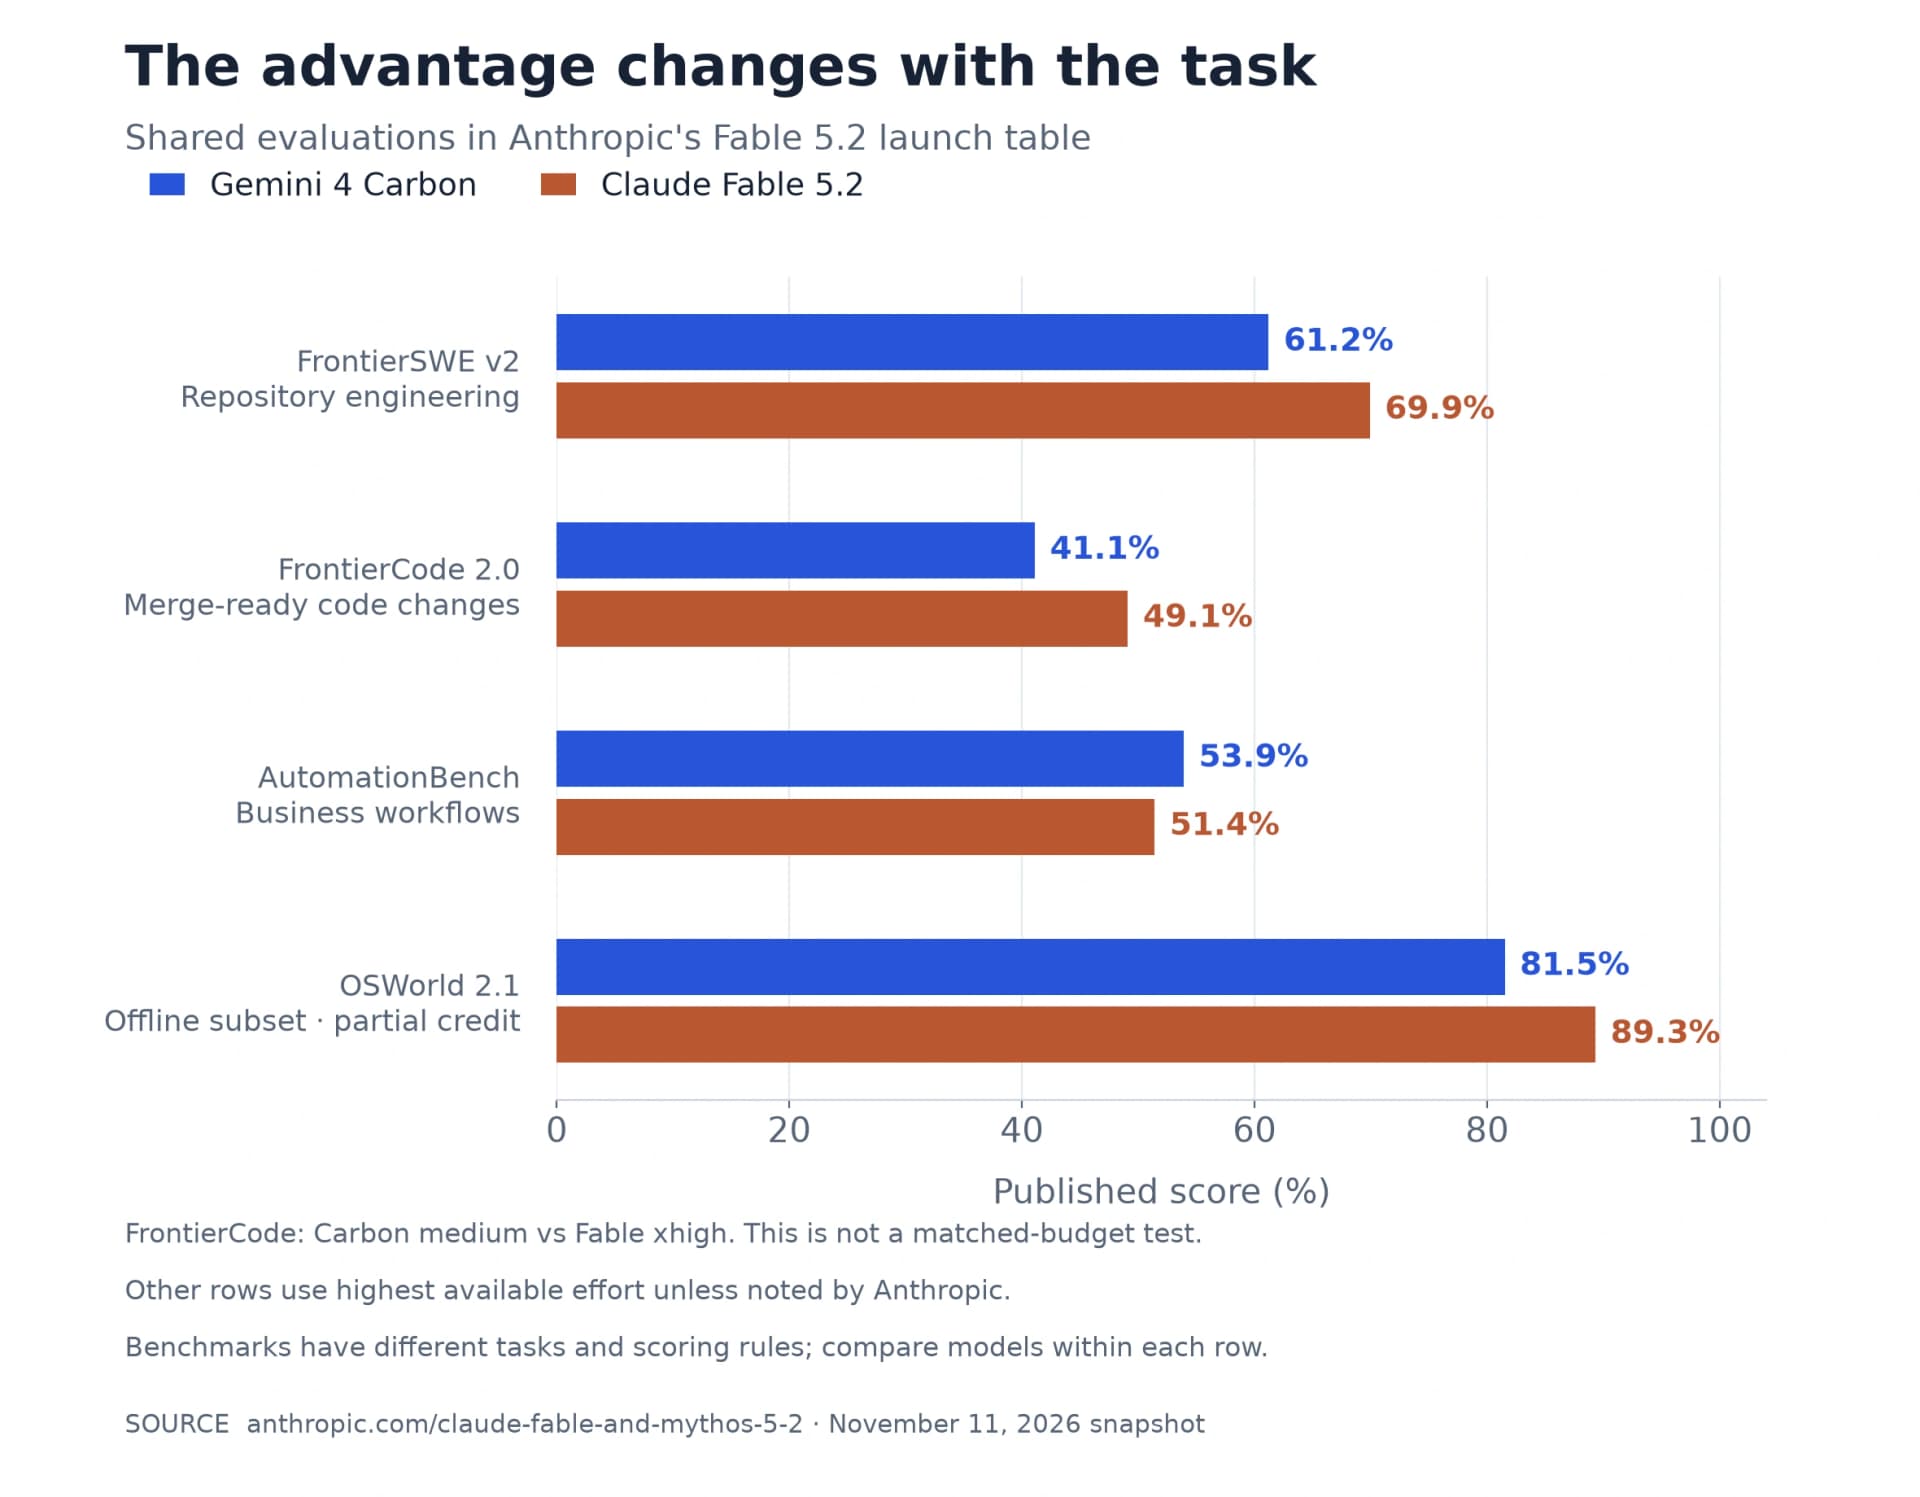
この結果は、難しいリポジトリ変更で Fable を優先して試す根拠となり、業務フローで Carbon を評価する理由にもなります。デスクトップ操作、コード変更、業務自動化では完了条件が違います。実際に納品するタスクに対応付けて読んでください。
CursorBench では Carbon の高性能構成が魅力的
CursorBench 4.0 は実際の Cursor セッションに由来する、曖昧さのある複数ファイルタスクを使います。11 月 11 日に確認した一部構成は次のとおりです。
| 構成 | 成績 | 掲載されている平均タスク費用 |
|---|---|---|
| Carbon high | 60.4% | $9.22 |
| Carbon medium | 60.1% | $8.49 |
| Carbon low | 58.6% | $11.89 |
| Fable 5.2 max | 60.0% | $32.79 |
| Fable 5.2 high | 56.9% | $9.70 |
| Fable 5.2 medium | 54.8% | $4.66 |
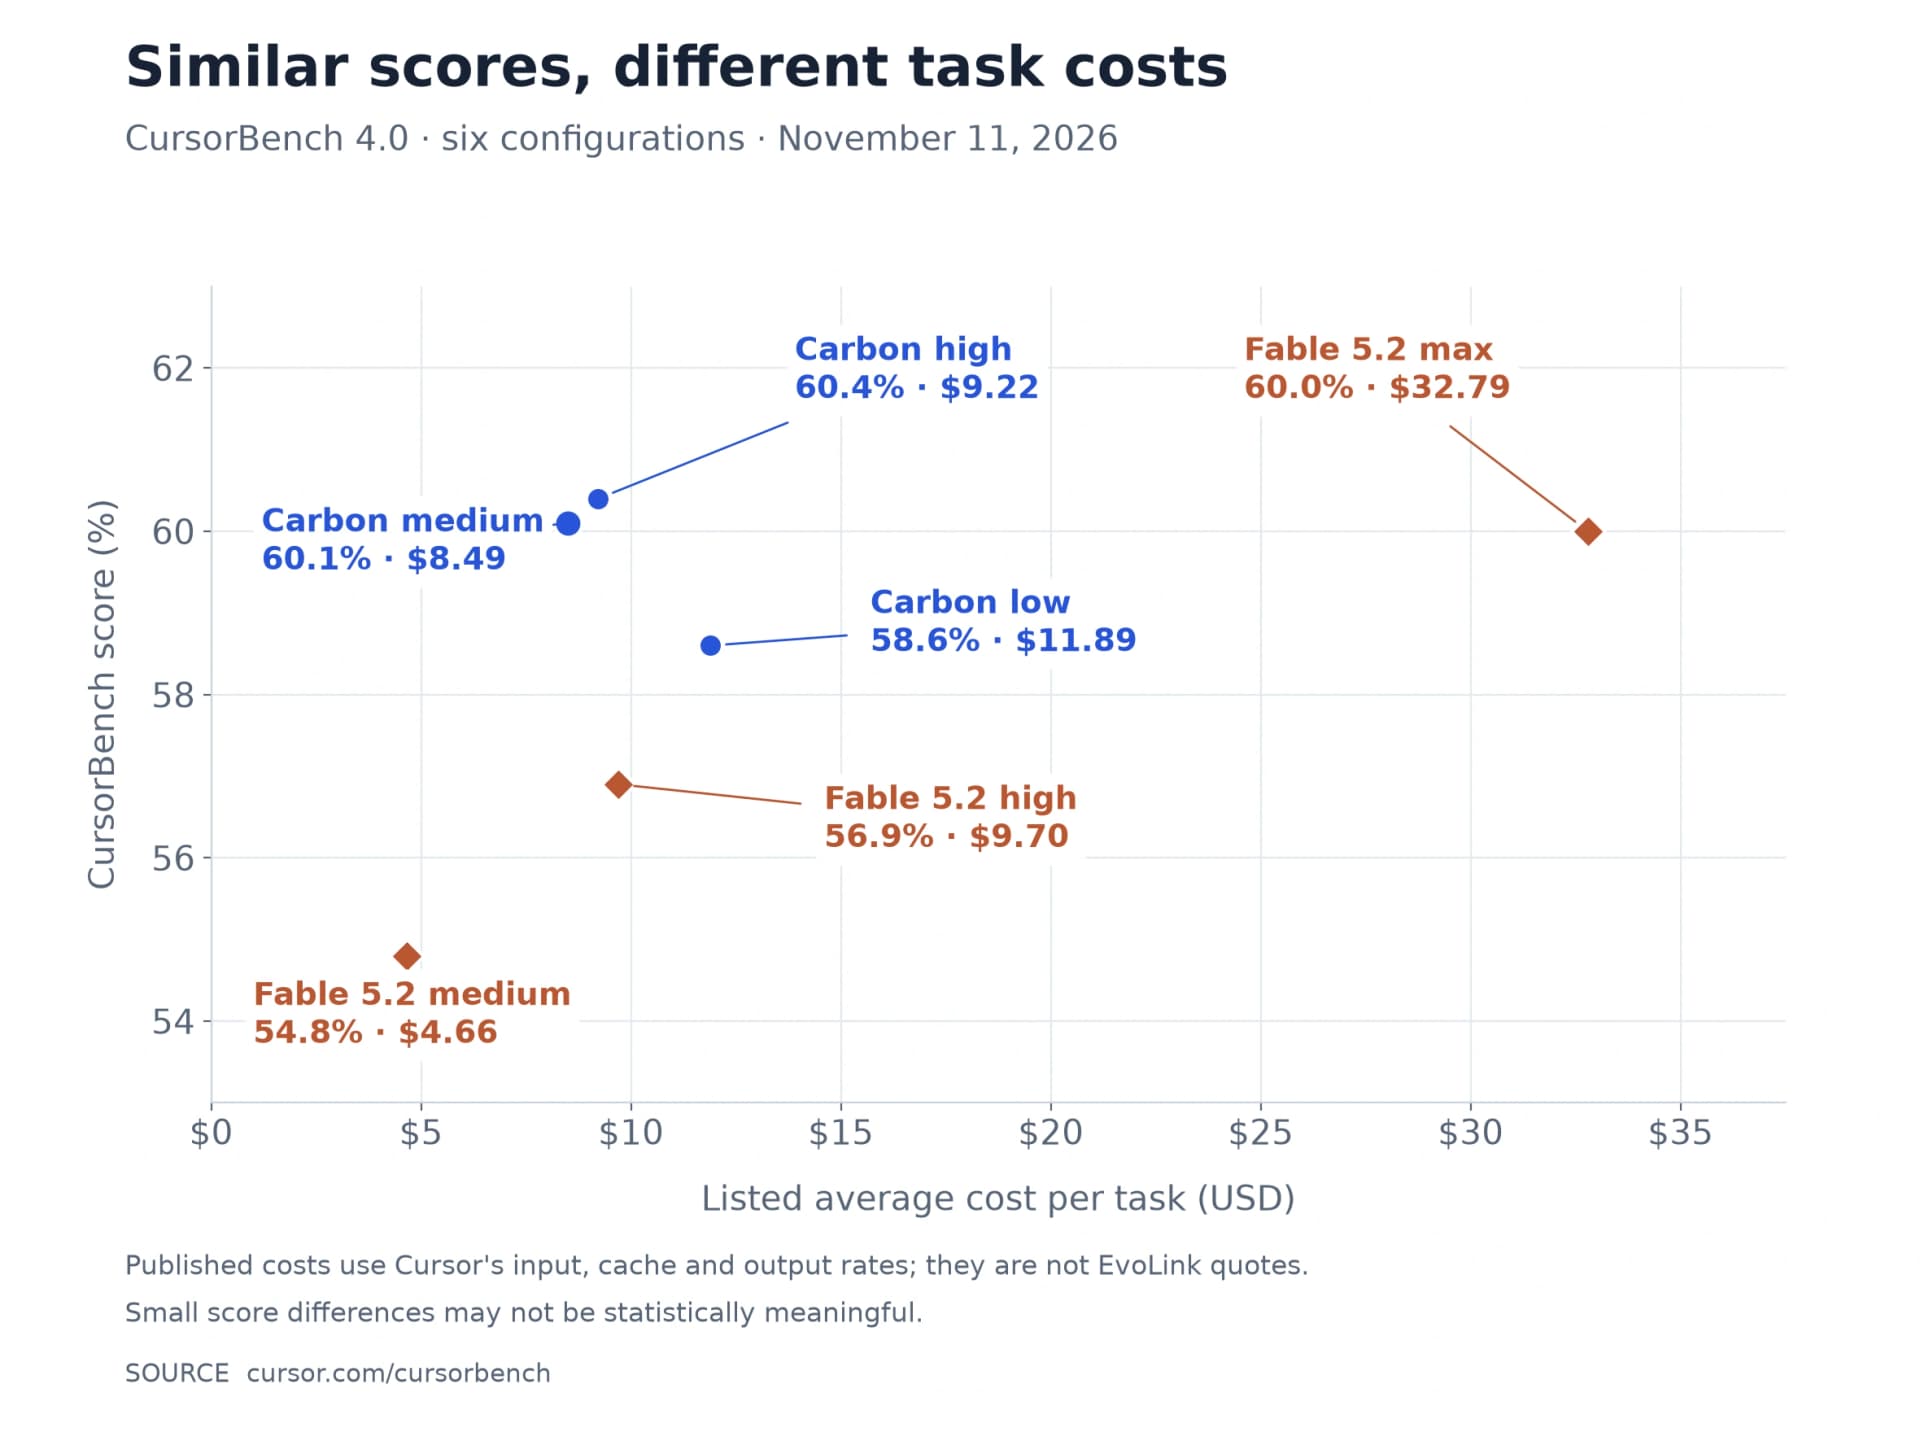
Carbon medium は Fable max に近い成績で掲載費用が大きく低いため、複雑なコーディングの最初の候補になります。一方、Fable medium はこのタスク群ではより安く、成績も低くなっています。その品質で要件を満たすなら、低いレベルの Fable も候補です。
Carbon low の平均費用は medium より高くなっています。複数段階のエージェントでは、1 ターンの推論を弱めると実行経路と総使用量も変わります。最終的な完了結果と総額でレベルを選びましょう。
Fable の高い単価に見合うのはどんなとき?
以下は提供元の Standard 基本料金で、単位はすべて 100 万トークンあたりの米ドルです。キャッシュ、Batch、Fast mode、追加の有料ツールは含みません。
| モデルと課金期間 | 入力 | 出力 |
|---|---|---|
| Carbon、2026 年 11 月 30 日まで | $2 | $10 |
| Carbon、2026 年 12 月 1 日以降 | $4 | $20 |
| Fable 5.2 | $8 | $40 |
- Carbon 導入期間:$0.30。
- Carbon 通常期間:$0.60。
- Fable 5.2:$1.20。
実際のタスクでは、トークン分割、思考消費、ツール呼び出し、リトライ経路が異なる場合があります。Fable を選ぶ理由は、ある種のタスクで失敗、手書きのやり直し、調査時間を減らせることです。Carbon を選ぶ理由は、同じ合格条件を満たしつつタスク全体の費用を抑えられることです。
クリエイティブコーディングは公開作品から比較する
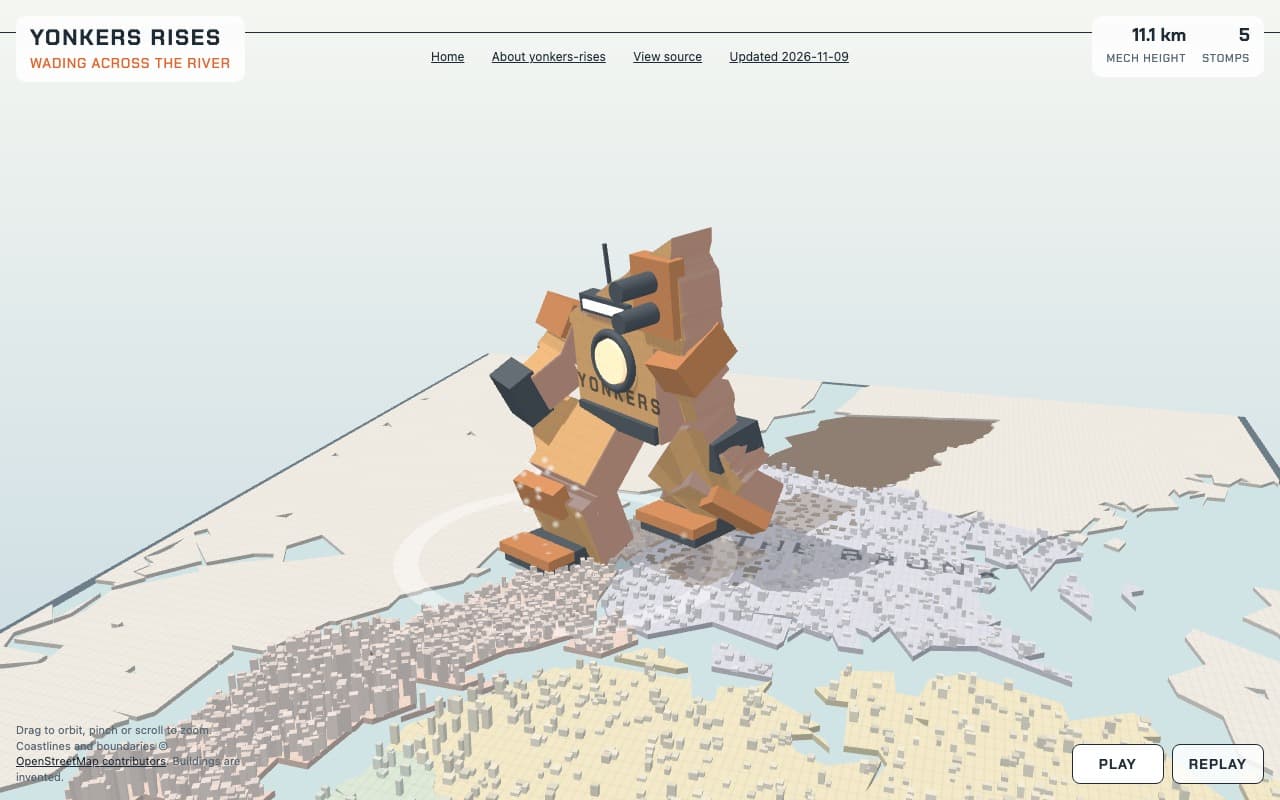
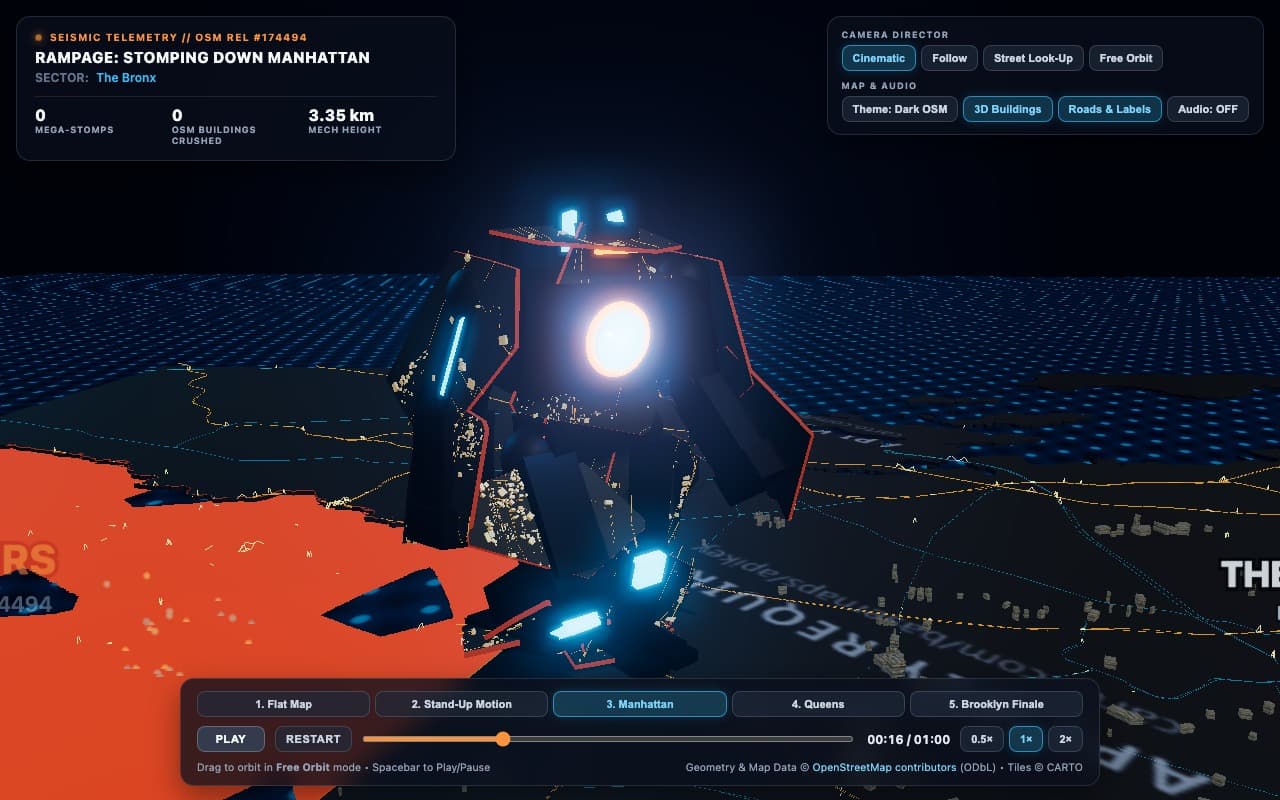
原作者が公開した作品から選んだ場面のスクリーンショットです。動きは元の作品を開いて再生できます。実行速度を比べる画像ではありません。
作品を開いたら、次の 3 点を具体的に確認できます。
- 地理の制約: Yonkers の輪郭がどうロボットになり、地図、道路、現在地ラベルが対応しているかを見ます。Fable 作品は建物が架空であると明記しています。
- 動きの連続性: 変形、起き上がり、歩行を一通り再生します。静止画だけで判断せず、動作のつながり、足の位置、地面との接触を確認してください。
- 操作の実用性: Fable のドラッグ、ズーム、再生と、Carbon のカメラ、チャプター、速度操作を試し、結果の確認や移動に役立つかを見ます。
両モデルが空間、アニメーション、データの要件をどう満たすかを見る事例です。ツール環境、プロンプトの細部、依頼回数が異なり、総費用と所要時間もそろっていないため、総合的な勝敗は判断できません。作者は Fable のレベルを medium としていますが、この記録には Carbon の推論レベルは記されていません。
インタラクティブな試作では同じ入力を与え、場面が要件を満たすか、コードが動くか、変更しやすいか、何回の追加依頼で納品に至るかを確認してください。初期の見栄えと後の保守性を両方、合格基準に含めます。
EvoLink で主力・上位モデル・レビューモデルをどう分担する?
既存プロダクトでは、安定した主力フローを維持し、特定できている難しいタスクから Carbon や Fable に任せます。統一 API の価値は、キー、残高、呼び出し管理を引き継ぎ、モデル選択をアプリ設定にできることです。各モデルのツールと推論パラメータは、それぞれの文書に従います。
まず次の 3 つから 1 つを選べます。
/swarm と Claude Advisor にも製品・チャネルの条件があり、統一 API では選んだフレームワークやアプリが対応するオーケストレーションを担います。実際のタスクで最終設定を決める
最近のバグ修正、複数ファイル変更、ツール作業から明確な合格基準のあるものを選び、両者に同じコード版、入力資料、ツール権限を与えます。
各タスクで、合格したか、全モデルとツールの費用、開始から納品までの総時間、人の介入と手戻りの 4 種類を記録します。続ける価値がある失敗タスクでは、同じリトライ規則を維持してレベルを上げるかモデルを切り替えます。
よくある質問
予算が限られる場合はどちらから?
高いコーディング構成に近い成績が必要なら Carbon medium から試します。品質要件が許せば Fable medium も比べてください。CursorBench では費用も成績も低く、最終判断は自分のタスクの合格基準で行います。
高価な Fable は必ずプログラミングに強い?
一部のリポジトリ評価では Fable が上回る一方、現在の CursorBench では Carbon も強い結果です。まずタスクで選び、レベル別の納品結果と手戻りを比較します。
Carbon は 75% 安い?
提供元の非キャッシュ入力と出力の基本単価では、導入期間は 75%、通常期間は 50% 低くなります。実際のタスク節約率とは異なり、EvoLink のアカウント料金を直接表すものでもありません。
両方 medium なら公平な比較?
実際の構成の利用結果は比較できますが、同じ名前でも計算予算は同じとは限りません。モデル、ツール、使用量、時間、合格結果を併せて記録します。
どちらが速い?
本番のチャネルとレベルごとに、最初のトークン待ち、回答全体、最終タスク完了までを測ってください。思考、ツール、手戻りで結果が変わります。
モデル名だけ変えれば切り替えられる?
統一接続はクライアントの重複設定を減らせますが、ツール呼び出し、推論設定、メッセージ形式、エラー処理はモデル別に確認が必要です。特に引き継ぎでは必要なタスク資料を渡し、宛先モデル向けにメッセージを作り直します。
別モデルでそのままコードレビューできる?
独立レビューとして試し、すべての指摘に発生条件と再現根拠を求めます。モデル間で意見が一致してもテストによる検証が必要です。レビュー費用と誤検知対応の時間も全体に含めてください。