Gemini 4 HydrogenとArgonを比較:タスク別の使い分け
Gemini 4 HydrogenとArgonのタスク配分、処理全体の費用、別モデルへ渡す条件、フォールバック上限を整理した本番ルーティングガイドです。
 EvoLink Team製品チーム
目次
本記事に、条件を統一した Hydrogen 対 Argon のワークロード結果はありません。機能の基準は提供元の文書に基づき、方針、例、数式はアプリケーション設計のための案内です。
Google のモデル選択ガイダンスでは、Hydrogen は日常的なコーディング、マルチモーダルな文書処理、並列実行の候補であり、Argon は高度な長期タスク向けと位置付けられています。これは提供元の位置付けであり、実測による自社トラフィックの分類ではありません。たとえば、リポジトリを扱うサービスでは、通常のテストで検証できる編集を一方のルートで、複数モジュールにまたがる障害分析をもう一方で評価できます。その際、同じリビジョンと受け入れ基準を使います。どちらの割り当ても、結果が裏付けた場合にだけ本番採用してください。
Gemini 4 Hydrogen と Argon:共通機能と上限を比較する
| 選択の変数 | 提供元 Hydrogen の基準 | 提供元 Argon の基準 | EvoLink で確認すること |
|---|---|---|---|
| 共有コンテキスト | 入力、思考、出力で 1,048,576 Token を共有 | 同じ共有ウィンドウ設計 | プロトコル上限と、入力後に残る回答用容量 |
| 長い出力 | 同期の一段階を超える long decode | long decode に対応 | ネイティブ継続処理。互換プロトコルも対応すると推定しない |
| 思考 | low、medium、high、xhigh。既定値 high | low、medium、high。Google の比較では既定値 medium | 対応値と、明示的に選んだ設定 |
| 非ストリーミングの一段階 | Google は最大 65,536 と記載 | Google の比較では REST の一段階上限 32,768 | 実際のゲートウェイ仕様と SDK の挙動 |
| ツール・構造化出力 | 対応機能 | 対応機能 | スキーマ、思考シグネチャ、エラー処理、ツール実行 |
| 料金 | モデル固有の商用料金体系 | モデル固有の商用料金体系 | キャッシュ入力とツールを含む現在のアカウント料金 |
xhigh が有効だと扱ってはいけません。同様に、Google の REST 上限の違いは、利用中のゲートウェイがその違いをそのまま実装した証拠ではありません。モデルを推測上の構造説明に置き換えないでください。価格の段階、元素名、似た応答から「Argon の蒸留版」とは確定できません。運用上重要なのは、対応インターフェースと、選択設定で合格する作業の品質です。
タスクの失敗コストからルートを選ぶ
出力仕様と、誤りがもたらす影響から始めます。あるタスクの最初の評価候補として適切でも、より重大な派生タスクに対して最も安全なルートとは限りません。タスク群を分けて記録し、平均点が重大な失敗を隠さないようにします。
| ワークロード | 最初の評価方針 | 受け入れ基準 | 最初の方針では足りない場合 |
|---|---|---|---|
| 固定フィールドの文書抽出 | 現行ルートと Hydrogen を比較 | 必須フィールド、正確な値、単位、出典根拠 | 重要フィールドが不合格、または曖昧さを解消できない |
| リポジトリの保守 | 再現可能なタスクで両者を比較 | テスト合格、変更が範囲内、レビュー負担が許容内 | 難しい失敗が残り、Argon が実際に解決すると示せる |
| 複数ステップのツールエージェント | 完了基準を満たす現行ルートから始め、もう一方を試す | 認可されたツールが完了し、最終回答がその結果を反映 | ツールが安定していても、有効なリクエストで繰り返しタスク失敗 |
| 長いレポート・仕様書生成 | モデル名で選ぶ前にコンテキストと継続を確認 | 全節がそろう、有効な参照、再開可能な出力 | クライアントが正しく再開できない、または根拠がない |
| 自動正解判定がない重大な判断 | 文書化したレビュー工程を要求 | 人が確認する評価基準と重大エラー検査 | どちらのモデルも必要な根拠や権限を提供できない |
抽出で問うのは、Argon のほうが慎重に聞こえるかではありません。参照値に照らした特定の失敗を修正できるかです。コードなら、別の回帰を起こさず失敗した挙動を直せるかを問います。エージェントでは、モデルの誤りとツールサービスの失敗を区別してください。モデルを替えても、停止したデータベースは復旧せず、欠けている権限も与えられません。
「worker」「verifier」のような役割は、アプリケーション側で提案する分担であり、モデル名が保証する機能階層ではありません。検証役も評価してください。二つのモデルが同じ根拠のない回答に同意することもあり、同意自体は独立した真実の根拠になりません。
直接ルーティングとエスカレーションを選ぶ
出発点として三つの方針があります。同じ受信タスク集合、同じ合格定義で、すべてを比較してください。
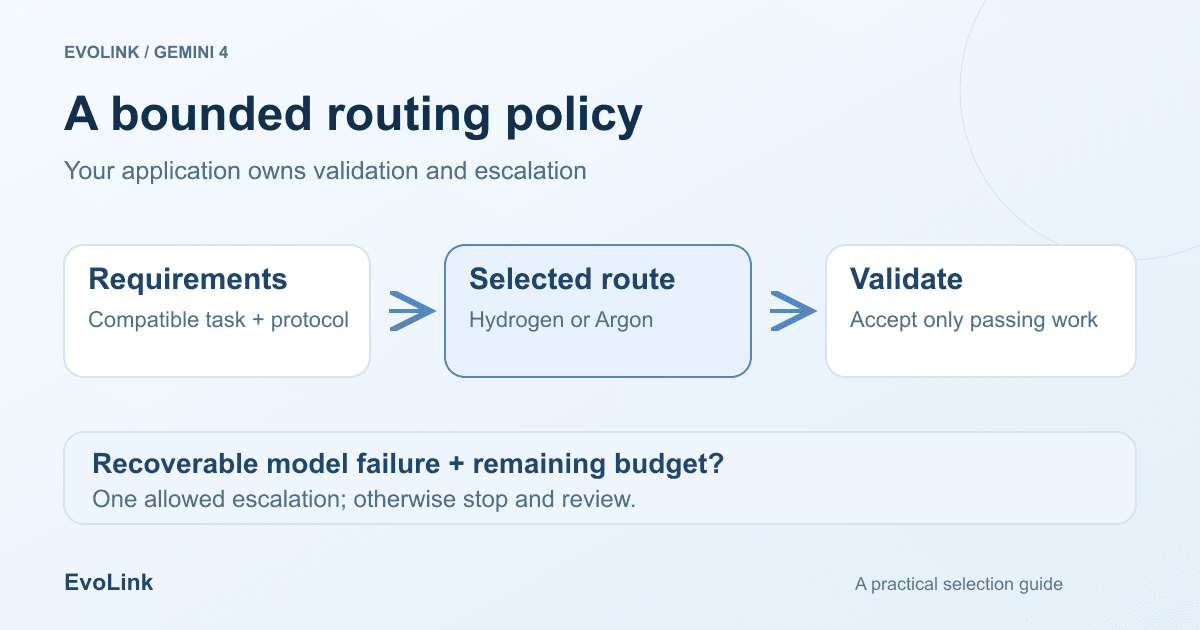
実用的な決定木は、次の順で進みます。
- 必須要件を確認する。 選択したプロトコルが入力を受け付け、必要なツールと出力ワークフローを提供するか。モデル品質を比較する前に、非互換ルートを除外します。
- 評価済みのタスク群別結果を使う。 その群の品質、待ち時間、費用を満たす直接ルートを選びます。根拠がなければ勝者を推定せず、範囲を限定して評価します。
- 応答を検証する。 スキーマ、実行、根拠、認可を検査します。タスク要件を満たしたものだけ合格にします。
- 失敗を分類する。 根拠不足、ツール停止、権限拒否、壊れたデータ、モデルの推論失敗は、それぞれ違う対応が必要です。
- 回復可能なモデル失敗だけを別モデルへ渡す。 関連する元の根拠と検証フィードバックを渡し、残り予算と時間を確認したうえで、許可された二回目を試します。
- 方針上の上限で止める。 二回目も失敗したら、未完了またはレビュー待ちを明示します。説得力のある答えが出るまでモデルを往復させてはいけません。
これはアプリケーション側のオーケストレーションの案内です。EvoLink が応答を自動評価したり、すべての失敗をより良いモデルへ送ったりする組み込み機能の説明ではありません。
不成功の試行も含めて、ルート全体の費用を計算する
エスカレーション方針について、次のように定義します。
c_H:受信タスクあたりの Hydrogen 段階の平均 API/ツール総費用。その段階で許可する再試行も含みます。r:すべての受信タスクのうち、実際に Argon に進む割合。c_A:Argon に渡したタスクあたりの、その段階全体の平均 API/ツール費用。a:元のタスクのうち、最終的に共通の受け入れ基準を満たす割合。
すると、
受信タスクあたりの平均 API/ツール費用 = c_H + r × c_A合格タスクあたりの API/ツール費用 = (c_H + r × c_A) / aa がゼロなら二つ目の式は未定義です。レビュー担当者の時間を含めるなら、期待費用を明示的に加算し、API の費用だけを事業費全体として示さないでください。どの方針でも対象集合と受け入れ基準を同じにする必要があります。
課金されるモデルベースの検証は、それを呼び出す段階の費用に含めます。それらの段階とは別に、別モデルやサービスが応答を判定するなら、その期待費用を分子に加えてから合格率で割ってください。ローカルテストの実行費用やその他のインフラ費用が API/ツール費用の定義の外にある場合は、別に報告します。
| 方針 | API/ツール総費用 | 合格した元タスク数 | 合格タスクあたりの API/ツール費用 |
|---|---|---|---|
| Hydrogen のみ | $6 | 800 | $0.0075 |
| Argon のみ | $12 | 960 | $0.0125 |
| Hydrogen の後、200 タスクを1件 $0.012 で Argon に渡す | $8.40 | 950 | 約 $0.00884 |
三行目は $6 + 200 × $0.012 = $8.40 です。Hydrogen で元の 800 件が合格していたなら、合計 950 件とは、渡した 200 件のうち 150 件が追加で合格したという意味です。これは説明用の仮定であり、観測した合格率、モデル料金、削減保証ではありません。方針ごとの結果は個別に仮定しており、決定論的な対応ありテストではありません。エスカレーションでは検証フィードバックや異なるリクエスト文脈を使うことがあるためです。成功率と c_A は、Argon 直接ルートの平均から導くのではなく、実際にエスカレーションした部分集合で測ってください。この例は、追加のモデル API 料金がないローカル検証を仮定しています。課金される検証処理の費用があれば、上の説明に従って加算します。
この方針は、すぐに採算が合わなくなる可能性があります。Argon に渡す割合が高すぎると、結局使う予定だったルートの前に第一段階の費用が加わります。検証処理が誤答を見逃せば、報告した合格率は誤解を招きます。正答を不合格にすれば、不要なエスカレーションで時間も費用も使います。人がラベルを付けた例や実行可能な参照ケースに照らして、検証処理自体を確認してください。
待ち時間も方針によって変わります。別モデルへ渡すタスクは、第一段階、検証、第二段階を順に通ります。別々に測った二つの p95 を平均して、ルート全体の p95 と呼んではいけません。実際の方針で開始から完了までを測り、エスカレーションしたタスクを別に報告します。速い多数派が、失敗タスクの長い待ち時間を隠さないようにするためです。
点検できるエスカレーション条件を定義する
有用な信号は、満たせなかったタスク要件と結び付いています。「自信がありません」のような曖昧な自己評価は、点検する要素の一つにはなっても、無制限な支出の許可にはなりません。
| 信号 | 最初の対応 | 別モデルが妥当な条件 | 停止条件 |
|---|---|---|---|
| 必須スキーマや型検証に失敗 | リクエスト/スキーマの正しさを確認 | 有効なリクエストを満たせず、代替モデルが評価でこの失敗群を解決した | 許可した1回のエスカレーション、またはタスク予算まで |
| 実行可能なテストが失敗 | テスト出力と関連する元のコンテキストを保持 | モデルによる修正が妥当で、安全に試せる | テストがなお失敗、または範囲が拡大 |
| 引用に根拠がない | 出典に実際に答えがあるか確認 | 根拠が存在するときだけ、別の解釈に意味がある | 根拠がなければ、資料を求めるかレビューへ |
| ツールがタイムアウト | ツールサービス側の再試行方針を適用 | モデル変更ではサービスの可用性は直らない | タイムアウト/期限到達 |
| 認可が拒否された | 拒否に従う | 別モデルで権限を迂回してはいけない | 未認可の処理を停止 |
| コンテキストに収まらない | 関連資料を絞る・検索する、またはワークフローを変更 | 代替ルートに本当に対応容量がある場合のみ | どちらにも安全に収まらない |
たとえば、生成した移行スクリプトが再現可能なテストに失敗したら、そのテスト失敗を Argon の試行へ渡せます。一方、ツールの「permission denied」応答は、別モデルに渡す理由にはなりません。PDF の署名が読めない場合も、二つ目のモデルが同じ名前を推測したからといって、信頼できる根拠にはなりません。
エスカレーション中の二重書き込みを防いでください。最初の試行が処理を実行済みの可能性があるなら、再試行の前に状態を照合します。冪等性識別子を保持し、外部操作の責任を実行層に残します。モデル選択でアプリケーションのトランザクション境界がなくなるわけではありません。
モデル間の移植性を仮定せず、状態を保持する
previous_interaction_id、ネイティブ継続 Token、状態オブジェクトを受け付けると想定しないでください。アプリケーションが管理するエスカレーションでは、承認済みの元の根拠と、何が失敗したかの明示的な説明から、次のリクエストを構築します。失敗したモデルの根拠のない結論を正解として提示しないでください。状態転送が文書化されていなければ、対応する新規リクエストから始め、繰り返す入力の費用を計上します。その費用を隠すとルート比較を歪めます。
設定に名前とバージョンを付けて管理します。ロールバック対象には、モデル、対応する思考レベル、プロンプト版、スキーマ、ツール方針を含めます。モデルだけを戻し、フォールバックが受け付けない設定を残す事態を避けるためです。
既定にする前に、ルーティング方針を段階展開する
連鎖型の方針を試す前に、両方の直接ルートを評価します。そうしなければ、追加したルーティング層が改善をもたらしたか分かりません。通常、難しい、既知の失敗を含むラベル付き集合を固定し、Hydrogen 直接、Argon 直接、提案するエスカレーション経路を試します。すべての試行を元の task ID の下に記録してください。
モデルと検証処理の不一致を点検します。平均費用が下がっても、重大エラーはレビューしてください。受け入れ判定には、自信のある誤答を見抜くのに十分な独立性も必要です。最初のモデルの説明を繰り返すだけの検証役は、強い判定基準ではありません。
次に、外部操作を無効にした承認済みシャドー方針を実行します。実入力の分布、状態処理、実際のエスカレーション頻度、使用量全体を確認します。その後、重大失敗、合格タスク費用、完了時間、ツール操作の上限を文書化した限定カナリアを行います。直接モデルへ直ちに戻せる手段と、方針を無効化できる担当者を確保してください。
すべてのリクエストを連鎖型に押し込まないでください。既知の難しいタスク群では、直接ルートのほうが安く、速い場合があります。すでに合格する単純なタスク群には、二つ目のモデルが不要かもしれません。確かな受け入れテストがない群では、もう一度自動試行するより、人手レビューや明示的な未完了結果のほうが安全なことがあります。
よくある質問
Token 単価が安いから、すべて Hydrogen から始めるべきですか?
いいえ。処理全体の費用と結果をテストしてください。ほぼ必ず別モデルへ渡すタスクなら、実績のあるルートに直接送るほうがよい場合があります。
Hydrogen は Argon の蒸留版ですか?
本記事には、その構造を確定する一次資料はありません。位置付けから学習設計を推測せず、記載されたモデル識別と対応動作を使います。
Argon は常に良い回答を返しますか?
ここでそのような普遍的結果は確立していません。難しい例や重大エラーも含め、タスク固有の参照基準に照らして両方を比較します。
長い出力が必要なら Argon を選ぶべきですか?
両方の提供元モデルが long decode を記載しています。共有コンテキスト、一段階の上限、選択したプロトコルの継続動作を確認し、共通機能を Argon 固有の優位と扱わないでください。
どんなときに Argon に引き継ぐべきですか?
検出でき、回復可能なモデル失敗が残り、代替モデルがその失敗群を改善すると評価で示され、時間と予算も残っているときです。権限や根拠の不足には別の対応が必要です。
二つ目のモデルで一つ目を自動検証できますか?
提案するレビュー工程に参加させることはできますが、同意は正しさの証明ではありません。検証役を評価し、必要な場面では実行可能な検査、出典根拠、人手レビューを使います。
モデル間で会話、キャッシュ、継続状態を再利用できますか?
選択プロトコルが文書化している場合だけです。必要な履歴を正しく保持し、モデル固有 Token を無条件に移さず、新しいリクエストでは重複入力の費用も計上します。
再試行はいつ止めるべきですか?
事前に決めた試行回数、時間、支出上限に達したとき、または追加のモデル呼び出しで解決できない失敗のときです。無限のモデル切り替えではなく、レビュー待ちや未完了状態を明示します。
出典と根拠の範囲
- Google Hydrogen モデル仕様。
- Google Argon モデル仕様。
- Google Hydrogen のモデル横断移行ガイド。
- Google Gemini API 料金。
- EvoLink Gemini ネイティブ API リファレンス。
2026年11月12日確認。提供元の仕様は提供経路ごとのものです。タスクの割り当て、ルーティング規則、1,000 タスクの例は設計案であり、公開済みのモデルベンチマークでも EvoLink の自動ルーティング機能の説明でもありません。