
Prix de l’API Kimi K3.1 Pro : tarifs des tokens, cache et exemples de coûts
Comparez les tarifs de Kimi K3.1 Pro et Highspeed : entrée, sortie, écriture du cache, raisonnement et exemples pour une requête ou un budget mensuel.
 EvoLink Team
Dans cet article
Le coût d’une requête dépend de l’entrée, de la sortie, de l’utilisation du cache et des outils. Ce guide détaille ces postes et montre comment estimer le coût d’une requête ou de plusieurs milliers d’appels mensuels.
Quel est le prix de l’API Kimi K3.1 Pro sur EvoLink ?
| Poste facturé | K3.1 Pro Standard | K3.1 Pro Highspeed |
|---|---|---|
| Entrée ordinaire | $2.00 | $4.00 |
| Sortie | $10.00 | $20.00 |
| Lecture du cache | $0.20 | $0.20 |
| Écriture dans le cache : 5 minutes | $2.00 | $4.00 |
| Écriture dans le cache : 1 heure | $4.00 | $8.00 |
Les frais d’entrée se répartissent en trois catégories :
- Entrée ordinaire : contenu facturé au tarif d’entrée habituel.
- Lecture du cache : contenu réutilisé avec succès depuis un cache existant.
- Écriture dans le cache : contenu enregistré dans le cache et facturé selon sa durée de validité.
Combien coûte une requête API ?
Kimi K3.1 Pro facture les tokens consommés, sans prix fixe par requête. Une courte question, un document volumineux et une requête réutilisant du contexte en cache peuvent produire des factures très différentes.
Voici trois exemples calculés avec les tarifs ci-dessus :
| Utilisation par requête | Coût Standard | Coût Highspeed | Standard : 1 000 requêtes |
|---|---|---|---|
| 2 000 tokens d’entrée ordinaire + 1 000 de sortie | $0.014 | $0.028 | $14 |
| 100 000 tokens d’entrée ordinaire + 10 000 de sortie | $0.30 | $0.60 | $300 |
| 100 000 tokens lus dans le cache + 1 000 d’entrée ordinaire + 2 000 de sortie | $0.042 | $0.064 | $42 |
Petite requête : 0,014 dollar avec Standard
Une requête contenant 2 000 tokens d’entrée ordinaire et générant 1 000 tokens de sortie coûte :
Regular input: 2,000 ÷ 1,000,000 × $2  = $0.004
Output:        1,000 ÷ 1,000,000 × $10 = $0.010

Total: $0.014Requête plus volumineuse : 0,30 dollar avec Standard
Une requête contenant 100 000 tokens d’entrée ordinaire et générant 10 000 tokens de sortie coûte :
Regular input: 100,000 ÷ 1,000,000 × $2  = $0.20
Output:         10,000 ÷ 1,000,000 × $10 = $0.10

Total: $0.30Pour établir un budget mensuel, regroupez les requêtes par profil de consommation, calculez le coût de chaque groupe, puis multipliez-le par le nombre d’appels prévu.
Highspeed double-t-il le coût ?
Les tarifs d’entrée ordinaire, de sortie et d’écriture dans le cache de Highspeed sont le double de ceux de Standard. Son tarif de lecture du cache ne change pas.
Pour une requête ne contenant que de l’entrée ordinaire et de la sortie, une consommation identique double les frais de tokens :
100,000 regular input + 10,000 output tokens

Standard:  $0.30
Highspeed: $0.60
Pour une requête dominée par les lectures du cache, l’écart est plus faible :
100,000 cached input + 1,000 regular input + 2,000 output tokens

Standard:  $0.042
Highspeed: $0.064Ces calculs gardent la consommation de tokens constante pour montrer l’effet des tarifs. Pour les appels réels, calculez chaque facture à partir de l’utilisation déclarée par l’API.
Coût du cache : première écriture et lectures suivantes
Le tarif de lecture du cache de Standard est dix fois moins élevé que son tarif d’entrée ordinaire, mais la création du cache entraîne des frais d’écriture distincts.
Prenons une requête Standard comprenant :
- un préfixe réutilisable de 100 000 tokens, écrit pour la première fois dans un cache de cinq minutes ;
- 1 000 tokens d’entrée ordinaire supplémentaires ;
- 2 000 tokens de sortie facturables.
La première requête coûte :
Cache write:   100,000 ÷ 1,000,000 × $2  = $0.200
Regular input:   1,000 ÷ 1,000,000 × $2  = $0.002
Output:          2,000 ÷ 1,000,000 × $10 = $0.020

First request total: $0.222
Lorsqu’une requête suivante réutilise avec succès ces 100 000 tokens en cache, le coût devient :
Cache read:    100,000 ÷ 1,000,000 × $0.20 = $0.020
Regular input:   1,000 ÷ 1,000,000 × $2    = $0.002
Output:          2,000 ÷ 1,000,000 × $10   = $0.020

Subsequent request total: $0.042
Si la première écriture est suivie de neuf requêtes atteignant toutes le cache :
Total for ten requests
= $0.222 + 9 × $0.042
= $0.60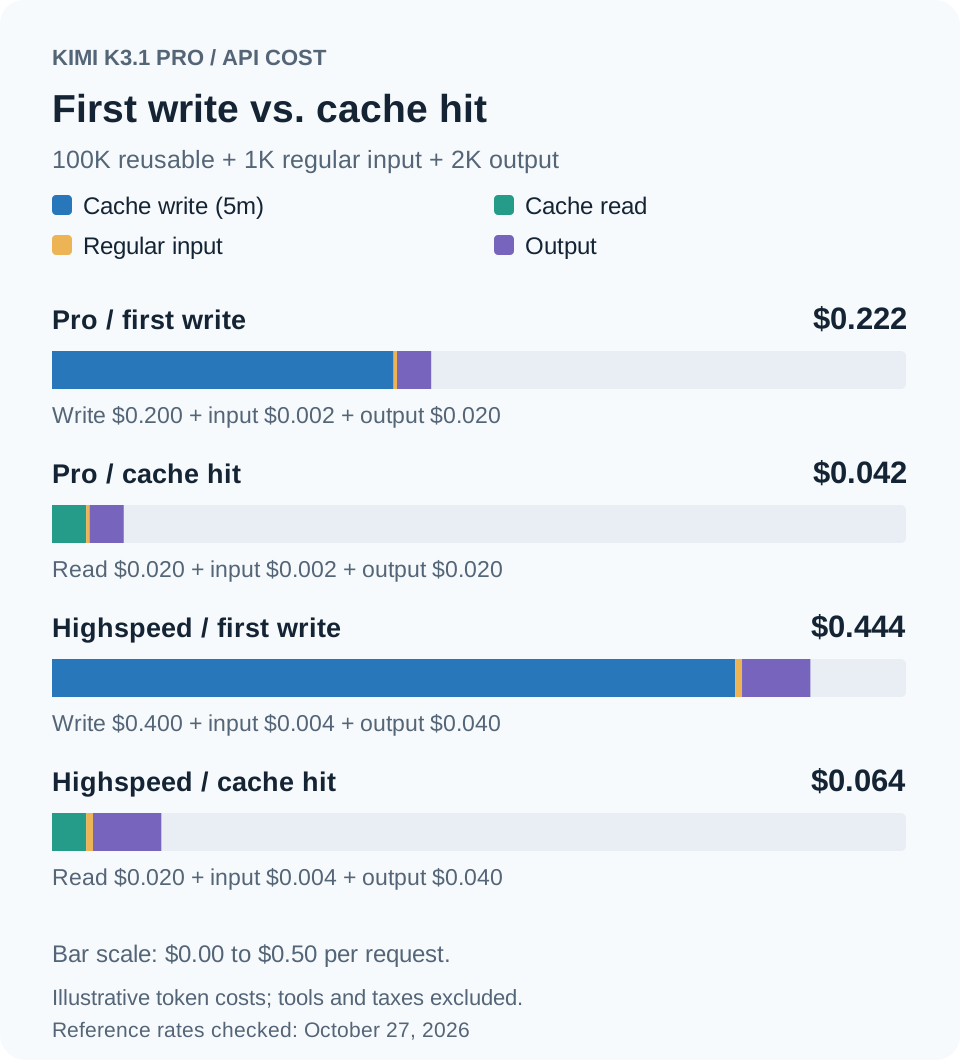
Cache de cinq minutes ou d’une heure : quels tarifs ?
Les tarifs d’écriture de Standard sont les suivants :
- Cinq minutes : 2 dollars par million de tokens.
- Une heure : 4 dollars par million de tokens.
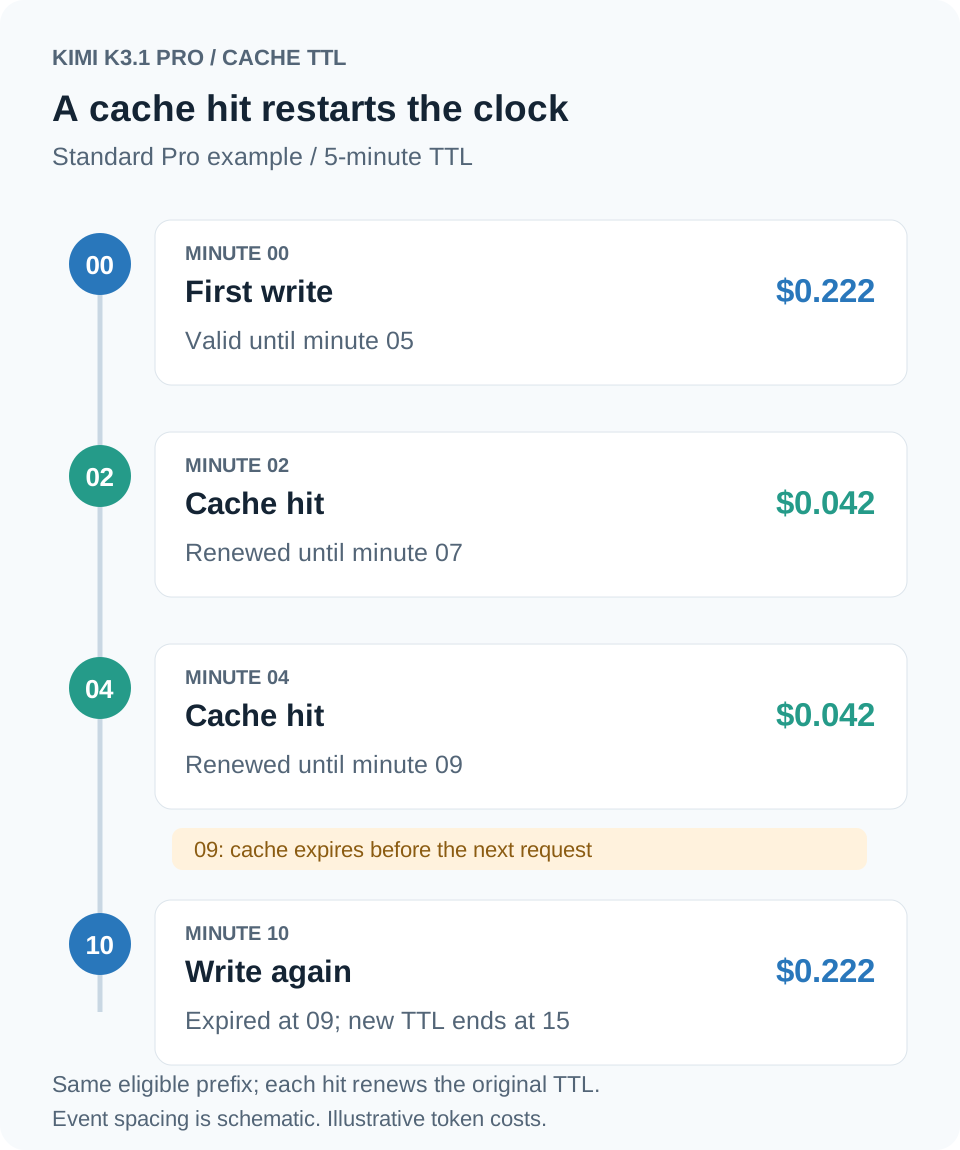
Le nombre de requêtes et leur espacement influencent les coûts récurrents. Dix requêtes qui réutilisent le cache avec succès peuvent coûter un montant différent de dix requêtes qui arrivent régulièrement après son expiration.
Comment les tokens de raisonnement sont-ils facturés ?
Supposons qu’une requête déclare 10 000 tokens de sortie facturables au total, répartis ainsi :
- 9 000 tokens de raisonnement ;
- 1 000 tokens pour la réponse finale.
Les frais de sortie de Standard sont alors :
10,000 ÷ 1,000,000 × $10 = $0.10Les tokens de raisonnement sont déjà inclus dans le total de sortie. Ne les ajoutez pas une deuxième fois. Utilisez le total de sortie facturable déclaré par l’API pour calculer le montant.
Frais des outils et facturation minimale
Trois recherches facturables ajoutent :
3 × $0.005 = $0.015Ajoutez les frais des outils aux frais de tokens du modèle. Les résultats de recherche transmis à une requête ultérieure peuvent aussi augmenter le volume d’entrée.
Calculer le coût des tokens avec du code
Cet exemple JavaScript utilise les tarifs de référence de Standard. Remplacez les nombres de tokens par votre utilisation pour obtenir le coût correspondant.
// Standard Pro reference rates checked on October 27, 2026.
// Input categories must not overlap.
const tokens = {
  regularInput: 1_000,
  cachedInput: 100_000,
  cacheWrite5m: 0,
  cacheWrite1h: 0,
  output: 2_000, // Includes billed reasoning tokens.
};

const ratePerMillion = {
  regularInput: 2,
  cachedInput: 0.2,
  cacheWrite5m: 2,
  cacheWrite1h: 4,
  output: 10,
};

const tokenCost = Object.entries(tokens).reduce(
  (total, [category, count]) =>
    total + (count * ratePerMillion[category]) / 1_000_000,
  0
);

console.log(`Estimated token cost: $${tokenCost.toFixed(6)}`);
// Estimated token cost: $0.042000ratePerMillion lorsque les tarifs de votre compte changent.Questions fréquentes
Quel est le prix de Kimi K3.1 Pro par token ?
Aux tarifs de base de Standard :
- Entrée ordinaire : 0,000002 dollar par token.
- Sortie : 0,00001 dollar par token.
- Lecture du cache : 0,0000002 dollar par token.
Chaque catégorie possède son tarif. Le prix d’une requête dépend du nombre de tokens facturés dans chacune d’elles.
Si la lecture du cache coûte 90 % de moins, la requête coûte-t-elle aussi 90 % de moins ?
Non. Cette baisse de 90 % compare le tarif de lecture du cache de Standard à son tarif d’entrée ordinaire. La sortie, l’écriture dans le cache et les outils peuvent toujours contribuer au coût total.
Pourquoi les prix diffèrent-ils d’un site à l’autre ?
Vérifiez le nom exact du modèle, la variante Standard ou Highspeed, le fournisseur, la devise, l’unité de facturation et la date de mise à jour. Les prix catalogue, les remises propres au compte et les prix moyens pondérés correspondent également à des notions différentes.


