
Test de Kimi K3.1 Pro : programmation, 3D et recherche
Test de Kimi K3.1 Pro : correction de code, Blender et CAO, analyse de données et latence, à partir de benchmarks publics et de cas concrets.
 EvoLink Team
Dans cet article
Les tests publics de Kimi K3.1 Pro montrent des corrections de code réussies et de réelles investigations dans les données, mais aussi des lacunes de validation dans le navigateur et une erreur de regroupement. Les exemples 3D officiels de Moonshot AI complètent ce tableau : le modèle peut utiliser Blender et des outils de CAO pour produire des scènes et des objets structurés.
Les questions pratiques concernent le fonctionnement de ces résultats, les points à vérifier et le temps nécessaire pour obtenir une réponse finale. Artificial Analysis, Atomic Agent, PacBench et Plotly fournissent des résultats concrets à examiner en parallèle des exemples officiels de Moonshot AI.
Test de Kimi K3.1 Pro : programmation, agents et raisonnement
L’évaluation de lancement publiée par Artificial Analysis le 23 octobre 2026 couvre les tâches dans un terminal, les workflows SaaS, le travail intellectuel et les questions de raisonnement difficiles :
| Évaluation | Résultat de K3.1 Pro | Objet de l’évaluation |
|---|---|---|
| Terminal-Bench 4.0 | 67% | Programmation et opérations dans un terminal |
| AutomationBench-AA | 73% | Exécution de workflows SaaS par des agents |
| GDPval-AA | 1 846 Elo | Performance relative sur des livrables de travail intellectuel |
| Humanity’s Last Exam | 52% | Questions difficiles de connaissances et de raisonnement |
Les quatre évaluations portent sur des travaux distincts. Les tâches de terminal et de SaaS demandent à un agent d’agir dans un environnement, tandis que les évaluations de travail intellectuel examinent son livrable. Les questions difficiles ajoutent une autre dimension : trouver la bonne réponse lorsque le raisonnement est exigeant. Un bon résultat dans une catégorie peut coexister avec une faiblesse ailleurs dans le workflow.
Pour un développeur, cette distinction explique pourquoi un benchmark de programmation et une application générée peuvent donner des impressions différentes. Résoudre une tâche dans un dépôt suppose de lire les fichiers, modifier le code, lancer des vérifications et interpréter les échecs. Livrer une application interactive ajoute les commandes, le rendu et les comportements rencontrés après son lancement. Les exemples suivants rendent ces différences visibles.
Programmation : correction de code et tâches longues
Low et max sur une tâche de correction en Python
Atomic Agent a testé un paquet Python contenant cinq bugs introduits volontairement et deux fonctions manquantes : une fonction de règlement et un outil en ligne de commande. L’agent recevait une consigne courte : lire le fichier de tâche, terminer le travail et exécuter les tests jusqu’à leur réussite. Les essais utilisaient Atomic Agent v0.6.9, avec la même tâche et les mêmes outils.
Chaque niveau de raisonnement a fait l’objet de trois exécutions, avec 32 assertions cachées par exécution. Ces contrôles étaient distincts des tests que l’agent pouvait consulter pendant son travail. Les deux réglages ont réussi toutes les assertions :
| Réglage | Assertions réussies sur trois exécutions | Durée moyenne | Appels au modèle en moyenne |
|---|---|---|---|
| Low | 96/96 | 2,2 minutes | 19 |
| Max | 96/96 | 4,9 minutes | 28 |
Pour cette tâche, low était le réglage le plus efficace. D’après les moyennes publiées, max a pris environ 2,2 fois plus de temps et effectué près de 47% d’appels supplémentaires, pour le même résultat aux tests.
Pour corriger du code, le bon point de comparaison est le correctif terminé. Corrige-t-il le comportement demandé, préserve-t-il l’interface publique et évite-t-il les modifications sans rapport ? Un niveau de raisonnement supérieur se justifie lorsqu’il améliore ces résultats. Une explication plus longue ou davantage d’appels aux outils décrivent l’exécution ; ils ne constituent pas à eux seuls un meilleur correctif.
Changer de diagnostic pendant une tâche longue
Le simulateur reposait sur le modèle anatomique human-atlas, comprenant 296 composants squelettiques et 402 composants musculaires. Moonshot décrit des explorations de la dynamique en boucle ouverte pour examiner le problème de mouvement des bras, avant la correction des calculs et le réentraînement du contrôleur.
Cet enchaînement compte dans un système couplé. Un contrôleur peut être entraîné sur une simulation incorrecte, tout comme du code applicatif peut être ajusté autour d’une dépendance défectueuse ou d’une fixture de test erronée. Améliorer sans cesse la boucle extérieure peut laisser intact le défaut sous-jacent. Ici, le modèle est passé de l’objectif d’entraînement au simulateur qui définissait l’environnement d’entraînement.
Dans une longue tâche de programmation, progresser peut donc aussi signifier changer de piste : lire une dépendance, vérifier une hypothèse numérique ou revoir l’explication initiale après un nouveau résultat. Le livrable doit conserver suffisamment de traces — fichiers modifiés, commandes de test et résultats mesurés — pour permettre à un autre développeur de poursuivre le travail.
Un jeu généré et une validation incomplète
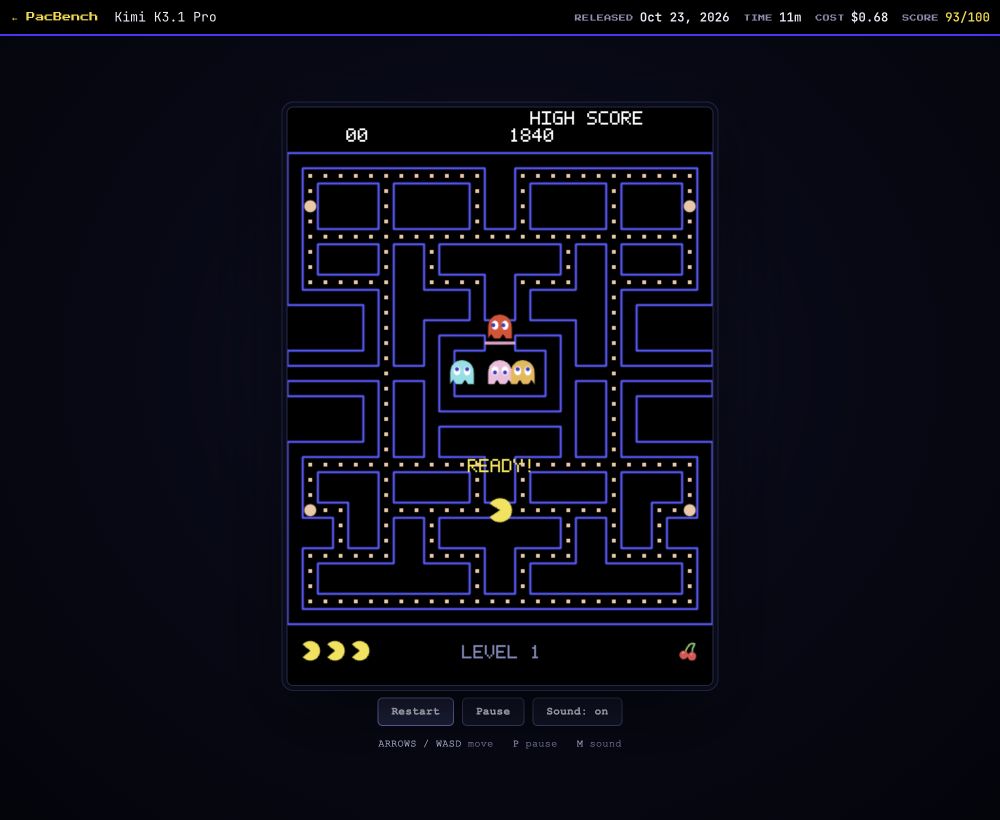
L’entrée K3.1 Pro de PacBench utilisait le niveau high, comptait 17 réponses du modèle et a pris environ 11,5 minutes. Le jeu Pac-Man généré est jouable publiquement, accompagné de son journal d’exécution.
L’évaluateur a aussi décrit ce qui fonctionnait : un labyrinthe classique de 28×31 cases, les 244 pastilles accessibles et aucun déplacement bloqué aux fréquences d’images testées. Ces éléments rendent les défauts restants plus instructifs qu’une simple étiquette « fonctionne » ou « ne fonctionne pas ».
Il restait donc à valider le jeu dans un navigateur. Un substitut dans Node pouvait exercer les transitions d’état du jeu, mais le focus clavier et l’audio des onglets en arrière-plan relèvent du navigateur. Pour un livrable interactif, vérifier la condition de victoire et vérifier l’expérience de jeu sont deux parties distinctes du travail.
Modélisation 3D : Blender, CAO et vérification des fichiers
Ce que reconstruit le benchmark de CAO
La métrique est le Voxel IoU : le recouvrement géométrique entre la forme générée et la référence dans un espace de voxels. Elle mesure la similarité des formes, pas la proportion de fichiers prêts pour la production. La tâche se rapproche davantage de la reconstruction d’un objet que de la création d’une image convaincante de cet objet.
D’une forme visible à un fichier 3D modifiable
Pour un objet donné, examinez trois niveaux :
| Niveau | Points à examiner |
|---|---|
| Forme globale | Silhouette, proportions et organisation spatiale |
| Structure locale | Connexions, occultations, symétrie et détails |
| Utilisation pratique | Fichiers sources, dimensions, topologie et résultats d’export |
Grille de vérification des objets 3D : établie pour cet article.
Pour un objet mécanique, demandez-vous si les pièces reliées se rejoignent au bon endroit et si une modification de dimension conserve leur relation. Pour une scène architecturale, examinez les composants répétés, les ouvertures et la disposition des espaces. Ces vérifications révèlent des intersections et des connexions absentes qu’une seule vue peut masquer.
Le format de livraison compte également. Une prévisualisation permet l’examen visuel, des fichiers modifiables permettent de poursuivre le travail et un export permet de passer à un autre outil. Définir le format attendu dès le départ aide à distinguer une bonne présentation d’un fichier sur lequel une autre personne peut réellement travailler.
Analyse de données : le résultat de 42/43 de Plotly et une erreur de regroupement
Le modèle a réussi 42 questions, dont les cinq sur les motifs cachés et les trois sur la qualité des données.
Trouver des problèmes que la question ne mentionne pas
Dans les cas de qualité des données, Plotly indique que K3.1 Pro a repéré des lignes dupliquées et l’absence du dernier jour du mois, puis distingué les éoliennes mises hors service sans données de celles dont la production était nulle. Ces états sont différents, même si une simple agrégation peut les faire paraître similaires.
Les questions sur les motifs cachés ajoutent un autre travail : explorer des relations sans recevoir d’indication exacte sur ce qu’il faut trouver. Cela rend le résultat pertinent pour l’analyse exploratoire, où la requête suivante dépend des découvertes de la précédente.
Comment une petite erreur de regroupement change la réponse
Cela change la population comparée. « Ne pas utiliser ce firmware » et « utiliser un autre firmware » désignent des groupes différents lorsque certains enregistrements n’ont aucun firmware. Ajouter ces états manquants modifie la référence avant même l’application d’un test statistique.
La méthode peut donc sembler rigoureuse alors que la question a déjà changé. Une vérification utile commence par la population : quels enregistrements entrent dans chaque groupe, lesquels sont exclus et que signifie une valeur manquante dans ces données ? Examinez ensuite le calcul et vérifiez que le texte décrit les filtres réellement utilisés. Le calcul ne répond à la question visée que si les groupes correspondent à sa définition métier.
Livrables financiers et travaux de recherche
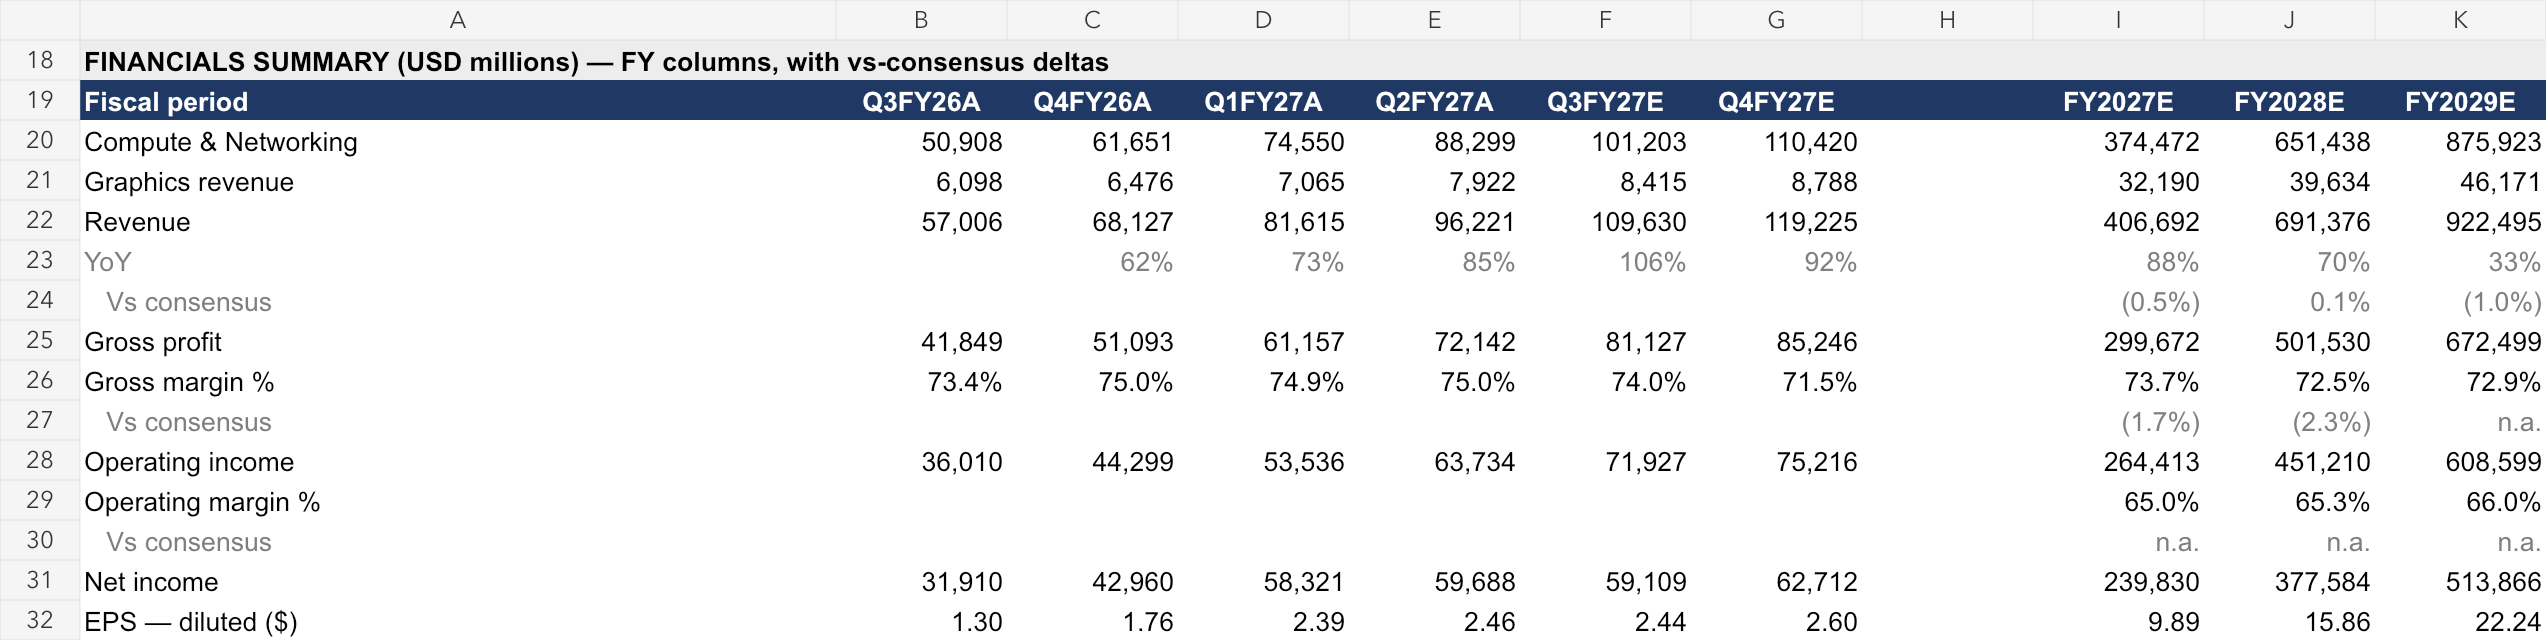
La capture NVDA présente des colonnes trimestrielles et annuelles avec le chiffre d’affaires, le bénéfice, les marges et le bénéfice dilué par action. Pour cette page de synthèse financière, l’utilité dépend de la facilité à relier les grands chiffres aux hypothèses et aux feuilles de calcul qui les étayent.
Dans un classeur de modélisation, suivez une prévision depuis une hypothèse, à travers les références de formules, jusqu’à la synthèse. Vérifiez la concordance des périodes comptables et qu’une hypothèse modifiée met à jour les résultats attendus. Dans un rapport ou une présentation, remontez des affirmations importantes aux sources et vérifiez que les graphiques et les conclusions écrites emploient la même période et la même définition.
Ces fichiers montrent aussi que livrer une recherche dépasse la génération d’une longue réponse. Un classeur contient des dépendances numériques, des diapositives nécessitent une progression claire des arguments et un rapport doit étayer ses conclusions de manière traçable. Le modèle contribue aussi à organiser ces relations dans un format qu’une autre personne peut vérifier et modifier.
Compréhension des images et des vidéos : vérifications pratiques
- Pour les graphiques, vérifier ensemble les valeurs, les unités et les définitions statistiques.
- Pour les tâches spatiales, contrôler les positions et les relations entre objets.
- Pour les vidéos, tester l’ordre des actions et les changements d’état entre images.
Un graphique illustre la différence entre lecture et interprétation. Extraire deux valeurs n’est qu’un début si une série utilise une autre unité, une autre période ou une autre population. Une réponse utile doit rattacher chaque valeur au bon axe, à la légende et à son explication.
content multimodal sous forme de tableau de parties de message, avec des images fournies en base64 ou par référence à un fichier téléversé. Le guide décrit le traitement vidéo par images clés : leur nombre et leur résolution influencent le volume d’entrée. Ces détails figurent dans le guide des entrées visuelles.Pour les vidéos, choisissez des exemples dont la réponse dépend de la séquence et pas d’une seule image : ce qui a changé avant une panne, par exemple, ou quelle action en a précédé une autre. Les tests publics présentés ici portent surtout sur la programmation et les données ; une application visuelle doit avoir ses propres exemples des événements et détails à reconnaître.
Latence du raisonnement : attendre la réponse finale
Le 24 octobre 2026, AIHubMix a testé un prompt demandant une explication des tables de hachage accompagnée de code Python, avec trois exécutions de Pro standard en low. Le délai mesuré différait nettement entre le premier token de raisonnement et le premier token de réponse finale :
Délai jusqu’au premier token de raisonnement et de réponse finale
Pro standard · un prompt · niveau low · trois exécutions
- Premier token de raisonnement
- 3,6–4,5 s
- Premier token de réponse finale
- 71–91 s
Secondes depuis le début de la requête
Le raisonnement représentait environ 85%–90% des tokens de complétion sur ces exécutions, et l’une d’elles a atteint le plafond de 8 192 tokens de complétion. Une interface qui n’affiche que les réponses finales peut donc sembler inactive alors que le modèle diffuse déjà son raisonnement.
Progression du flux et réponse exploitable
Trois mesures décrivent des parties différentes de l’expérience : le début du flux, le début du texte de réponse finale et la fin de la réponse. Même avec une connexion saine, l’utilisateur peut attendre longtemps une réponse exploitable. Un premier token rapide ne décrit donc pas toute l’attente.
Pour une application interactive, mesurez ces trois moments avec les prompts réellement envoyés par les utilisateurs. Notez aussi le niveau de raisonnement et la limite de complétion, pour distinguer une réponse rapide mais tronquée d’une réponse terminée. Pour une tâche en arrière-plan, la qualité finale et la durée totale peuvent compter davantage que l’apparition du premier texte.
reasoning_content pour les fragments de raisonnement et content pour ceux de la réponse finale. Une application peut ainsi distinguer l’état du traitement de la réponse qu’elle affiche ou analyse. Pour les workflows multi-tours avec outils, le guide de démarrage demande également de conserver le message assistant complet et les résultats d’outils correspondants, plutôt que le seul texte de la réponse finale.Cela relie la mesure du temps au comportement de l’agent. L’application gère une tâche en cours, avec des appels d’outils, des observations retournées et une réponse finale. Le niveau de raisonnement est un réglage de ce processus ; la validation et la gestion des messages restent déterminantes pour livrer correctement le travail.
À quelles tâches Kimi K3.1 Pro convient-il ?
Les cas présentés suggèrent des priorités différentes selon le travail :
| Capacité | Ce que les éléments disponibles étayent | Limites restantes |
|---|---|---|
| Programmation et tâches longues | Corrections terminées et débogage prolongé | La fiabilité sur de plus grands projets doit être vérifiée dans l’environnement cible |
| 3D et raisonnement spatial | Construction de scènes et d’objets avec des outils | Le recouvrement des formes ne garantit ni la topologie ni la qualité d’export |
| Analyse de données et recherche | Bons résultats dans le test spécialisé de Plotly | Les règles de regroupement et les hypothèses peuvent encore être erronées |
| Compréhension visuelle | Prise en charge officielle des images et vidéos | Ces tests n’établissent pas la précision sur des tâches visuelles spécialisées |
| Raisonnement et exécution | Raisonnement et utilisation d’outils soutenus | Un effort supplémentaire peut accroître la latence sans améliorer le résultat mesuré |
Synthèse des sources examinées ci-dessus.
Commencez par une correction de code ou une analyse dont vous pouvez mesurer la qualité. Pour une correction, conservez le cas d’échec initial et examinez le diff obtenu. Pour l’analyse, gardez quelques réponses connues et incluez des états manquants ou exceptionnels. Pour la 3D, convenez des formats sources et d’export avant d’examiner la prévisualisation.
Comparez la qualité finale, le temps d’exécution, les appels d’outils et les tokens consommés avant d’élargir aux tâches moins structurées. Le comparatif low/max d’Atomic, la lacune de validation navigateur de PacBench et l’erreur de regroupement de Plotly fournissent chacun un contrôle concret à intégrer. Ensemble, ils relient l’évaluation au travail réel du modèle.
Questions fréquentes
Kimi K3.1 Pro peut-il créer des modèles 3D modifiables ?
Faut-il choisir low ou max pour programmer ?
Comparez-les d’abord sur des tâches représentatives. Dans l’expérience Python d’Atomic Agent, les deux réglages ont réussi les mêmes assertions ; low a pris en moyenne 2,2 minutes et 19 appels, contre 4,9 minutes et 28 appels pour max. Augmentez l’effort lorsqu’il améliore suffisamment les correctifs ou le taux de réussite pour justifier le temps et la consommation supplémentaires.
Pourquoi Kimi K3.1 Pro diffuse-t-il un flux sans réponse finale ?
Le résultat de 42/43 chez Plotly permet-il d’utiliser directement les conclusions ?
C’est un bon résultat sur le jeu de données synthétiques de parc éolien de Plotly. L’échec sur la question du firmware montre pourquoi il faut encore examiner la population et les règles de regroupement. Sur d’autres données, vérifiez les valeurs manquantes, les périodes, les formules et les sources avant d’utiliser les conclusions.


