GPT-6.1 Terra vs GPT-6.1 Sol : quel modèle choisir ?
Comparez GPT-6.1 Terra et Sol pour le code, l’analyse de données, l’effort de raisonnement et le coût par tâche.
Himi LiProduct Manager at EvoLink
10 min de lecture
Dans cet article
Essayez GPT-6.1 Terra pour les tâches bien délimitées : actions à l’écran, rédaction à partir de documents fournis et petites corrections de code. Gardez GPT-6.1 Sol comme point de départ pour le code complexe et les projets où une dépendance oubliée entraîne beaucoup de reprises.
Les tarifs Standard de Terra sont plus bas. Reste à choisir un niveau de raisonnement qui fournisse la qualité nécessaire. Augmenter cet effort peut modifier la facture et l’attente : choisir entre Terra et Sol, c’est aussi choisir une configuration.
GPT-6.1 Terra vs GPT-6.1 Sol : les principales différences
Critère
GPT-6.1 Terra
GPT-6.1 Sol
Point de départ conseillé
Actions à l’écran définies, rédaction à partir de faits fournis, corrections ciblées
Code complexe et travail professionnel avec de nombreuses dépendances
Entrée / sortie Standard, par million de tokens
$1 / $5
$2 / $10
Entrée en cache, par million de tokens
$0.05
$0.10
Effort de raisonnement
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Effort par défaut
medium
medium
Appels d’outils
Responses API requise
Responses API requise
Spécifications et tarifs officiels : Terra, Sol, prix. Il s’agit des tarifs Standard d’OpenAI ; le contexte long et les autres modes de traitement ont leurs propres conditions.
Les deux modèles acceptent le texte et les images et produisent du texte. Leur fenêtre de contexte est de 1 050 000 tokens, avec une sortie maximale de 128 000 tokens. La capacité de contexte ne les départage donc pas. Référence Terra ; référence Sol.
Code, utilisation de l’ordinateur et analyse de données : lequel choisir ?
Code : Terra pour une correction ciblée, Sol pour un projet aux éléments liés
Un problème de mise en page facile à reproduire convient bien à un premier essai avec Terra. Une fonctionnalité touchant à l’authentification, à la facturation et à un état partagé justifie davantage Sol : une interaction oubliée peut coûter plus cher en reprises que l’écart de prix des tokens. Ce partage correspond aux conseils de sélection d’OpenAI.
Artificial Analysis indique 48 points pour Terra et 54 pour Sol dans son Coding Agent Index v2.0. Celui-ci regroupe modifications de dépôt, tâches de terminal et questions sur le dépôt. Un seul test de terminal ne résume donc pas tout un travail de développement. Analyse AA ; méthodologie.
Il existe aussi une exception intéressante : OpenAI rapporte que Terra en max dépasse Sol sur Terminal-Bench-Science 0.1 à moindre coût, tout en recommandant Sol ou Astra pour le code le plus complexe. Un travail scientifique dans un terminal et une refonte d’application ont des exigences différentes. Évaluation OpenAI.
Ordinateur et rédaction : Terra mérite un premier essai
Terra peut convenir à un flux consistant à lire une facture et à saisir ses champs dans une application. Les évaluations de compréhension visuelle et d’utilisation de l’ordinateur d’OpenAI montrent ses résultats sur ce type de tâche. OpenAI.
Essayez-le aussi lorsque les faits et le livrable sont clairs : transformer des notes de version en documentation client ou réviser une proposition pour un public défini. Si le travail exige de réconcilier des éléments contradictoires dans un projet complexe, Sol reste un point de départ plus prudent. Guide de sélection.
Analyse de données : les questions difficiles peuvent justifier Sol
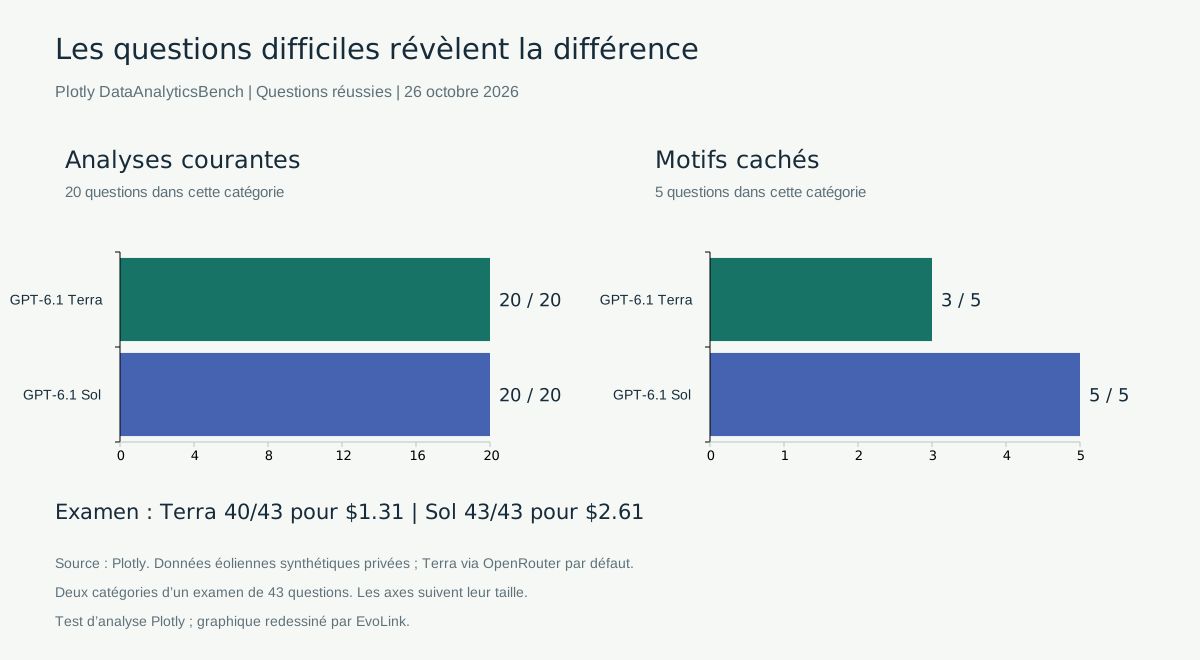
L’examen de 43 questions de Plotly donne un exemple concret. Terra en a réussi 40 pour $1.31 ; Sol, les 43 pour $2.61. Les deux ont réussi les 20 questions d’analyse courante. Sur les motifs cachés, Terra en a trouvé trois sur cinq et Sol les cinq. Résultats Plotly.
Résultats Plotly : Terra et Sol réussissent 20 questions courantes sur 20 ; pour les motifs cachés, Terra obtient 3 sur 5 et Sol 5 sur 5.
Les analyses courantes et la recherche de motifs cachés peuvent conduire à des choix différents. Graphique redessiné à partir des résultats publiés par Plotly.
Terra est ainsi un candidat plausible pour les requêtes récurrentes bien définies. Sol mérite davantage d’attention quand il faut découvrir ce que la question ne nomme pas encore. L’examen utilisait des données synthétiques privées de parcs éoliens. Terra passait par OpenRouter, avec le raisonnement par défaut et une forte réutilisation du cache. Conditions du test ; conception du benchmark.
Terra high ou Sol medium : quel effort de raisonnement choisir ?
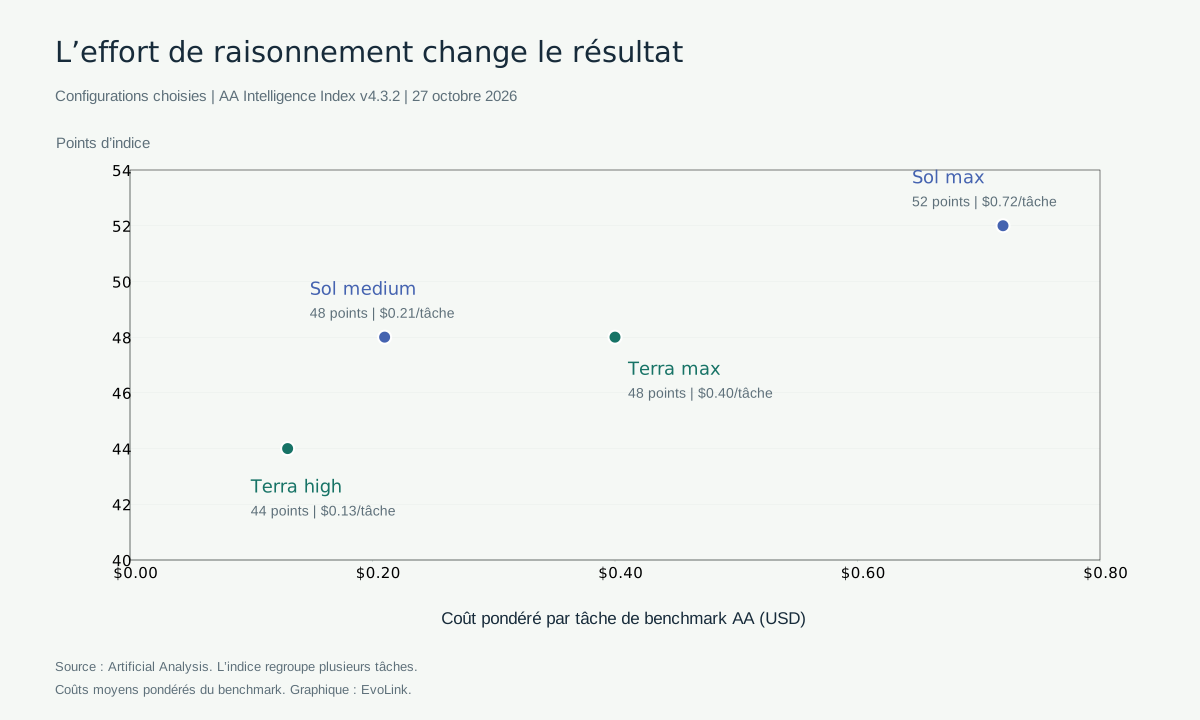
Dans les résultats AA, Terra high coûte moins cher par tâche de benchmark, tandis que Sol medium obtient le meilleur score global.
Modèle et effort
AA Intelligence Index
Coût moyen pondéré par tâche de benchmark AA
GPT-6.1 Terra · high
44
$0.13
GPT-6.1 Sol · medium
48
$0.21
GPT-6.1 Terra · max
48
$0.40
GPT-6.1 Sol · max
52
$0.72
Données du 27 octobre 2026 : classement des fournisseurs AA et comparaison max/max. L’indice est un score composite, pas un pourcentage de tâches réussies. Les coûts sont des moyennes pondérées de tâches de benchmark.
Configurations AA : Terra high obtient 44 points à $0.13 par tâche, Sol medium 48 à $0.21, Terra max 48 à $0.40 et Sol max 52 à $0.72.
Le nom du modèle et son effort se choisissent ensemble. Sources : classement AA et max/max.
Terra max et Sol medium affichent tous deux 48, mais leurs résultats détaillés diffèrent : Terra max obtient 56 % contre 48 % sur Terminal-Bench 4.0, tandis que Sol medium mène 63 % à 60 % sur AutomationBench-AA. Un même score arrondi ne signifie pas des résultats identiques sur votre travail. Terra max ; Sol medium.
AA distingue aussi les réglages efficaces selon l’objectif : Terra low et medium sont sur sa frontière d’efficacité intelligence/coût ; low et xhigh sur celle du code. Une règle imposant toujours medium, ou évitant systématiquement les efforts élevés, efface cette différence. Analyse AA.
Terra est-il vraiment plus rapide et moins cher que Sol ?
Mesurer le débit et l’attente avant la première réponse
Artificial Analysis publie séparément la vitesse de sortie et le temps jusqu’au premier token pour chaque configuration et fournisseur. Ces mesures évoluent : consultez celles du point d’accès que vous comptez utiliser. Classement AA.
Pour un assistant interactif, le début de la réponse compte. Pour un agent enchaînant des outils, mesurez le moment où le résultat est réellement enregistré ou livré. Les définitions de performance d’AA distinguent ces indicateurs. La page calcule aussi le temps d’une réponse de 500 tokens ; il ne correspond pas à la durée d’un travail complet de code ou de bureau.
Dans DataAnalyticsBench de Plotly, sur 43 questions, le temps médian entre la question et la réponse finale, requêtes comprises, était de 15 secondes pour Terra et 18 secondes pour Sol. Terra a réussi 40 questions et Sol 43. Le test utilisait des données synthétiques privées de parc éolien ; Terra passait par OpenRouter avec son niveau de raisonnement par défaut. Résultats Plotly ; conditions du test Terra.
Le tarif par token ne suffit pas à déterminer le coût du travail
À volume facturable identique en Standard, les frais d’entrée et de sortie de Terra sont moitié moins élevés. L’effort change toutefois la consommation de tokens. En max, AA affiche $0.40 contre $0.72 par tâche de benchmark, soit environ 44 % de moins pour Terra. Entre niveaux différents, Sol medium est moins cher que Terra max. Tarifs officiels ; AA max/max ; classement.
AA calcule ce coût à partir de moyennes d’évaluation pondérées et de frais de tokens. Pour une tâche acceptée par votre équipe, utilisez un autre dénominateur. Définition AA :
Coût par tâche acceptée = dépenses totales de modèles et d’outils, tentatives échouées comprises ÷ nombre de tâches acceptées
Suivez aussi le temps de vérification humaine. Une réponse bon marché qui demande plusieurs corrections peut être moins intéressante qu’une tâche ciblée que Terra termine proprement. L’économie dépend de la fréquence à laquelle le flux produit un résultat acceptable.
Changer de modèle, garder Sol ou utiliser les deux ?
Commencez par une catégorie de travail bien définie :
Votre travail
Choix de départ
Quand changer ?
Correction locale de code reproductible
Évaluer Terra
Erreurs répétées de périmètre ou régressions oubliées : garder Sol
Fonctionnalité ou refonte dans des fichiers inconnus
Garder Sol comme référence
Étendre Terra quand il traite les dépendances de façon fiable
Écrans, formulaires et rédaction à partir de documents
Évaluer Terra
Champs enregistrés incorrects ou faits omis : clarifier l’entrée ou choisir un modèle plus fort
Analyses récurrentes avec questions connues
Évaluer Terra
Motifs cachés et questions plus difficiles : avantage à Sol
Flux déjà fiable avec Sol
Le garder tout en testant Terra sur une partie ciblée
Changer quand qualité, coût et attente justifient la transition
Les deux modèles peuvent se compléter : Terra sur les tâches qu’il maîtrise, Sol sur les plus difficiles. Une escalade doit s’appuyer sur un signal vérifiable, comme un test échoué ou un champ obligatoire manquant dans un enregistrement. La confiance affichée par le modèle ne remplace pas cette vérification.
Pour une première comparaison, fournissez les mêmes entrées représentatives et critères d’acceptation. Faites varier l’effort séparément du modèle afin d’identifier la cause des différences. Choisissez ensuite le couple qui satisfait vos exigences de qualité et de délai à un coût acceptable.
Vérifier aussi la voie d’accès
La passerelle API unifiée d’EvoLink permet de gérer le choix des modèles dans une même intégration. Consultez les pages GPT-6.1 Sol et GPT-6.1 Terra pour l’accès et les tarifs actuels. La route retenue doit prendre en charge le flux d’outils nécessaire à votre application.
Questions fréquentes
GPT-6.1 Terra est-il meilleur que Sol pour coder ?
Sol a le score composite de code AA le plus élevé. Terra reste à essayer pour les corrections ciblées et certains travaux de terminal ; OpenAI rapporte aussi un avantage sur son évaluation scientifique. Le type de tâche compte. AA ; OpenAI.
Terra high équivaut-il à Sol medium ?
Il n’y a pas d’équivalence fixe. Dans le relevé AA, Terra high a un score global et un coût moyen de benchmark plus bas. Même Terra max, dont le score affiché rejoint celui de Sol medium, a des résultats différents par tâche. AA ; Terra max ; Sol medium.
Les deux utilisent-ils la même API pour les outils ?
OpenAI documente la Responses API pour les appels d’outils des deux modèles. Vérifiez aussi la prise en charge de ce flux par votre route ou client. Référence Terra ; référence Sol.

 Himi LiProduct Manager at EvoLink