GPT-6.1 Terra vs Claude Opus 5.5 : Opus vaut-il le surcoût ?
Comparez Terra et Opus 5.5 : coûts, code complexe, automatisation et migration d’un agent vers une autre API.
 Himi LiProduct Manager at EvoLink
Dans cet article
GPT-6.1 Terra peut-il remplacer Opus 5.5 ?
Si vous utilisez déjà Opus, la question utile est précise : quelles tâches peuvent passer sur Terra sans que les corrections supplémentaires absorbent l’économie ? Cela peut représenter une part importante du travail sans concerner toute l’application.
Terra est-il quatre ou neuf fois moins cher ?
Les deux chiffres correspondent à des comparaisons publiées, avec des dénominateurs différents. Les tarifs Standard cités pour Terra couvrent jusqu’à 272 000 tokens d’entrée par requête. Au-delà, les tarifs de contexte long sont plus élevés.
| Comparaison de coût | Résultat | Périmètre |
|---|---|---|
| Tarif API Standard officiel par token | Entrée et sortie de Terra 75 % moins chères : $1/$5 contre $4/$20 par million de tokens | Frais de modèle pour un même volume de tokens |
| Expérience Agents’ Last Exam d’OpenAI | OpenAI rapporte un coût par tâche environ neuf fois inférieur avec Terra max face à Opus 5.5 | Évaluation d’utilisation de l’ordinateur d’OpenAI |
| Configurations max sélectionnées par AA | Coût pondéré par tâche de l’Intelligence Index : Terra $0.40, Opus avec Default Fallback $5.98, soit un rapport proche de 15 | Moyenne pondérée des tâches de benchmark AA |
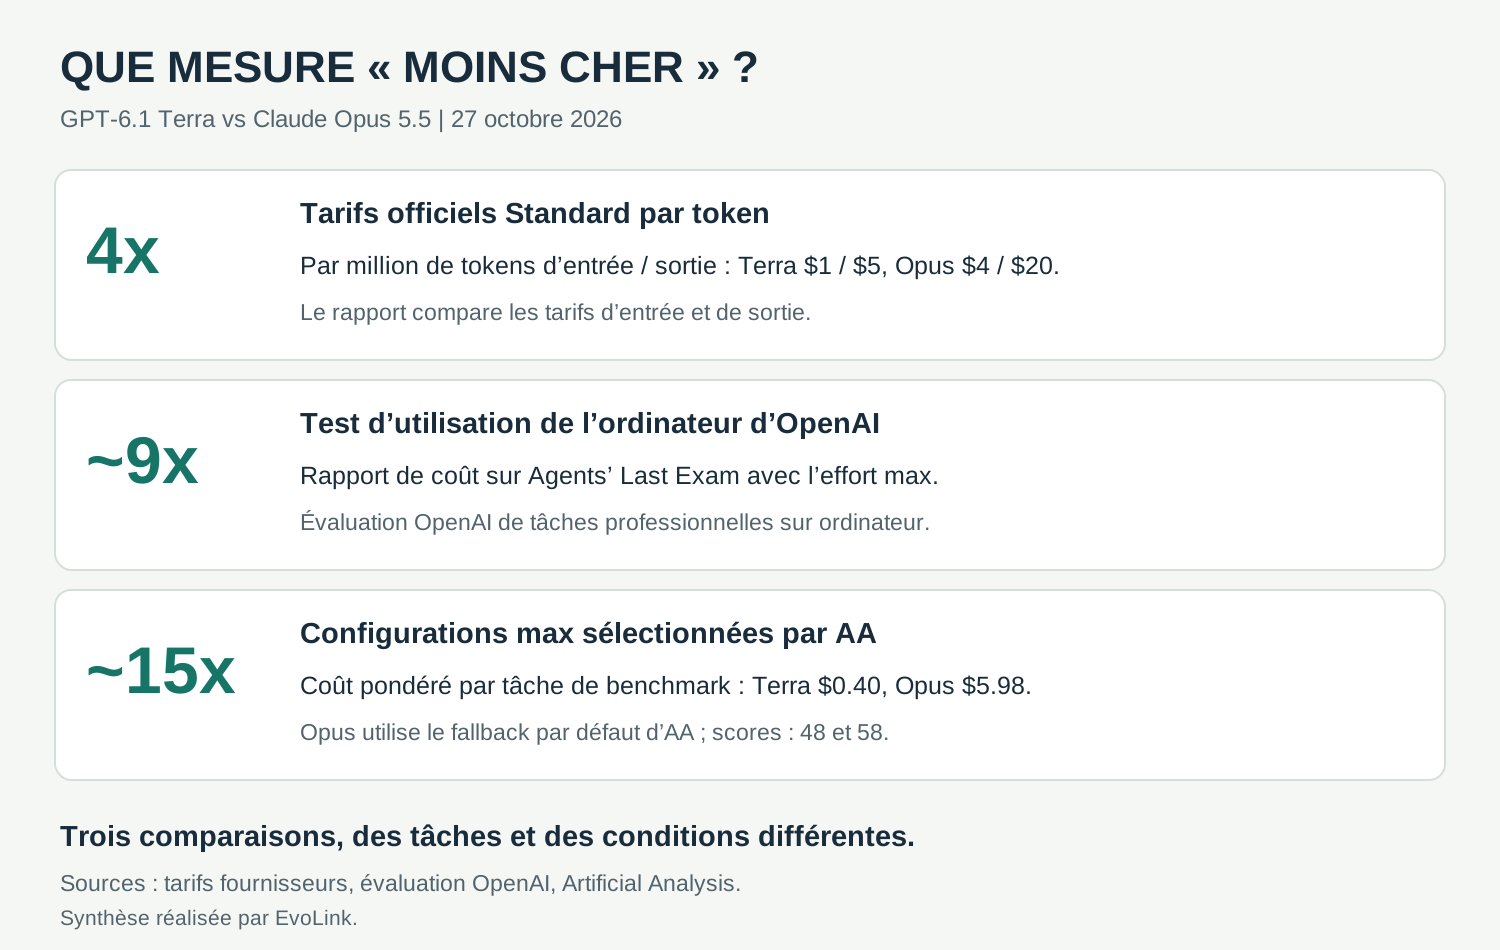
Le facteur neuf d’OpenAI vient de son évaluation de tâches professionnelles sur ordinateur. Ailleurs, le coût dépend des tokens, des outils et des nouvelles tentatives.
En production, additionnez les dépenses de modèle et d’outils sur toutes les tentatives, puis divisez par le nombre de résultats acceptés. Suivez le temps de vérification humaine à côté. Un tarif bas est surtout utile lorsque le flux aboutit sans interventions répétées.
Dans quels cas le surcoût d’Opus se justifie-t-il ?
Les résultats d’un même évaluateur offrent une base plus utile que les scores mis en avant séparément par chaque fournisseur :
| Résultat AA, configurations max sélectionnées | Terra | Opus, Default Fallback |
|---|---|---|
| Intelligence Index | 48 | 58 |
| Terminal-Bench 4.0 | 56% | 60% |
| AutomationBench-AA | 60% | 70% |
Opus mène sur ces indicateurs, avec une avance différente selon les tâches. Il constitue une bonne référence pour le code difficile et les flux d’agents dont les étapes sont liées.
Test EvoLink : un pélican à vélo
Dans ce test EvoLink, GPT-6.1 Terra apparaît à gauche et Claude Opus 5.5 à droite.
Ces résultats sont des exemples, pas un benchmark contrôlé : ils ne démontrent pas un avantage général en qualité de code ou en coût.
Quand Terra devient-il intéressant pour l’automatisation ?
Et pour les documents longs, l’analyse et la rédaction ?
Pour rédiger à partir d’un brief complet, par exemple transformer des notes de version en documentation client, Terra est un candidat pertinent : les faits et omissions se vérifient. Pour une analyse qui doit réconcilier des documents contradictoires, les résultats plus larges d’Opus justifient de le garder comme première référence.
Si le style ou l’approche analytique compte pour vous, testez les deux sur vos propres documents et comparez le résultat ainsi que les retouches nécessaires.
Peut-on passer un agent Claude existant sur Terra ?
gpt-6.1-terra et claude-opus-5-5. Changer ce nom n’adapte pas automatiquement les messages d’outils, les réglages de raisonnement, l’état de la conversation ou le cache.Trois différences comptent pour un agent :
- Raisonnement et outils. Terra propose none à max, utilise medium par défaut et exige la Responses API pour les outils. Opus utilise un raisonnement adaptatif toujours actif, avec medium par défaut. Son API native restreint l’utilisation forcée d’outils. Des noms d’effort identiques ne garantissent pas un calcul identique. Terra ; Opus ; guide effort Claude.
- Historique. Anthropic documente des contraintes de blocs de raisonnement propres au modèle et à la conversation. Un changement au cours d’une longue session Claude demande de préparer l’historique ; tout son contenu interne ne se rejoue pas automatiquement chez un autre fournisseur. Comportement d’Opus.
- Cache. Aux tarifs API Standard des fournisseurs, la lecture du cache coûte $0.05 par million de tokens pour Terra et $0.20 pour Opus. Les écritures coûtent $1.25 pour 30 minutes ou $2.50 pour 12 heures avec Terra, contre $5 pour 5 minutes ou $8 pour une heure avec Opus. Les durées différentes influent sur la réutilisation et les réécritures. Les tarifs Terra s’appliquent aux requêtes de 272 000 tokens d’entrée maximum. Prix OpenAI ; prix du cache Anthropic.
L’application de code apporte aussi ses outils, sa gestion du contexte et son orchestration. Vérifiez que votre configuration Claude Code ou autre client accepte le modèle. Les prix API et les quotas d’un abonnement sont également des comparaisons différentes.
La passerelle API unifiée d’EvoLink permet de gérer des choix de modèles dans une intégration commune. Avant de déplacer un agent, vérifiez le point d’accès de la route, les outils, les réglages de raisonnement et la facturation. Les références fournisseurs décrivent les capacités natives ; la prise en charge par la route choisie fait partie du test d’intégration.
Quelles tâches déplacer en premier ?
Si Opus traite déjà vos travaux de code et d’analyse les plus difficiles de façon fiable, gardez-le sur ces tâches. Le meilleur premier rôle de Terra est une catégorie clairement définie, avec des résultats directement vérifiables.
Par exemple, Opus peut garder la responsabilité d’un changement à l’échelle du dépôt, et Terra corriger un problème d’interface isolé et reproductible. Dans un flux opérationnel, Terra peut remplir les champs connus d’un formulaire, tandis que le modèle plus fort examine les exceptions. Faites remonter les échecs observables et les exigences non résolues, plutôt que la seule confiance exprimée.
Le choix dépend de la quantité de travail que la route moins chère accomplit de façon fiable. Un remplacement ciblé et une répartition explicite des tâches sont mieux étayés qu’un remplacement général d’Opus.
Questions fréquentes
GPT-6.1 Terra peut-il remplacer Opus 5.5 pour coder ?
Terra est un bon candidat pour les corrections ciblées. Gardez Opus comme référence pour le code complexe et les agents à plusieurs étapes.
Un coût neuf fois inférieur signifie-t-il une qualité égale ?
Non. Le chiffre vient d’une évaluation précise d’utilisation de l’ordinateur menée par OpenAI. Il n’établit ni une qualité égale, ni des réglages identiques, ni la même économie sur une autre tâche.