Gemini 4 Hydrogen vs Argon: Welches Modell für welche Aufgabe?
Produktionsrouting mit Gemini 4 Hydrogen und Gemini 4 Argon: Aufgabenverteilung, Kosten des gesamten Ablaufs, Eskalationssignale und Fallback-Grenzen.
 EvoLink TeamProduktteam
In diesem Artikel
Dieser Artikel enthält keine kontrollierten Hydrogen-vs.-Argon-Workload-Ergebnisse. Die Funktionsbasis stammt aus Anbieterdokumentation; Richtlinie, Beispiele und Formeln sind Empfehlungen für die Anwendungsarchitektur.
In Googles Leitfaden zur Modellauswahl ist Hydrogen ein Kandidat für alltägliche Programmieraufgaben, multimodale Dokumentarbeit und parallele Ausführung; Argon wird für anspruchsvolle Aufgaben mit langem Planungshorizont positioniert. Das ist die Einordnung des Anbieters, keine gemessene Aufteilung Ihres Traffics. Ein Repository-Dienst könnte beispielsweise routinemäßige, durch Tests abgesicherte Änderungen auf einer Route und modulübergreifende Fehleranalysen auf einer anderen evaluieren, jeweils mit demselben Revisionsstand und denselben Abnahmeprüfungen. Übernehmen Sie eine solche Zuordnung nur, wenn die Ergebnisse sie stützen.
Gemini 4 Hydrogen vs Argon: gemeinsame Funktionen und Grenzen
| Auswahlfaktor | Hydrogen beim Anbieter | Argon beim Anbieter | Prüfung auf EvoLink |
|---|---|---|---|
| Gemeinsamer Kontext | 1.048.576 Tokens für Eingabe, Thinking und Ausgabe | Gleiches gemeinsames Fenster | Protokollgrenzen und nach der Eingabe verbleibender Antwortplatz |
| Lange Ausgabe | Long Decode über einen synchronen Schritt hinaus | Long Decode unterstützt | Native Fortsetzung; kompatibles Protokoll nicht ungeprüft gleichsetzen |
| Thinking | low, medium, high, xhigh; Standard high | low, medium, high; laut Google-Vergleich Standard medium | Unterstützte Werte und ausdrücklich gewählte Einstellung |
| Nicht gestreamter Schritt | Google dokumentiert bis 65.536 | Google nennt vergleichend 32.768 pro REST-Schritt | Tatsächlicher Gateway-Vertrag und SDK-Verhalten |
| Werkzeuge und strukturierte Ausgabe | Funktionen unterstützt | Funktionen unterstützt | Schemas, Thinking-Signaturen, Fehlerbehandlung und Werkzeugausführung |
| Preise | Eigenes Modell und eigener Tarifplan | Eigenes Modell und eigener Tarifplan | Aktueller Kontotarif einschließlich Cache-Eingabe und Werkzeugen |
xhigh erst dann als aktiviert, wenn die Routendokumentation dies bestätigt. Ebenso beweist eine abweichende Google-REST-Grenze nicht, dass das Gateway dieselbe Unterscheidung stillschweigend implementiert.Machen Sie daraus keine spekulative Architekturgeschichte. „Destilliertes Argon“ wird weder durch eine Preisleiter noch durch einen Elementnamen oder ähnliche Antworten belegt. Für den Betrieb zählen die unterstützte Schnittstelle und akzeptierte Ergebnisse unter Ihrer Konfiguration.
Die Route nach den Fehlerkosten der Aufgabe wählen
Beginnen Sie mit dem Ausgabevertrag und den Folgen eines Fehlers. Ein Modell kann für eine Aufgabe ein guter erster Kandidat sein, ohne für eine folgenreichere Variante derselben Aufgabe die sicherste Route zu bilden. Erfassen Sie Klassen getrennt, damit ein Mittelwert keine kritischen Fehler verdeckt.
| Workload | Erste Evaluationsstrategie | Abnahmetest | Wann die erste Strategie nicht genügt |
|---|---|---|---|
| Dokumentextraktion mit festen Feldern | Hydrogen gegen die bestehende Route testen | Pflichtfelder, exakte Werte, Einheiten und Quellenbelege | Kritische Felder fehlschlagen oder Mehrdeutigkeit bleibt ungelöst |
| Repository-Wartung | Beide an reproduzierbaren Aufgaben vergleichen | Tests bestehen, Umfang eingehalten, vertretbarer Prüfaufwand | Schwierige Fehler bleiben und Argon behebt sie nachweislich |
| Agent mit mehreren Werkzeugschritten | Mit der bereits erfolgreichen Route beginnen und die andere testen | Autorisierte Werkzeuge schließen ab; Schlussantwort gibt Ergebnisse korrekt wieder | Gültige Anfragen scheitern trotz zuverlässiger Werkzeuge wiederholt an der Aufgabe |
| Langer Bericht oder erzeugte Spezifikation | Kontext und Fortsetzung vor der Modellwahl prüfen | Vollständige Abschnitte, gültige Verweise, fortsetzbare Ausgabe | Client kann nicht korrekt fortsetzen oder Belege fehlen |
| Folgenreiche Beurteilung ohne automatische Referenz | Dokumentierten Prüfprozess verlangen | Menschlich geprüfte Bewertungsregeln und kritische Fehlerkontrollen | Keines der Modelle liefert notwendige Belege oder Befugnisse |
Bei Extraktion zählt nicht, ob Argon vorsichtiger klingt, sondern ob es einen konkreten Fehler gegenüber einer Referenz korrigiert. Bei Code geht es um die Behebung des Fehlverhaltens ohne neue Regression. Beim Agenten müssen Sie Modellfehler von Werkzeugausfällen trennen: Ein Modellwechsel stellt keine ausgefallene Datenbank wieder her und erteilt keine fehlende Berechtigung.
„Worker“ und „Verifier“ sind vorgeschlagene Rollen Ihrer Anwendung, keine vom Modellnamen garantierten Fähigkeitsstufen. Prüfen Sie auch den Verifier. Zwei Modelle können derselben unbelegten Antwort zustimmen; Übereinstimmung ist keine unabhängige Wahrheitsquelle.
Zwischen direkter Route und Eskalation entscheiden
Drei Ausgangsstrategien sind sinnvoll. Vergleichen Sie alle mit derselben eingehenden Aufgabenpopulation und derselben Definition akzeptierter Arbeit.
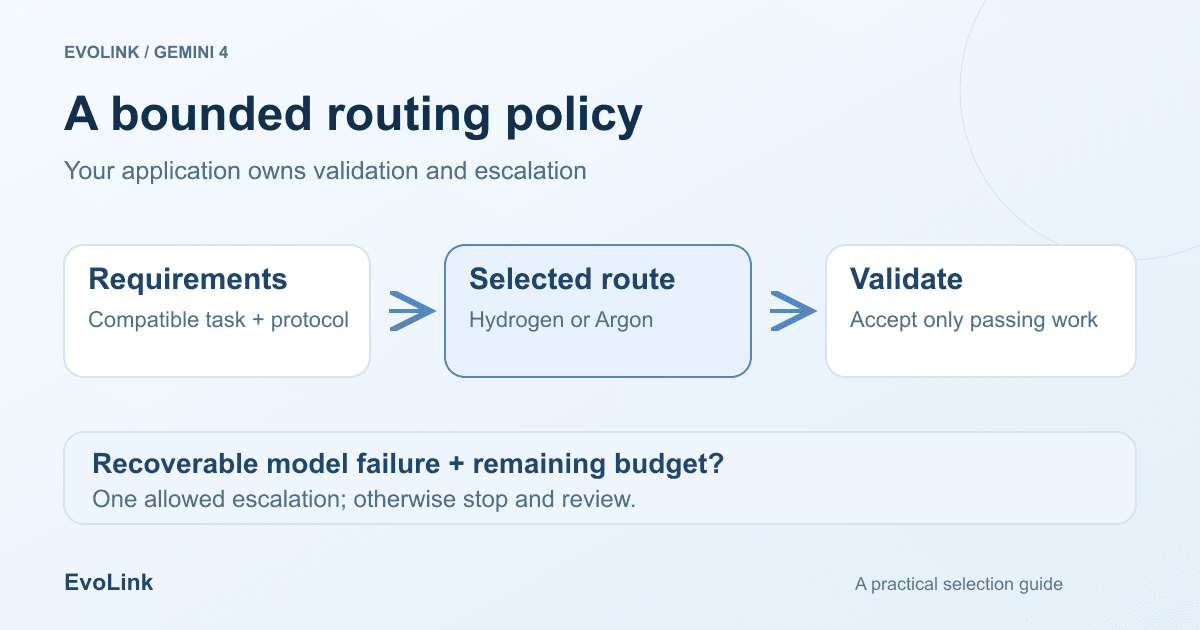
Ein praktischer Entscheidungsbaum geht so vor:
- Harte Anforderungen prüfen. Akzeptiert das Protokoll die Eingabe, stellt es das benötigte Werkzeug bereit und unterstützt es den Ausgabeverlauf? Verwerfen Sie inkompatible Routen vor jedem Qualitätsvergleich.
- Ausgewertete Klassenresultate nutzen. Wählen Sie die direkte Route, die Qualität, Latenz und Kosten der Klasse erfüllt. Fehlen solche Belege, führen Sie eine begrenzte Evaluation durch, statt einen Sieger zu vermuten.
- Antwort validieren. Prüfen Sie Schema, Ausführung, Belege und Berechtigung. Akzeptieren Sie nur Ergebnisse, die den Aufgabenanforderungen genügen.
- Fehler klassifizieren. Fehlende Belege, ausgefallene Werkzeuge, verweigerte Berechtigung, fehlerhafte Daten und ein tatsächlicher Reasoning-Fehler brauchen unterschiedliche Reaktionen.
- Nur behebbaren Modellfehler eskalieren. Übergeben Sie relevante Originalbelege und Validierungsfeedback, kontrollieren Sie Restbudget und verbleibende Zeit und erlauben Sie dann den zweiten Versuch.
- An der Richtliniengrenze stoppen. Scheitert auch Versuch zwei, geben Sie ausdrücklich „unvollständig“ oder „zur Prüfung“ zurück. Wechseln Sie nicht endlos zwischen Modellen, bis eines überzeugend klingt.
Das ist eine Empfehlung für anwendungsseitige Orchestrierung. Sie beschreibt keine eingebaute EvoLink-Funktion, die Antworten automatisch bewertet oder jeden Fehler an ein besseres Modell weiterleitet.
Die gesamte Route einschließlich erfolgloser Arbeit kalkulieren
Für eine Eskalationsstrategie seien:
c_Hdie durchschnittlichen gesamten API-/Werkzeugkosten der Hydrogen-Stufe pro eingehender Aufgabe einschließlich dort erlaubter Wiederholungen;rder Anteil aller eingehenden Aufgaben, der tatsächlich Argon erreicht;c_Adie durchschnittlichen vollständigen API-/Werkzeugkosten der Argon-Stufe pro eskalierter Aufgabe;ader Anteil ursprünglicher Aufgaben, der am Ende dieselben Abnahmekriterien erfüllt.
Dann gilt:
mittlere API-/Werkzeugkosten pro eingehender Aufgabe = c_H + r × c_AAPI-/Werkzeugkosten pro akzeptierter Aufgabe = (c_H + r × c_A) / aDie zweite Formel ist für a gleich null nicht definiert. Berücksichtigen Sie Reviewer-Zeit mit einem ausdrücklich addierten Erwartungswert, statt reine API-Ausgaben als sämtliche Geschäftskosten auszugeben. Population und Abnahmeregeln müssen über alle Strategien gleich bleiben.
Rechnen Sie kostenpflichtige modellbasierte Validierung jener Stufe zu, die sie aufruft. Bewertet ein separates Modell oder ein Dienst die Antwort außerhalb dieser Stufen, addieren Sie dessen erwartete Kosten vor der Division durch die Annahmequote zum Zähler. Lokale Testausführung oder andere Infrastrukturkosten weisen Sie getrennt aus, wenn sie außerhalb Ihrer Definition von API-/Werkzeugausgaben liegen.
| Strategie | Gesamte API-/Werkzeugausgaben | Akzeptierte ursprüngliche Aufgaben | API-/Werkzeugkosten pro akzeptierter Aufgabe |
|---|---|---|---|
| Nur Hydrogen | $6 | 800 | $0.0075 |
| Nur Argon | $12 | 960 | $0.0125 |
| Hydrogen, danach Argon für 200 Aufgaben zu je $0.012 | $8.40 | 950 | Etwa $0.00884 |
In Zeile drei gilt $6 + 200 × $0.012 = $8.40. Haben bei Hydrogen 800 ursprüngliche Aufgaben die Abnahme bestanden, bedeuten insgesamt 950 akzeptierte Aufgaben, dass 150 der 200 Eskalationen zusätzlich erfolgreich waren. Das sind illustrative Annahmen, keine beobachteten Abnahmequoten, Modellpreise oder versprochenen Einsparungen. Die Ergebnisse der Strategien werden getrennt angenommen und stammen nicht aus einem deterministischen gepaarten Test: Eine Eskalation kann Validierungsfeedback und einen anderen Anfragekontext nutzen. Messen Sie ihren Erfolg und c_A an der tatsächlich eskalierten Teilmenge, statt beides aus dem Durchschnitt direkter Argon-Aufrufe abzuleiten. Dieses Beispiel setzt lokale Validierung ohne zusätzliche Modell-API-Gebühr voraus; addieren Sie gegebenenfalls kostenpflichtige Validierung wie oben beschrieben.
Die Strategie kann schnell unattraktiv werden. Bei zu vielen Eskalationen bezahlen Sie die erste Stufe vor jener Route, die Sie ohnehin gebraucht hätten. Übersieht der Validator falsche Antworten, ist die gemeldete Erfolgsquote irreführend. Lehnt er richtige Antworten ab, kosten unnötige Eskalationen Zeit und Geld. Prüfen Sie den Validator gegen menschlich gelabelte oder ausführbare Referenzfälle.
Auch die Latenz ändert sich. Eine eskalierte Aufgabe durchläuft erste Stufe, Validierung und zweite Stufe nacheinander. Mitteln Sie nicht zwei getrennt gemessene p95-Werte und nennen das den p95 der Route. Messen Sie die gesamte Abschlusszeit der tatsächlichen Strategie und weisen Sie eskalierte Fälle getrennt aus, damit eine schnelle Mehrheit den langsamen Fehlerbereich nicht verdeckt.
Überprüfbare Eskalationssignale festlegen
Ein brauchbares Signal ist an eine verletzte Aufgabenanforderung gebunden. Eine vage Selbsteinschätzung wie „Ich bin unsicher“ kann ein Prüfmerkmal sein, darf aber keine unbegrenzte Ausgabenfreigabe werden.
| Signal | Erste Maßnahme | Wann ein anderes Modell sinnvoll ist | Stoppbedingung |
|---|---|---|---|
| Erforderliches Schema oder Typprüfung schlägt fehl | Anfrage und Schema auf Richtigkeit prüfen | Gültige Anfrage bleibt unerfüllt und die Alternative bestand diese Fehlerklasse in der Evaluation | Eine erlaubte Eskalation oder Aufgabenbudget |
| Ausführbarer Test schlägt fehl | Testausgabe und relevanten Originalkontext erhalten | Eine Korrektur auf Modellebene ist plausibel und sicher versuchbar | Tests scheitern weiter oder Umfang wächst |
| Quellenverweis unbelegt | Prüfen, ob die Quelle die Antwort enthält | Andere Interpretation nur bei vorhandenen Belegen | Fehlende Belege: anfordern oder prüfen lassen |
| Werkzeug-Timeout | Wiederholungsrichtlinie des Werkzeugdienstes anwenden | Modellwechsel behebt keine Dienstverfügbarkeit | Timeout oder Frist erreicht |
| Berechtigung verweigert | Ablehnung respektieren | Nie mit anderem Modell eine Berechtigung umgehen | Unautorisierte Operation stoppen |
| Kontext passt nicht | Relevante Belege reduzieren/abrufen oder Ablauf ändern | Nur wenn die andere Route tatsächlich passende Kapazität hat | Keine Route passt sicher |
Ein erzeugtes Migrationsskript, das einen reproduzierbaren Test nicht besteht, kann beispielsweise Testfehler in einen Argon-Versuch mitnehmen. Eine Werkzeugantwort „permission denied“ sollte das nicht. Eine unleserliche PDF-Unterschrift wird nicht zum zuverlässigen Beleg, nur weil das zweite Modell denselben Namen errät.
Vermeiden Sie doppelte Schreibvorgänge bei Eskalationen. Hat der erste Versuch möglicherweise bereits etwas ausgeführt, gleichen Sie den Status ab, bevor Sie erneut handeln. Behalten Sie Idempotenzkennungen bei; die Ausführungsschicht bleibt für Seiteneffekte verantwortlich. Modellwahl hebt die Transaktionsgrenze der Anwendung nicht auf.
Zustand erhalten, ohne Modellportabilität vorauszusetzen
previous_interaction_id, native Fortsetzungstokens oder Zustandsobjekte an einem anderen Gateway-Endpunkt akzeptiert werden.Bei anwendungsseitiger Eskalation entsteht die nächste Anfrage aus freigegebenen Originalbelegen und einer ausdrücklichen Fehlerbeschreibung. Unbelegte Schlussfolgerungen des ersten Modells sind keine Referenzwahrheit. Ist Zustandsübertragung nicht dokumentiert, starten Sie eine unterstützte frische Anfrage und kalkulieren die erneut gesendete Eingabe. Verborgene Eingabekosten würden den Vergleich verzerren.
Benennen und versionieren Sie Konfigurationen. Ein Rollback-Ziel umfasst Modell, unterstützte Thinking-Stufe, Promptversion, Schema und Werkzeugrichtlinie. So wechseln Sie nicht zum alten Modell zurück, während eine vom Fallback nicht akzeptierte Einstellung bestehen bleibt.
Die Strategie vor der Standardfreigabe einführen
Evaluieren Sie beide direkten Routen vor der Kaskade. Sonst wissen Sie nicht, ob die Zusatzschicht überhaupt nützt. Fixieren Sie einen gelabelten Satz gewöhnlicher, schwieriger und bekannter Fehlerfälle. Testen Sie direktes Hydrogen, direktes Argon und die geplante Eskalationsroute. Alle Versuche bleiben unter der ursprünglichen Aufgaben-ID.
Untersuchen Sie Abweichungen zwischen Modell und Validator. Prüfen Sie kritische Fehler selbst dann, wenn die Durchschnittskosten sinken. Die Abnahme muss ausreichend unabhängig sein, um überzeugende falsche Antworten zu finden; ein Verifier, der nur die Erklärung des ersten Modells wiederholt, ist keine starke Prüfschranke.
Führen Sie anschließend eine genehmigte Schattenstrategie ohne Seiteneffekte aus. Prüfen Sie reale Eingabeverteilung, Zustandsbehandlung, tatsächliche Eskalationshäufigkeit und vollständige Nutzung. Danach folgt ein begrenzter Canary mit schriftlichen Grenzen für kritische Fehler, akzeptierte Aufgabenkosten, Abschlusszeit und Werkzeugaktionen. Halten Sie eine sofort wählbare direkte Modellroute und einen zuständigen Operator bereit, der die Strategie deaktivieren kann.
Zwingen Sie nicht jede Anfrage in die Kaskade. Bekannte schwierige Klassen können auf einer direkten Route günstiger und schneller sein. Einfache Aufgaben, die schon bestehen, brauchen womöglich kein zweites Modell. Ohne verlässliche Abnahmeprüfung sind menschliche Kontrolle oder ein ausdrücklich unvollständiges Ergebnis unter Umständen sicherer als ein weiterer automatischer Versuch.
FAQ
Sollte wegen niedrigerer Tokenpreise jede Aufgabe mit Hydrogen beginnen?
Nein. Prüfen Sie vollständige Ablaufkosten und Ergebnisse. Eine Aufgabe, die fast immer eskaliert, ist möglicherweise direkt auf ihrer bewährten Route besser aufgehoben.
Ist Hydrogen eine destillierte Version von Argon?
Dieser Artikel hat dafür keinen Primärbeleg. Verwenden Sie dokumentierte Modellidentität und unterstütztes Verhalten, statt das Trainingsdesign aus der Positionierung abzuleiten.
Liefert Argon immer die bessere Antwort?
Ein solches universelles Ergebnis ist hier nicht belegt. Vergleichen Sie beide mit einer aufgabenspezifischen Referenz einschließlich schwieriger Fälle und kritischer Fehler.
Spricht lange Ausgabe für Argon statt Hydrogen?
Beide Anbietermodelle dokumentieren Long Decode. Prüfen Sie gemeinsamen Kontext, Schrittgrenzen und Fortsetzung des gewählten Protokolls. Eine geteilte Funktion ist kein exklusiver Argon-Vorteil.
Wann sollte ich an Argon eskalieren?
Wenn ein erkennbarer, behebbarer Modellfehler bleibt, Ihre Evaluation den Nutzen der Alternative für diese Fehlerklasse zeigt und Zeit und Budget reichen. Fehlende Berechtigung oder Belege verlangen eine andere Reaktion.
Kann das zweite Modell das erste automatisch prüfen?
Es kann Teil einer vorgeschlagenen Prüfung sein, aber Übereinstimmung beweist keine Richtigkeit. Evaluieren Sie den Verifier und verwenden Sie bei Bedarf ausführbare Tests, Quellenbelege oder menschliche Prüfung.
Lassen sich Gesprächs-, Cache- und Fortsetzungszustand zwischen Modellen wiederverwenden?
Nur wo das gewählte Protokoll es dokumentiert. Erhalten Sie die Historie korrekt, verschieben Sie modellspezifische Tokens nicht blind und kalkulieren Sie wiederholte Eingabe bei einer frischen Anfrage.
Wann muss der Ablauf Wiederholungen beenden?
An der festgelegten Versuchs-, Zeit- oder Kostengrenze oder wenn ein weiterer Modellaufruf den Fehler nicht beheben kann. Geben Sie einen klaren Prüf-/Unvollständig-Status zurück statt einer endlosen Wechselschleife.
Quellen und Aussagegrenzen
- Googles Hydrogen-Spezifikationen.
- Googles Argon-Spezifikationen.
- Googles modellübergreifende Hydrogen-Migrationshinweise.
- Google Gemini API-Preise.
- Native EvoLink-Gemini-API-Referenz.
Geprüft am 12. November 2026. Anbieterspezifikationen gelten für ihren jeweiligen Zugangsweg. Aufgabenrollen, Routing-Regeln und das 1.000-Aufgaben-Beispiel sind vorgeschlagene Entwürfe, kein veröffentlichter Modellbenchmark und keine Beschreibung automatischen EvoLink-Routings.