Gemini 4 Hydrogen vs Gemini 3.8 Flash: Lohnt sich der Umstieg?
Eine konkrete Upgrade-Entscheidung zu Hydrogen: gemeinsamer Kontext, Thinking-Standards, Caching, faire Aufgabentests, Gesamtkosten und Rollback.
 EvoLink TeamProduktteam
In diesem Artikel
Dieser Artikel enthält keinen kontrollierten EvoLink-Workload-Benchmark. Er verbindet dokumentierte Unterschiede mit einem reproduzierbaren Evaluations- und Einführungsverfahren. Damit sollen Sie vor der Änderung von Produktionsverkehr entscheiden können, statt aus Community-Demos einen allgemeinen Sieger abzuleiten.
Entscheiden Sie, welches Upgrade Sie überhaupt brauchen
Eine stabile Klassifizierung und ein Coding-Agent können beim selben Modell zu unterschiedlichen Ergebnissen kommen. Beim Klassifikator bleibt womöglich wenig Qualitätsspielraum; beim Agenten kann eine hohe Fehlerquote im ersten Versuch eine teurere Antwort rechtfertigen. Behandeln Sie das als getrennte Routing-Entscheidungen.
| Ausgangssituation | Erste Entscheidung | Erforderlicher Beleg für einen Wechsel |
|---|---|---|
| 3.8 erfüllt Qualitäts-, Kosten- und Antwortzeitziele | Als Kontrollroute behalten | Eine konkrete, geschäftlich relevante Verbesserung |
| Wiederkehrende Fehler bei Dokumenten oder Code | Hydrogen auf diesen Fehlerklassen testen | Korrekte akzeptierte Ergebnisse, nicht eine überzeugendere Erklärung |
| Aufgaben brauchen mehr Ausgabe als die derzeitige Antwortgrenze | Architektur für lange Ausgaben prüfen | Unterstützte Fortsetzung, Gesamtbudgets und Unterbrechungsbehandlung |
| Der Client hängt von expliziten Prompt-Caches ab | Vor dem Test Kompatibilität prüfen | Funktionierende implizite Cache-Strategie und korrekter Nutzungsabgleich |
| Der Verkehr mischt einfache und schwierige Aufgaben | Je Klasse evaluieren | Klassenbezogene Fehler-, Latenz- und Gesamtkostenvergleiche |
Gemini 4 Hydrogen vs Gemini 3.8 Flash: Unterschiede bei der Migration
| Bereich | Ausgangsbasis 3.8 Flash | Änderung bei Hydrogen | Migrationsprüfung |
|---|---|---|---|
| Kontext | Getrennte Grenzen von 1M Eingabe und 64K Ausgabe | Ein gemeinsames Fenster von 1.048.576 Tokens für Eingabe, Thinking und Ausgabe | Antwortplatz lassen, statt die Eingabegrenze voll auszunutzen |
| Thinking | low, medium, high; laut Googles Migrationsvergleich Standard medium | xhigh kommt hinzu; beim Anbieter wird high Standard | Einen von der Route unterstützten Wert ausdrücklich setzen |
| Lange Ausgabe | Dokumentierte Ausgabegrenze von 65.536 | Long Decode kann einen synchronen Schritt von 65.536 Tokens überschreiten | Fortsetzungszustand speichern und Gesamtnutzung abgleichen |
| Caching | Ältere Clients können explizite Caches anlegen und referenzieren | Explizite Cache-Erstellung wird nicht unterstützt | Abhängigkeiten entfernen und implizite Treffer messen |
| Sampling | Bestehender Code sendet möglicherweise Sampling-Felder | Laut Google werden eigene temperature-, top_p- und top_k-Werte ignoriert | Nicht mehr voraussetzen, dass diese Hydrogens Verhalten steuern |
| Werkzeugdeklarationen | Ältere Prompt-Wrapper verlangen womöglich „Werkzeugaufrufe“ als JSON in reinem Text | Google warnt, dass dies ohne deklarierte native Werkzeuge MALFORMED_FUNCTION_CALL auslösen kann | Funktionswerkzeuge oder ein Schema für strukturierte Ausgaben deklarieren; dem Anfragevertrag des gewählten Gateways folgen |
| Werkzeughistorie | Clientseitiger Zustand braucht protokollspezifische Behandlung | Modellbeiträge und Thinking-Signaturen unverändert erhalten | Mehrere Gesprächsrunden statt nur der ersten Anfrage prüfen |
Am leichtesten wird der gemeinsame Kontext übersehen: Eine Anfrage, die zuvor fast die separate Eingabegrenze nutzte, kann Hydrogen zu wenig Platz im gemeinsamen Fenster lassen. Unabhängig davon begrenzt das gewählte Ausgabelimit Thinking- und Antwort-Tokens zusammen. Ein niedrigeres Limit schafft keine zusätzliche Kapazität für die sichtbare Antwort, wenn Thinking das Budget verbraucht. Prüfen Sie sowohl den verbleibenden Platz im gemeinsamen Fenster als auch das konfigurierte Limit, den Abbruchgrund und die Nutzung, bevor Sie eine kürzere Antwort als geringere Intelligenz deuten.
Auch Caching braucht einen eigenen Kompatibilitätstest. Ein wiederholtes Präfix ermöglicht einen impliziten Treffer; er garantiert weder einen aufgewärmten oder gültigen Cache noch dessen Übertragbarkeit zwischen Modellen. Testen Sie wiederholte und wechselnde Präfixe und verwenden Sie beobachtete Cache-Lesezahlen. Ein Migrationsbudget darf nicht von hypothetischen Treffern abhängen.
Ganze Aufgaben statt ausgewählter Demos vergleichen
Ein brauchbarer Test umfasst tatsächlich vorkommende Aufgaben, schriftliche Abnahmeregeln und eine feste Umgebung. Die drei folgenden Beispiele sind Evaluationsentwürfe, keine gemeldeten Modellergebnisse.
Code: ein Patch, der Ausführung und Prüfung besteht
Wählen Sie einen Fehler mit Regressionstest, etwa einen Filter, der beim Wechsel zwischen paginierten Ergebnissen erhalten bleiben muss. Fixieren Sie Repository-Revision, Abhängigkeiten, erlaubte Dateien und Aufgabenanweisung. Beide Modelle erhalten dieselben relevanten Belege, Testzugänge und Berechtigungsgrenzen.
Zum Bestehen braucht es das geforderte Verhalten ohne unzulässige Regression oder sachfremde Änderungen. Erfassen Sie Testergebnisse, Korrekturen durch Reviewer und die Zahl der Runden bis zu einem brauchbaren Patch. Eine schnell ausgegebene elegante Lösung schlägt keinen langsameren akzeptierten Patch, wenn sie fehlschlägt. Vergleichen Sie die Abschlusszeit einschließlich Tests und Korrektur; die Zeit bis zum ersten Token bleibt ein getrenntes Reaktionsmaß.
Nehmen Sie mindestens einen Fall mit unvollständigen Belegen auf. Ein Modell, das nach dem fehlenden Vertrag fragt, sollte nicht dafür bestraft werden, dass es ihn nicht erfindet. Legen Sie diese Bewertungsregel vor dem Lesen der Ausgaben fest.
Extraktion: richtige Felder mit Belegen
Verwenden Sie ein Produktblatt oder einen Dienstleistungsvertrag mit festem Schema und gelabelter Referenz. Nehmen Sie Einheitenumrechnung, fehlende Felder und einen Widerspruch zwischen zwei Dokumentständen auf. Beide Modelle sehen dieselbe Quelle und dieselben Anweisungen für fehlende Werte.
Bewerten Sie Feldgenauigkeit und die Abnahme ganzer Datensätze getrennt. Ein einziger falscher kritischer Betrag kann einen sonst richtigen Datensatz unbrauchbar machen. Schemaprüfung ist notwendig, bestätigt aber keine sachliche Richtigkeit. Markieren Sie prüfpflichtige Ausgaben ausdrücklich, damit sicheres Enthalten nicht mit einem automatisch erledigten Datensatz verwechselt wird.
Agenten: Werkzeuge auch bei Fehlern korrekt abschließen
Erstellen Sie deterministische Werkzeug-Testfälle für eine Abfrage, einen Timeout und eine verweigerte Berechtigung. Erfassen Sie gültige Argumente, abgeschlossene Operationen und wahrheitsgemäße Schlussantworten. Die Absicht, ein Werkzeug aufzurufen, ist keine Erledigung; ein erfundenes Ergebnis nach einem Timeout muss durchfallen.
Evaluationswerkzeuge bleiben lesend oder simuliert. Lösen Sie im Schattentest keine zweite Zahlung, Erstattung oder Kundenbenachrichtigung aus, nur weil beide Modelle sie vorschlagen. Idempotenz, Autorisierung und Ausführungsverantwortung muss die Anwendung unabhängig von der Modellwahl durchsetzen.
Einstellungen vergleichbar machen, ohne Unterschiede zu verbergen
Führen Sie zwei ergänzende Vergleiche aus. Bewerten Sie zuerst je Modell die tatsächlich vorgesehene Produktionskonfiguration. Das beantwortet die Betriebsfrage. Falls unterstützt, gleichen Sie anschließend Thinking-Stufe und Aufgabengrenzen stärker an, um die Ursache geänderten Verhaltens zu untersuchen. Dokumentieren Sie beide Konfigurationen; ein gleich benanntes Feld macht sie nicht automatisch identisch.
Hydrogen mit low und 3.8 mit high zu vergleichen kann für eine Produktrichtlinie sinnvoll sein. Es ist aber keine kontrollierte Geschwindigkeitsaussage bei gleicher Reasoning-Einstellung. Standards sind besonders riskant, weil Googles dokumentierter Wechsel von medium zu high das Experiment unbemerkt verändert.
Fixieren Sie den Testsatz vor dem Blick auf die Ergebnisse. Trennen Sie einfache, typische und fehleranfällige Fälle. Gewichten Sie Aufgaben anhand ihrer Produktionshäufigkeit oder deklarieren Sie einen ungewichteten Diagnosesatz. Sonst können viele leichte Beispiele Regressionen in einem seltenen, teuren Ablauf verdecken.
| Evaluationsdatensatz | Aufzubewahrende Angaben | Bedeutung |
|---|---|---|
| Aufgabe und Referenz | Aufgaben-ID, Eingabeversion, erwartetes Ergebnis, Regeln für kritische Fehler | Hält Labels und Umfang stabil |
| Anfragevertrag | angefragtes Modell, soweit verfügbar zurückgegebene Identität, Kanal, Thinking, Budget, Werkzeuge | Zeigt Standards und Routing-Unterschiede |
| Ergebnis | Abnahme im ersten Versuch, finale Abnahme, Fehlerklasse, Prüfstatus | Verhindert, dass Stil die Richtigkeit ersetzt |
| Zeit | erstes Token, Generierungsende, Zeitpunkt des akzeptierten Ergebnisses | Trennt Reaktionszeit und Aufgabenerledigung |
| Nutzung | ungecachte Eingabe, Cache-Lesezugriffe, sichtbare Ausgabe, Thinking, Suche und Wiederholungen | Ermöglicht vollständigen Rechnungsabgleich |
| Rollout-Kontext | Anwendungsversion, Werkzeug-Testdaten, Parallelität und Timeout | Macht Änderungen reproduzierbar |
Wiederholen Sie variable Aufgaben bei Bedarf und berichten Sie die Streuung. Eine kleine Stichprobe findet offensichtliche Regressionen, belegt aber weder stabile Latenzen am oberen Verteilungsrand noch seltene Fehlerquoten. Bestimmen Sie Stichprobengröße und Produktionsfenster anhand des zu erkennenden Fehlers. Fehlende Messwerte bleiben fehlend und werden nicht zu null.
Den Kostenschwellenwert für akzeptierte Arbeit berechnen
Als datierte Anbieterreferenz nennen die am 12. November geprüften Google-Standardtarife für Hydrogen $1.50 Eingabe und $7.50 Ausgabe pro Million Tokens. Bei 3.8 Flash sind es bis zum 31. Dezember 2026 $0.75 und $3.75. Diese beiden aktuellen Tokenpreise sind damit doppelt so hoch; das beweist keine doppelt so hohen Aufgabenkosten. Ab dem 1. Januar 2027 listet Google für 3.8 die Tarife $1.50 und $7.50. Prüfen Sie Geltungszeitraum, Caching und Werkzeugbedingungen erneut; dies sind Referenztarife des direkten Anbieters, keine Preisangebote für ein EvoLink-Konto.
Verwenden Sie eine einheitliche Definition:
API-Kosten pro akzeptierter Aufgabe = gesamte API- und Werkzeugausgaben des Stapels / akzeptierte AufgabenDer Zähler enthält erfolglose Versuche, Wiederholungen und Fallback-Aufrufe. Zählen Sie jede ursprüngliche Aufgaben-ID im Nenner höchstens einmal. Trennen Sie erledigte Aufgaben von sicheren, aber noch nicht abgeschlossenen Rückfragen oder Prüffällen, sofern der vorab festgelegte Aufgabenvertrag diese Behandlung nicht selbst als abgeschlossenes Ergebnis definiert. Ist der Nenner null, ist das Ergebnis nicht definiert und kein Schnäppchen. Berichten Sie auch den Anteil tatsächlich akzeptierter Aufgaben: Eine Richtlinie, die schwere Anfragen ablehnt, kann Kosten senken, ohne gleichwertige Arbeit zu liefern. Wenn menschliche Korrektur relevant ist, weisen Sie zusätzliche kombinierte Kosten aus: Verwenden Sie denselben Arbeitspreis, etwa Dollar pro Prüfminute, aber die je Route tatsächlich beobachtete Prüfhäufigkeit und Prüfdauer.
| Szenario für 1.000 eingehende Aufgaben | Gesamte API-/Werkzeugausgaben | Akzeptierte Aufgaben | Kosten pro akzeptierter Aufgabe |
|---|---|---|---|
| Funktionierende Vergleichsbasis | $8 | 800 | $0.0100 |
| Kandidat A | $12 | 960 | $0.0125 |
| Kandidat B | $9 | 960 | $0.009375 |
Kandidat A erledigt mehr Aufgaben erfolgreich, ist aber pro akzeptierter Aufgabe nicht günstiger. Die zusätzliche Abdeckung kann den Einsatz trotzdem rechtfertigen; das ist eine Geschäftsentscheidung, keine Einsparungsbehauptung. Kandidat B verbessert unter den Annahmen beide Kennzahlen. Keine Zeile sagt reales Modellverhalten voraus.
c_H / a_H < c_F / a_F. Dabei steht c für mittlere API-/Werkzeugausgaben pro eingehender Aufgabe und a für den unter derselben Bewertungsregel akzeptierten Anteil. Verwenden Sie echte Kosten des gesamten Ablaufs. Eine einzelne Antwort darf nicht für c stehen, wenn die Richtlinie mehrere Versuche vorsieht.Gleichen Sie auch Tokenkategorien ab. Enthält die gemeldete Promptnutzung Cache-Treffer, ziehen Sie diese vor der Eingabe ungecachter Tokens in den Rechner ab. Wenn Reasoning bereits in completion_tokens enthalten ist, addieren Sie es nicht erneut. Native und kompatible Nutzungsfelder brauchen getrennte Zuordnungen zu denselben Abrechnungskategorien.
Von Replay über Schattentest zum reversiblen Canary
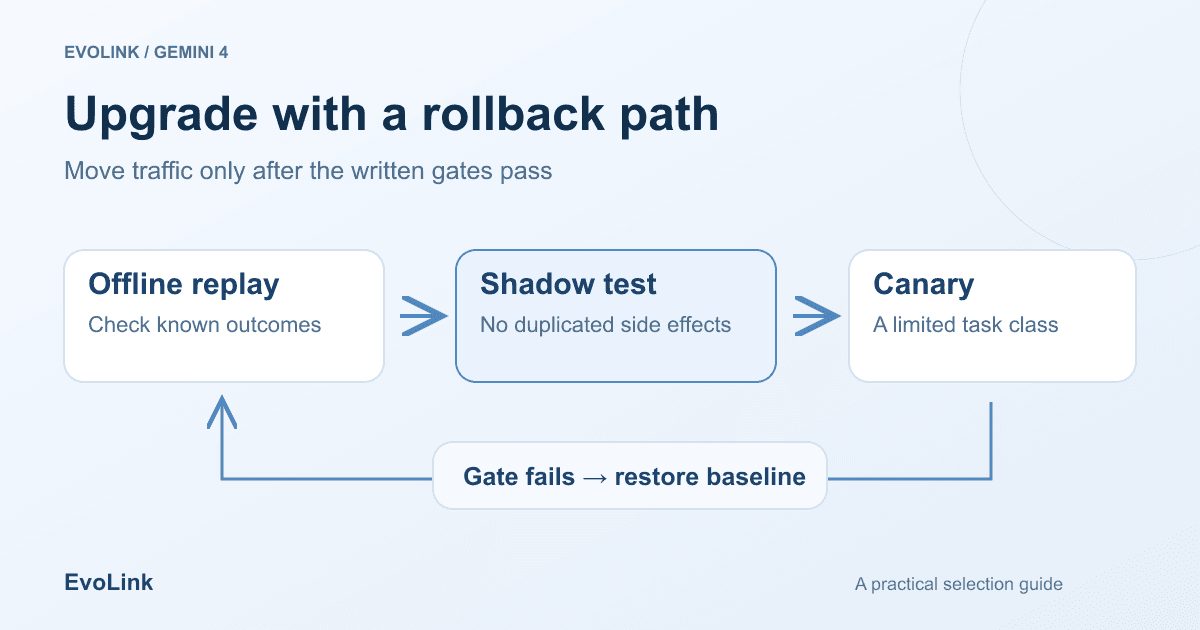
EvoLinks einheitliche API reduziert den Integrationsaufwand, mehrere Modelle verfügbar zu halten. Evaluation, Verkehrsverteilung und Ausweichregeln bleiben Aufgabe der Anwendung. Dieser Leitfaden beschreibt weder automatische Migration noch eine eingebaute Richtlinie, die stets das günstigste erfolgreiche Modell auswählt.
Wann ist es sinnvoll, bei 3.8 zu bleiben?
Behalten Sie 3.8, wenn es den Abnahmestandard erfüllt und der Kandidat ohne erheblichen Nutzen mehr Kosten oder Risiko verursacht. Das gilt besonders für stabile Aufgaben mit wenig verbleibendem Genauigkeitsspielraum, Latenzbudgets, die empfindlich auf Thinking-Änderungen reagieren, oder Clients, deren Cache- und Zustandsbehandlung noch angepasst werden muss.
FAQ
Ist Hydrogen besser als Gemini 3.8 Flash?
Google empfiehlt das Upgrade, doch dieser Artikel belegt keinen universellen Sieger. Prüfen Sie akzeptierte Ergebnisse, kritische Fehler, Abschlusszeit und vollständige Ablaufkosten an Ihrer Aufgabe.
Muss ich unmittelbar nach der Veröffentlichung migrieren?
Hier wird keine Migrationsfrist festgestellt. Behalten Sie die funktionierende Basis, während Sie den Kandidaten prüfen und Anbieter-Abkündigungen unabhängig kontrollieren.
Reicht eine andere Modell-ID?
Sie startet die Auswahl, löst aber weder gemeinsame Kontextplanung noch Thinking-Standards, explizite Cache-Abhängigkeiten, Werkzeugzustand oder lange Ausgaben. Prüfen Sie diese Punkte für das gewählte Protokoll.
Kann ich beide Modelle mit ihren Standard-Thinking-Stufen vergleichen?
Ja, wenn Sie geplante Einsatzrichtlinien vergleichen und den Unterschied ausweisen. Das ist kein Benchmark bei gleichen Einstellungen. Führen Sie zusätzlich einen kontrollierten Vergleich mit ausdrücklich gesetzten unterstützten Stufen durch.
Kann ich einen expliziten Cache von 3.8 weiterverwenden?
Verlassen Sie sich nicht darauf: Hydrogens Anbieterleitfaden entfernt explizites Caching. Prüfen Sie das implizite Verhalten des Gateways und gleichen Sie tatsächliche Cache-Nutzung ab.
Bedeutet ein schnellerer Stream eine schneller erledigte Aufgabe?
Nicht zwingend. Tests, Werkzeuge, Wiederholungen und Prüfung können die Wartezeit dominieren. Berichten Sie Zeit bis zum ersten Token und Zeit bis zum akzeptierten Ergebnis getrennt.
Wie vermeide ich doppelte Thinking-Kosten?
Ordnen Sie Nutzungsfelder den Abrechnungskategorien des Protokolls zu. Reasoning als Detail in completion_tokens ist bereits enthalten. Separat gemeldetes natives Thinking wird nur addiert, wenn es nicht in der sichtbaren Ausgabezählung steckt.
Was sollte ein Rollback auslösen?
Vorab festgelegte Verstöße gegen kritische Fehler-, Qualitäts-, Aufgabenkosten- oder Abschlusszeitgrenzen. Stellen Sie Modell und kompatible Konfiguration wieder her und untersuchen Sie den Fall anhand der Aufgabenprotokolle.
Quellen und Prüfhinweise
- Googles Hydrogen-Migrationshinweise: Anbieterstandards sowie Cache- und Kontextänderungen.
- Googles Hydrogen-Spezifikationen: Grenzen und unterstützte Fähigkeiten des neuen Modells.
- Googles 3.8-Flash-Spezifikationen: bisherige Vergleichsbasis.
- Google Gemini API-Preise: zugangswegspezifische kommerzielle Referenz.
- Native EvoLink-Gemini-API-Referenz: Anfragevertrag des Gateways.
Geprüft am 12. November 2026. Aufgabenentwürfe, Schwellen und Dollar-Beispiel sind analytische Hilfen, keine kontrollierten Modellergebnisse. Verwenden Sie beim Rollout die aktuellen EvoLink-Kontotarife und die von der gewählten Route unterstützten Einstellungen.