
Kimi K3.1 Pro vs K3: Für welche Aufgaben lohnt sich das Upgrade?

Was ändert sich gegenüber K3?
Moonshot beschreibt weiteres Post-Training mit mehr Rechenleistung. Langkontext und visuelles Verständnis bleiben erhalten. Entscheidend ist das veränderte Verhalten beim Erstellen Ihres Ergebnisses.
| Dimension | Kimi K3 | Kimi K3.1 Pro | Bedeutung |
|---|---|---|---|
| Position | Vorgänger als Baseline | Weiter post-trainiert | Bestehende K3-Ergebnisse sichern |
| Kontext | 1,048,576 Token | 1,048,576 Token | Kein größeres Kontextfenster als Upgrade-Grund |
| Aufgaben | Coding und lange Aufgaben | Laut Moonshot Coding-, 3D- und Recherchegewinne | Schwachstelle des eigenen Workloads testen |
| Bereitstellung | Bestehende K3-Route | Pro und Pro Highspeed | Variante ausdrücklich auswählen |
| Gateway-Preis | Aktuelle K3-Kontotarife | Aktuelle K3.1-Kontotarife | Dasselbe Konto statt fremder Preislisten vergleichen |
Was unabhängige Start-Evidenz belegt
Artificial Analysis veröffentlichte diesen Stand am 23. Oktober 2026, mit K3 bei max-Effort als Basis. Es handelt sich nicht um EvoLink-Messungen.
| Messung | K3 | K3.1 Pro | Einordnung |
|---|---|---|---|
| Intelligence Index | 44 | 55 | Elf Punkte in dieser Gesamtevaluierung |
| Ausgabe pro Index-Aufgabe | Etwa 48,000 Token | Etwa 55,000 Token | Mehr Generierung kann Preisvorteile aufzehren |
| Kosten pro Index-Aufgabe | Ungefähr wie Pro | Etwa $1.98 | Test-Snapshot, kein eigenes Budget |
Niedrigere Tokenpreise sind kein Aufgabenkosten-Ergebnis
Moonshots internationale Referenzpreise vom 24. Oktober 2026 betragen für normale Eingabe/Ausgabe je Million Token bei K3 $3/$15 und bei Pro $2/$10. Das sind direkte Listenpreise, keine EvoLink-Kontoangebote. Cache, Werkzeuge, Steuern und Wiederholungen gesondert berücksichtigen.
| Fall | Normale Eingabe | Abgerechnete Ausgabe | Referenzkosten |
|---|---|---|---|
| K3-Basis | 100,000 | 10,000 | $0.45 |
| Pro, gleiche Tokenzahl | 100,000 | 10,000 | $0.30 |
| Pro, mehr Generierung | 100,000 | 25,000 | $0.45 |
Nur bei konstanten Mengen spart die zweite Zeile. Die dritte erreicht die alte Rechnung schon ohne Werkzeuge oder Wiederholungen. Für den Betrieb zählt:
accepted_task_cost =
  (initial_call_costs + retry_costs + fallback_costs + tool_fees + review_cost)
/ accepted_deliverablesDas Upgrade dem Workload zuordnen
| Workload | Pro testen, wenn | Bestehende Route behalten, wenn |
|---|---|---|
| Repository-Reparatur | K3 stockt, Korrekturen braucht oder Tests verfehlt | Patchqualität und Budget bereits stimmen |
| Lange Dokumente | Quellenabgleich oder Vollständigkeit schwach sind | Extraktion und Retrieval der Engpass sind |
| Interaktive Anwendung | Bessere Ergebnisse wichtig sind und Pro schnell genug ist | Wartezeit untragbar bleibt; Highspeed gesondert messen |
| Batch und Wiederholungen | Kosten pro Abnahme im selben Sample fallen | Mehr Reasoning oder Prüfung die Ersparnis aufzehren |
Highspeed ist eine weitere Bereitstellungsentscheidung. Moonshots 2–3× Ausgabetempo verspricht keine entsprechend kürzeren Builds, Werkzeugschleifen oder Agent-Läufe. Erst Pro-Qualität und Kosten bestimmen, dann Highspeed vergleichen, wenn Generierung die Latenz dominiert.
Die Ersetzungsentscheidung nachvollziehbar dokumentieren
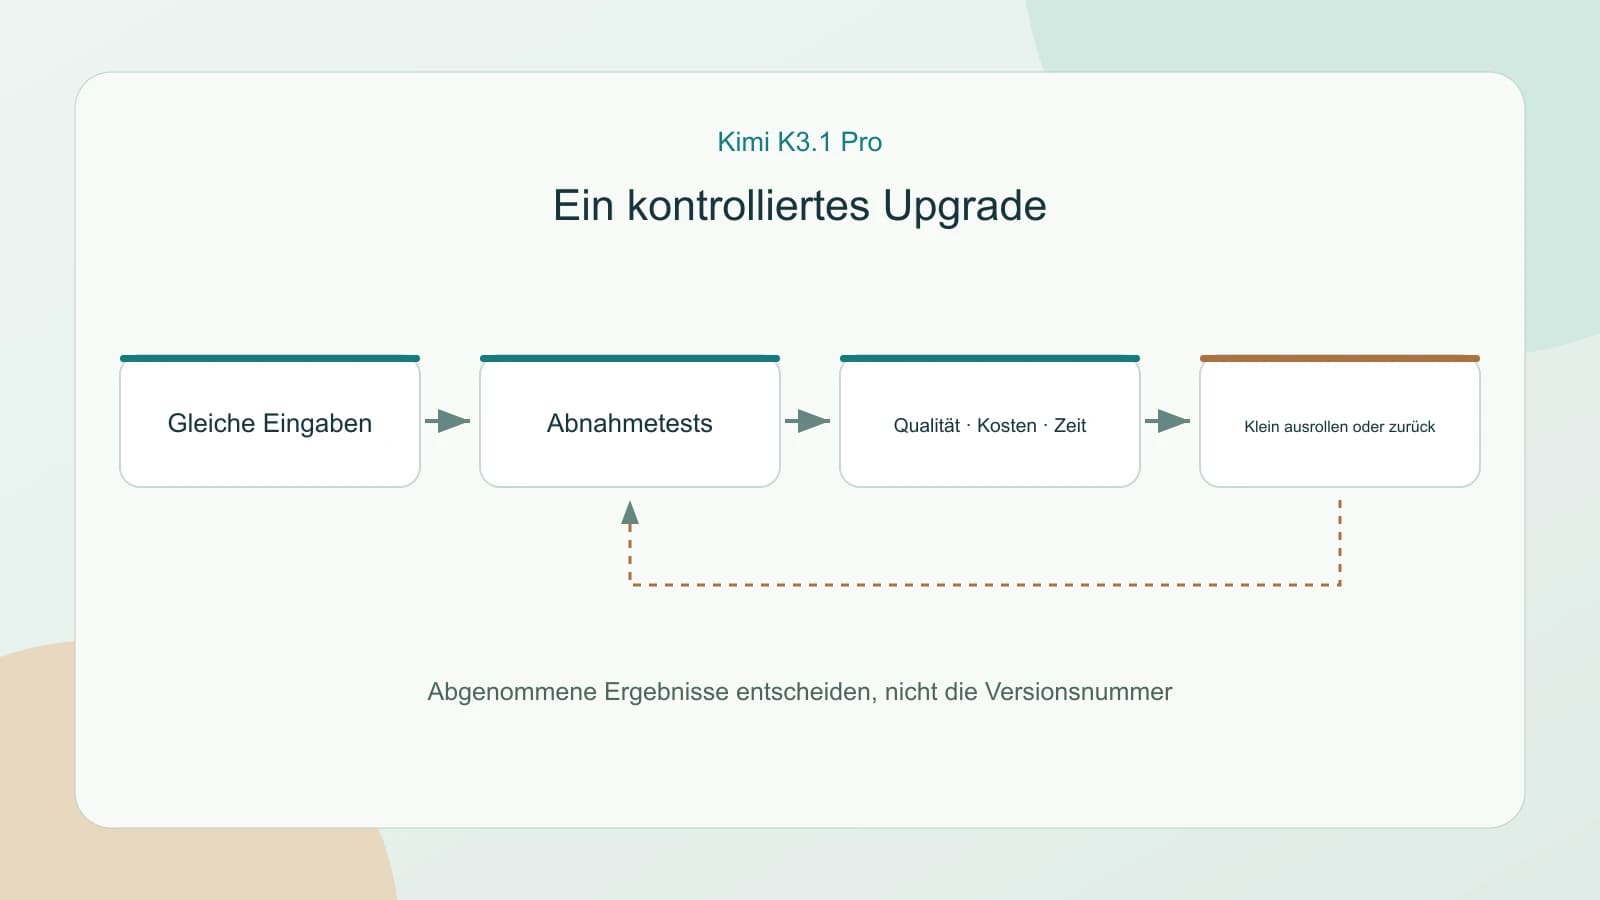
Commit oder Dokumentensatz, Prompt, Werkzeuge und Abnahmetests einfrieren. Modelle getrennt mit denselben Eingaben ausführen. Vollständigen Assistant-/Tool-Zustand innerhalb eines Laufs erhalten; nach Modell- oder Reasoning-Wechsel eine alte Unterhaltung nicht als kontrollierten Vergleich ausgeben.
| Protokoll | Inhalt |
|---|---|
| Konfiguration | Exaktes Modell, Effort, Ausgabebudget, Route |
| Usage | Normale Eingabe, Cache-Lesen, Schreiben je TTL, Ausgabe, Werkzeugaufrufe |
| Qualität | Tests, Zitiergenauigkeit, Artefakte und Restfehler |
| Betrieb | Erste Antwort, Gesamtdauer, Wiederholungen, Fehler |
| Kosten | Kontobelastung, Fallback und gemessener Prüfaufwand |
Cache-Kategorien nach zurückgegebener Usage trennen; Schreib-Token nicht nochmals als normale Eingabe zählen. Schlüssel, Protokoll und Bild-Upload-Vertrag an den Dienst binden. Ähnliche Request-Strukturen garantieren kein gleiches Verhalten.
Nur erfolgreiche Workloads ausrollen
Zuerst ohne Nutzerverkehr vergleichen. Qualitätsuntergrenze, Ausgabenlimit und Latenzziel vor Sichtung der Ergebnisse definieren. Bei Erfüllung einen kleinen Abschnitt migrieren und die alte Konfiguration für Rollback behalten. Erst nach Fehler- und Abrechnungsbeobachtung ausweiten, nicht wegen einer guten Einzelantwort.
Besteht ein Patch Tests, braucht aber mehr manuelle Reparatur, gehört das zu den Prüfkosten. Fehlen Dokumenttabellen schon nach der Extraktion, zuerst diese korrigieren. So verdeckt das Upgrade nicht den eigentlichen Engpass.
FAQ
Ist K3.1 Pro immer besser?
Nein. Die Start-Evidenz rechtfertigt Tests; Qualität, Kosten und Latenz des Workloads entscheiden.
Wird das Kontextfenster größer?
Nein. Beide Modelle bieten 1,048,576 Token; Eingabe, Reasoning und Ausgabe teilen das Budget.
Garantiert der niedrigere Preis eine kleinere Rechnung?
Nein. Ausgabeumfang, Cache, Werkzeuge, Wiederholungen und Prüfung verändern Kosten pro abgenommenem Ergebnis. Die Planungsrechnung benennt ihre Annahmen.
Sollte ich mit Highspeed beginnen?
Zunächst Pro als Basis messen, sofern Ihr Antwortzeitziel es zulässt. Highspeed mit gleicher Aufgabe und aktuellen Tarifen vergleichen.
Welchen Reasoning-Effort soll ich wählen?
Dokumentierte Einstellungen mit eigenen Abnahmetests vergleichen. Aus einer fremden Konfiguration keine low/high/max-Qualität ableiten.
Kann ich die alte Unterhaltung unverändert weiterverwenden?
Erforderlichen Tool-Zustand innerhalb eines Laufs erhalten; bei Änderungen am Modell oder an den Reasoning-Einstellungen einen getrennten Vergleich beginnen und Dienstregeln prüfen.
Wann sollte K3 bleiben?
Wenn die geprüfte Route Ziele erfüllt und die Alternative keine bessere Ergebnisqualität oder geringere Kosten pro abgenommenem Ergebnis nachweist.
Enthält der Vergleich einen EvoLink-Direktvergleich?
Nein. Er verbindet zugeschriebene Start-Evidenz, eine konstruierte Rechnung und ein Testverfahren. Leere Testprotokolle sind keine Messwerte.


