Gemini 4 Carbon vs Claude Fable 5.2: Coding, Reasoning und Kosten
Carbon oder Fable 5.2? Repository-Tests, CursorBench-Denkstufen, gesamte Aufgabenkosten und praktische Modellverteilung über EvoLink vergleichen.
 EvoLink TeamProduktteam
In diesem Artikel
Dafür sprechen zwei Gruppen von Ergebnissen: Carbon erreicht im aktuellen CursorBench einen ähnlichen Wert wie Fable max bei niedrigeren ausgewiesenen Kosten. Fable liegt dagegen in von Anthropic veröffentlichten Repository-Tests vorn. Die Vorteile hängen von Aufgabe und Denkstufe ab. Deshalb sollte jedes Modell einen klaren Einsatzbereich erhalten.
Carbon oder Fable zuerst nach der Aufgabe auswählen
| Ihre Aufgabe | Erste Wahl für den Test | Woran Sie den weiteren Einsatz festmachen |
|---|---|---|
| Komplexe Änderungen über mehrere Dateien bei kontrollierten Modellkosten | Carbon medium | Tests bestehen, Änderungen sind akzeptabel und die Gesamtaufgabe bleibt im Budget |
| Modulübergreifende Migrationen oder schwierige Fehler mit hohem manuellem Folgeaufwand | Fable 5.2 | Weniger verworfene Ansätze, Auslassungen und Zeit für die Fehlersuche |
| Geschäftsabläufe über mehrere Tools | Zuerst Carbon bewerten, dann mit dem bisherigen Modell vergleichen | Richtige Reihenfolge der Aktionen, Parameter und endgültiger Geschäftszustand |
| Zuverlässige Alltagsarbeit mit einzelnen schwierigen Fällen | Hauptmodell beibehalten und Eskalationspfad ergänzen | Die Eskalation löst ein tatsächliches Problem des bisherigen Ablaufs |
| Code eines anderen Modells prüfen | Ein anderes Modell unabhängig prüfen lassen | Reproduzierbare Funde, bestandene Regressionstests und beherrschbare Fehlalarme |
Die Tabelle legt eine Reihenfolge für erste Tests fest. Carbons niedrigere Basistarife eignen sich für eine Budgetreferenz. Fables Repository-Ergebnisse begründen einen frühen Test bei Codeaufgaben mit hohen Fehlerkosten. Wählen Sie das Prüfmodell passend zum vorhandenen Implementierungsmodell, damit Umsetzung und Kontrolle nicht vollständig auf demselben Urteil beruhen.
Ein Beispiel ist die Überarbeitung eines Zahlungsdienstes, bei der Idempotenz und das bisherige Wiederholungsverhalten erhalten bleiben müssen. Entscheidend ist, ob das Modell alte Schnittstellenbedingungen erkennt, eine überprüfbare Migration plant und Regressionstests ergänzt. Spart ein besserer Plan Stunden an Nacharbeit, verliert der Token-Preis relativ an Gewicht.
Was sagen Programmier-Benchmarks über diese Auswahl?
Fable liegt in einigen Repository-Tests vorn
Anthropics Veröffentlichung zu Fable 5.2 enthält diese gemeinsamen Prüfungen:
| Prüfaufgabe | Gemini 4 Carbon | Claude Fable 5.2 |
|---|---|---|
| FrontierSWE v2: Softwareentwicklung in Repositories | 61.2% | 69.9% |
| FrontierCode 2.0: Erreichen Codeänderungen den Maßstab für einen Merge? | 41.1%, medium | 49.1%, xhigh |
| AutomationBench: Geschäftsabläufe | 53.9% | 51.4% |
| OSWorld 2.1: Offline-Teilmenge von Desktop-Aufgaben, Teilpunkte | 81.5% | 89.3% |
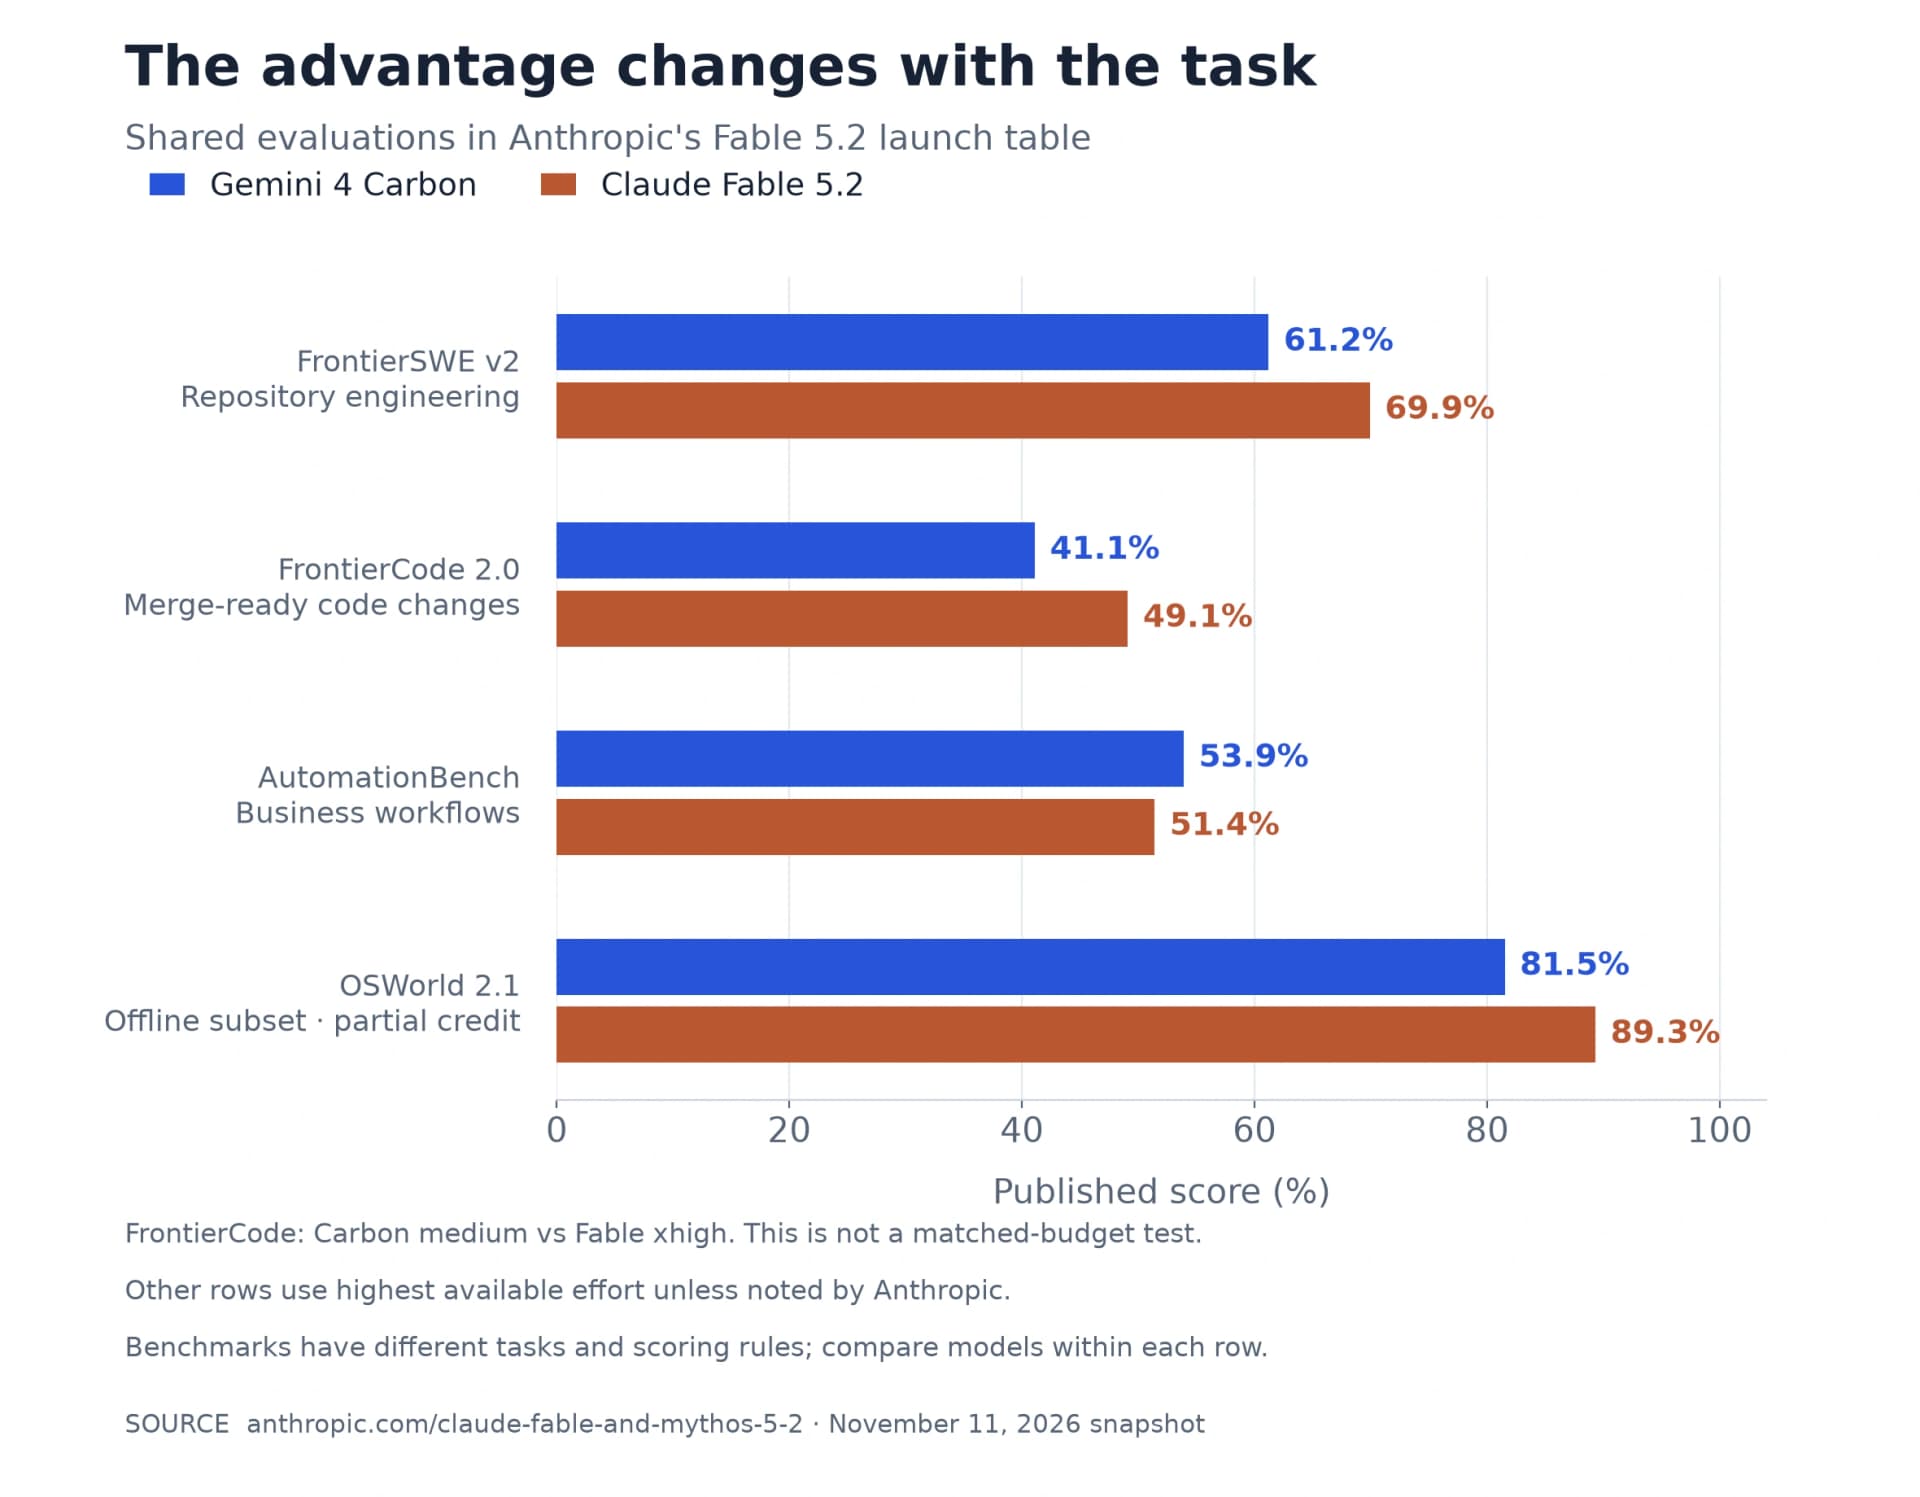
Das spricht für einen frühen Fable-Test bei schwierigen Repository-Änderungen und liefert einen Anlass, Carbon für Geschäftsabläufe zu prüfen. Desktop-Bedienung, Codeänderungen und Geschäftsautomatisierung haben unterschiedliche Erfolgskriterien. Ordnen Sie die Resultate Ihrer tatsächlichen Aufgabe zu.
Carbon bietet im CursorBench eine attraktive Konfiguration für hohe Anforderungen
CursorBench 4.0 verwendet mehrdeutige Aufgaben über mehrere Dateien aus realen Cursor-Sitzungen. Am 11. November wurden unter anderem folgende Konfigurationen angezeigt:
| Konfiguration | Ergebnis | Ausgewiesene Durchschnittskosten pro Aufgabe |
|---|---|---|
| Carbon high | 60.4% | $9.22 |
| Carbon medium | 60.1% | $8.49 |
| Carbon low | 58.6% | $11.89 |
| Fable 5.2 max | 60.0% | $32.79 |
| Fable 5.2 high | 56.9% | $9.70 |
| Fable 5.2 medium | 54.8% | $4.66 |
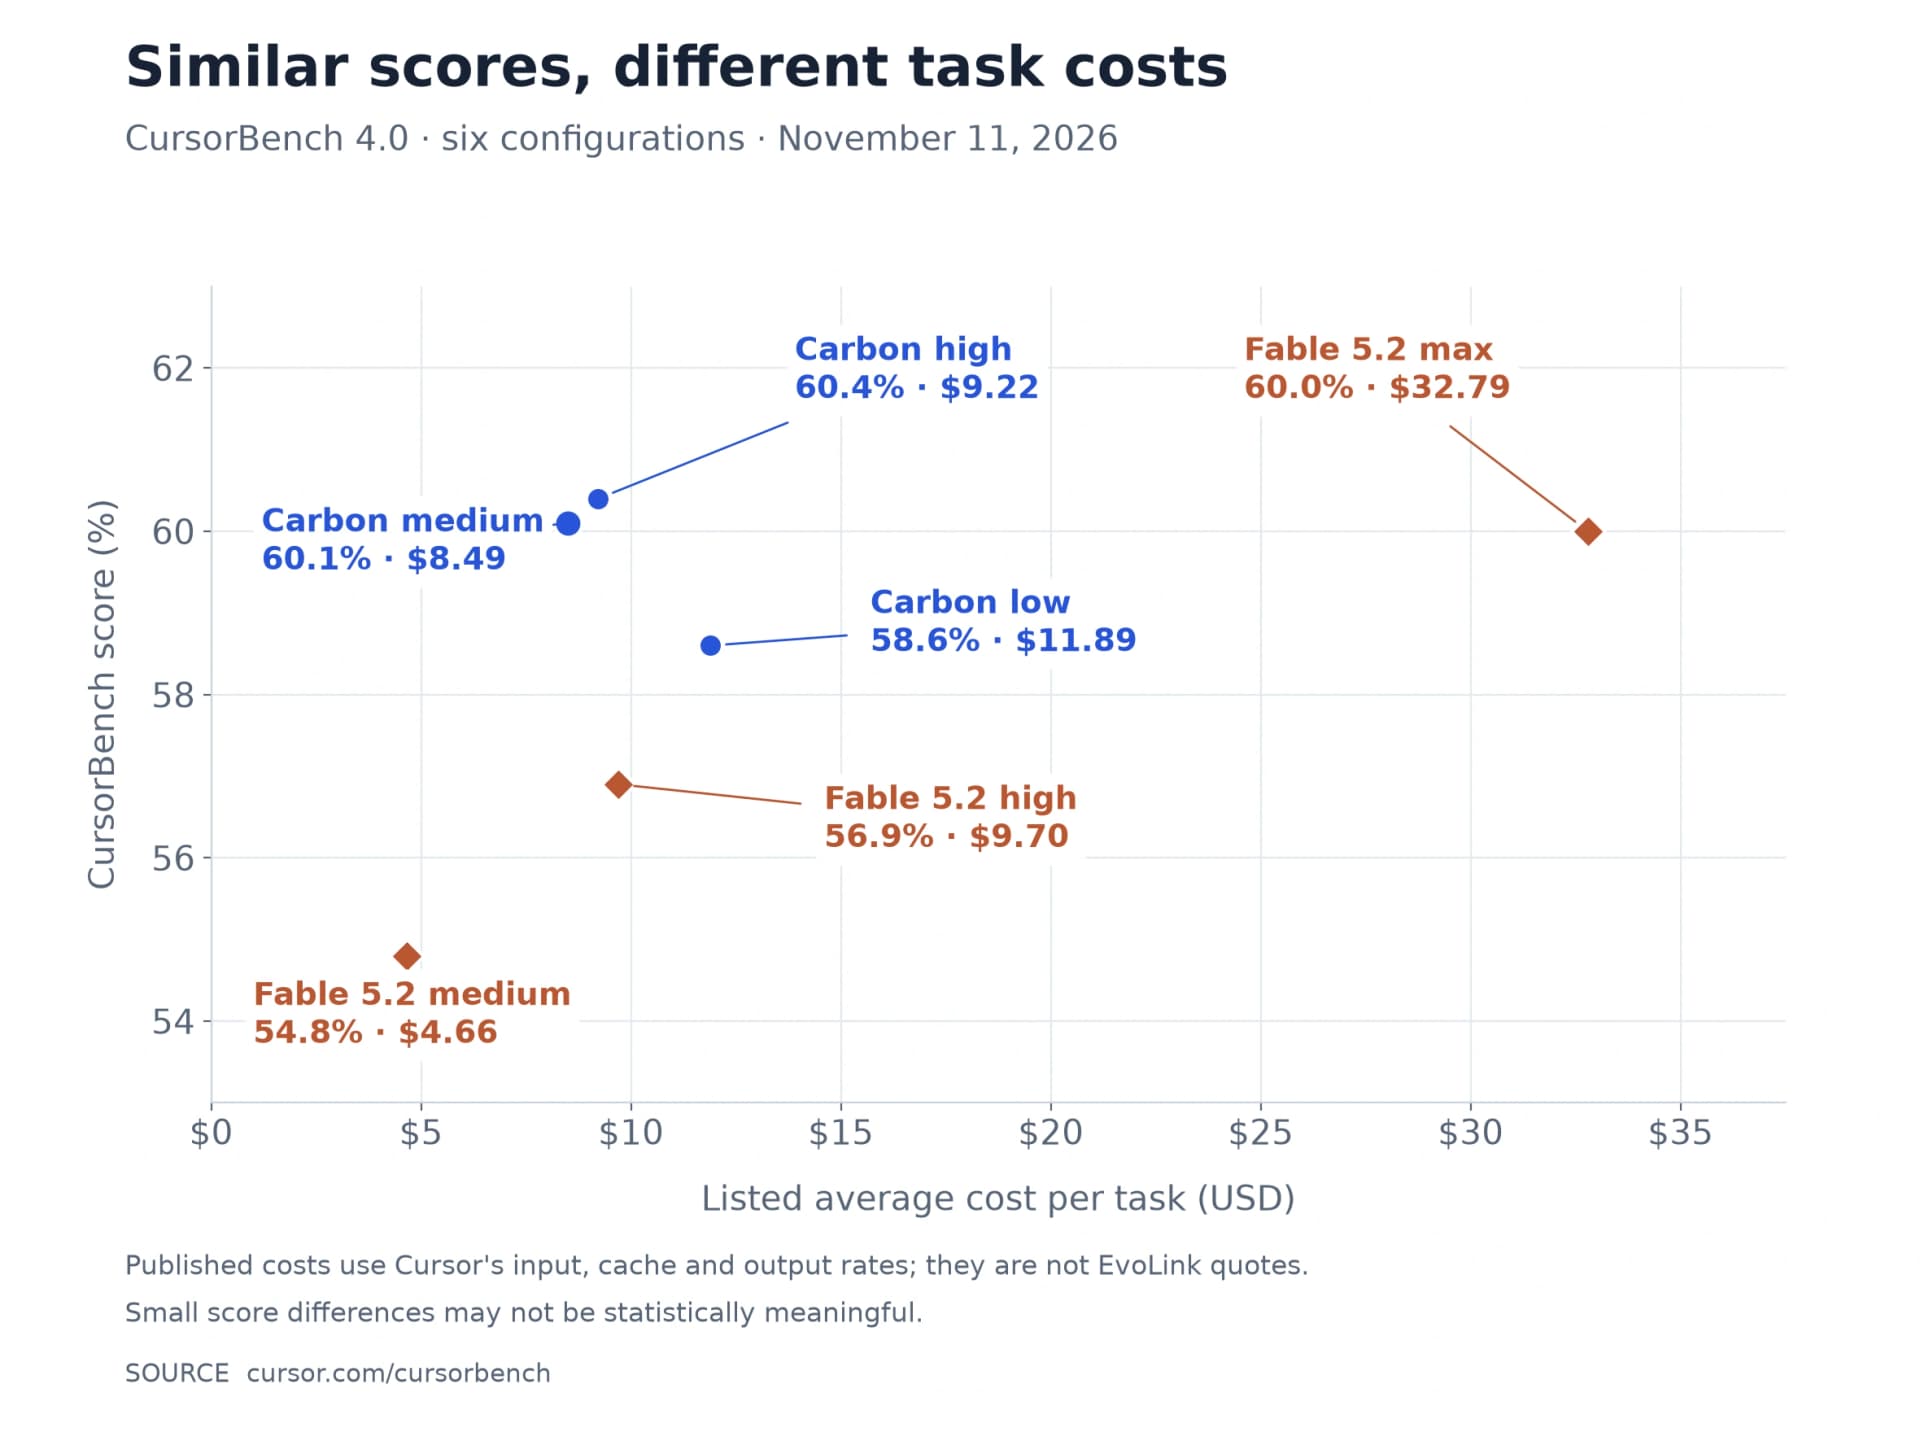
Carbon medium liegt nahe an Fable max und ist in der Liste deutlich günstiger. Damit eignet es sich als erster Kandidat für komplexe Programmierung. Fable medium kostet bei diesen Aufgaben weniger, erzielt aber auch ein niedrigeres Ergebnis. Reicht diese Qualität aus, kann die niedrigere Fable-Stufe ebenfalls passen.
Carbon low kostet im Durchschnitt sogar mehr als medium. Weniger Denken pro Runde kann bei einem mehrstufigen Agenten den gesamten Ausführungspfad und Verbrauch verändern. Vergleichen Sie deshalb Aufgabenerfüllung und Gesamtrechnung.
Wann lohnt sich Fables höherer Token-Preis?
Die folgenden Standard-Basistarife der Anbieter gelten in US-Dollar pro Million Tokens. Caching, Batch, Fast Mode und zusätzliche kostenpflichtige Tools sind nicht enthalten.
| Modell und Abrechnungszeitraum | Eingabe | Ausgabe |
|---|---|---|
| Carbon, bis einschließlich 30. November 2026 | $2 | $10 |
| Carbon, ab 1. Dezember 2026 | $4 | $20 |
| Fable 5.2 | $8 | $40 |
- Carbon zum Einführungspreis: $0.30.
- Carbon zum regulären Preis: $0.60.
- Fable 5.2: $1.20.
Bei realen Aufgaben können Tokenisierung, Denkverbrauch, Tool-Aufrufe und Wiederholungswege abweichen. Fable lohnt sich, wenn es in einer Aufgabenklasse Fehlschläge, manuelle Neufassungen oder Suchzeit reduziert. Carbon lohnt sich, wenn es dieselben Abnahmekriterien bei niedrigeren Gesamtkosten erfüllt.
Kreative Programmierung anhand öffentlicher Projekte vergleichen
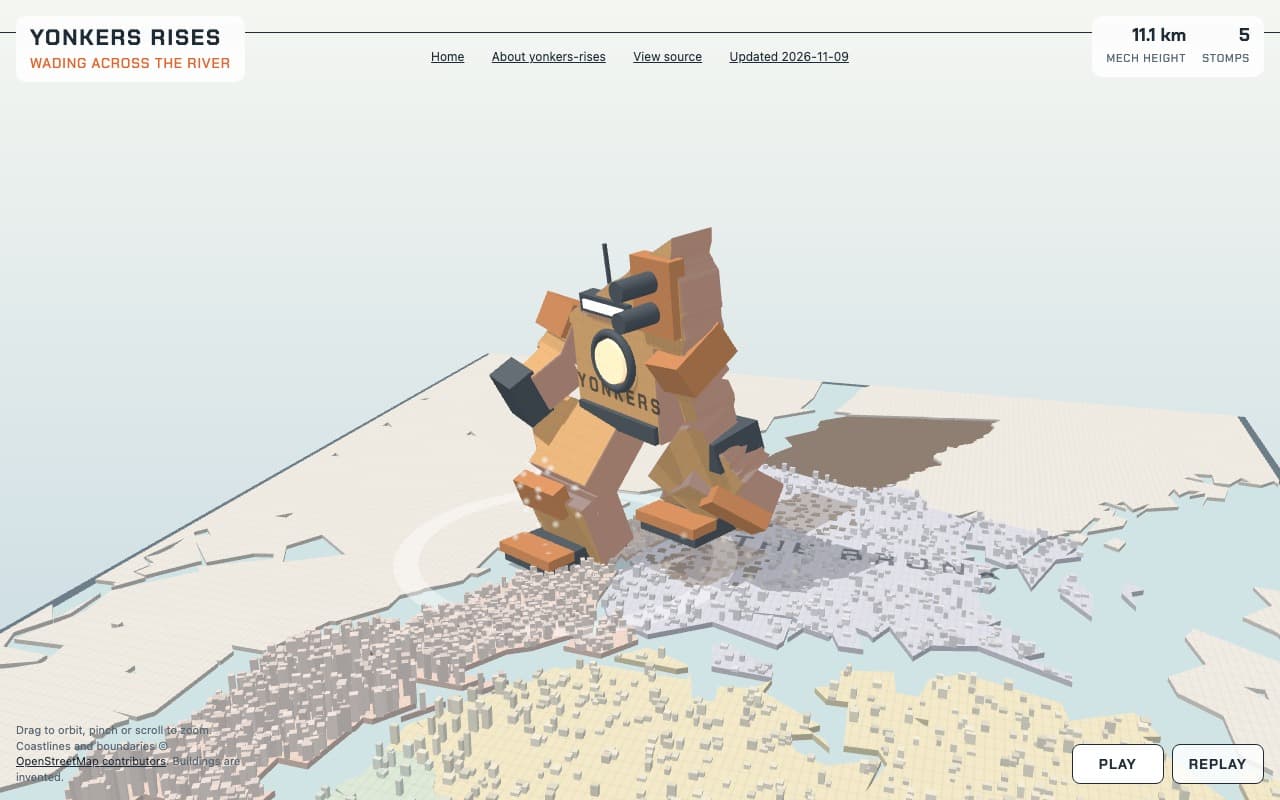
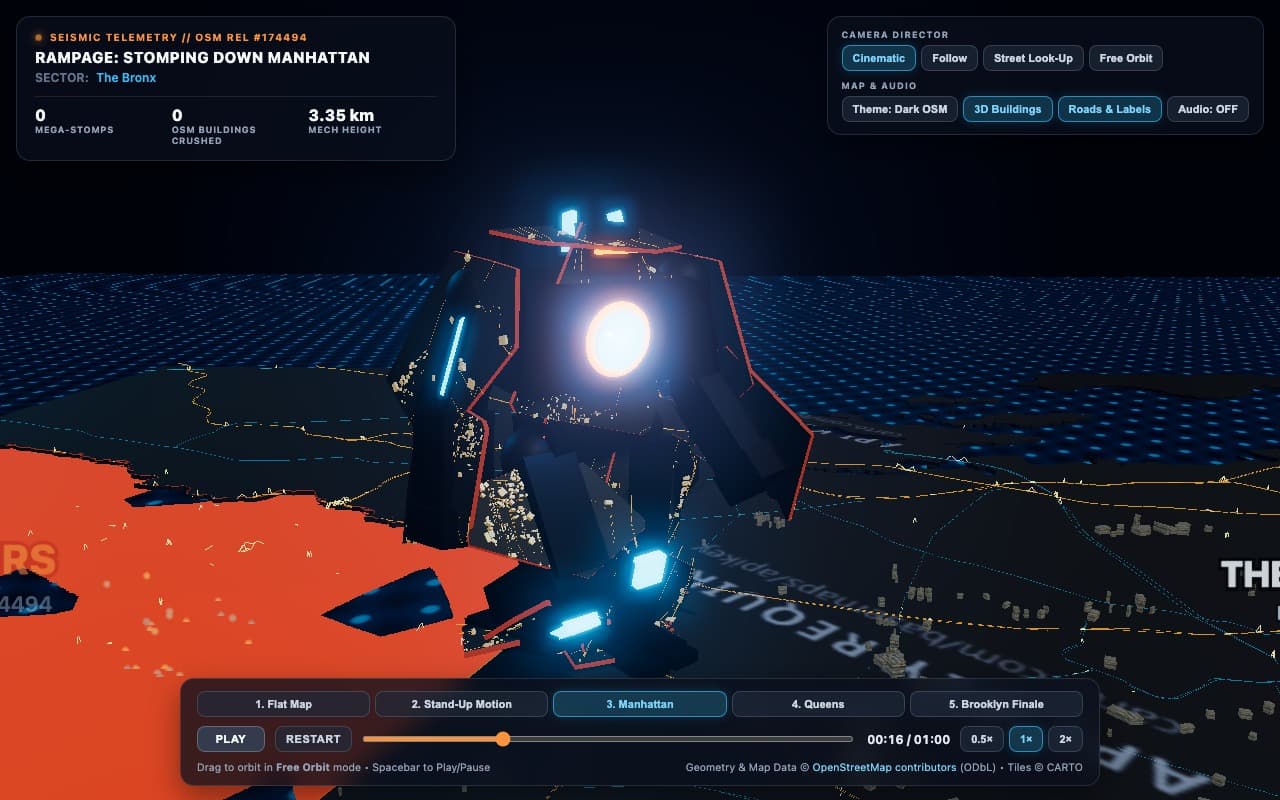
Die Bilder zeigen ausgewählte Ansichten der öffentlichen Projekte des Autors. Öffnen Sie die Originale für die Animation; die Screenshots vergleichen keine Laufgeschwindigkeit.
Achten Sie beim Öffnen auf drei konkrete Aspekte:
- Geografische Vorgaben: Prüfen Sie, wie der Yonkers-Umriss zum Mech wird und ob Karte, Straßen und aktuelle Regionsangaben zusammenpassen. Das Fable-Projekt kennzeichnet seine Gebäude ausdrücklich als erfunden.
- Bewegungsübergänge: Spielen Sie Verwandlung, Aufstehen und Gehen vollständig ab. Achten Sie auf Übergänge, Fußpositionen und Bodenkontakt, statt Bewegung anhand eines Einzelbilds zu beurteilen.
- Nützliche Interaktion: Testen Sie Ziehen, Zoomen und Wiederholung bei Fable sowie Kameras, Kapitel und Geschwindigkeit bei Carbon. Helfen die Bedienelemente beim Prüfen und Navigieren?
Der Fall eignet sich, um die Umsetzung von Raum-, Animations- und Datenanforderungen zu betrachten. Tool-Umgebungen, Prompt-Details und Zahl der Anfragen unterschieden sich. Vergleichbare Gesamtkosten und Zeiten fehlen; ein allgemeiner Sieger lässt sich daraus nicht ableiten. Der Autor nennt für Fable medium; die Carbon-Denkstufe wird in diesem Bericht nicht angegeben.
Für einen interaktiven Prototyp sollten beide dieselben Eingaben bekommen. Prüfen Sie, ob die Szene die Vorgaben erfüllt, der Code läuft, Änderungen handhabbar bleiben und wie viele Zusatzrunden bis zur Lieferung nötig sind. Erster visueller Eindruck und spätere Wartbarkeit gehören beide zur Abnahme.
Haupt-, Eskalations- und Prüfmodell in EvoLink festlegen
Bei einem bestehenden Produkt sollte der stabile Hauptablauf erhalten bleiben. Übertragen Sie Carbon oder Fable zunächst klar erkannte schwierige Aufgaben. Der einheitliche API-Zugang ermöglicht es, Schlüssel, Guthaben und Aufrufverwaltung weiterzuverwenden und die Modellauswahl in der Anwendungskonfiguration festzuhalten. Tools und Denkparameter jedes Modells richten sich weiterhin nach dessen Dokumentation.
Beginnen Sie mit einer von drei Anordnungen:
/swarm und Claude Advisor haben eigene Produkt- und Kanalbedingungen; beim einheitlichen API-Zugang übernimmt Ihr Framework oder Ihre Anwendung die entsprechende Orchestrierung.Die endgültige Konfiguration mit realen Aufgaben bestimmen
Wählen Sie aktuelle Fehlerbehebungen, Mehrdateiänderungen oder Tool-Aufgaben mit eindeutigen Abnahmekriterien. Beide Modelle erhalten denselben Codestand, dieselben Unterlagen und Tool-Berechtigungen.
Speichern Sie pro Aufgabe vier Ergebnisarten: Abnahme, sämtliche Modell- und Tool-Kosten, Gesamtzeit vom Beginn bis zur Lieferung sowie menschliche Eingriffe und Nacharbeit. Bei lohnenden ungelösten Fällen erhöhen Sie die Denkstufe oder wechseln das Modell und behalten dieselben Wiederholungsregeln bei.
Häufige Fragen
Welches Modell sollte ich mit begrenztem Budget zuerst testen?
Für Ergebnisse nahe an hohen Programmierkonfigurationen beginnen Sie mit Carbon medium. Falls die Qualitätsanforderungen es zulassen, vergleichen Sie auch Fable medium: Es kostet im CursorBench weniger und erzielt einen niedrigeren Wert. Entscheidend ist die eigene Aufgabenabnahme.
Ist Fable durch den höheren Preis immer besser für Programmierung?
Fable liegt in einigen Repository-Tests vorn, Carbon ist im aktuellen CursorBench ebenfalls stark. Wählen Sie nach Aufgabe und vergleichen Sie Lieferung und Nacharbeit auf verschiedenen Stufen.
Ist Carbon 75 % günstiger?
Die Anbieter-Basistarife für nicht zwischengespeicherte Eingabe und Ausgabe liegen während der Einführung 75 % und später 50 % niedriger. Das ist weder die tatsächliche Aufgabenersparnis noch unmittelbar Ihr EvoLink-Kontotarif.
Ist medium auf beiden Seiten ein fairer Vergleich?
So vergleichen Sie den praktischen Nutzen dieser Konfigurationen. Gleiche Stufennamen bedeuten jedoch kein gleiches Rechenbudget. Erfassen Sie Modell, Tools, Verbrauch, Dauer und Abnahme gemeinsam.
Welches Modell ist schneller?
Messen Sie Zeit bis zum ersten Token, vollständige Antwortzeit und Abschluss der Gesamtaufgabe im vorgesehenen Kanal und auf der jeweiligen Stufe. Denken, Tools und Nacharbeit verändern das Ergebnis.
Reicht zum Wechsel der Modellname?
Der einheitliche Zugang reduziert doppelte Client-Konfiguration. Tool-Aufrufe, Denkparameter, Nachrichtenformate und Fehlerbehandlung müssen dennoch je Modell geprüft werden. Bei Übergaben geben Sie notwendiges Aufgabenmaterial weiter und bauen die Nachrichten für das Zielmodell neu auf.
Kann das andere Modell direkt Code prüfen?
Beginnen Sie mit einem unabhängigen Prüfversuch und verlangen Sie Auslöser und Reproduktionsbelege zu jedem Problem. Auch übereinstimmende Modelle brauchen Testvalidierung. Prüfkosten und Zeit für Fehlalarme gehören zur Gesamtrechnung.