Claude Fable 5.2発表:コード・推論・エージェントの進化
Fable 5.2の変更点を解説。コードと推論の改善、電子機器・ゲームのデモ、標準単価20%引き下げ、推論強度とAPI移行の確認事項。
 EvoLink Team製品チーム
目次
注目したいのは、既存コードの理解、問題の分解、ツール実行、結果の検証、失敗後の方針変更を通じて、長い作業を前に進められるかです。回答が詳しくなることと、プロジェクトを完成させやすくなることは別の成果です。後者はツール、実行時間、人の修正、最終費用も含めて評価する必要があります。
ClaudeシリーズにおけるFable 5.2の位置づけ
Fableは、継続的な推論が必要な難度の高い技術作業向けです。Anthropicは、多くの作業では最新のOpusから始め、Opusの推論強度を上げても評価結果が要件に届かない場合にFable 5.2へ移ることを推奨しています。
スタイルの変更、一般的なAPIの実装、明確な規則による文書整理なら、すでに安定して完了できるモデルが経済的な場合があります。複雑な依存関係、設計案の比較、繰り返しの検証を伴う作業では、高性能モデルの価値を見つけやすくなります。移行作業ではデータ構造、業務動作、デプロイ、性能制約が絡みます。判断ミスによる手戻りを一度防ぐことが、単発のリクエスト単価より重要になる場合もあります。
Mythos 5.2は同じ基盤モデルを使用します。Fableはサイバーセキュリティと生物分野の保護措置によって広く提供され、MythosはAnthropicの認証プログラムで承認された組織向けです。これらの分野の結果は、どのモデルによるものか区別する必要があります。
100万トークンのコンテキストと128Kの最大出力
claude-fable-5-2です。100万トークンのコンテキストと最大128Kトークンの出力**に対応し、テキストと画像を入力してテキストを出力します。適応型思考は常時有効で、APIの推論強度は既定でhighです。リポジトリの調査ではインターフェース定義、実装、テスト、過去の設計資料を、調査作業では複数の報告書とデータ定義を渡せます。ただし、資料の渡し方は引き続き重要です。入力では次を明確にします。
- 成果物:実行可能なコード、移行計画、完成した分析など。
- 必須条件:インターフェース互換性、データ整合性、レイテンシーなど。
- 利用できる検証:テスト、型チェック、ビルド、データ検証スクリプトなど。
- モデルが判断してよいことと、人が決めるべきトレードオフ。
明確な目標と実行できる検証があれば、進捗を判断しやすくなります。コンテキスト容量は作業領域であり、その使い方はタスクの構造によって決まります。
Fable 5.2はコード、推論、グラフ理解を改善
Anthropicが公開した結果は、技術作業の複数の側面を対象としています。図ではFrontierCode 2.0、FrontierSWE v2、ツール使用ありのHumanity's Last Exam、ツールなしのChartographyを比較しています。
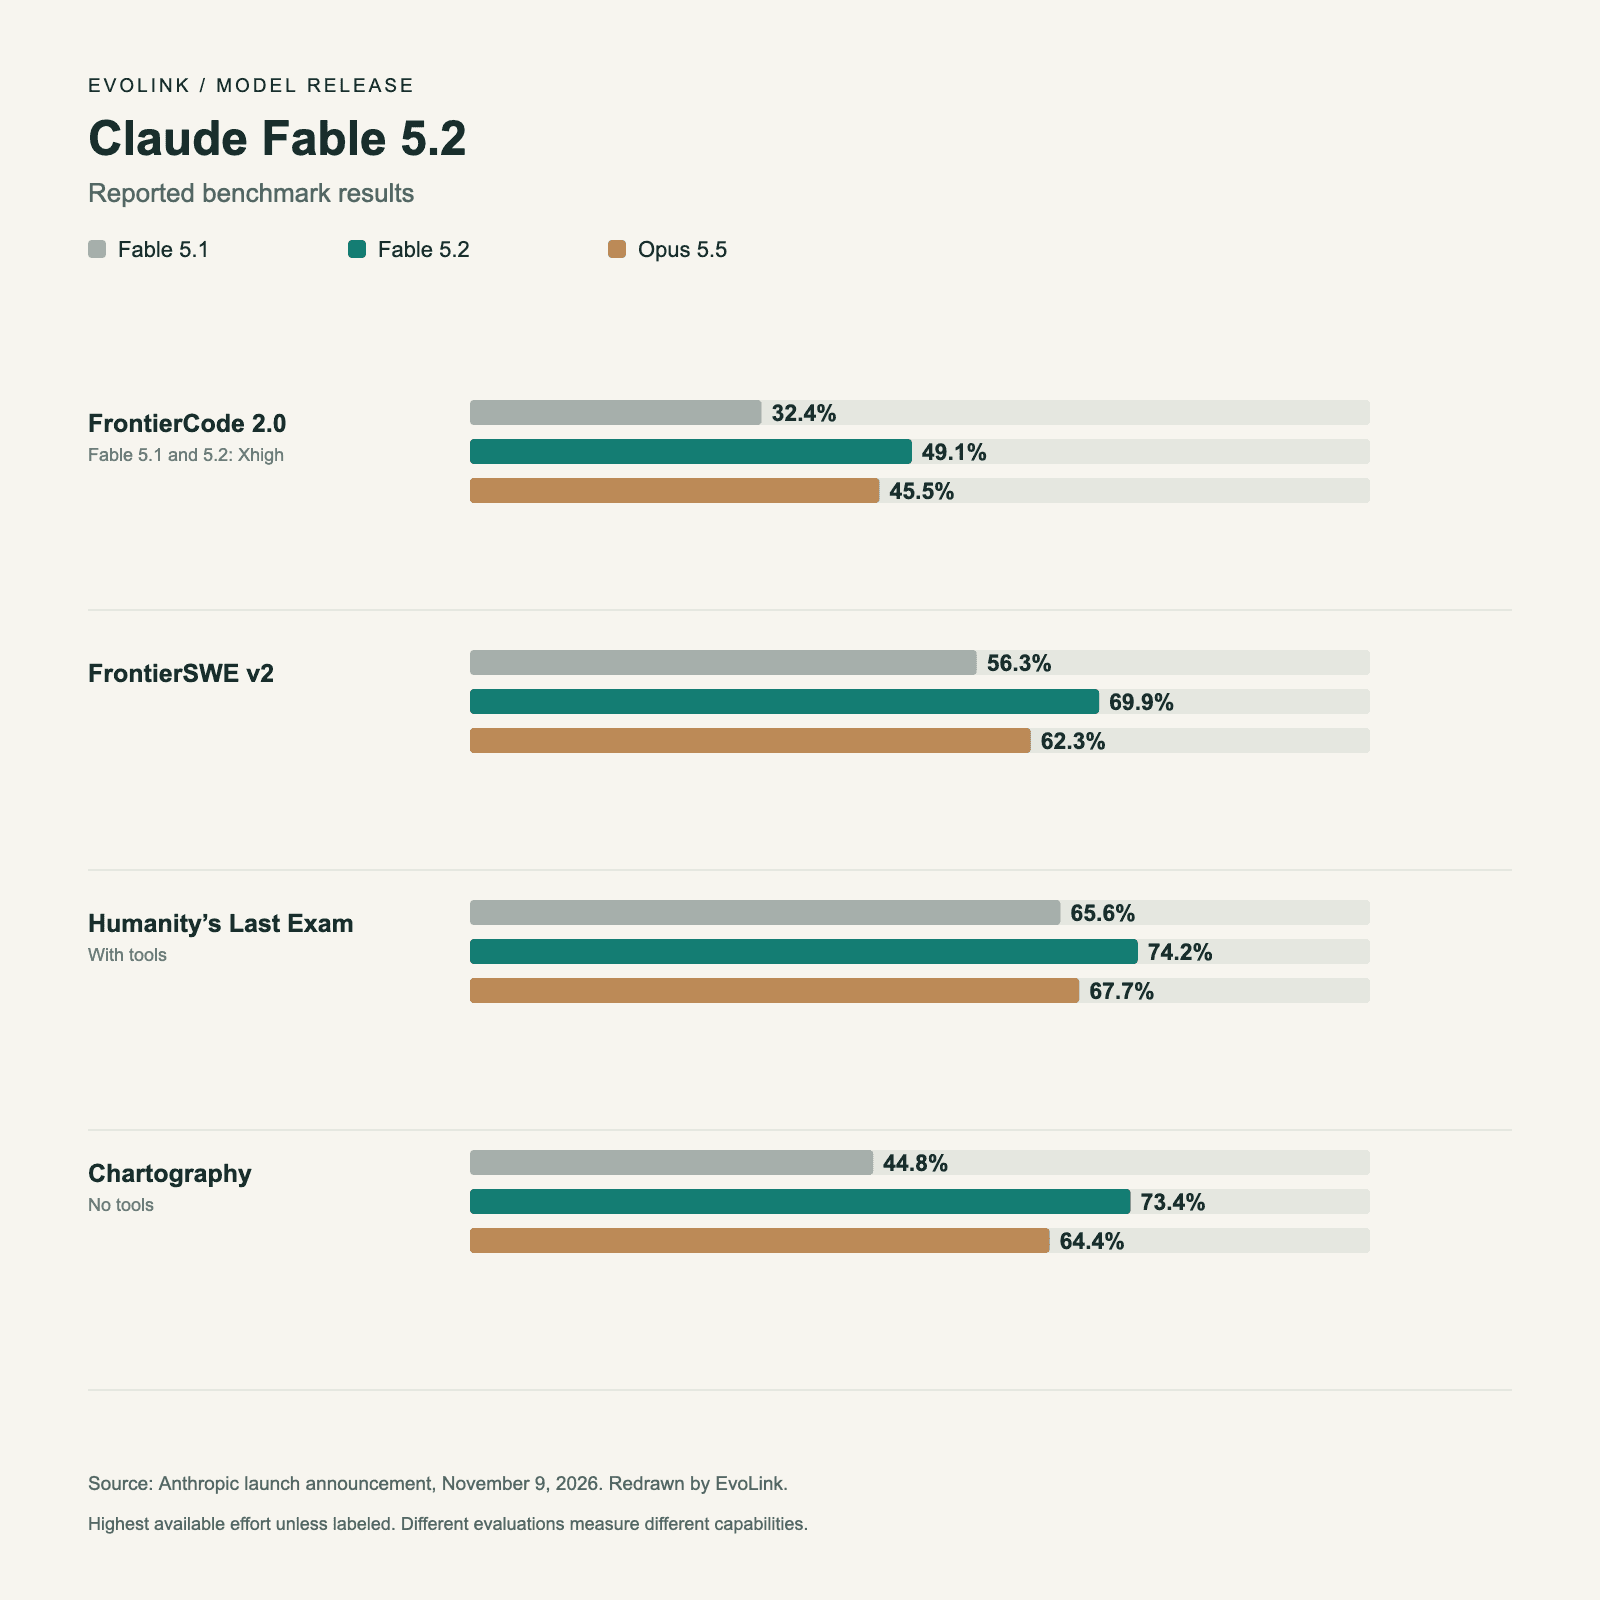
実際のプロジェクトでは、コーディング、多段階の分析、グラフからの情報抽出が組み合わさります。性能曲線とエラーログからボトルネックを探す、グラフの解釈をコードで検証する、視覚的な参考資料を操作できるUIにする、といった作業です。
評価には日常業務の入力を使いましょう。スクリーンショット、グラフ、コードを扱うなら、すべて含めます。テキストだけの一問では、ワークフロー全体の違いを捉えきれない場合があります。
電子機器の試作で見える、複数工程をつなぐ設計能力
AnthropicとDiodeは、Fable 5.2にUSB会議用スピーカーフォン、家庭用音声アシスタントハブ、携帯型の電子ペットを設計させました。仕様、回路図、部品配置、基板配線、筐体、ファームウェアをモデルが担当し、Diodeの技術者が製造と試験を実施しました。Anthropicによると、3台とも回路修正なしで動作しました。
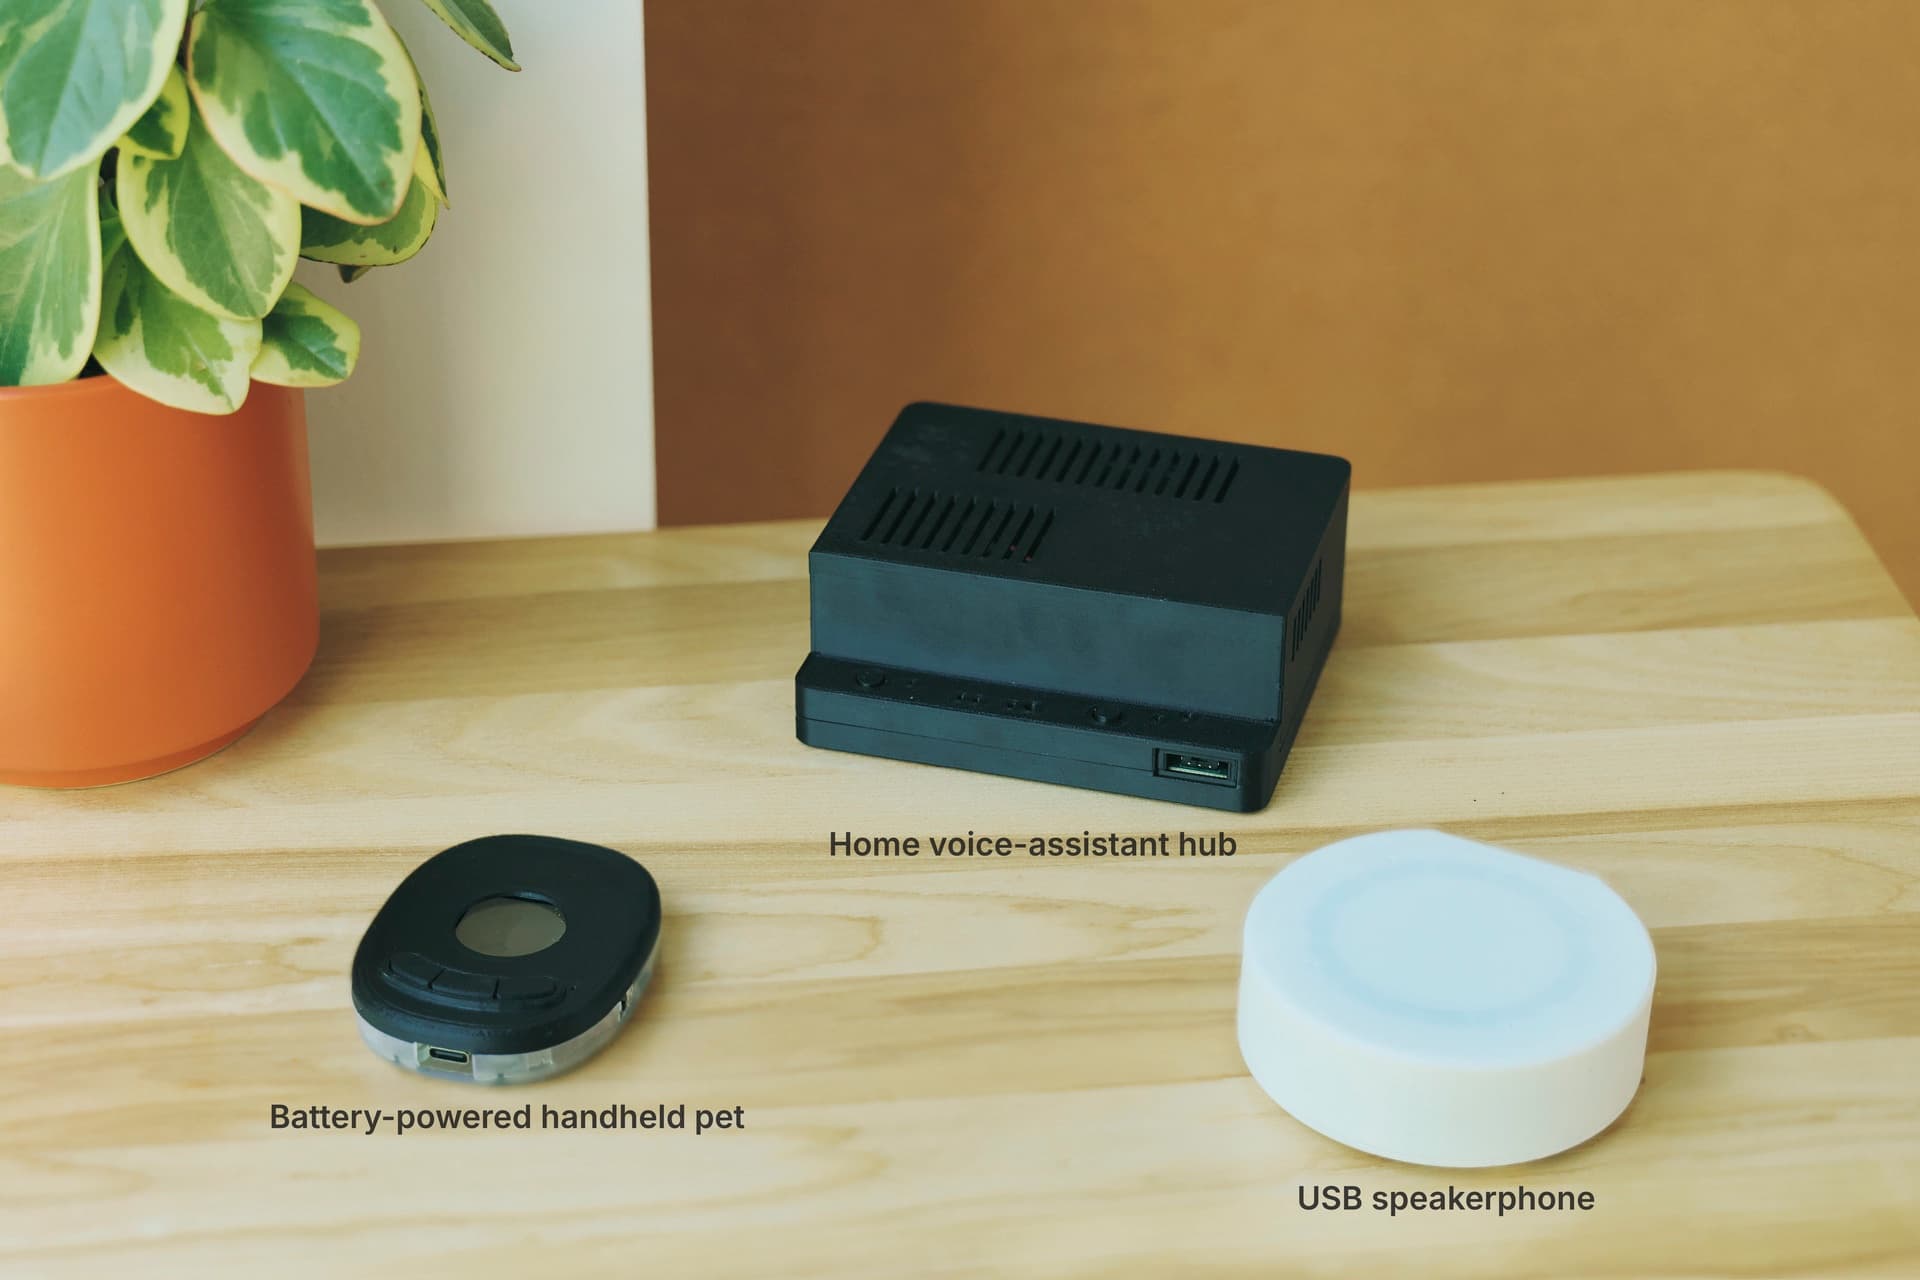
部品配置は配線に、コネクターの位置は筐体の開口に、組み立て方は機構設計に影響します。一つの工程で妥当な判断が、後の工程で問題を生むこともあります。この例は、制約と後工程への影響を追い続ける価値を示しています。
これらは試作品です。電気的な検証、アンテナ調整、熱試験、認証は残っており、量産向けの設計ではありません。動く試作品が得られても、その後の製品開発は必要です。ソフトウェアでも、コードの動作に加えてデプロイ、監視、ロールバック、保守を考慮したか確認できます。
1,000エージェントによる長時間協調の実験
システムとして重要なのは、依存する作業を引き受け、進捗を共有し、結果を提出し、部分成果を結合する仕組みです。共有状態と信頼できる検証が作業の継続を支えます。大規模なコード移行では共通のインターフェース、重複編集の回避、統一されたテストが必要です。調査の分担でも、分析を組み合わせるにはデータ定義をそろえる必要があります。
エージェントを増やす前に、独立して完了でき、明確に検証できる部分作業を見つけましょう。並列化には調整コストがあり、台数と同じくらいタスクの区切り方が重要です。
ゲームやインタラクティブデモで能力を確認する
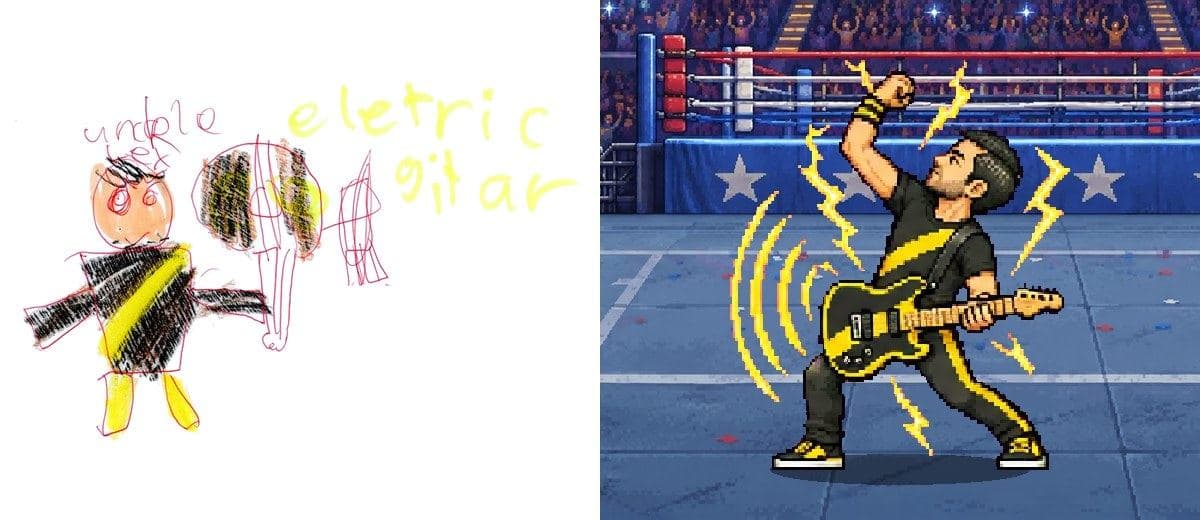
この事例の魅力は、キャラクター、物語、目標を、コード、素材ツールの呼び出し、テストへ継続的に展開できる点です。教育ツール、操作可能なデモ、ブランド体験を作るチームなら、パラメーターを変えられる製品説明や、操作できる工程シミュレーションで、説明が伝わるか試せます。
見た目だけでなく、操作への反応、安定性、修正のしやすさも確認しましょう。試作は何度も変更されます。編集可能なソースコードと整理された素材構成が、後の修正費用に影響します。
標準単価は20%下落、Fast modeで速度を選択
Anthropicの標準料金はFable 5.1から20%下がりました。
| 100万トークン当たりの米ドル料金 | Fable 5.1標準 | Fable 5.2標準 | Fable 5.2 Fast mode |
|---|---|---|---|
| 入力 | $10 | $8 | $16 |
| 出力 | $50 | $40 | $80 |
対話的なデバッグなど、待ち時間にコストがある場合はFast modeが候補になります。キューに入れて処理できるバックグラウンド作業では、時間短縮が料金増に見合うか確認してください。
キャッシュとタスク全体の費用も確認する
エージェントはプロジェクト背景やツール定義を複数回使います。キャッシュ条件を満たせば、通常入力とは異なる料金になります。ゲーム事例の大量のキャッシュ読み取りも、トークンを種類別に見る理由です。
通常入力、キャッシュ書き込み、読み取り、出力を分けて記録し、外部ツール料金と人の手戻りも含めて、受け入れ可能な成果物の費用を比較します。単価の下落は基礎費用を改善しますが、最終的な節約は実行の仕方によって決まります。
推論強度もモデル選択の一部
low、medium、high、xhigh、maxがあり、APIの既定値はhighです。AnthropicはHighから始め、難しい作業で効果を測定してからXhighを試し、Maxは能力上限の探索や時間・トークン費用が重要でない少数の作業向けとしています。2026年11月10日に確認したArtificial Analysisの結果は次のとおりです。
| 設定 | Intelligence Index | 評価タスク当たりの加重平均費用 |
|---|---|---|
| Medium | 56 | $3.80 |
| High | 62 | $9.08 |
| Max | 65 | $26.54 |
すべてDefault Fallbackと表示された設定です。費用はAAの評価タスクと算定方法によるもので、一般的な仕事の見積もりではありません。この時点のHighからMaxではスコアが上がる一方、評価費用も大きく増えています。
入力、ツール、受け入れ基準を固定して推論強度を変え、要件を最初に満たす設定と、追加予算で改善が続くかを確認しましょう。日常的な情報整理と依存関係の複雑な移行では、異なる設定が適しています。
アップグレード時には古いプロンプトも見直す
Anthropicのガイドは、常設の「サブエージェントを多く使う」指示が不要な分担を生む場合があると説明しています。プロンプトに書いた大きなトークン予算も消費に影響し、一部のコーディング試験では、その文言を外すと同程度の性能で費用が下がりました。これは文章中の予算の話であり、APIのtask budgets機能についての結論ではありません。
毎回の並列処理、すべての案の網羅、重複した古い規則が本当に必要か確認します。明確な完了条件は評価を容易にします。元のプロンプトを残し、変更を一つずつ品質、費用、実行動作で比較して、モデルの効果とワークフローの効果を分けて判断してください。
本番接続で確認する変更点
公式チャネルにはClaude API、Amazon Bedrock、Google Cloud、Microsoft Foundry、Claude Platform on AWSがあります。モデルID、機能、課金はチャネルごとの文書で確認してください。
既存の実装では次の4点を確認します。
- 会話履歴: システムプロンプト、ツール、過去のメッセージを変えると、返送する思考ブロックが無効になる場合があります。プレフィックス検証は全アカウントに適用され、無効なブロックを
prefix_mismatch_behavior未設定で送ると400エラーになります。 - モデル切り替え: Claude APIでFable 5.2からOpus 5.5へ切り替えるとFableの思考ブロックは破棄されますが、リクエスト自体は成功する場合があります。
- Computer use: Amazon Bedrockを除き、旧
computer_20251124から新しいツール群への移行が必要です。 - Advisor: Fable 5.2を実行モデルにする場合、Fable 5.2またはMythos 5.2の互換advisorが必要です。
統一APIゲートウェイで管理する場合も、パラメーターの転送、課金、長い会話でモデルを切り替える際の履歴処理を確認します。これらは本番ワークフローの動作に直結します。
Fable 5.2を優先的に評価したいチーム
Fable 5.1の利用者は、品質と費用の記録がある仕事で完了率、修正量、支出を比較できます。Opus中心のチームは、繰り返し難航する仕事から始めます。何度直してもテストが通らないコードや、相互に関係する制約を満たせない計画などです。
エージェント製品のチームは、計画、難しい分析、重要な結果のレビューにFableを使い、明確な実行手順をより経済的なモデルに任せる構成を評価できます。導入前に情報の受け渡しと合計費用を測ってください。
最初は通常の仕事、既知の難問、長時間のプロジェクトを一つずつ選び、成果物の品質、時間、総費用、人の修正量を比較するとよいでしょう。その結果から既定モデル、上位モデルへ切り替える条件、推論強度を決めます。Fable 5.2の高い能力上限と低い標準単価が、安定した現実的な費用の納品につながる場所を、慣れた仕事で見極められます。
よくある質問
Claude Fable 5.2の発表日は?5.1から何が変わりましたか?
Fable 5.2の発表を機に、利用中のOpus 5.5を置き換えるべきですか?
Fable 5.2とMythos 5.2の違いは何ですか?
Fable 5.1から20%下がった単価は、タスク全体の費用にどう影響しますか?
Fable 5.2は画像や動画を直接生成できますか?
100万トークンのコンテキストと128Kの出力は、長いタスクで何を意味しますか?
Fable 5.2の発表では、どの提供チャネルが案内されていますか?
claude-fable-5-2です。公式チャネルにはAmazon Bedrock、Google Cloud、Microsoft Foundry、Claude Platform on AWSもあります。チャネルごとのID、機能、課金を確認してください。EvoLinkではFable 5.2モデルページで現在の接続情報と料金を確認できます。外部ルートではパラメーターと会話履歴の互換性も個別に検証が必要です。公式の提供情報推論強度はどの設定から始めるべきですか?
highで、low、medium、high、xhigh、maxから選べます。Highから始め、入力、ツール、受け入れ基準を固定して他の設定を比較します。難しい作業で効果を測定してからXhighを試し、追加の時間とトークンに見合う能力上限の探索にはMaxを使います。推論強度の指針アップグレード後に既存の会話で400エラーが出るのはなぜですか?
prefix_mismatch_behavior未設定で再送すると400になります。移行時は思考履歴の処理と、プレフィックス不一致時の文書化された動作を確認してください。別の動作として、Claude APIでFable 5.2からOpus 5.5へ切り替えると、リクエストが成功しても思考ブロックは破棄される場合があります。移行時の変更点