Gemini 4 Carbon vs Claude Fable 5.2 : code, raisonnement et coût par tâche
Choisir Carbon ou Fable 5.2 selon les benchmarks de code, les niveaux CursorBench et le coût total, avec une répartition des modèles via EvoLink.
 EvoLink TeamÉquipe produit
Dans cet article
Deux ensembles de résultats motivent ce point de départ : Carbon obtient un score proche de Fable max dans le CursorBench actuel, avec un coût affiché inférieur ; Fable obtient de meilleurs résultats dans les évaluations de développement sur dépôt publiées par Anthropic. Les avantages varient selon la tâche et le niveau de raisonnement. Il faut donc définir un rôle pour chacun.
Choisir Carbon ou Fable selon la tâche
| Votre tâche | Premier choix à tester | Critère pour le conserver |
|---|---|---|
| Modifications complexes sur plusieurs fichiers en maîtrisant les dépenses | Carbon medium | Tests réussis, changements acceptables et coût total dans le budget |
| Migration entre modules ou bug difficile entraînant beaucoup de reprises manuelles | Fable 5.2 | Moins de solutions abandonnées, d'omissions et de temps d'enquête |
| Processus métier utilisant plusieurs outils | Évaluer Carbon, puis le comparer au modèle actuel | Ordre des actions, paramètres et état métier final corrects |
| Travail quotidien fiable avec quelques cas difficiles | Garder le modèle principal et ajouter une voie d'escalade | L'escalade résout un blocage réel du processus actuel |
| Revue du code produit par un autre modèle | Choisir un autre modèle pour une revue indépendante | Problèmes reproductibles, tests de non-régression réussis et faux positifs maîtrisés |
Ce tableau propose un ordre pour les premiers essais. Les tarifs de base inférieurs de Carbon permettent d'établir une référence budgétaire. Les résultats de Fable sur les dépôts justifient de le tester tôt sur les travaux dont l'échec coûte cher. Pour la revue, tenez compte du modèle d'implémentation existant afin que production et contrôle ne reposent pas entièrement sur le même jugement.
Prenons la refonte d'un service de paiement qui doit préserver l'idempotence et le comportement historique des nouvelles tentatives. Le modèle doit reconnaître les contraintes des anciennes interfaces, proposer une migration vérifiable et compléter les tests de non-régression. Si un meilleur plan évite des heures de reprises, le prix du token pèse moins dans la décision.
Que disent les benchmarks de programmation ?
Fable est devant sur certaines évaluations de développement sur dépôt
Le tableau de lancement de Fable 5.2 publié par Anthropic contient ces tests communs :
| Tâche évaluée | Gemini 4 Carbon | Claude Fable 5.2 |
|---|---|---|
| FrontierSWE v2 : ingénierie logicielle sur dépôt | 61.2% | 69.9% |
| FrontierCode 2.0 : modifications de code répondant aux critères de fusion | 41.1%, medium | 49.1%, xhigh |
| AutomationBench : processus métier | 53.9% | 51.4% |
| OSWorld 2.1 : sous-ensemble de tâches de bureau hors ligne, crédit partiel | 81.5% | 89.3% |
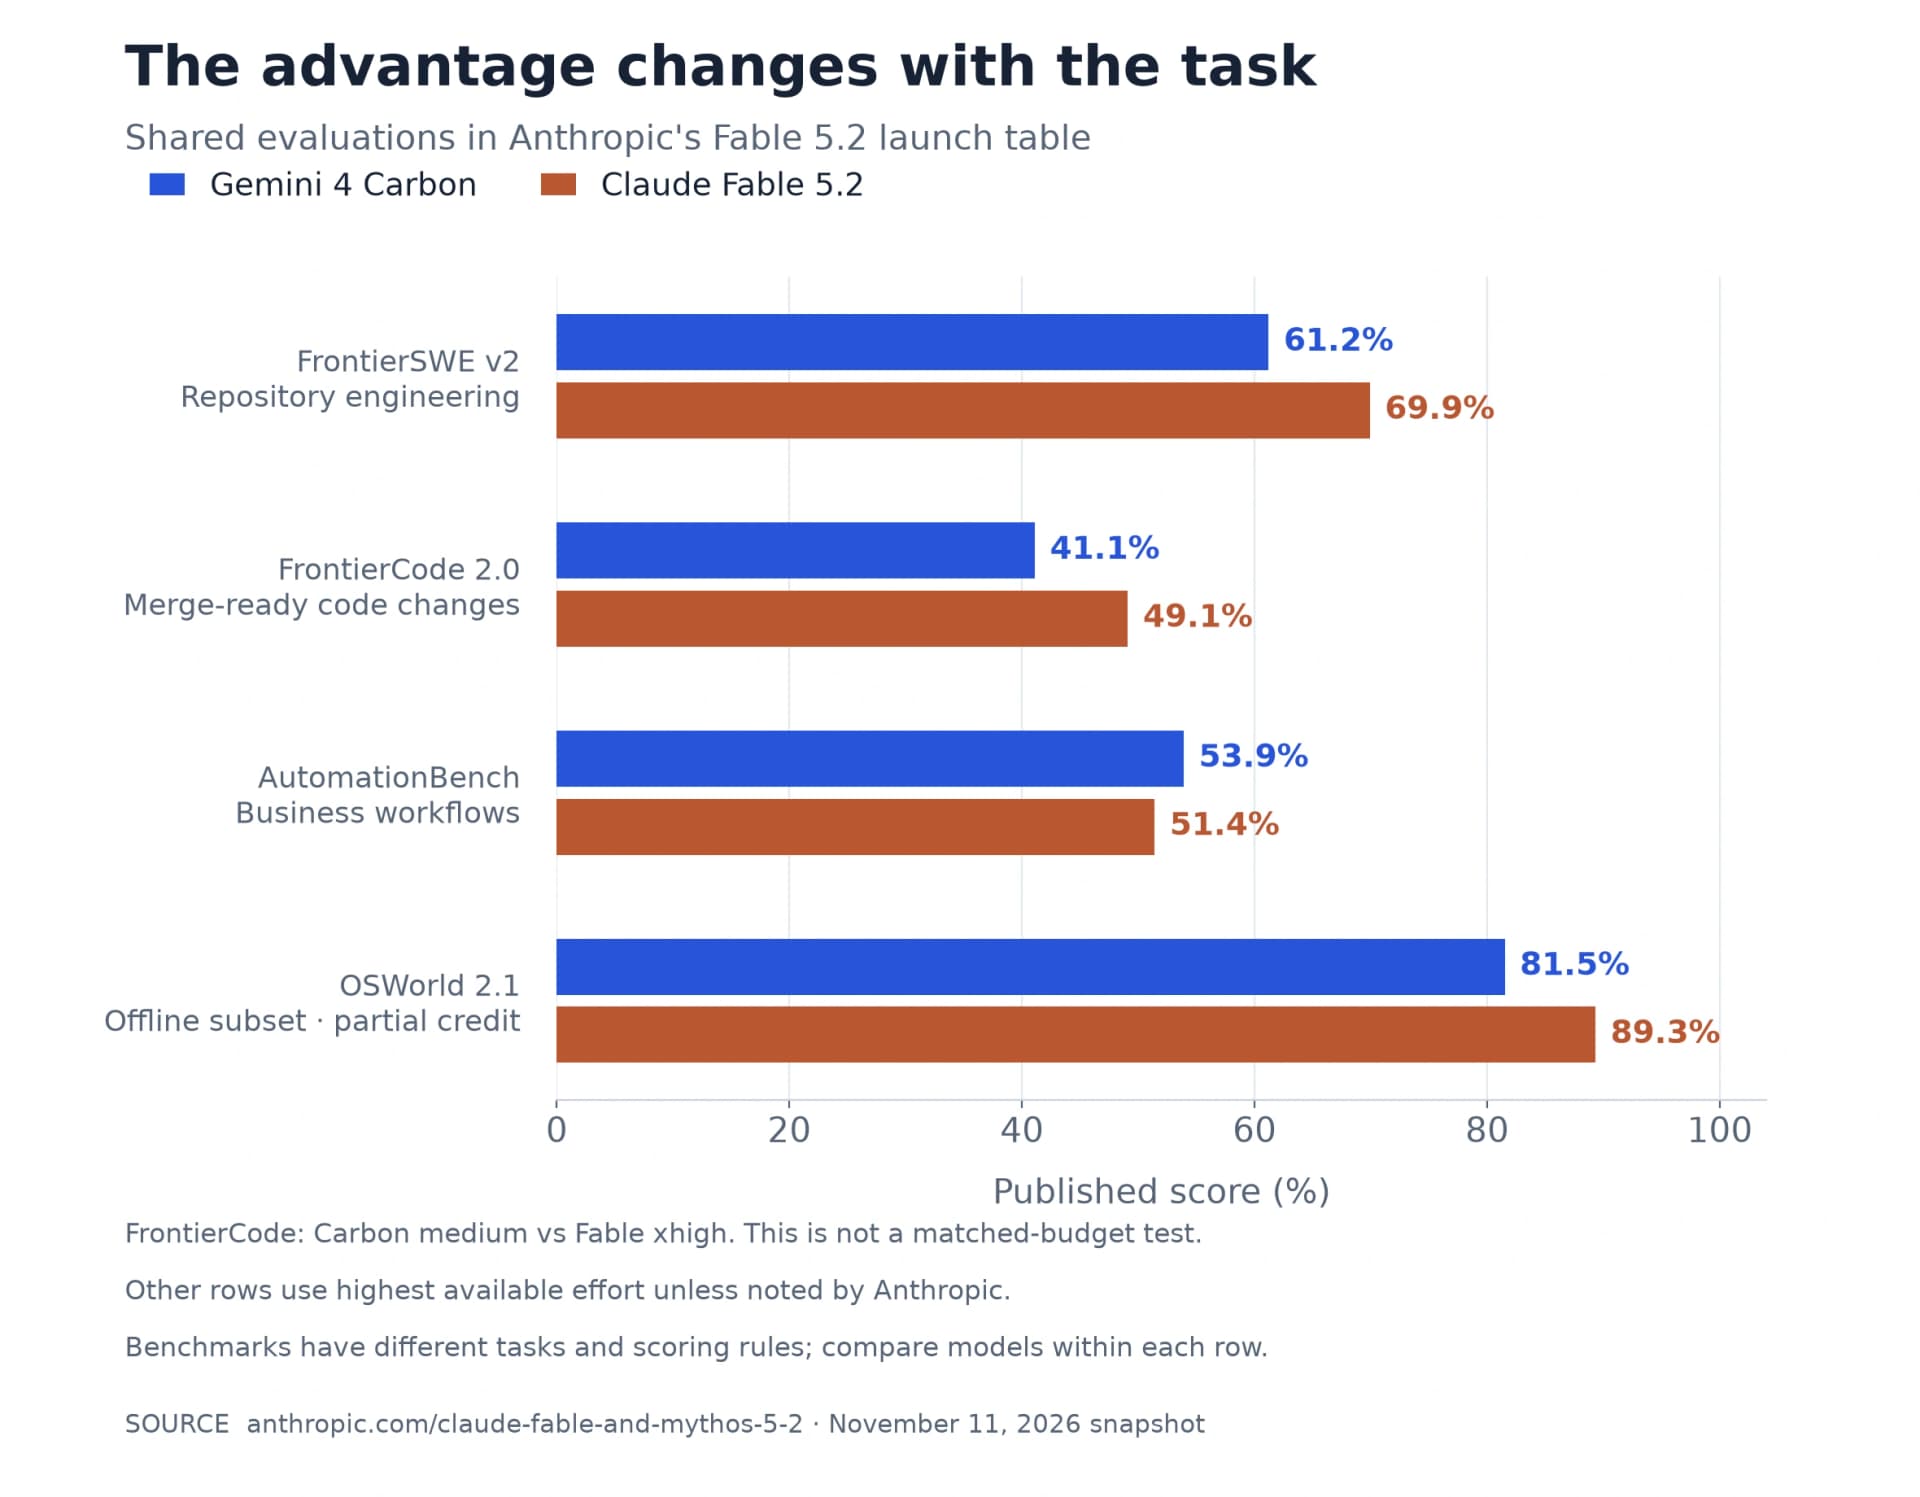
Ces résultats soutiennent un essai prioritaire de Fable sur les modifications difficiles d'un dépôt et donnent une raison d'évaluer Carbon sur les processus métier. Les opérations de bureau, le développement et l'automatisation métier ont des critères d'achèvement différents. Reliez chaque résultat au travail à livrer.
Carbon propose une configuration intéressante pour les besoins élevés sur CursorBench
CursorBench 4.0 utilise des tâches ambiguës sur plusieurs fichiers issues de sessions Cursor réelles. Voici quelques configurations relevées le 11 novembre :
| Configuration | Score | Coût moyen affiché par tâche |
|---|---|---|
| Carbon high | 60.4% | $9.22 |
| Carbon medium | 60.1% | $8.49 |
| Carbon low | 58.6% | $11.89 |
| Fable 5.2 max | 60.0% | $32.79 |
| Fable 5.2 high | 56.9% | $9.70 |
| Fable 5.2 medium | 54.8% | $4.66 |
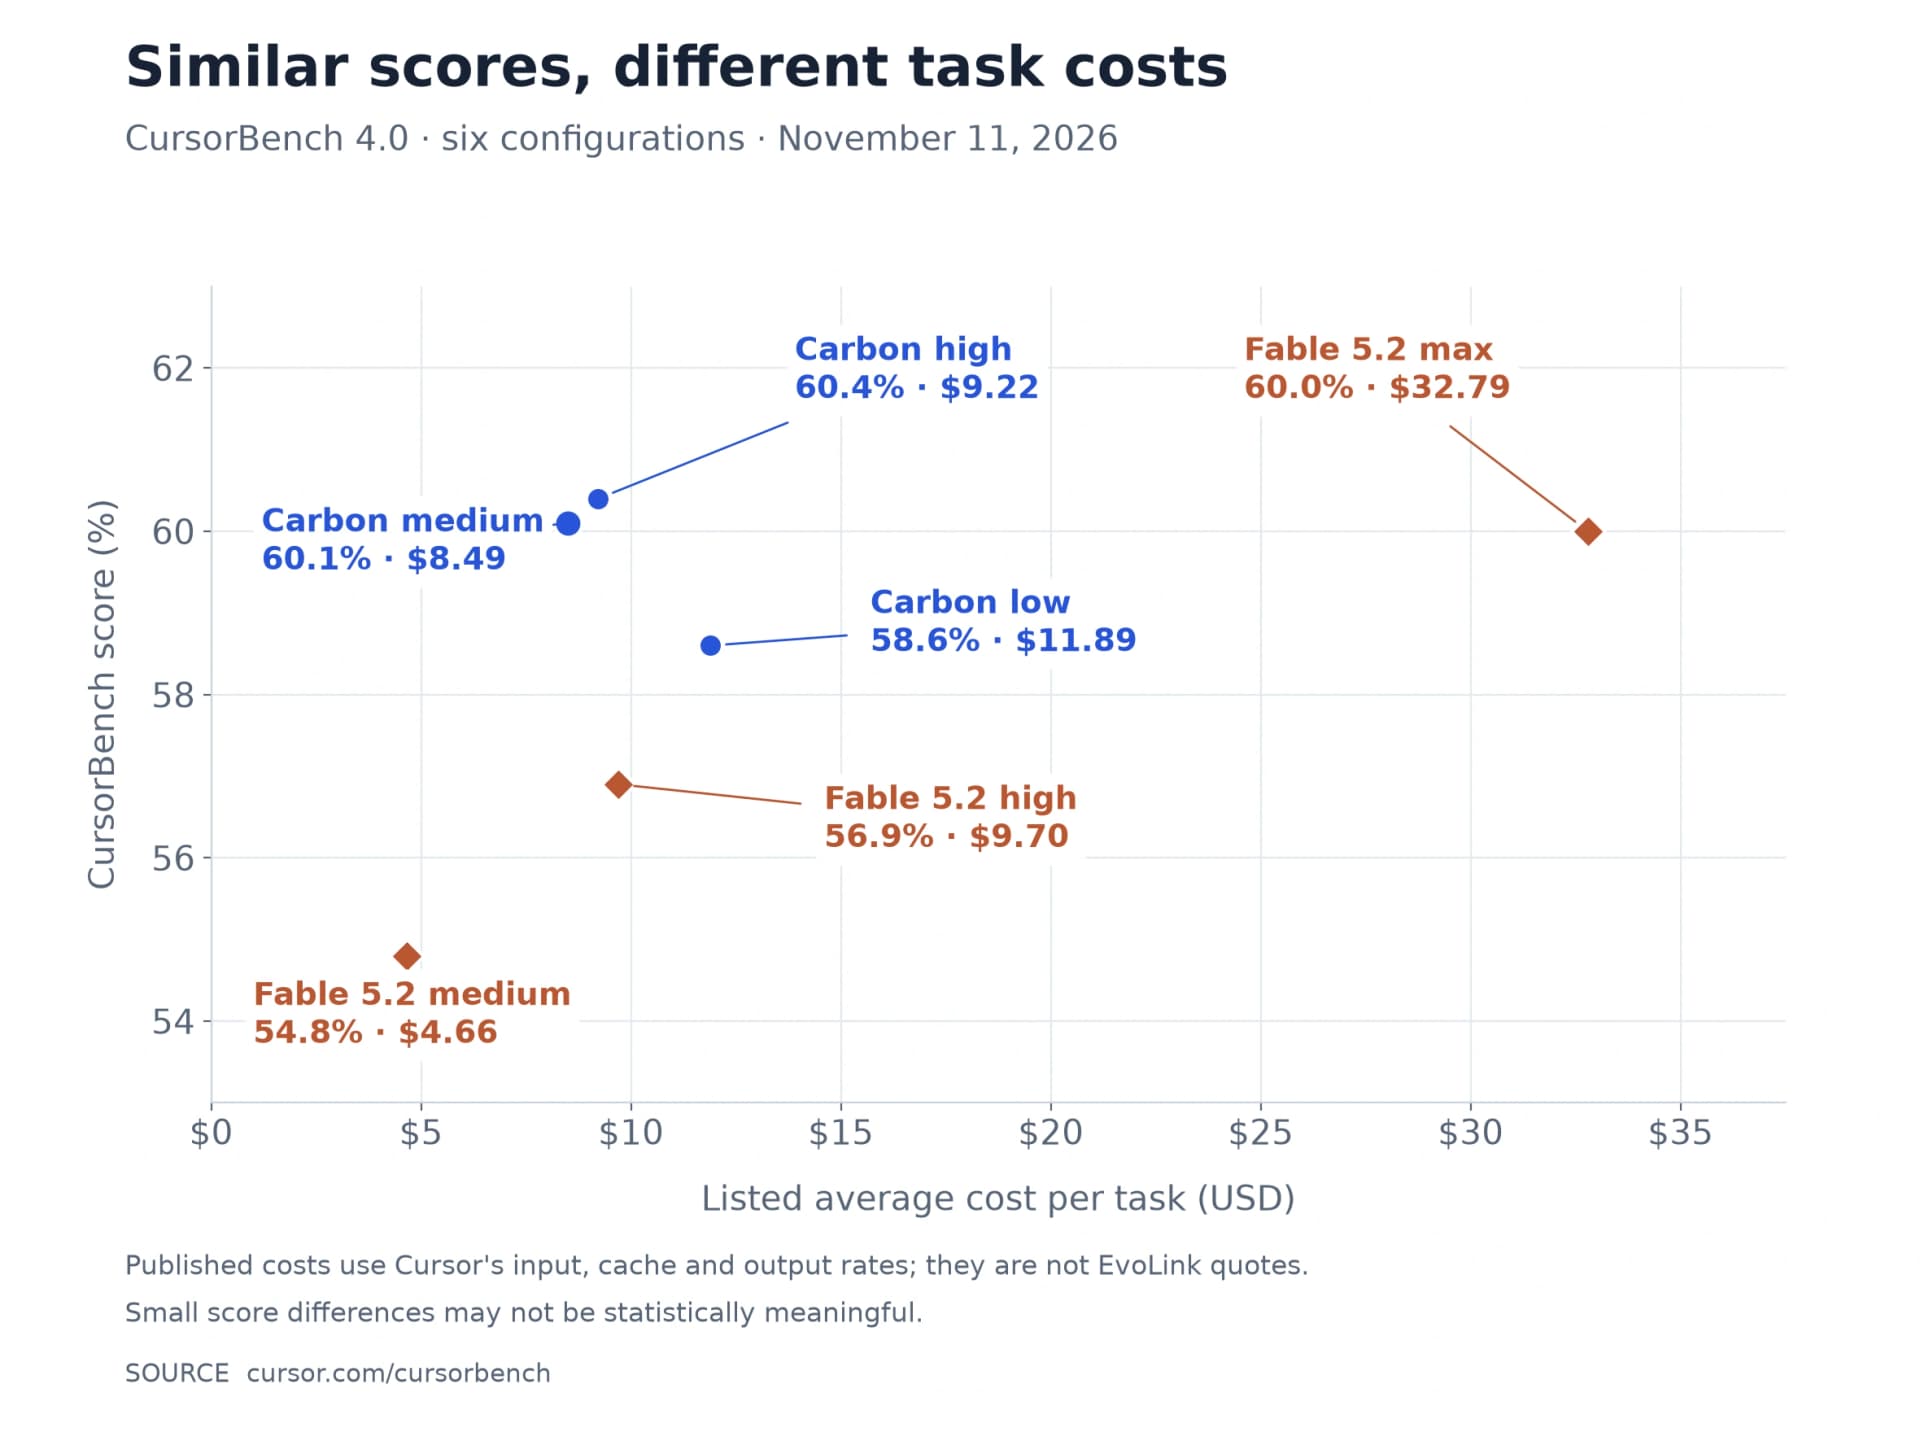
Carbon medium est proche de Fable max avec un coût affiché nettement inférieur : c'est un bon premier candidat pour la programmation complexe. Fable medium coûte moins cher sur ces tâches, avec un score lui aussi inférieur. Si ce niveau de qualité suffit, cette configuration de Fable peut convenir.
Le coût moyen de Carbon low dépasse celui de medium. Pour un agent en plusieurs étapes, réduire le raisonnement par tour peut modifier tout le parcours d'exécution et la consommation totale. Choisissez le niveau selon l'achèvement final et la facture complète.
Quand le prix plus élevé de Fable vaut-il la dépense ?
Voici les tarifs de base Standard des fournisseurs, en dollars américains par million de tokens. Ils excluent le cache, Batch, le mode rapide et les outils payants supplémentaires.
| Modèle et période de facturation | Entrée | Sortie |
|---|---|---|
| Carbon, jusqu'au 30 novembre 2026 inclus | $2 | $10 |
| Carbon, à partir du 1er décembre 2026 | $4 | $20 |
| Fable 5.2 | $8 | $40 |
- Carbon au lancement : $0.30.
- Carbon au tarif normal : $0.60.
- Fable 5.2 : $1.20.
En pratique, la tokenisation, le raisonnement, les appels d'outils et les nouvelles tentatives peuvent différer. Fable se justifie s'il réduit, sur certaines tâches, les échecs, les réécritures manuelles ou le temps d'enquête. Carbon se justifie s'il satisfait les mêmes critères d'acceptation à un coût total inférieur.
Comparer la programmation créative à partir de projets publics
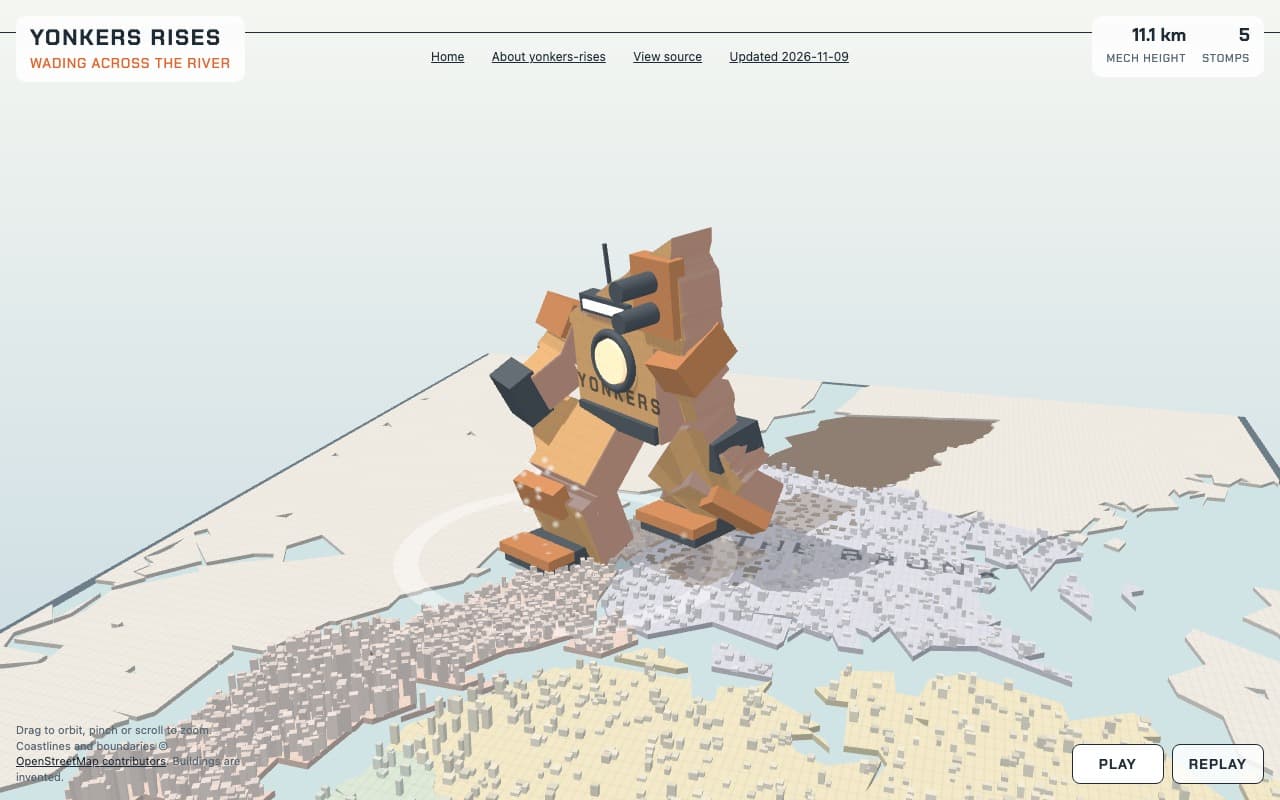
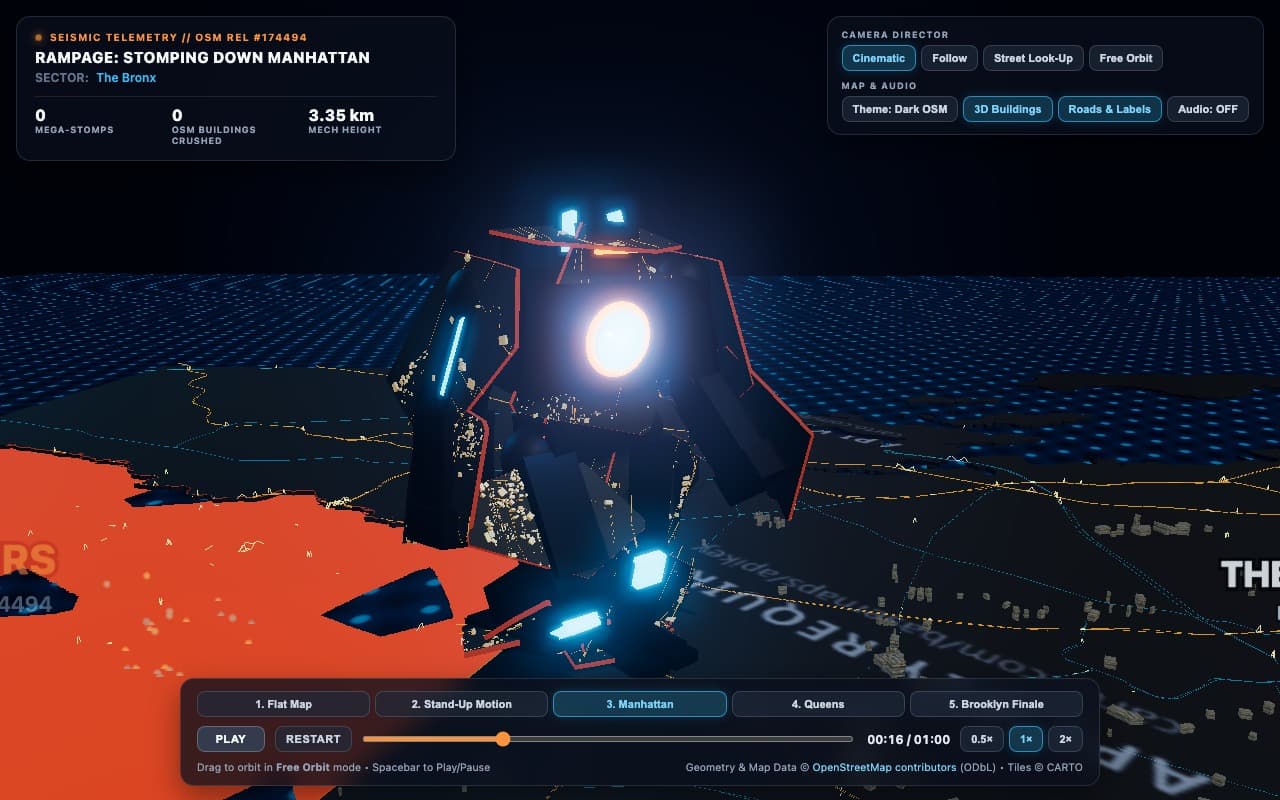
Ces captures montrent des vues choisies des projets publics de l'auteur. Ouvrez les originaux pour revoir les mouvements ; les images ne comparent pas la vitesse d'exécution.
En ouvrant les démos, observez trois aspects précis :
- Contraintes géographiques : Vérifiez comment le contour de Yonkers devient le robot et si carte, routes et noms de la région courante concordent. Le projet Fable précise que ses bâtiments sont inventés.
- Continuité du mouvement : Rejouez la transformation, le redressement et la marche. Examinez transitions, position des pieds et contact au sol plutôt que de juger une animation sur une seule image.
- Utilité des interactions : Essayez le déplacement de la vue, le zoom et la relecture dans Fable, puis les caméras, chapitres et vitesses dans Carbon. Vérifiez que ces commandes aident à inspecter et parcourir le résultat.
Ce cas permet d'examiner le respect des contraintes spatiales, d'animation et de données. Les environnements d'outils, détails des prompts et nombres de requêtes diffèrent, sans coût total ni durée comparables. Il ne permet pas de désigner un vainqueur général. L'auteur indique medium pour Fable ; le niveau de raisonnement de Carbon n'est pas précisé dans ce compte rendu.
Pour un prototype interactif, donnez les mêmes entrées aux deux modèles. Vérifiez que la scène respecte le brief, que le code s'exécute, qu'il reste facile à modifier et combien de tours supplémentaires sont nécessaires. Le rendu initial et la maintenabilité doivent tous deux faire partie de l'acceptation.
Comment répartir modèle principal, escalade et revue dans EvoLink ?
Pour un produit existant, conservez le processus principal stable et confiez à Carbon ou Fable les tâches difficiles déjà identifiées. Une API unifiée permet de garder clé, solde et gestion des appels tout en faisant du choix du modèle une configuration applicative. Les outils et paramètres de raisonnement restent propres à la documentation de chaque modèle.
Commencez par l'une de ces trois organisations :
/swarm d'Antigravity et Claude Advisor ont aussi leurs propres conditions de produit et de canal. Avec l'API unifiée, le framework ou l'application choisie assure l'orchestration correspondante.Définir la configuration finale avec de vraies tâches
Choisissez des corrections de bugs, modifications multifichiers ou tâches d'outils récentes avec des critères d'acceptation explicites. Fournissez aux deux modèles la même version du code, les mêmes données et les mêmes autorisations d'outils.
Conservez quatre catégories de résultats par tâche : acceptation, totalité des frais de modèles et d'outils, temps du début à la livraison, puis interventions humaines et reprises. Pour les échecs qui méritent d'être poursuivis, augmentez le raisonnement ou changez de modèle en gardant les mêmes règles de nouvelle tentative.
Questions fréquentes
Que tester en premier avec un budget limité ?
Pour un résultat proche des configurations de programmation les plus poussées, commencez par Carbon medium. Si vos exigences le permettent, comparez aussi Fable medium : son coût et son score sont plus bas dans CursorBench. Vos propres critères d'acceptation tranchent.
Le prix supérieur de Fable le rend-il toujours meilleur en programmation ?
Fable est devant sur certaines évaluations de dépôt, mais Carbon est également très performant sur le CursorBench actuel. Choisissez selon la tâche, puis comparez livraison et reprises à différents niveaux.
Carbon coûte-t-il 75 % moins cher ?
Ses tarifs de base fournisseur pour l'entrée non mise en cache et la sortie sont inférieurs de 75 % au lancement et de 50 % ensuite. Ce rapport ne donne pas l'économie réelle par tâche et ne décrit pas directement les tarifs du compte EvoLink.
Régler les deux sur medium donne-t-il une comparaison équitable ?
Cela compare l'effet pratique de ces configurations, mais les noms identiques ne garantissent pas le même budget de calcul. Consignez ensemble modèle, outils, consommation, durée et acceptation.
Lequel est le plus rapide ?
Mesurez l'attente du premier token, la réponse complète et l'achèvement final sur le canal et aux niveaux prévus. Raisonnement, outils et reprises modifient le résultat.
Suffit-il de changer le nom du modèle ?
L'accès unifié réduit la configuration répétée des clients. Appels d'outils, raisonnement, formats des messages et erreurs nécessitent toujours des vérifications par modèle. Pour un transfert, transmettez les éléments utiles et reconstruisez les messages pour le modèle cible.
L'autre modèle peut-il directement relire du code ?
Commencez par une revue indépendante et exigez pour chaque problème un déclencheur et une preuve de reproduction. Même si les modèles sont d'accord, des tests restent nécessaires. Incluez le prix de la revue et le traitement des faux positifs dans le coût global.