
Kimi K3.1 Pro API-Preise: Token-Kosten, Cache-Gebühren und Rechenbeispiele
Vergleichen Sie die Token-Preise von Kimi K3.1 Pro und Highspeed: Cache-Schreibgebühren, Reasoning-Token sowie Kosten pro Anfrage und Monatsbudget.
 EvoLink Team
In diesem Artikel
Die Kosten einer Anfrage hängen von Eingabe, Ausgabe, Cache-Nutzung und Tools ab. Dieser Leitfaden erklärt die einzelnen Posten und zeigt, wie Sie eine Anfrage oder mehrere Tausend monatliche Aufrufe kalkulieren.
Was kostet die Kimi K3.1 Pro API bei EvoLink?
| Abrechnungsposten | K3.1 Pro Standard | K3.1 Pro Highspeed |
|---|---|---|
| Reguläre Eingabe | $2.00 | $4.00 |
| Ausgabe | $10.00 | $20.00 |
| Cache lesen | $0.20 | $0.20 |
| Cache schreiben: 5 Minuten | $2.00 | $4.00 |
| Cache schreiben: 1 Stunde | $4.00 | $8.00 |
Bei der Eingabe werden drei Kategorien unterschieden:
- Reguläre Eingabe: Inhalte, die zum regulären Eingabepreis abgerechnet werden.
- Cache-Lesezugriffe: Inhalte, die erfolgreich aus einem vorhandenen Cache wiederverwendet werden.
- Cache-Schreibvorgänge: Inhalte, die in den Cache geschrieben und entsprechend ihrer Gültigkeitsdauer berechnet werden.
Wie viel kostet eine einzelne API-Anfrage?
Kimi K3.1 Pro rechnet nach Token-Verbrauch ab, nicht zu einem festen Preis pro Anfrage. Eine kurze Frage, ein umfangreiches Dokument und eine Anfrage mit wiederverwendetem Kontext können sehr unterschiedliche Kosten verursachen.
Die folgenden drei Beispiele verwenden die oben genannten Preise:
| Nutzung pro Anfrage | Kosten Standard | Kosten Highspeed | Standard: 1.000 Anfragen |
|---|---|---|---|
| 2.000 reguläre Eingabe- + 1.000 Ausgabe-Token | $0.014 | $0.028 | $14 |
| 100.000 reguläre Eingabe- + 10.000 Ausgabe-Token | $0.30 | $0.60 | $300 |
| 100.000 Cache-Lese- + 1.000 reguläre Eingabe- + 2.000 Ausgabe-Token | $0.042 | $0.064 | $42 |
Kleine Anfrage: 0,014 US-Dollar bei Standard
Eine Anfrage mit 2.000 regulären Eingabe-Token und 1.000 erzeugten Ausgabe-Token kostet:
Regular input: 2,000 ÷ 1,000,000 × $2  = $0.004
Output:        1,000 ÷ 1,000,000 × $10 = $0.010

Total: $0.014Größere Anfrage: 0,30 US-Dollar bei Standard
Eine Anfrage mit 100.000 regulären Eingabe-Token und 10.000 erzeugten Ausgabe-Token kostet:
Regular input: 100,000 ÷ 1,000,000 × $2  = $0.20
Output:         10,000 ÷ 1,000,000 × $10 = $0.10

Total: $0.30Für ein Monatsbudget gruppieren Sie Anfragen nach ihrem typischen Verbrauch. Berechnen Sie die Kosten jeder Gruppe und multiplizieren Sie sie mit der erwarteten Anzahl an Anfragen.
Verdoppelt Highspeed die Kosten?
Die Preise für reguläre Eingaben, Ausgaben und Cache-Schreibvorgänge sind bei Highspeed doppelt so hoch wie bei Standard. Der Preis für Cache-Lesezugriffe bleibt unverändert.
Enthält eine Anfrage nur reguläre Eingaben und Ausgaben, verdoppeln sich bei identischem Verbrauch die Token-Kosten:
100,000 regular input + 10,000 output tokens

Standard:  $0.30
Highspeed: $0.60
Bei einer Anfrage, die überwiegend aus Cache-Lesezugriffen besteht, fällt der Unterschied kleiner aus:
100,000 cached input + 1,000 regular input + 2,000 output tokens

Standard:  $0.042
Highspeed: $0.064Diese Berechnungen halten den Token-Verbrauch konstant, um den Einfluss der Preise zu zeigen. Verwenden Sie bei tatsächlichen Aufrufen jeweils den gemeldeten Verbrauch zur Kostenberechnung.
Cache-Gebühren: erstes Schreiben und spätere Lesezugriffe
Bei Standard beträgt der Preis für Cache-Lesezugriffe ein Zehntel des regulären Eingabepreises. Das Anlegen des Caches verursacht jedoch eine eigene Schreibgebühr.
Betrachten wir eine Standard-Anfrage mit:
- einem wiederverwendbaren Präfix aus 100.000 Token, das erstmals in einen Cache mit fünf Minuten Gültigkeit geschrieben wird;
- weiteren 1.000 regulären Eingabe-Token;
- 2.000 berechneten Ausgabe-Token.
Die erste Anfrage kostet:
Cache write:   100,000 ÷ 1,000,000 × $2  = $0.200
Regular input:   1,000 ÷ 1,000,000 × $2  = $0.002
Output:          2,000 ÷ 1,000,000 × $10 = $0.020

First request total: $0.222
Verwendet eine spätere Anfrage diesen Cache mit 100.000 Token erfolgreich wieder, ergeben sich folgende Kosten:
Cache read:    100,000 ÷ 1,000,000 × $0.20 = $0.020
Regular input:   1,000 ÷ 1,000,000 × $2    = $0.002
Output:          2,000 ÷ 1,000,000 × $10   = $0.020

Subsequent request total: $0.042
Folgen auf das erste Schreiben neun Anfragen mit erfolgreichen Cache-Treffern:
Total for ten requests
= $0.222 + 9 × $0.042
= $0.60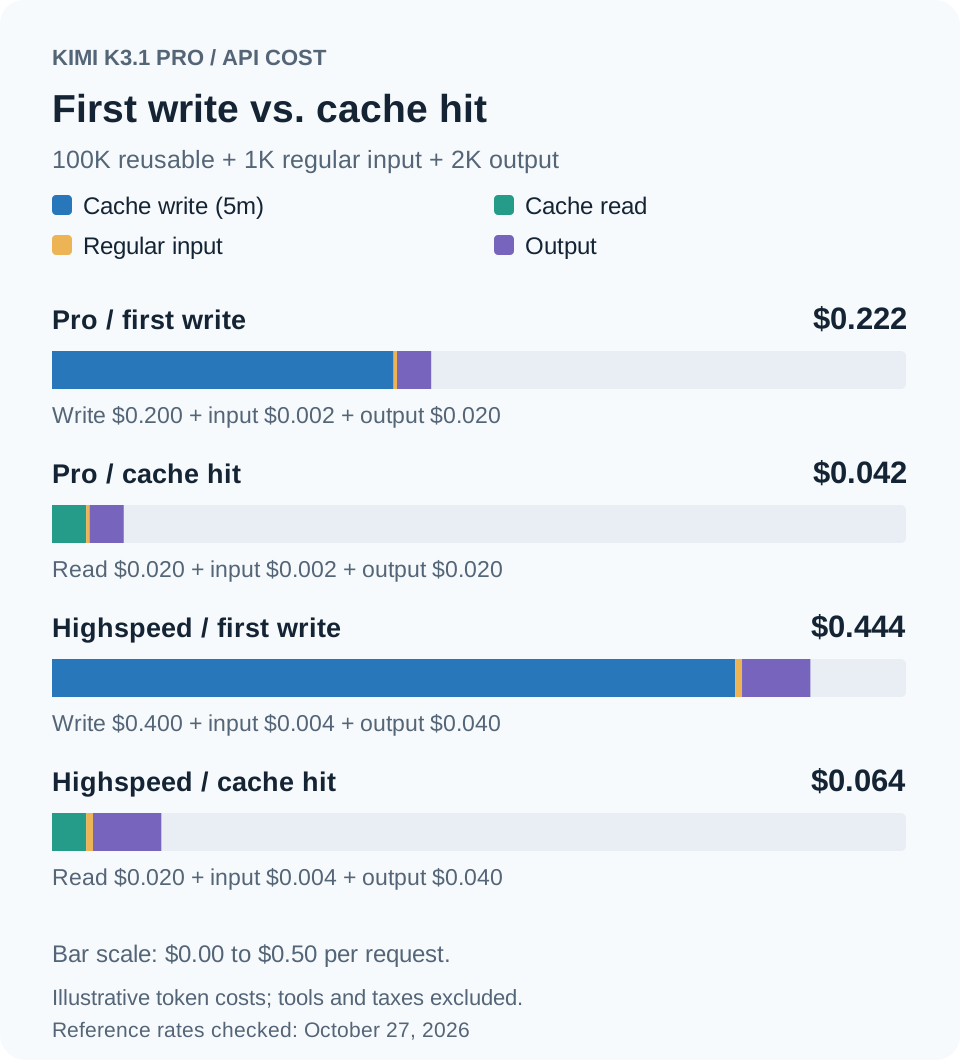
Fünf Minuten oder eine Stunde: Preise für Cache-Schreibvorgänge
Die Schreibpreise bei Standard betragen:
- Fünf Minuten: 2 US-Dollar pro Million Token.
- Eine Stunde: 4 US-Dollar pro Million Token.
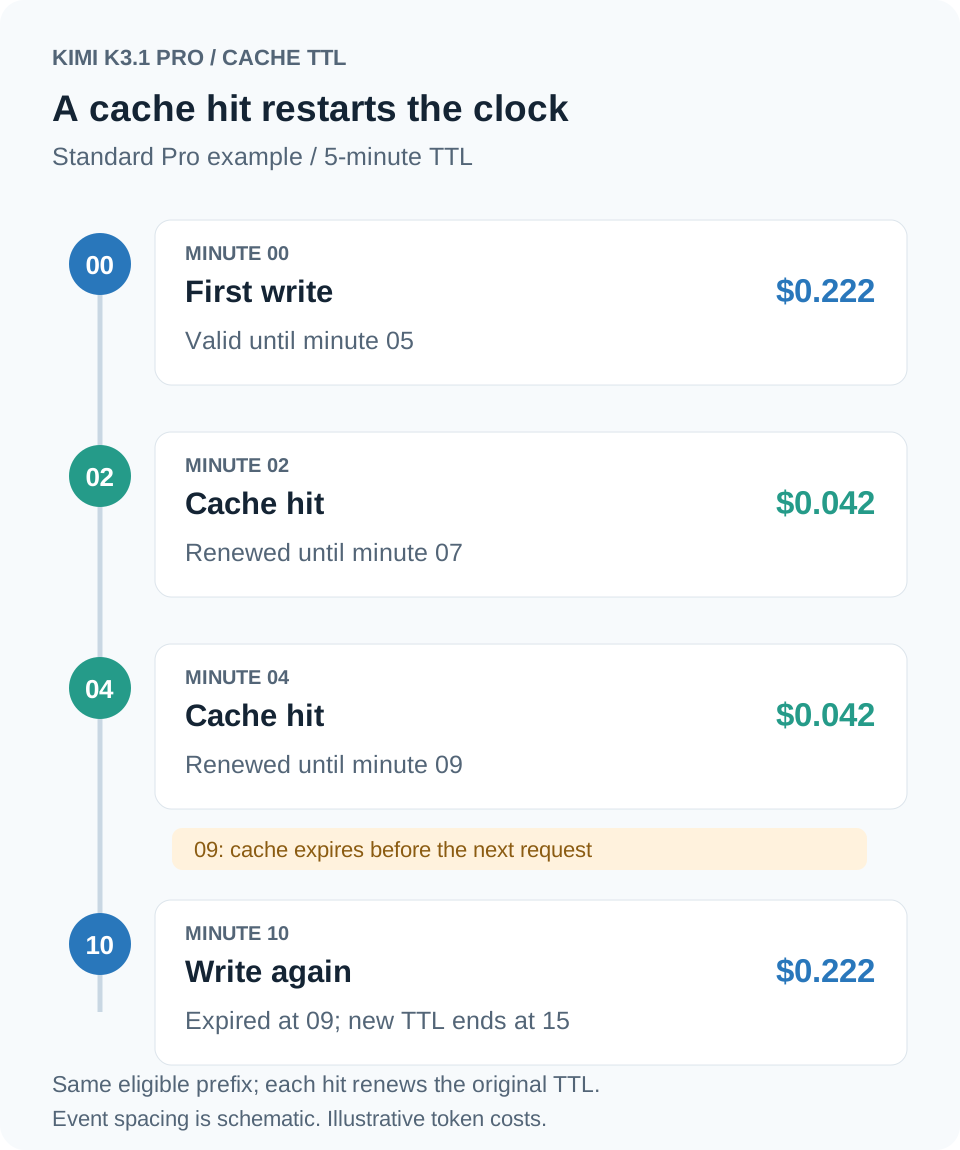
Anzahl und zeitlicher Abstand der Anfragen beeinflussen die wiederkehrenden Kosten. Zehn Anfragen mit erfolgreicher Cache-Wiederverwendung können andere Gesamtkosten ergeben als zehn Anfragen, die wiederholt erst nach Ablauf eintreffen.
Wie werden Reasoning-Token berechnet?
Beispielsweise meldet eine Anfrage insgesamt 10.000 berechnete Ausgabe-Token, bestehend aus:
- 9.000 Reasoning-Token;
- 1.000 Token für die endgültige Antwort.
Bei Standard kostet diese Ausgabe:
10,000 ÷ 1,000,000 × $10 = $0.10Die Reasoning-Token sind bereits in der Gesamtausgabe enthalten. Addieren Sie sie nicht ein zweites Mal. Verwenden Sie für die Kostenberechnung die von der API gemeldete gesamte berechnete Ausgabe.
Tool-Gebühren und Mindestgebühr
Drei kostenpflichtige Suchaufrufe ergeben:
3 × $0.005 = $0.015Addieren Sie Tool-Gebühren zu den Token-Gebühren des Modells. Suchergebnisse, die in eine nachfolgende Modellanfrage eingehen, können außerdem den Eingabeverbrauch erhöhen.
Token-Kosten mit Code berechnen
Dieses JavaScript-Beispiel nutzt die Referenzpreise von Standard. Ersetzen Sie die Token-Zahlen durch Ihren Verbrauch, um die entsprechenden Token-Kosten zu berechnen.
// Standard Pro reference rates checked on October 27, 2026.
// Input categories must not overlap.
const tokens = {
  regularInput: 1_000,
  cachedInput: 100_000,
  cacheWrite5m: 0,
  cacheWrite1h: 0,
  output: 2_000, // Includes billed reasoning tokens.
};

const ratePerMillion = {
  regularInput: 2,
  cachedInput: 0.2,
  cacheWrite5m: 2,
  cacheWrite1h: 4,
  output: 10,
};

const tokenCost = Object.entries(tokens).reduce(
  (total, [category, count]) =>
    total + (count * ratePerMillion[category]) / 1_000_000,
  0
);

console.log(`Estimated token cost: $${tokenCost.toFixed(6)}`);
// Estimated token cost: $0.042000ratePerMillion, wenn sich Ihre Kontopreise ändern.Häufige Fragen
Was kostet Kimi K3.1 Pro pro Token?
Zu den Basispreisen von Standard:
- Reguläre Eingabe: 0,000002 US-Dollar pro Token.
- Ausgabe: 0,00001 US-Dollar pro Token.
- Cache-Lesezugriffe: 0,0000002 US-Dollar pro Token.
Jede Kategorie hat ihren eigenen Preis. Die Kosten einer Anfrage hängen davon ab, wie viele Token je Kategorie berechnet werden.
Sind bei 90 % günstigeren Cache-Lesezugriffen auch Anfragen 90 % günstiger?
Nein. Die Reduktion um 90 % vergleicht den Preis für Cache-Lesezugriffe bei Standard mit dem regulären Eingabepreis. Ausgabe, Cache-Schreiben und Tools können weiterhin zu den Gesamtkosten beitragen.
Warum zeigen verschiedene Websites unterschiedliche Preise?
Prüfen Sie den genauen Modellnamen, die Variante Standard oder Highspeed, den Anbieter, die Währung, die Abrechnungseinheit und das Aktualisierungsdatum. Öffentliche Listenpreise, Kontorabatte und gewichtete Durchschnittspreise beschreiben ebenfalls unterschiedliche Größen.


