
Kimi K3.1 Pro im Test: Programmierung, 3D und Recherche
Kimi K3.1 Pro im Test: Codekorrekturen, Blender und CAD, Datenanalyse und Wartezeiten anhand öffentlicher Benchmarks und konkreter Aufgaben.
 EvoLink Team
In diesem Artikel
Öffentliche Tests von Kimi K3.1 Pro zeigen erfolgreiche Codekorrekturen und Datenanalysen, aber auch Lücken bei der Browserprüfung und einen Fehler bei der Gruppierung von Daten. Die offiziellen 3D-Beispiele von Moonshot AI ergänzen dieses Bild: Das Modell kann mit Blender- und CAD-Werkzeugen strukturierte Szenen und Objekte erstellen.
Für die Praxis stellen sich drei Fragen: Wie gut funktionieren die Ergebnisse, was muss geprüft werden und wie lange dauert es bis zur endgültigen Antwort? Die konkreten Ergebnisse von Artificial Analysis, Atomic Agent, PacBench und Plotly lassen sich dazu neben den offiziellen Beispielen von Moonshot AI betrachten.
Kimi K3.1 Pro im Test: Programmierung, Agenten und Reasoning
Die Veröffentlichungsauswertung von Artificial Analysis vom 23. Oktober 2026 umfasst Terminalaufgaben, SaaS-Workflows, Wissensarbeit und anspruchsvolle Denkaufgaben:
| Evaluation | Ergebnis von K3.1 Pro | Untersuchter Bereich |
|---|---|---|
| Terminal-Bench 4.0 | 67% | Programmier- und Bedienaufgaben in einer Terminalumgebung |
| AutomationBench-AA | 73% | Agenten bei der Ausführung von SaaS-Workflows |
| GDPval-AA | 1.846 Elo | Relative Leistung bei Arbeitsergebnissen aus der Wissensarbeit |
| Humanity’s Last Exam | 52% | Anspruchsvolle Wissens- und Denkaufgaben |
Die vier Evaluationen betrachten unterschiedliche Arten von Arbeit. Bei Terminal- und SaaS-Aufgaben handelt ein Agent innerhalb einer Umgebung; bei Wissensarbeit wird das erstellte Arbeitsergebnis beurteilt. Schwierige Fragen ergänzen eine weitere Dimension: trotz hoher Anforderungen an die Schlussfolgerung zur richtigen Antwort zu gelangen. Ein gutes Ergebnis in einer Kategorie kann mit Schwächen in anderen Teilen eines Workflows einhergehen.
Für Entwickler erklärt diese Unterscheidung, warum ein Programmierbenchmark und eine generierte Anwendung unterschiedliche Eindrücke vermitteln können. Eine Aufgabe in einem Repository zu lösen bedeutet, Dateien zu lesen, Änderungen vorzunehmen, Prüfungen auszuführen und Fehler einzuordnen. Eine interaktive Anwendung auszuliefern erfordert zusätzlich funktionierende Steuerung, Darstellung und das Verhalten nach dem Programmstart. Die folgenden Beispiele machen diese Unterschiede greifbar.
Programmierung: Codekorrekturen und längere Aufgaben
Low und max bei einer Python-Reparaturaufgabe
Atomic Agent testete ein Python-Paket mit fünf absichtlich eingebauten Fehlern und zwei fehlenden Funktionen: einer Abrechnungsfunktion und einem Kommandozeilenwerkzeug. Der Agent erhielt eine kurze Anweisung, die Aufgabendatei zu lesen, die Arbeit zu erledigen und die Tests bis zum erfolgreichen Abschluss auszuführen. Alle Durchläufe nutzten Atomic Agent v0.6.9 mit derselben Aufgabe und denselben Werkzeugen.
Jede Reasoning-Einstellung wurde dreimal ausgeführt, mit jeweils 32 verdeckten Assertions. Diese Prüfungen waren von den Tests getrennt, die der Agent während seiner Arbeit sehen konnte. Beide Einstellungen bestanden sämtliche Assertions:
| Einstellung | Bestandene Assertions aus drei Durchläufen | Durchschnittliche Dauer | Durchschnittliche Modellaufrufe |
|---|---|---|---|
| Low | 96/96 | 2,2 Minuten | 19 |
| Max | 96/96 | 4,9 Minuten | 28 |
Bei dieser Aufgabe war low effizienter. Aus den veröffentlichten Mittelwerten errechnet, dauerte max etwa 2,2-mal so lange und benötigte rund 47% mehr Modellaufrufe, bei gleichem Testergebnis.
Bei Codekorrekturen ist der fertige Patch der entscheidende Vergleichspunkt. Behebt er das gewünschte Verhalten, erhält er die öffentliche Schnittstelle und vermeidet er sachfremde Änderungen? Eine höhere Reasoning-Stufe lohnt sich, wenn sie diese Ergebnisse verbessert. Eine längere Erklärung oder mehr Werkzeugaufrufe beschreiben zunächst die Ausführung und ergeben für sich genommen keinen besseren Patch.
Bei einer langen Aufgabe die Diagnose ändern
Der Simulator basierte auf dem anatomischen Modell human-atlas mit 296 Skelett- und 402 Muskelkomponenten. Moonshot beschreibt, wie das Modell die Dynamik ohne geschlossenen Regelkreis untersuchte, um das Problem der Armbewegung einzugrenzen, bevor es die Berechnungen änderte und den Controller neu trainierte.
In einem gekoppelten System ist diese Reihenfolge bedeutsam. Ein Controller kann mit einer fehlerhaften Simulation trainiert werden, ebenso wie Anwendungscode an eine defekte Abhängigkeit oder eine fehlerhafte Testvorbereitung angepasst werden kann. Wiederholte Verbesserungen an der äußeren Schleife lassen den eigentlichen Defekt möglicherweise unberührt. Hier wechselte das Modell vom Trainingsziel zum Simulator, der die Trainingsumgebung bestimmte.
Sinnvoller Fortschritt bei längeren Programmieraufgaben umfasst deshalb auch einen Wechsel der Diagnose: eine Abhängigkeit lesen, eine numerische Annahme prüfen oder die ursprüngliche Erklärung nach einem neuen Ergebnis revidieren. Das Arbeitsergebnis sollte genügend Spuren enthalten – geänderte Dateien, Testbefehle und gemessene Ergebnisse –, damit andere Entwickler daran weiterarbeiten können.
Ein generiertes Spiel mit Lücken bei der Validierung
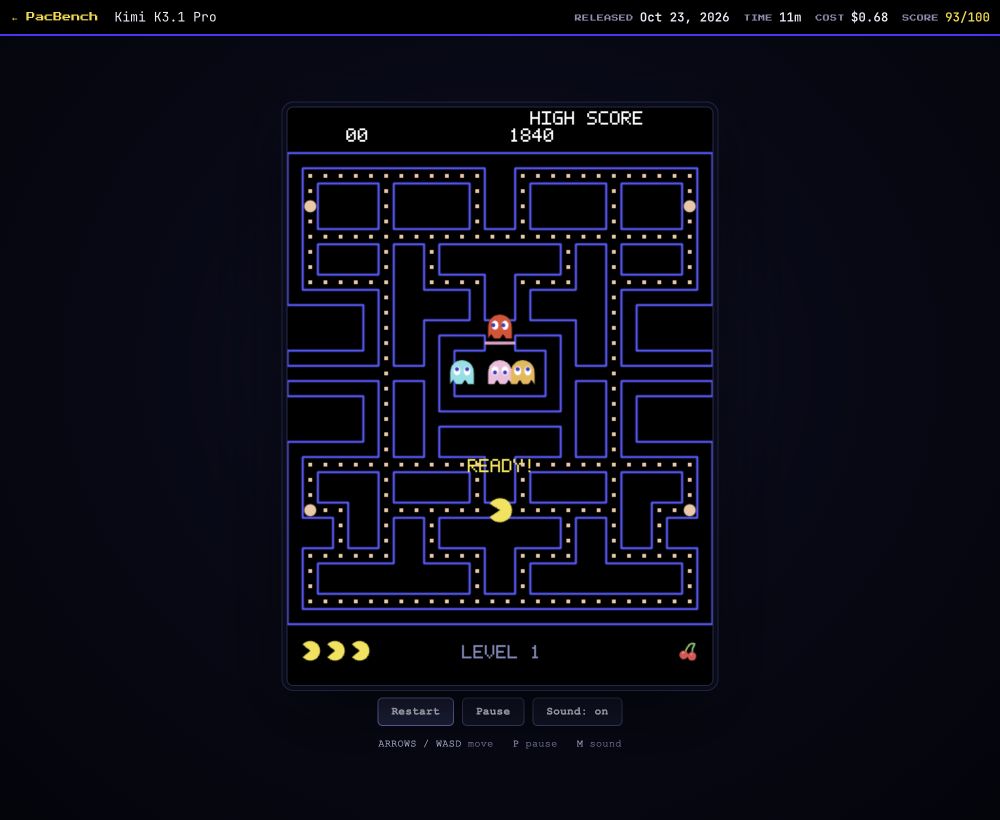
Der K3.1-Pro-Eintrag von PacBench verwendete high, umfasste 17 Modellantworten und dauerte etwa 11,5 Minuten. Das erzeugte Pac-Man-Spiel ist zusammen mit dem Ausführungsprotokoll öffentlich spielbar.
Der Evaluator hielt auch fest, was funktionierte: ein klassisches Labyrinth mit 28×31 Feldern, alle 244 Punkte erreichbar und keine blockierte Bewegung bei den getesteten Bildraten. Damit sind die verbleibenden Probleme aufschlussreicher als ein pauschales „funktioniert“ oder „funktioniert nicht“.
Es fehlte damit noch die Browserprüfung. Ein Ersatz in Node konnte Zustandswechsel des Spiels ausführen, doch Tastaturfokus und Audio im Hintergrund hängen vom Browser ab. Bei einem interaktiven Ergebnis sind die Prüfung der Gewinnbedingung und die Prüfung des tatsächlichen Spielerlebnisses eigenständige Teile des Abschlusses.
3D-Modellierung: Blender, CAD und Prüfung der Ergebnisse
Was der CAD-Benchmark rekonstruiert
Die Kennzahl Voxel IoU misst die geometrische Überlappung zwischen erzeugter Form und Referenzform im Voxelraum. Sie beschreibt Formähnlichkeit, nicht den Anteil produktionsreifer Assets. Die Aufgabe ähnelt eher der Rekonstruktion einer Objektstruktur als der Erzeugung eines überzeugenden Bildes davon.
Von der sichtbaren Form zum editierbaren Asset
Ein einzelnes Asset lässt sich auf drei Ebenen prüfen:
| Ebene | Was geprüft werden sollte |
|---|---|
| Gesamtform | Silhouette, Proportionen und räumliche Anordnung |
| Lokale Struktur | Verbindungen, Verdeckungen, Symmetrie und Details |
| Praktische Nutzung | Quelldateien, Maße, Topologie und Exportergebnisse |
Checkliste zur Asset-Prüfung: für diesen Artikel zusammengestellt.
Bei einem mechanischen Objekt ist etwa zu prüfen, ob verbundene Teile an den vorgesehenen Stellen zusammentreffen und ihre Beziehung bei einer Maßänderung erhalten bleibt. In einer Architekturszene sind wiederholte Bauteile, Öffnungen und die Anordnung der Räume relevant. So werden Überschneidungen und fehlende Verbindungen sichtbar, die eine einzelne Kameraansicht verbergen kann.
Auch das Lieferformat zählt. Eine Vorschau ermöglicht die Sichtprüfung, editierbare Dateien erlauben spätere Änderungen und ein Export unterstützt die Nutzung in einem anderen Werkzeug. Wer das gewünschte Format zu Beginn festlegt, kann eine gute Präsentation leichter von einem Asset unterscheiden, an dem andere tatsächlich weiterarbeiten können.
Datenanalyse: Plotlys Ergebnis von 42/43 und ein Gruppierungsfehler
Das Modell bestand 42 Fragen, darunter alle fünf Fragen zu verborgenen Mustern und alle drei zur Datenqualität.
Probleme erkennen, die nicht ausdrücklich in der Frage stehen
In den Datenqualitätsfällen erkannte K3.1 Pro laut Plotly doppelte Zeilen und den fehlenden letzten Tag eines Monats. Außerdem unterschied es stillgelegte Turbinen ohne Daten von Turbinen mit einer tatsächlichen Produktion von null. Das sind unterschiedliche Datenzustände, auch wenn eine einfache Aggregation sie ähnlich erscheinen lassen kann.
Die Fragen zu verborgenen Mustern verlangen zusätzlich, Beziehungen zu untersuchen, ohne genau vorgegeben zu bekommen, wonach gesucht werden soll. Das macht das Ergebnis für explorative Analysen relevant, bei denen die nächste Abfrage von den Erkenntnissen der vorherigen abhängt.
Wie ein kleiner Gruppierungsfehler die Antwort verändert
Damit ändert sich die verglichene Grundgesamtheit. „Nicht mit dieser Firmware“ und „mit einer anderen Firmware“ bezeichnen unterschiedliche Gruppen, wenn manche Datensätze überhaupt keine Firmware haben. Diese Datensätze hinzuzunehmen verändert die Vergleichsbasis bereits vor jedem statistischen Test.
Die Methode kann daher sorgfältig wirken, obwohl sich die beantwortete Frage bereits verschoben hat. Eine sinnvolle Prüfung beginnt bei der Grundgesamtheit: Welche Datensätze gelangten in welche Gruppe, welche wurden ausgeschlossen und was bedeutet ein fehlender Wert in diesem Datensatz? Danach folgen Berechnung und Text: Beschreibt die Erklärung die tatsächlich verwendeten Filter? Nur wenn die Gruppen zur fachlichen Definition passen, beantwortet die Rechnung die beabsichtigte Frage.
Finanzmodelle und Rechercheergebnisse
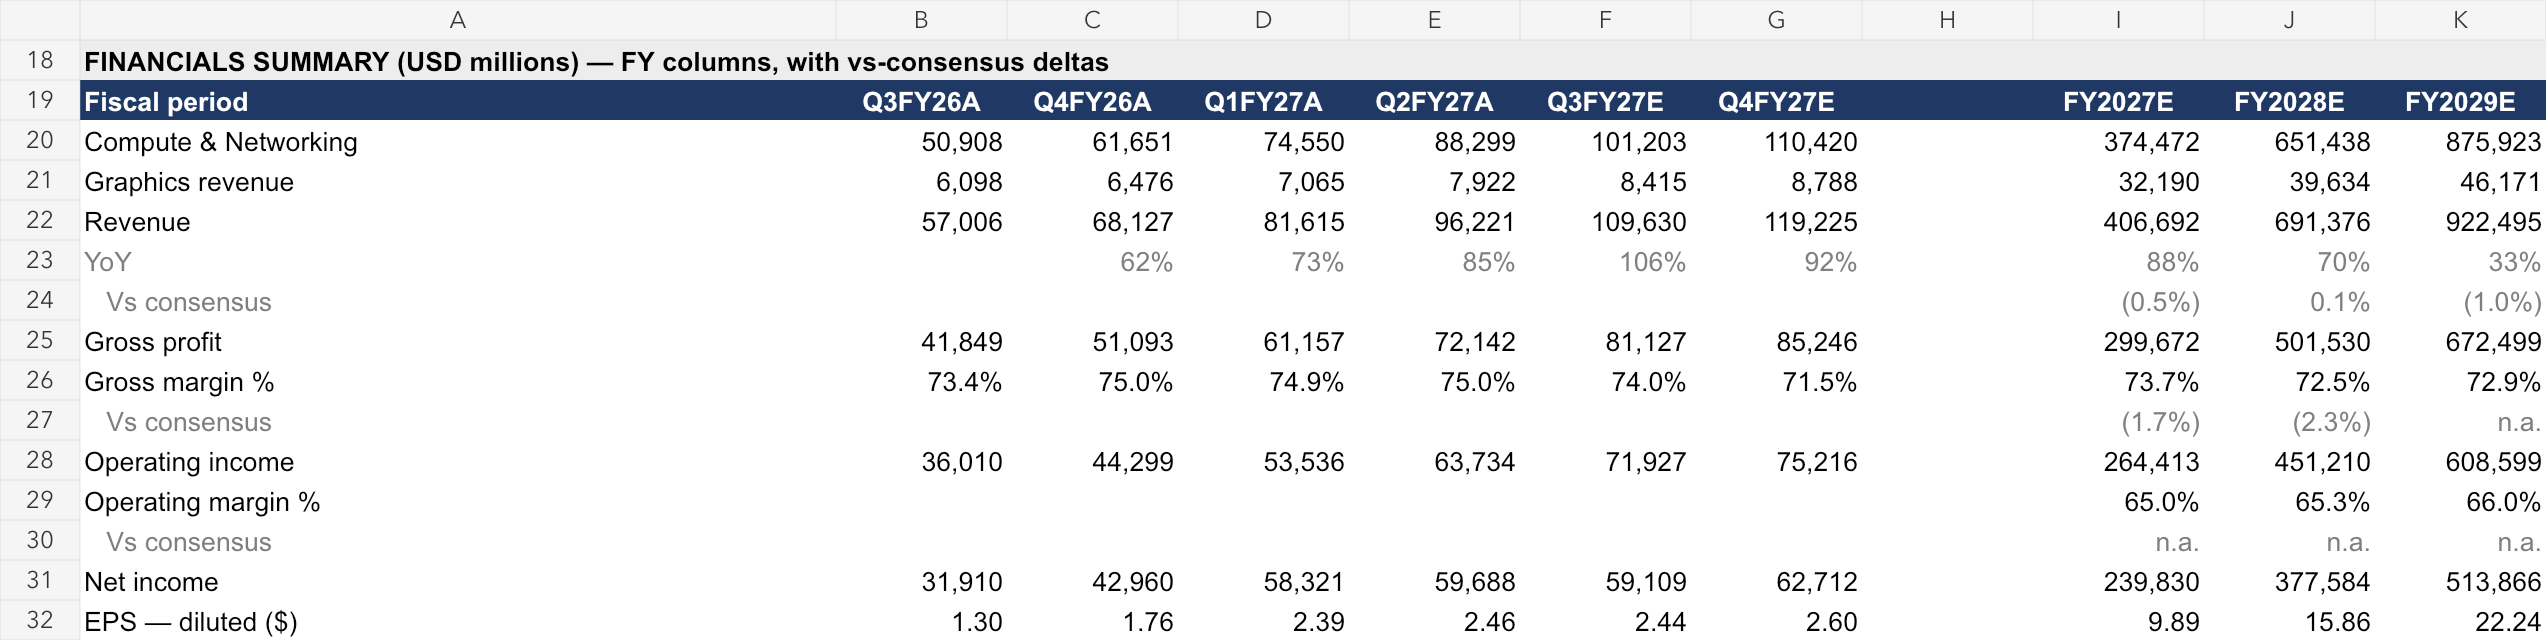
Der NVDA-Screenshot zeigt Quartals- und Jahresspalten sowie Umsatz, Gewinn, Margen und verwässertes Ergebnis je Aktie. Auf einer solchen Finanzübersichtsseite hängt der Nutzen davon ab, wie gut Leser die zentralen Zahlen mit den zugrunde liegenden Annahmen und unterstützenden Arbeitsblättern verbinden können.
Verfolgen Sie in einer Modellierungsarbeitsmappe eine Prognose von einer Annahme über die betreffenden Formelverweise bis zur Übersicht. Prüfen Sie die Übereinstimmung der Geschäftsjahresperioden und ob eine geänderte Annahme die vorgesehenen Ergebnisse aktualisiert. Bei einem Bericht oder einer Präsentation sollten wichtige Aussagen bis zur Quelle zurückverfolgt werden. Diagramme und schriftliche Schlussfolgerungen müssen dieselben Zeiträume und Definitionen verwenden.
Diese Dateien zeigen auch, warum Recherche mehr ist als eine lange Antwort. Eine Arbeitsmappe enthält numerische Abhängigkeiten, Folien brauchen eine klare Abfolge von Argumenten und ein Bericht benötigt nachvollziehbare Belege für seine Schlussfolgerungen. Zum Beitrag des Modells gehört, diese Zusammenhänge in einer Form zu organisieren, die andere prüfen und überarbeiten können.
Bild- und Videoverständnis: praktische Prüfungen
- Bei Diagrammen Werte, Einheiten und statistische Definitionen gemeinsam prüfen.
- Bei räumlichen Aufgaben Positionen und Beziehungen zwischen Objekten kontrollieren.
- Bei Videos Handlungsreihenfolge und Zustandsänderungen zwischen Bildern testen.
Diagramme verdeutlichen den Unterschied zwischen Ablesen und Interpretation. Zwei Werte zu extrahieren ist erst der Anfang, wenn eine Datenreihe eine andere Einheit, einen anderen Zeitraum oder eine andere Grundgesamtheit verwendet. Eine brauchbare Antwort muss jeden Wert der richtigen Achse, Legende und begleitenden Erklärung zuordnen.
content als Array von Nachrichtenbestandteilen; Bilder werden als base64 oder als Referenz auf hochgeladene Dateien übergeben. Der Leitfaden beschreibt die Videoverarbeitung anhand von Schlüsselbildern: Anzahl und Auflösung der Bilder beeinflussen den Eingabeumfang. Einzelheiten stehen im Leitfaden zu visuellen Eingaben.Wählen Sie für Videos Beispiele, deren Antwort von der Abfolge und nicht von einem Einzelbild abhängt: Was änderte sich vor einem Fehler, oder welche Handlung ging einer anderen voraus? Die hier besprochenen öffentlichen Tests betreffen vor allem Programmierung und Datenarbeit. Eine visuelle Anwendung braucht eigene Beispiele für die Ereignisse und Details, die sie erkennen muss.
Reasoning-Latenz: Warten auf die endgültige Antwort
Am 24. Oktober 2026 testete AIHubMix einen Prompt, der eine Hash-Map-Erklärung mit Python-Code verlangte. Standard Pro lief dreimal mit low. Die gemessene Wartezeit bis zum ersten Reasoning-Token unterschied sich deutlich von der bis zum ersten Token der endgültigen Antwort:
Wartezeit bis zum ersten Reasoning-Token und zur endgültigen Antwort
Standard Pro · ein Prompt · low · drei Durchläufe
- Erstes Reasoning-Token
- 3,6–4,5 s
- Erstes Token der endgültigen Antwort
- 71–91 s
Sekunden seit Beginn der Anfrage
Reasoning machte bei diesen Durchläufen etwa 85%–90% der Completion-Token aus; ein Durchlauf erreichte die Grenze von 8.192 Completion-Token. Eine Oberfläche, die nur die endgültige Antwort zeigt, kann deshalb untätig erscheinen, obwohl bereits Reasoning gestreamt wird.
Fortschritt im Stream und eine nutzbare Antwort
Drei Zeitpunkte beschreiben unterschiedliche Teile des Erlebnisses: Beginn des Streams, Beginn des endgültigen Antworttexts und Abschluss der Antwort. Auch eine funktionierende Verbindung kann Nutzer auf eine brauchbare Antwort warten lassen. Eine kurze Zeit bis zum ersten Token beschreibt deshalb nicht die gesamte Wartezeit.
Messen Sie bei einer interaktiven Anwendung alle drei Zeitpunkte mit den tatsächlichen Nutzerprompts. Erfassen Sie außerdem Reasoning-Stufe und Completion-Limit, um eine schnelle, aber abgeschnittene Ausgabe von einer vollständigen Antwort zu unterscheiden. Bei Hintergrundaufgaben können Ergebnisqualität und Gesamtdauer wichtiger sein als der Zeitpunkt, zu dem erstmals Text erscheint.
reasoning_content für Reasoning-Inkremente und content für Inkremente der endgültigen Antwort. Eine Anwendung kann dadurch den Bearbeitungsstatus von der Antwort trennen, die sie darstellt oder auswertet. Bei mehrstufigen Werkzeug-Workflows verlangt die Schnellstartanleitung außerdem, die vollständige assistant-Nachricht und die zugehörigen Werkzeugergebnisse aufzubewahren, statt nur den endgültigen Antworttext zu behalten.So hängt die Zeitmessung mit dem Agentenverhalten zusammen. Die Anwendung verwaltet eine fortlaufende Aufgabe mit Werkzeuganfragen, zurückgegebenen Beobachtungen und schließlich einer Antwort. Die Reasoning-Stufe ist dabei eine Stellgröße; Validierung und Nachrichtenverarbeitung entscheiden weiterhin darüber, ob das Ergebnis korrekt übergeben wird.
Für welche Aufgaben eignet sich Kimi K3.1 Pro?
Die Beispiele legen je nach Aufgabe unterschiedliche Schwerpunkte nahe:
| Fähigkeit | Was die Belege stützen | Verbleibende Grenzen |
|---|---|---|
| Programmierung und lange Aufgaben | Abgeschlossene Korrekturen und ausdauerndes Debugging | Zuverlässigkeit in größeren Projekten muss in der Zielumgebung geprüft werden |
| 3D und räumliches Denken | Werkzeuggestützter Aufbau von Szenen und Objekten | Formüberlappung belegt weder Topologie noch Exportqualität |
| Datenanalyse und Recherche | Gute Ergebnisse in Plotlys spezialisiertem Test | Gruppierungsregeln und Annahmen können weiterhin falsch sein |
| Visuelles Verständnis | Offizielle Unterstützung für Bild- und Videoeingaben | Diese Tests belegen keine Genauigkeit bei spezialisierten visuellen Aufgaben |
| Reasoning und Ausführung | Umfangreiches Reasoning und Werkzeugnutzung | Zusätzlicher Aufwand kann die Latenz erhöhen, ohne das gemessene Ergebnis zu verbessern |
Zusammenfassung der oben besprochenen Quellen.
Beginnen Sie mit einer Codekorrektur oder Datenanalyse, die sich bewerten lässt. Bewahren Sie bei einer Korrektur den ursprünglichen Fehlerfall auf und prüfen Sie den resultierenden Diff. Halten Sie für Analysen bekannte Antworten bereit und nehmen Sie fehlende oder besondere Zustände auf. Vereinbaren Sie bei einem 3D-Ergebnis Quell- und Exportformate vor der Vorschauprüfung.
Vergleichen Sie Ergebnisqualität, Ausführungszeit, Werkzeugaufrufe und Tokenverbrauch, bevor Sie zu weniger strukturierten Aufgaben übergehen. Atomics Vergleich von low und max, PacBenchs Browserlücke und Plotlys Gruppierungsfehler liefern jeweils konkrete Prüfpunkte. Gemeinsam verbinden sie die Evaluation mit der Arbeit, die das Modell tatsächlich übernehmen soll.
Häufige Fragen
Kann Kimi K3.1 Pro editierbare 3D-Modelle erstellen?
Sollte ich für Programmierung low oder max verwenden?
Vergleichen Sie beide zunächst mit einer repräsentativen Aufgabenauswahl. In Atomic Agents Python-Experiment bestanden beide Einstellungen dieselben Assertions. Low benötigte durchschnittlich 2,2 Minuten und 19 Aufrufe, max 4,9 Minuten und 28 Aufrufe. Erhöhen Sie die Stufe, wenn bessere Patches oder eine höhere Erfolgsquote den zusätzlichen Zeit- und Tokenaufwand rechtfertigen.
Warum streamt Kimi K3.1 Pro, ohne eine endgültige Antwort auszugeben?
Können Rechercheergebnisse nach Plotlys 42/43 direkt übernommen werden?
Das ist ein gutes Ergebnis auf Plotlys synthetischem Windparkdatensatz. Die verfehlte Firmwarefrage zeigt, warum Grundgesamtheit und Gruppierungsregeln weiterhin geprüft werden müssen. Kontrollieren Sie bei anderen Daten fehlende Werte, Zeiträume, Formeln und Quellen, bevor Sie die Schlussfolgerungen verwenden.


