Claude Fable 5.5とOpus 5.5の比較:切り替えの費用対効果

今の段階で何を比較できるか?
| 判断材料 | Opus 5.5の基準 | Fable 5.5の候補 |
|---|---|---|
| 識別情報とアクセス | 現在文書化されたルートを使い、アカウントを確認 | 確認した情報源では未確立 |
| タスク品質 | 自分の成功・失敗タスクで測定 | 検証済みの結果は掲載していない |
| 費用とレイテンシ | 実際の課金、再試行、経過時間を記録 | 呼び出せるルートを評価できるまで不明 |
| 本番での役割 | 要件を満たせば維持 | 未決定。バージョン番号は合格テストではない |
比較対象となる既存モデルも、すでに進歩している
xhigh、同じ表の他の多くの Opus 結果は max です。これは Opus 5.5 と Fable 5.1 のメーカー評価であり、Fable 5.5 の証拠でも EvoLink ルートの測定でもありません。Anthropic は本番用の安全機構を有効にしたことも明記しています。介入時にはサイバーセキュリティ課題が Opus 4.8、生物学や最先端 LLM 開発の課題が Opus 5 にフォールバックしました。結果はこの評価構成のもので、全課題を Opus 5.5 単体が実行した証明ではありません。medium、Fable 5.1 が high です。窓の大きさが同じでも情報を適切に取り出せるかは別です。初期値が違えば、設定を変えない比較は異なる動作条件を比較している可能性があります。将来 Fable 5.5 を評価する際は、独立課題数、全試行数、初回成功、最終成功を別々に記録します。一つの見出しの割合だけでは、初回応答が改善したのか、再試行後に解ける課題が増えたのかが分かりません。ルーティング判断では、実際の予算内で Opus がまだ解けない課題を特定してください。高価な候補が価値を示すべき対象はそこです。
切り替えに意味があるタスクを選ぶ
「どちらが賢いか」という大まかな質問では、本番の選択はほとんど決まりません。結果が改善すると業務上の価値が明確に得られるワークロードから始めてください。難しい例の改善に日常トラフィックの劣化が隠れないよう、通常のタスクも含めます。
| ワークロード | 成功の定義 | 記録すべき失敗 | 切り替えで問うこと |
|---|---|---|---|
| 複数ファイルのコード変更 | 必要なテストが通り、意図した動作に変わる | 部分的な修正、新しい回帰、存在しないAPI | レビューと修正の作業を減らせるか |
| 資料に基づく調査 | 主張が提供された根拠で裏付けられる | 根拠のない結論、制約の見落とし | 事実確認を増やさず、合格する回答を増やせるか |
| ツールを使うワークフロー | 正しい引数と意図した最終状態 | 誤ったツール、無効な引数、副作用の重複 | ワークフロー全体を安定して完了できるか |
| 日常的な構造化抽出 | スキーマとフィールド単位の検証を通る | 形式は正しいが値が誤っている | この量の処理で追加費用や遅延に見合うか |
これは推奨するタスク分類であり、どちらかのモデルがその機能に対応するという主張ではありません。ルート文書とリクエストで対応を確認してからテストしてください。
複数ファイルの推論とコンテキスト活用を直接試す
基準モデルと候補には同じテストケースを使います。これは提案するケースであってモデルの出力ではなく、数回の成功だけで普遍的な順位は決まりません。
アクセス確認後に条件を揃えて比較する
候補を実行する前に、期待結果を含むバージョン管理されたタスクセットを固定してください。Opusの成功と失敗の両方を含めます。既知の失敗だけを試すと、候補を魅力的に見せる一方で、何を壊すかを見落とします。プロンプト調整用の開発セットと、最終判断用の独立したテストセットを分けてください。
入力データ、ツール定義、ツール環境、採点基準を揃えます。正確なルートID、日付、リクエスト設定、プロンプトのバージョン、再試行方針を記録してください。同名の設定やeffortラベルがモデル間で同じ意味だと仮定してはいけません。各モデルで異なる対応設定が必要なら、それを開示し、同じ予算とレイテンシの制約内で設定全体を比較します。
出力が変動するタスクは繰り返します。可能なら、重要なケースはモデル名を伏せてレビューしてください。比率だけでなく件数と分母も示します。「20件中18件が合格」なら標本数も伝わります。判断が割れた記録を残し、小規模なリプレイを一般的な性能の主張に広げないでください。
API比較とClaude Codeのワークフロー比較を分ける
どちらも有用です。ワークフローの結果は、チームが実環境でより効率よく仕事を終えられるかに答えます。ただし、差のどの部分がモデル、コンテキスト構成、オーケストレーションに由来するかを切り分けるものではありません。周辺要素も実行間で変わったなら、改善をすべてFable 5.5に帰属させず、構成比較と明記してください。
合格タスク1件あたりの費用を比較する
Token単価はワークフロー費用の一部にすぎません。評価期間内の全試行について、失敗、再試行、ツール料金、適用されるキャッシュ料金を含む課金額を集計します。その後、同じ基準で合格したタスク数で割ります。
合格がゼロなら、有限の成功単価を報告しないでください。合格ゼロと総支出を示します。人によるレビュー時間は別に記録し、金額換算する場合は工数単価とその仮定を開示してください。
| 評価費用の明細 | 構成A | 構成B |
|---|---|---|
| 全試行の非キャッシュ入力料金 | $3 | $4 |
| 全試行の出力料金 | $5 | $6 |
| 全試行のキャッシュ読み書き料金 | $1 | $2 |
| 全試行の追加ツール料金 | $3 | $3 |
| 総料金 | $12 | $15 |
| 同じ12タスク中の合格数 | 8 | 12 |
| 合格タスク1件あたりの費用 | $1.50 | $1.25 |
各料金は一度だけ計上します。失敗や再試行はすでに項目別合計に含まれるため、別途「再試行費用」を足すと二重計上になります。ルートのusageフィールドでは入力総量の中にキャッシュTokenが含まれる場合があるので、実際の請求と照合してください。その総量に非キャッシュ単価を掛け、さらにキャッシュ料金を足してはいけません。
この例では構成Bの評価総額は高いものの、合格1件あたりは安くなります。それでも厳格なレイテンシ上限を超えたり重大なエラーを起こしたりすれば不適切です。ウォームキャッシュの結果で初回費用を隠さないよう、コールドスタートと同一コンテキストの再実行を分けてください。
| 単一リクエストのトークン構成 | Opus 5.5 | Fable 5.1 | Fable / Opus の費用比 |
|---|---|---|---|
| 非キャッシュ入力 100,000、キャッシュ読み取りなし、出力 2,000 | $0.4400 | $1.1000 | 2.50× |
| 非キャッシュ入力 10,000、キャッシュ読み取り 90,000、出力 2,000 | $0.0980 | $0.2225 | 2.27× |
| 非キャッシュ入力 10,000、キャッシュ読み取り 900,000、出力 2,000 | $0.2600 | $0.4250 | 1.63× |
(10,000 × 4 + 90,000 × 0.20 + 2,000 × 20) / 1,000,000 = $0.098 です。長い履歴がキャッシュにある例では比率が縮まりますが、Fable の方が安くなるわけではなく、キャッシュ作成費用も含みません。実際にはモデルごとにトークン消費量も変わり得ます。請求総額を単純に 2.5 倍するのではなく、実際のリクエスト構成と適用される EvoLink ルート料金で再計算してください。C を再試行込みの提出課題あたり平均 API・ツール総費用、p をその課題の検収合格率とすると、合格課題あたり API 費用は C / p です。費用倍率が r = C_candidate / C_Opus の候補がこれを下げる条件は p_candidate > r × p_Opus。基準の合格率が 80%、候補の課題費用を仮に 1.5 倍とすると、120% 超の合格率が必要になり、API 費用だけの指標では達成不能です。人の作業や高損失の失敗を十分減らせるなら採用価値はあり得ますが、その便益は別途評価します。全 Opus リクエストの置き換えより、特定課題のみ上位モデルへ送る方が合理的な場合がある理由です。Fableをadvisorだけに使うと安くなるか?
同じタスクで3構成を比較します。現在のOpusワークフロー、文書化され利用可能な組み合わせのOpusとadvisor、そして確認後に限り候補を主モデルにした構成です。いずれも主モデル呼び出し、相談、ツール料金、再試行、最終合否を含む全体を集計します。
維持、一部タスクの切り替え、全面置き換えを判断する
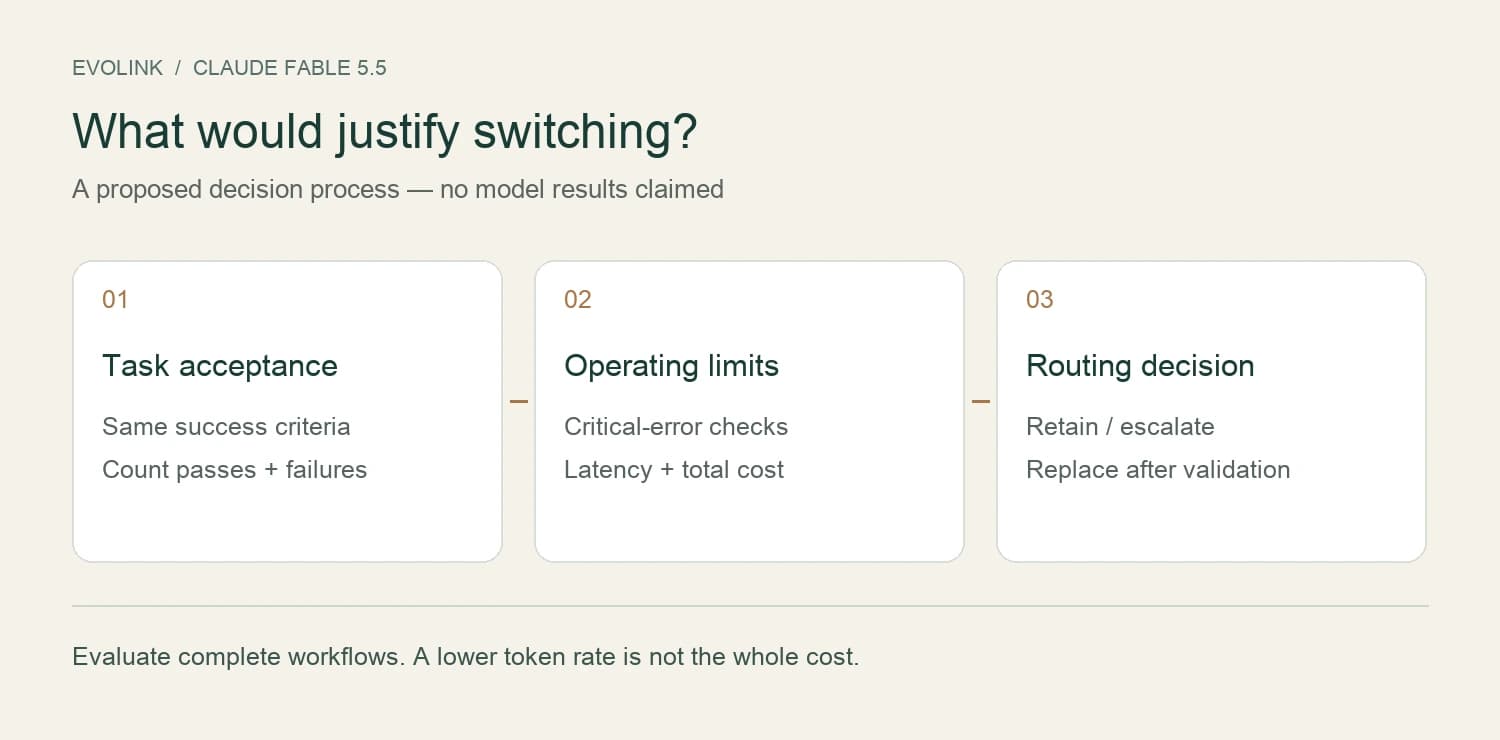
候補の結果を見る前に合格基準を設定します。基準はアプリケーションの特性を反映すべきです。平均品質が改善しても重大なツールエラー1件で展開を見送る場合があります。許容する最大レイテンシと支出、判定が割れた出力の決定者を定めてください。
- Opusを維持: 要件を満たし、候補が有用な改善をまだ示していない場合。
- 選んだタスクのみ切り替え: 検証済みの候補が識別可能な難しいタスク群に有効でも、他では不要な費用や遅延を加える場合。分類ミスで利益が失われるため、振り分けルール自体もテストします。
- 既定モデルを置き換え: 代表的なトラフィックで品質、重大エラー、レイテンシ、費用の要件を満たし、フォールバックを検証した場合のみ。
EvoLinkの統合ゲートウェイは共通の接続面でモデル選択を管理できますが、モデルの動作が互換になるわけではありません。ルートごとの仕様を確認してください。アクセス検証までは候補を未設定にし、範囲を限定した展開をレビューしてからトラフィックを増やします。
よくある質問
Fable 5.5はOpus 5.5より優れていますか?
ここには検証済みの直接比較はありません。確認した情報源ではFable 5.5の識別情報、アクセス、動作が未確認のため、優劣は確立できません。
Opus 5.5を既定のままにすべきですか?
要件を満たす既定モデルは、検証済みの代替が自社評価に合格するまで維持してください。判断はワークロードの成果、レイテンシ、総費用に依存します。
大きそうなモデル名や新しいバージョンならコード能力も上ですか?
いいえ。期待する変更と回帰チェックを明示したリポジトリ課題を使ってください。名前だけでは自社コードで成功するとは判断できません。
両モデルのeffort設定は同じにすべきですか?
文書化された設定に意味のある比較可能性がある場合に限ります。そうでなければ、それぞれの対応構成を記録し、違いを説明したうえで同じ運用制約内で比較してください。
Token料金だけで決められますか?
いいえ。再試行、出力長、ツール、キャッシュ動作、失敗タスクで総額は変わります。同じ成功定義で合格1件あたりの実際の課金額を比べます。
候補が難しいタスクだけで勝った場合は?
アクセスと動作の確認後、選択的な切り替えを検討してください。どのリクエストを切り替えるかの判定費用と誤りも含めます。
EvoLinkの性能ベンチマークですか?
いいえ。この記事ではFable 5.5の認証付き呼び出しを行っていません。タスク表、手順、計算例は評価の補助であり、モデルの実測結果ではありません。
公開状況はどこで確認できますか?
情報源と対象範囲
- Anthropicモデル概要:文書化されたモデルの案内と識別情報の確認。
- Anthropicニュース:公開の根拠の確認。
- EvoLink Opus 5.5:現在の製品と料金の参照先。
- Claude Code advisor文書:advisorのコンテキスト、追加使用量、キャッシュ動作。Fable 5.5対応の根拠ではありません。