Gemini 4 Neon vs Claude Opus 5.5 pour le code et le coût
Comparez Neon et Opus 5.5 à partir de tests publics dans un même éditeur et avec leurs agents. Décidez quand changer grâce au coût par correctif validé.
 EvoLink TeamÉquipe produit
Dans cet article
high sur les tâches de programmation fréquentes couvertes par des tests automatisés. Gardez Claude Opus 5.5 comme référence pour les flux de travail déjà rodés dans votre dépôt. Neon présente des résultats compétitifs sur les modifications multi-fichiers et des tarifs standard d’entrée et de sortie plus bas. Avant de changer, mesurez le taux de validation au premier essai, le temps de revue et la prise en charge de vos outils. CursorBench 4.1 · Tarifs Google · Tarifs AnthropicComparer Gemini 4 Neon et Claude Opus 5.5 dans votre environnement
| Configuration actuelle | Quoi tester | Critère de décision |
|---|---|---|
| Les deux modèles sont disponibles dans le même éditeur | Changer de modèle en gardant éditeur, outils et processus de revue | Correctifs validés, coût total et interventions humaines |
| L’équipe utilise surtout Claude Code | Comparer les ensembles Claude Code avec Opus et Antigravity avec Neon | Instructions du dépôt, permissions et passages de relais |
| L’application appelle les modèles par API | Garder la même tâche, les outils autorisés et la même validation | Appels d’outils corrects, correctif valide et reprise en cas d’échec |
| La configuration gère des migrations rares et risquées | Rejouer un cas avec Neon ou tester sur une branche isolée | Compatibilité et volume de retouches manuelles |
Ce que mesurent les deux évaluations de programmation
xhigh avec Antigravity CLI obtient 59 points pour 6,86 $US par tâche, contre 58 points et 12,61 $US pour Opus 5.5 max dans Claude Code. Les scores arrondis concernent chaque couple modèle-outil. CursorBench 4.1 propose un autre angle dans le même éditeur. Évaluation d’Artificial Analysis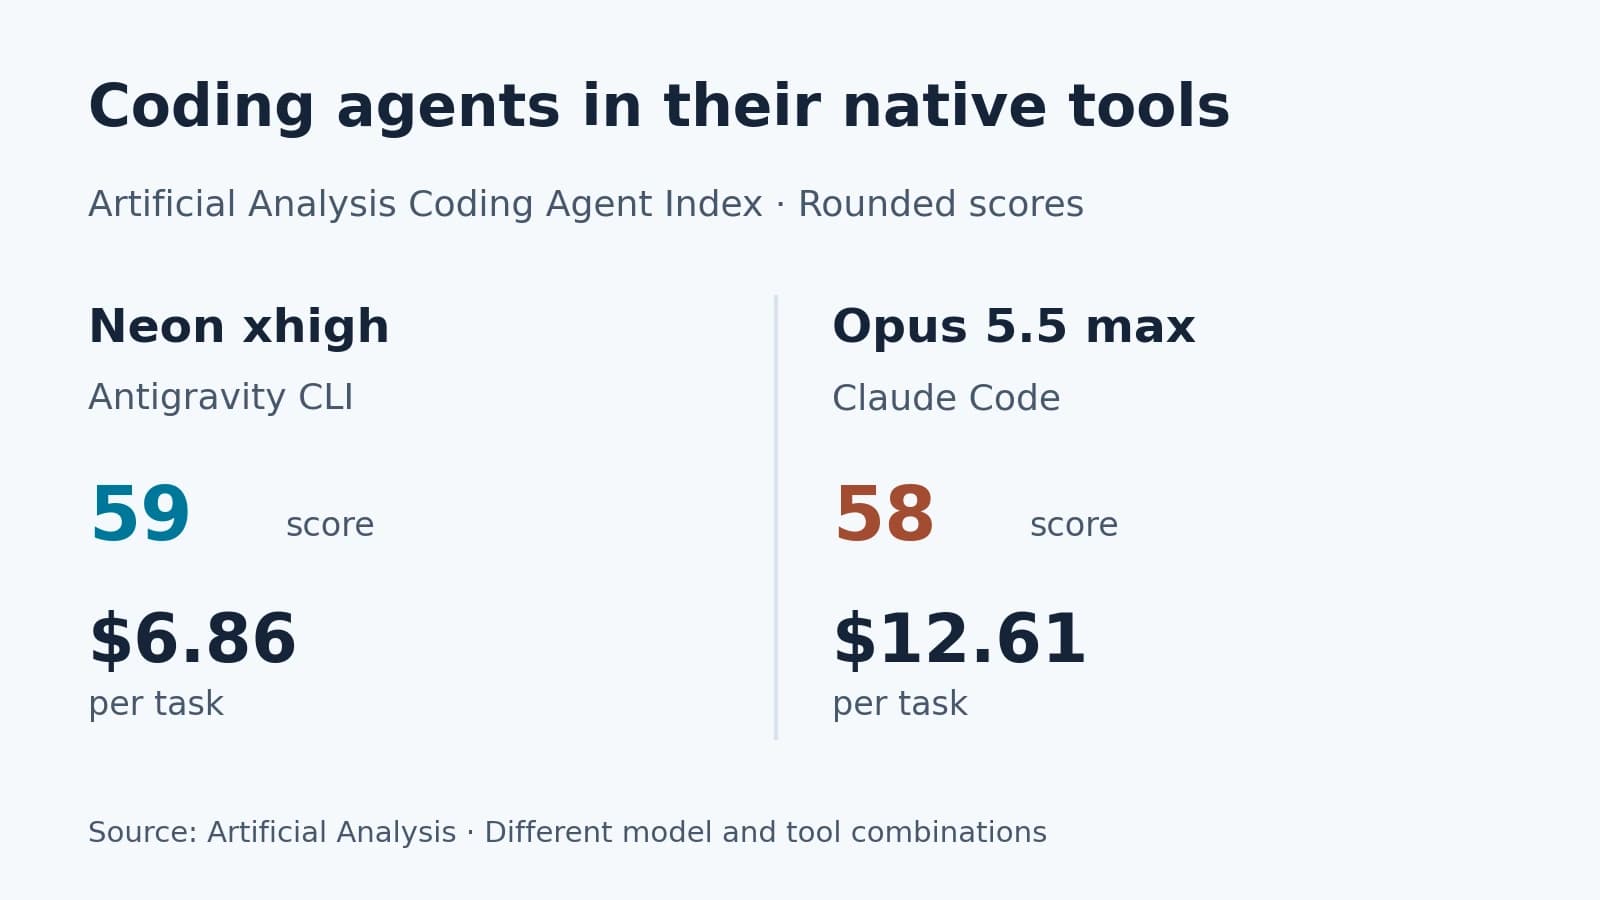
| Configuration CursorBench 4.1 | Score | Coût par tâche affiché |
|---|---|---|
Neon medium | 57,7 % | 3,07 $US |
Opus 5.5 high | 54,5 % | 3,87 $US |
Neon high | 63,7 % | 6,54 $US |
Opus 5.5 xhigh | 56,7 % | 6,54 $US |
Neon xhigh | 65,4 % | 10,67 $US |
Opus 5.5 max | 58,1 % | 11,88 $US |
high constitue un bon premier essai. Dans l’évaluation publiée par Google, Opus garde une légère avance sur Terminal-Bench 4.1 et FrontierCode 2.0. Si votre équipe travaille surtout sur du débogage complexe en terminal ou sur des changements de dépôt prêts à fusionner, incluez ce type de tâche dans votre test. Les benchmarks aident à choisir les cas, vos critères de validation à choisir le modèle. Chiffres de CursorBench vérifiés le 19 novembre 2026. CursorBench · Évaluation Google DeepMindQuel effet l’environnement d’exécution de l’agent a-t-il sur les scores ?
| Configuration SWE-sweep | Neon | Opus 5.5 |
|---|---|---|
| Framework propre à chaque fournisseur | 39,0 % | 10,1 % |
| Framework mini-SWE commun | 12,8 % | 3,6 % |

Les scores et l’écart entre les modèles changent avec l’environnement. Selon Google, Antigravity CLI peut répartir la recherche dans le dépôt entre plusieurs sous-agents, ce qui convient à la détection de bogues dans un test comme SWE-sweep. Pour changer de modèle, gardez si possible le même environnement d’exécution. Pour choisir un autre IDE, comparez les deux chaînes d’outils avec des permissions et un périmètre identiques. Comptez le temps de prise en main et de revue.
Calculer le coût par correctif validé
Dans cet exemple chiffré de 100 tâches de programmation, les totaux incluent les tentatives ratées et les relances.
| Route | Dépense API totale | Correctifs validés | Coût API par correctif validé |
|---|---|---|---|
| Neon | 45 $US | 75 | 0,60 $US |
| Opus 5.5 | 60 $US | 90 | 0,67 $US |
| Neon, avec moins de validations | 45 $US | 65 | 0,69 $US |
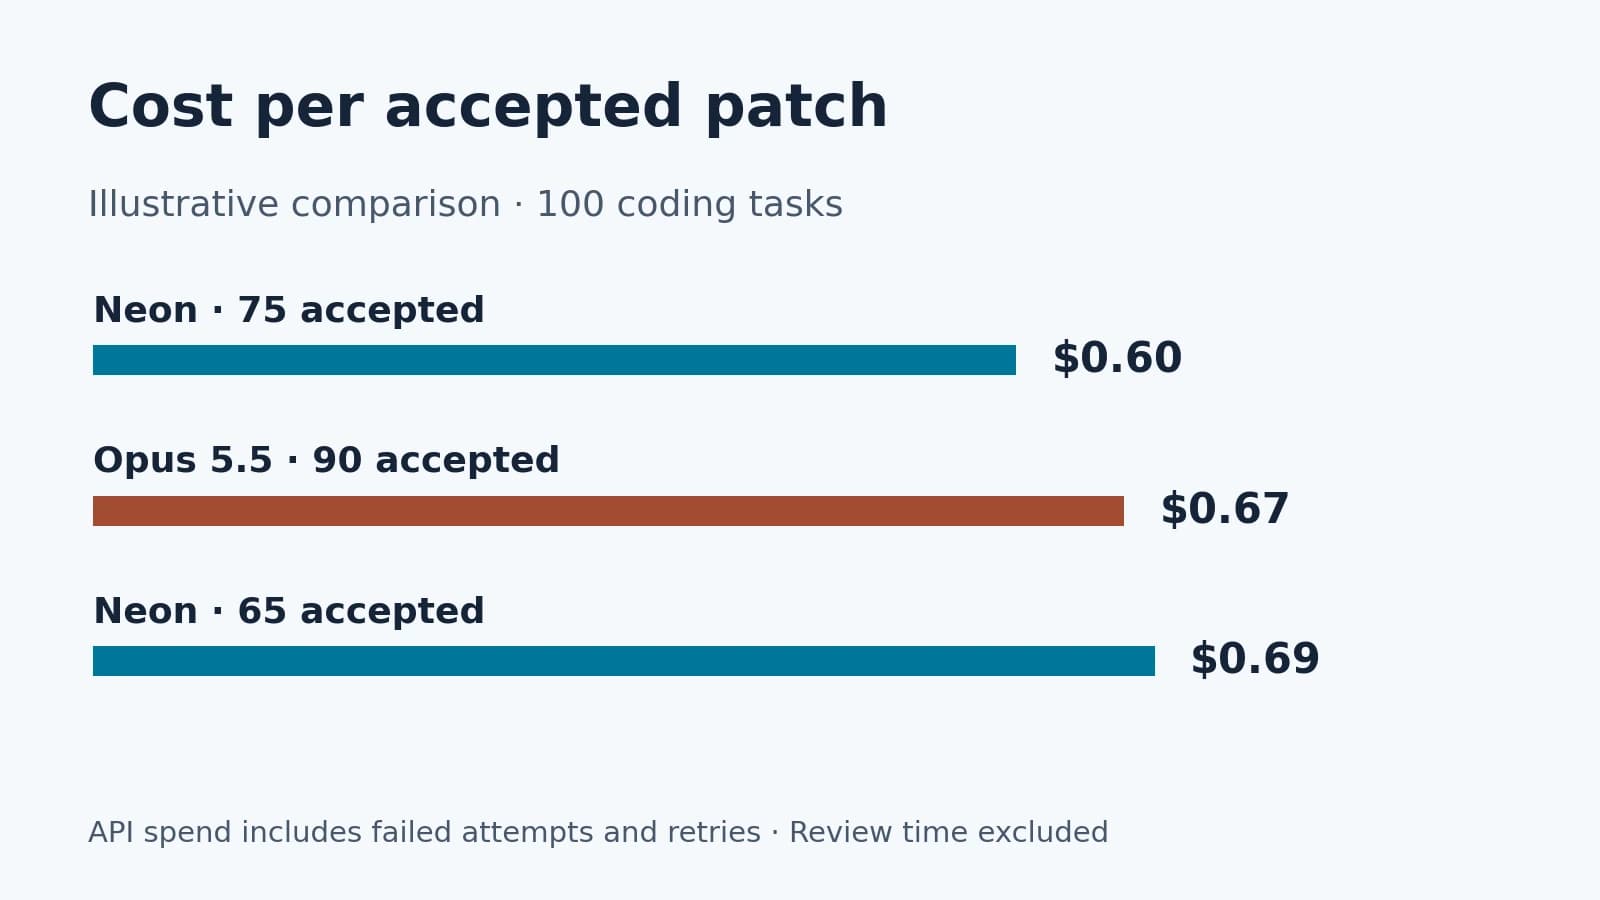
Avec la même dépense de 45 $US pour Neon, une baisse du taux de validation peut rendre chaque correctif validé plus cher qu’avec Opus 5.5. Ajoutez le temps de revue et de reprise manuelle au coût de l’API. Oublier une exigence de compatibilité sur une interface partagée peut coûter davantage que l’appel lui-même.
Vérifier l’intégration avant de changer de fournisseur
high par défaut. Le raisonnement adaptatif d’Opus 5.5 utilise medium par défaut. Comparez les réglages explicites et les valeurs par défaut que vous déploieriez. Un même nom de niveau peut correspondre à des quantités de calcul différentes. Guide développeur Neon · Documentation Anthropic| Point d’intégration | Gemini 4 Neon | Claude Opus 5.5 |
|---|---|---|
| Sortie longue via l’API native | Limite synchrone par défaut de 65 536 jetons pour le raisonnement et la sortie. Génération longue sur les interfaces compatibles | Anthropic indique 128K jetons de sortie au maximum |
| Cache | Accès implicites, au tarif standard de 0,15 $US par million de jetons en cache | Lecture à 0,20 $US, écriture à 5 $US pour cinq minutes ou 8 $US pour une heure, par million de jetons |
| État des outils sur plusieurs tours | Conserver le contexte d’interaction ou les signatures de raisonnement Google selon l’API | Respecter le format de résultats d’outils et de raisonnement de Claude Messages |
Concevoir un test qui aide à décider du changement
Prenez une catégorie récurrente de tickets, par exemple un test intermittent avec une procédure de reproduction. Donnez aux agents la même branche, la même description, le même accès aux outils, le même délai et la même commande de test. Isolez les essais et examinez les diffs avec une grille commune, idéalement sans connaître le modèle.
Fixer les critères d’acceptation avant de lire les correctifs
Choisissez quelques tickets représentatifs dont le résultat se mesure. Fixez la révision, le fichier de verrouillage des dépendances, les instructions du dépôt, les outils et les règles d’arrêt. Dans Claude Code, identifiez les hooks et commandes qui contribuent à un bon résultat. Pour isoler l’effet du modèle, reproduisez ces vérifications dans un exécuteur de tests indépendant.
| Critère | Vérification concrète |
|---|---|
| Fonctionnement | Reproduire le défaut avant la modification et réussir le test cible après |
| Compatibilité | Les exemples existants passent encore et les anciennes entrées ou les clients conservent le comportement voulu |
| Périmètre | Le correctif reste dans les limites du ticket et les vérifications générales restent actives |
| Reprise | Si un outil s’arrête, l’agent décrit l’état incomplet et évite de répéter une action à effet de bord |
Gardez une ligne par ticket initial, avec le résultat au premier essai et à la fin, le temps jusqu’au diff révisable, les jetons facturés et les minutes de revue. Si le deuxième essai résout le problème, comptez les deux et notez si la personne qui a vérifié a apporté une nouvelle information. Le coût de la reprise aide à décider quels tickets restent sur Opus et lesquels passer à Neon.
Questions fréquentes
Neon code-t-il mieux qu’Opus 5.5 ?
Neon devance Opus dans les configurations CursorBench citées. Opus garde l’avantage sur certains tests de terminal et de dépôt. Prenez le test le plus proche de vos tâches.
Neon est-il moins cher ?
Ses prix standard d’entrée et de sortie sont inférieurs de 25 %. Le coût par tâche validée dépend de la consommation, du cache, des relances et de la revue.
Faut-il comparer les deux au niveau maximal ?
Ajoutez cet essai pour les cas difficiles. Pour le trafic courant, comparez les configurations compatibles avec votre budget et votre délai.
Peut-on comparer les modèles sans changer d’éditeur ?
Oui si le même éditeur propose les deux modèles et les fonctions requises. Cela stabilise une variable importante.
Peut-on changer le nom du modèle d’un agent en cours d’exécution ?
Vérifiez d’abord l’intégration. Les messages d’outil, le paramétrage du raisonnement et la gestion de l’état varient selon les API.
Sur quelle tâche commencer ?
Choisissez un ticket récurrent, reproductible, avec des critères de validation clairs. Le résultat vous aidera à sélectionner la route pour le prochain ticket de ce type.