OpenAI Agents API vs Agents SDK: Kontrolle und Migration

Agents API vs Agents SDK vs Responses: Was ändert sich?
| Entscheidung | Agents API | Agents SDK | Responses API direkt |
|---|---|---|---|
| Wer betreibt die Orchestrierung? | OpenAIs verwalteter Dienst | Deine Anwendung mit SDK | Deine Anwendung oder Workflow-Engine |
| Wo wird fortgesetzte Arbeit abgebildet? | Verwaltete Sitzungen mit Zuordnung zum Geschäftsauftrag | Gewählte Sitzungs- und Zustandsintegration | Workflow-Datensatz plus genutzte API-Zustandsfunktionen |
| Wie laufen Geschäftswerkzeuge? | Anwendungshandler führen Funktionswerkzeuge weiterhin aus | SDK-Werkzeuge sind in Anwendungscode integriert | Eigener Dispatcher übernimmt clientseitige Werkzeugarbeit |
| Was ist der zentrale Kompromiss? | Weniger Laufzeitbetrieb, externe Dienstgrenze | Laufzeitkontrolle und Deployment-Verantwortung | Direkte Komposition und explizite Workflow-Verantwortung |
| Was überlebt einen Laufzeitwechsel? | Nur das, was außerhalb des Dienstes portabel gehalten wird | Unabhängige Geschäftsdatensätze und Adapter | Beibehaltene Geschäftsdatensätze und Workflow-Verträge |
Die letzte Zeile ist eine Architekturempfehlung. Kein Produktname garantiert Portabilität. Eine Werkzeugimplementierung kann wiederverwendbar sein, während ausstehende Aufrufe, Freigabestatus und Ergebnisformat angepasst werden müssen.
Ersetzt Agents API LangGraph oder dein bestehendes Framework?
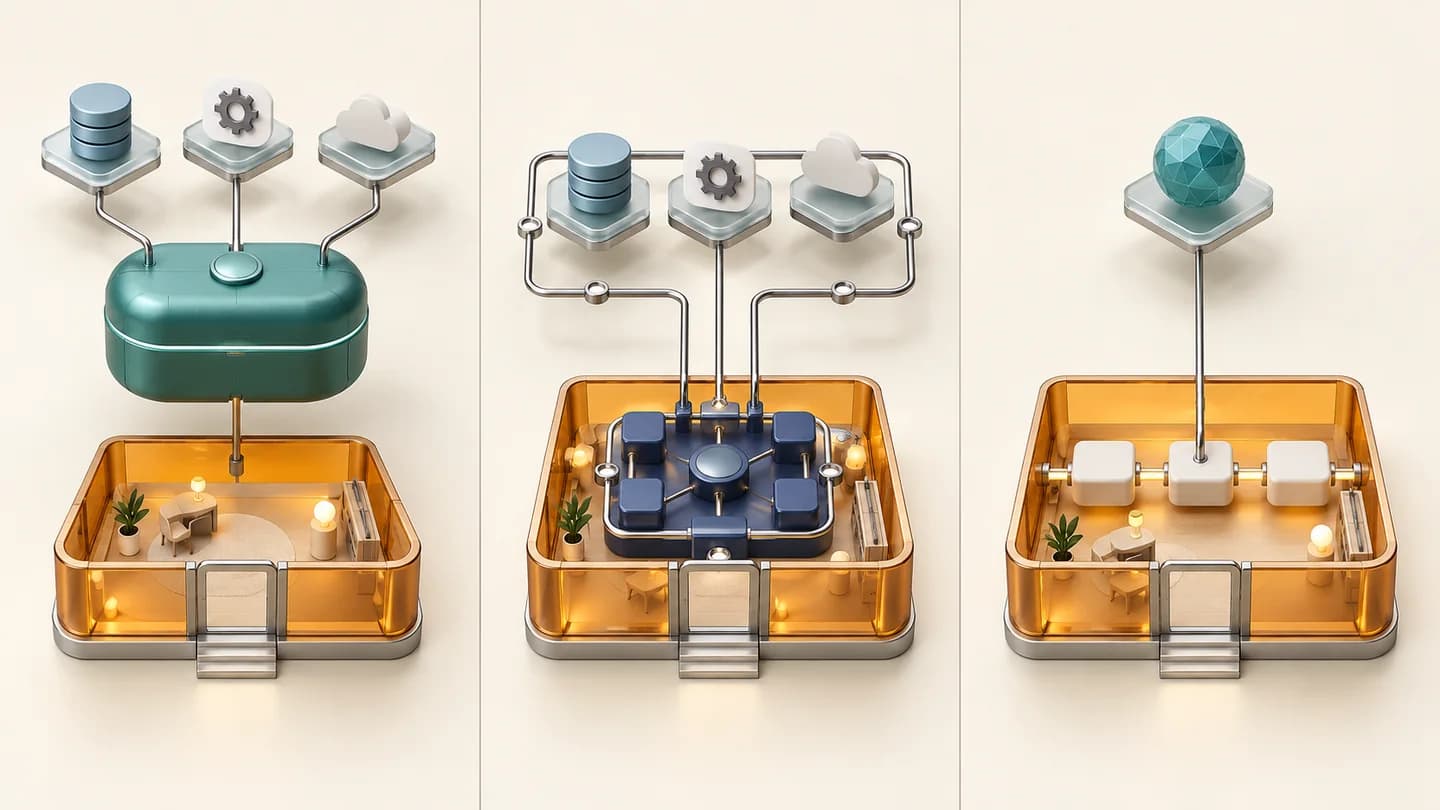
Das hängt davon ab, welche Aufgaben das Framework im Produkt erfüllt. Wartet es hauptsächlich eine allgemeine Modell-Werkzeug-Schleife, kann eine verwaltete Laufzeit viel davon übernehmen. Kodiert es Geschäftsabläufe, Freigabeübergänge, Fristen und dauerhaften Fachzustand, brauchen diese Verantwortlichkeiten weiterhin einen Eigentümer.
Ein Versicherungsdokument-Workflow könnte Informationen extrahieren, auf eine berechtigte Prüfung warten und das freigegebene Ergebnis weiterleiten. Der Analyseschritt kann die Laufzeit wechseln, ohne die Freigabeberechtigung zu verändern. Den ganzen Workflow wegen eines verwalteten Ausführungsschritts zu ersetzen vermischt Geschäftsregeln mit Infrastrukturwahl.
Ordne jede bestehende Komponente als Geschäftsregel, Ausführungsmechanik oder Integrationsadapter ein. Prüfe anschließend, welche Mechanik der Dienst tatsächlich ersetzt. Das ergibt eine bessere Aufwandsschätzung als ein Vergleich der Codezeilen zweier Quickstarts.
Auch ein Hybrid ist sinnvoll: Ein deterministischer äußerer Workflow delegiert eine begrenzte Untersuchung an Agents API. Definiere Eingabe, erwartete Belege und Rückkehrbedingung für diesen Schritt. Vermeide, dass äußerer Workflow und innere Laufzeit unabhängig dieselbe externe Schreibaktion wiederholen.
Damit ist weder behauptet, bestimmte Frameworks hätten keine verwalteten Funktionen, noch dass eines veraltet sei. Entscheidend sind die Verantwortlichkeiten in deiner Implementierung, keine allgemeine Rangliste.
Sitzungen, Gedächtnis und Freigaben sind verschiedene Zustände
RunState. Der Unterschied ist, wer diese Mechanismen bereitstellt und betreibt, nicht ob Gedächtnis oder Freigaben existieren.Trenne bei einem Assistenten zur Erstattungsprüfung drei Arten von Datensätzen:
| Datensatz | Beispielinhalt | Warum ein Gespräch nicht genügt |
|---|---|---|
| Arbeitskontext | Gesammelte Belege und Erklärungsvorschlag | Unterstützt Schlussfolgerungen, ersetzt aber keinen Berechtigungsnachweis |
| Ausführungszustand | Aktueller Lauf, ausstehender Werkzeugaufruf, Fortsetzungsreferenz | Legt den Wiederaufnahmepunkt fest |
| Geschäftszustand | Kunde, vorgeschlagener Betrag, Prüfer, finale Transaktions-ID | Belegt Erlaubnis und tatsächliches Ergebnis |
Das sind vorgeschlagene Anwendungsdatensätze, keine drei vorgeschriebenen Tabellen und kein OpenAI-Schema. Ein fortgesetzter Lauf soll zuerst klären, ob die Aktion weiterhin erlaubt ist. Eine zwischenzeitliche Stornierung darf durch Wiederaufnahme keine alte Berechtigung reaktivieren.
Ordne verwaltete Sitzungen einem Geschäftsauftrag zu. Beim SDK legst du Speicherort und Worker-Zugriff für Sitzungen und pausierte Läufe fest. Bei direkten Responses definierst du die entsprechende Fortsetzung im vorhandenen Workflow. Teste in allen Fällen einen Prozessneustart während einer Freigabe; eine In-Memory-Demo beweist keine Wiederherstellung.
Ist eine private Sandbox ein selbst gehosteter Agent?
Zeichne den tatsächlichen Datenweg auf. Unterscheide Datenbankabfrage, zurückgegebene Zeilen, an das Modell gesendetes Werkzeugergebnis und gespeicherten Debug-Trace. Eine Datenbank in der VPC bedeutet nicht, dass deren Abfrageergebnis die VPC nie verlässt.
Was bedeutet freie Modellwahl für die Architektur?
Trenne Modellschnittstelle und Laufzeitschnittstelle. Ein Gateway mit mehreren Modellen erleichtert die Modellwahl, vereinheitlicht aber nicht automatisch Sitzungslebenszyklen und Werkzeugprotokolle aller Anbieter.
Prüfe in zwei Stufen: Zuerst Laufzeiten möglichst mit gleichem Modell, gleichen Werkzeugen, Daten und Abnahmeregeln vergleichen. Dann Modelle innerhalb der gewählten Architektur untersuchen. Braucht ein Kandidat andere Modelle oder Werkzeuge, benenne es als Gesamtsystemvergleich; schreibe nicht jede Verbesserung der Laufzeit zu.
Bei SDK-Routen sind Nachrichten, Werkzeugargumente und -ergebnisse, strukturierte Ausgabe, Streaming, Verbrauchsdaten und Fehlerbehandlung des Adapters zu verifizieren. Eine Textantwort belegt keine Eignung für werkzeugintensive Agenten. Die Anbieterflexibilität des SDK bedeutet nicht, dass Agents API beliebige Gateway-Modelle unterstützt.
Eine sinnvolle Fallback-Grenze ist häufig ein neuer Geschäftsauftrag. Dieser kann mit frischem Ausführungsdatensatz an eine geprüfte Alternative gehen. Eine laufende Sitzung umzuziehen erfordert bewusste Zustandskonvertierung und Replay-Regeln; eine andere Base URL ersetzt das nicht.
Nach Aufgabe wählen – einschließlich Beibehaltung der bestehenden Lösung
| Aufgabe und Ausgangslage | Erster Kandidat | Begründung | Was würde die Entscheidung ändern? |
|---|---|---|---|
| Kleines Team, unterschiedlich lange Recherchen, wenig bestehende Orchestrierung | Agents API | Laufzeitbetrieb wäre erhebliche neue Arbeit | Unvereinbare Datenverarbeitungsgrenzen oder kein Qualitäts-/Betriebsvorteil |
| Produkt mit eigenen Freigabepfaden und Workern | Agents SDK | Ausführung bleibt nahe an vorhandenen Kontrollen | Worker- und Zustandsbetrieb überwiegen den Kontrollgewinn |
| Zuverlässige Workflow-Engine mit wenigen festen Modellschritten | Responses direkt | Bestehenden Zustandsautomaten nutzen | Adaptive Schleife erforderlich, die das Team nicht wirtschaftlich warten kann |
| Dateiintensive Arbeit auf spezieller interner Rechenumgebung | SDK oder verwaltete API mit eigener Umgebung | Beide gegen die reale Infrastruktur prüfen | Verbindung, Isolation oder Abrufweg nicht erfüllbar |
| Mehrere unabhängige Beweissammlungen | Verwaltete oder SDK-Orchestrierung | Parallelität kann den kritischen Pfad verkürzen | Zusammenführung, Doppelarbeit oder Prüfung heben den Vorteil auf |
Wiederherstellung dort testen, wo doppelte Aktionen entstehen können
Nutze ein nichtproduktives Ticketszenario: Problem untersuchen und nach Freigabe genau ein Ticket erstellen. Unterbrich den Client, nachdem das Zielsystem das Ticket angenommen hat, aber bevor die Anwendung das Werkzeugergebnis gespeichert hat. Das ist vorgeschlagene Fehlerinjektion, kein gemeldeter Anbieterdefekt.
Bestanden ist das Szenario erst, wenn die Anwendung die Existenz des Tickets erklären, ein Duplikat vermeiden und die Aufgabe in bekanntem Zustand fortsetzen oder beenden kann. Mehrdeutige Ergebnisse gehen zur Prüfung. Blindes Wiederholen kann eine scheinbar robuste Demo im Betrieb unzuverlässiger machen.
Kosten je akzeptiertem Ergebnis statt nur Token vergleichen
Erfasse direkte Kosten je abgenommenem Ergebnis und Engineering-Aufwand separat. Fehlversuche, Werkzeuge, Umgebungen und Nacharbeit gehören dazu. Eine Laufzeit kann den Betriebsaufwand senken und gleichzeitig die API-Rechnung erhöhen – oder umgekehrt. Dieser Unterschied muss sichtbar bleiben.
Auch Migration muss sich amortisieren. Angenommen, Integration und Validierung kosten intern geschätzte 1.200 USD; später verifiziert der stabile Betrieb 0,04 USD Ersparnis je akzeptierter Aufgabe. Ohne Berücksichtigung wiederkehrender Unterschiede im Betriebsaufwand sind 30.000 akzeptierte Aufgaben nötig. Ersetze diese hypothetischen Werte durch eigene Daten. Wird dieses Volumen nicht erreicht, rechtfertigt die kleine Stückersparnis den Wechsel möglicherweise nicht.
Vergleiche Latenz mit gleichen Messpunkten: erster Fortschritt, abgenommenes Artefakt und manuelle Prüfzeit. Ein erstes Streaming-Token ist kein vollständig geprüfter Bericht. Bei Umgebungen gehören Einrichtung und Aufräumen neben der aktiven Verarbeitung dazu; erst so werden Kaltstarts oder lange Wartezeiten sichtbar.
Trace-Export hilft bei der Diagnose, ersetzt aber kein Geschäfts-Audit
Ein exportierter Trace und ein akzeptiertes Geschäftsergebnis beantworten dennoch verschiedene Fragen. Verknüpfe im Ticketszenario Geschäftsauftrag, Laufzeit-Trace, Werkzeugaufruf und Zielticket. Eine unbeteiligte prüfende Person sollte erklären können, warum das Ticket erstellt wurde und ob dies erlaubt war. Mehr exportierte Spans allein schließen eine fehlende Beweiskette nicht.
Halte Modell-/Werkzeugbeobachtungen und abgerechnete Gebühren bis zum Abgleich getrennt. Ein Dashboard-Screenshot belegt keine endgültigen Stückkosten; ein protokollierter Werkzeugaufruf beweist keinen gespeicherten Zielsystemeffekt.
Migration mit einer echten Rückkehrgrenze
- Ausgangsbasis einfrieren. Fixtures, Werkzeugversionen, Abnahmekriterien und aktuelle Ergebnisse sichern. Lange Aufgabe, mehrdeutige Eingabe, Freigabepause und fehlgeschlagene externe Aktion einschließen.
- Paarweise testen. Möglichst gleiche Modelle und Budgets verwenden; Unterschiede protokollieren. Bei variablen Aufgaben mehrere Versuche behalten und Stichprobengröße statt nur Bestleistung nennen.
- Nur lesend im Schattenbetrieb prüfen. Der Vergleichsagent darf weder Nachrichten senden noch Schreibaktionen duplizieren. Für beide gelten dieselben Abnahmeregeln.
- Neue Aufgaben schrittweise zuweisen. Laufzeit bei Auftragsbeginn wählen und bis zum Ende beibehalten. Keine laufende Aufgabe zwischen unsynchronisierten Controllern teilen.
- Bewusst zurückrollen. Neue Aufträge zurück zur Ausgangslösung leiten. Laufende Aufträge entweder in der bisherigen Laufzeit abschließen oder Wirkungen und Artefakte abgleichen, bevor Ersatz startet. Übergangsbelege aufbewahren.
Schwellenwerte vor den Ergebnissen festlegen. Qualität muss bestehende Produktanforderungen erfüllen. Unberechtigte Schreibaktionen und doppelte Nebenwirkungen blockieren die Einführung. Kosten- und Zeitbudgets ergeben sich aus der Geschäftsaufgabe. Ein universelles „95 Prozent sind produktionsreif“ ersetzt das nicht.
Migrationsbeispiel: Supportablauf behalten, Untersuchung austauschen
Eine SDK-Anwendung nimmt ein Supportproblem auf, sammelt Kontobelege, wartet auf Freigabe und erstellt ein Ticket. Ein sinnvoller erster Wechsel ersetzt nur die Beweissammlung. Die verwaltete Aufgabe liefert Entwurf und Referenzen; Freigabe und Erstellung bleiben in der Anwendung. Das ist ein Architekturvorschlag, kein getestetes Migrationsergebnis.
| Bestehende Komponente | Behalten oder anpassen? | Konkrete Arbeit |
|---|---|---|
| Identität, Kontoberechtigungen, Ticketschema | Fachvertrag behalten | Dieselben erlaubten Datensätze und Pflichtfelder bereitstellen |
| SDK-Untersuchungsrunner | Im Pilotschritt ersetzen | Verwaltete Sitzung starten und dem bestehenden Auftrag zuordnen |
| Werkzeugimplementierungen | Bei passendem Vertrag wiederverwenden, Dispatch anpassen | Argumente/Ergebnisse übersetzen, Berechtigungen erhalten und Fehler protokollieren |
Ausstehende Freigabe und gespeicherter RunState | Laufende Aufträge beim bisherigen Eigentümer lassen | Alten Lauf abschließen oder abgleichen; serialisierten Zustand nicht als Sitzungsimport behandeln |
| Fortschrittsanzeige und Endergebnis | Zuordnung zur Oberfläche anpassen | Untersuchung, prüfbarer Entwurf und tatsächlich erstelltes Ticket unterscheiden |
| Trace- und Abrechnungsdatensätze | Neue Referenzen ergänzen | Kandidatenlauf mit derselben Aufgabe, dem abgenommenen Ergebnis und dem Kostenbuch verknüpfen |
Der erste Pilot darf bei „Entwurf zur Prüfung bereit“ enden. Nicht alle Workflow-Teile müssen gleichzeitig umziehen. Verbessert sich die Untersuchung, aber verschlechtert sich die Wiederherstellung während der Freigabe, behalte den Freigabepfad und grenze die Migration enger ein.
RunState enthält ausstehende Arbeit und Entscheidungen, aber seine Deserialisierung authentifiziert den Absender nicht. Speichere ihn unter Anwendungskontrolle, prüfe die Berechtigung der prüfenden Person für die ausstehende Aktion und koordiniere die Fortsetzung, damit eine Freigabe nicht zweimal verbraucht wird. Diese Arbeit bleibt auch bei anderer Untersuchungslaufzeit bestehen.Häufige Fragen
Macht Agents API bestehende Frameworks überflüssig?
Sie kann allgemeine Laufzeitmechanik ersetzen. Geschäftsregeln, Freigabeübergänge und Fachzustand brauchen weiter Verantwortliche. Bewerte Komponenten statt Framework-Namen.
Ist Agents SDK zustandslos?
Nein. Dokumentiert sind Sitzungen und persistente Implementierungen. Bereitstellung und Speicher betreibt weiterhin deine Anwendung.
Bleiben menschliche Freigaben mit dem SDK möglich?
Ja, dokumentiert sind unterbrochene Läufe und fortsetzbarer Zustand. Prüfe Neustarts und geänderte Berechtigungen im eigenen Deployment, nicht nur im Arbeitsspeicher.
Macht eigene Recheninfrastruktur Agents API ZDR-fähig?
Laut aktueller Dokumentation nein. Auch SDK-Alternativen brauchen eine Prüfung des gesamten Datenwegs; lokale Orchestrierung garantiert keine Aufbewahrungsbedingungen.
Genügt eine andere Base URL zum Laufzeitwechsel?
Davon solltest du nicht ausgehen. Werkzeuge können wiederverwendbar sein, Sitzungen, ausstehende Aufrufe, Zustand und Ergebnisse brauchen jedoch Adapter und Tests.
Welche Option ist am günstigsten?
Vergleiche dasselbe akzeptierte Geschäftsergebnis mit Fehlern und Nacharbeit sowie Migrations- und Betriebsaufwand. Die obige Rechnung ist hypothetisch, kein Siegerurteil.
Lassen sich Agents-API-Traces exportieren?
Die aktuellen offiziellen Dokumente beschreiben den Export im Format OTLP JSON. Plane die Verbindung zum Monitoring und prüfe die EvoLink-Startdokumentation auf den verfügbaren Integrationsweg.
Kann ich Agents API heute über EvoLink nutzen?
Quellen und Geltungsbereich
Primärdokumentation steht an den technischen Aussagen. HN und Reddit liefern nur die API-/SDK- und Framework-Fragen. Aufgaben, Rechnungen und Einführungsempfehlungen sind redaktionelle Vorschläge. Dieser Artikel behauptet weder einen kontrollierten Benchmark noch universelle Einsparungen oder produktiv verifizierte Gateway-Kompatibilität.