Claude Fable 5.5 vs Opus 5.5: Wann lohnt sich der Wechsel?

Was lässt sich jetzt vergleichen?
| Entscheidungsgrundlage | Opus 5.5 als Referenz | Fable 5.5 als Kandidat |
|---|---|---|
| Identität und Zugang | Aktuell dokumentierte Route verwenden; Konto prüfen | Durch die geprüften Quellen nicht belegt |
| Aufgabenqualität | An eigenen bestandenen und gescheiterten Aufgaben messen | Hier keine verifizierten Ergebnisse |
| Kosten und Latenz | Tatsächliche Kosten, Wiederholungsversuche und Laufzeit erfassen | Unbekannt, bis eine aufrufbare Route evaluiert werden kann |
| Produktionsrolle | Beibehalten, wenn Anforderungen erfüllt sind | Offen; eine Versionsnummer ist kein Abnahmetest |
Die bestehende Vergleichsbasis ist bereits stärker geworden
xhigh; die meisten anderen Opus-Ergebnisse dieser Tabelle nutzen max. Es handelt sich um Herstellerbewertungen von Opus 5.5 und Fable 5.1, nicht um Belege zu Fable 5.5 oder Messungen einer EvoLink-Route. Anthropic gibt außerdem an, dass die produktiven Schutzmechanismen aktiviert waren: Bei deren Eingreifen wurden Cybersicherheitsaufgaben an Opus 4.8 und Aufgaben aus Biologie oder der Entwicklung modernster LLMs an Opus 5 übergeben. Die Ergebnisse gelten für diese geprüfte Konfiguration und belegen nicht, dass jede Aufgabe ausschließlich von Opus 5.5 bearbeitet wurde.medium für Opus 5.5 und high für Fable 5.1. Gleiche Fenstergrößen beantworten nicht die Frage nach der Informationsnutzung; verschiedene Standardwerte bedeuten, dass ein Test ohne Anpassungen unterschiedliche Betriebsbedingungen vergleichen kann.Erfassen Sie für eine spätere Fable-5.5-Bewertung getrennt die Anzahl einzigartiger Aufgaben, alle Versuche, Erfolge beim ersten Versuch und letztlich gelöste Aufgaben. Eine einzelne Schlagzeilenquote kann verdecken, ob ein Modell die erste Antwort verbessert oder erst nach Wiederholungen mehr Aufgaben löst. Für das Routing zählt die Aufgabenmenge, an der Opus unter Ihrem tatsächlichen Budget weiterhin scheitert. Dort muss sich ein teurerer Kandidat rechtfertigen.
Wählen Sie Aufgaben, bei denen ein Wechsel relevant wäre
Die pauschale Frage „Welches Modell ist intelligenter?“ löst selten eine Produktionsentscheidung. Beginnen Sie mit einer Aufgabe, bei der ein besseres Ergebnis einen klaren betrieblichen Nutzen hat. Nehmen Sie auch Routineaufgaben auf, damit ein Erfolg bei einem schwierigen Beispiel keine Regressionen im Alltag verdeckt.
| Workload | Was zählt als Erfolg? | Zu erfassender Fehler | Frage für den Wechsel |
|---|---|---|---|
| Codeänderung über mehrere Dateien | Erforderliche Tests bestehen und beabsichtigtes Verhalten ändert sich | Teilkorrekturen, neue Regressionen, erfundene APIs | Reduziert der Kandidat Review und Nacharbeit? |
| Quellenbasierte Recherche | Aussagen sind durch die bereitgestellten Belege gestützt | Unbelegte Schlussfolgerungen oder fehlende Einschränkungen | Mehr akzeptierte Antworten ohne mehr Faktenprüfung? |
| Tool-gesteuerter Workflow | Korrekte Argumente und vorgesehener Endzustand | Falsches Tool, ungültige Argumente, doppelte externe Aktionen | Wird der Workflow zuverlässig abgeschlossen? |
| Routinemäßige strukturierte Extraktion | Schema- und Feldprüfungen bestehen | Plausibel wirkende, aber falsche Felder | Rechtfertigt der Nutzen Mehrkosten oder Verzögerung bei diesem Volumen? |
Das sind vorgeschlagene Aufgabenkategorien, keine Aussagen zur Funktionsunterstützung eines Modells. Testen Sie eine Funktion erst, wenn Routendokumentation und eine Anfrage ihre Unterstützung bestätigen.
Dateiübergreifendes Denken und Kontextnutzung gezielt testen
Nutzen Sie identische Testdaten für Referenz und Kandidat. Dies sind vorgeschlagene Fälle, keine Modellausgaben. Wenige erfolgreiche Durchläufe ergeben keine allgemeingültige Rangliste.
Nach verifiziertem Zugang kontrolliert vergleichen
Fixieren Sie vor dem Kandidatentest einen versionierten Aufgabensatz mit erwarteten Ergebnissen. Nehmen Sie Opus-Erfolge und -Fehler auf: Nur bekannte Fehler zu testen kann einen Kandidaten attraktiv erscheinen lassen und zugleich verbergen, was er verschlechtert. Trennen Sie einen Entwicklungssatz zur Prompt-Anpassung von einem zurückgehaltenen Testsatz für die endgültige Entscheidung.
Halten Sie Eingabedaten, Tool-Definitionen, Tool-Umgebung und Bewertungsregeln konstant. Erfassen Sie genaue Routen-IDs, Datum, Anfrageeinstellungen, Prompt-Versionen und Wiederholungsregeln. Gleich benannte Einstellungen oder Effort-Stufen müssen nicht modellübergreifend dasselbe bedeuten. Benötigen Modelle unterschiedliche unterstützte Einstellungen, dokumentieren Sie diese und vergleichen Sie vollständige Konfigurationen innerhalb derselben Budget- und Latenzgrenzen.
Wiederholen Sie Aufgaben mit schwankenden Ausgaben. Lassen Sie wichtige Fälle nach Möglichkeit ohne sichtbare Modellbezeichnung beurteilen. Veröffentlichen Sie Zähler und Nenner statt nur Prozentwerten: „18 von 20 akzeptiert“ zeigt die Stichprobengröße. Dokumentieren Sie unklare Bewertungen und machen Sie aus einem kleinen Replay keine allgemeine Leistungsaussage.
API-Vergleiche von Claude-Code-Workflow-Vergleichen trennen
Beide Experimente sind sinnvoll. Ein Workflow-Ergebnis beantwortet, ob Ihr Team eine Aufgabe in seiner realen Umgebung effektiver erledigt. Es isoliert nicht, welcher Anteil einer Veränderung vom Modell, der Kontextzusammenstellung oder der Orchestrierung stammt. Ändern sich diese Begleitfaktoren zwischen Durchläufen, kennzeichnen Sie das Ergebnis als Konfigurationsvergleich, statt den gesamten Gewinn Fable 5.5 zuzuschreiben.
Kosten pro akzeptierter Aufgabe vergleichen
Ein Tokenpreis bildet nur einen Teil der Workflow-Kosten ab. Zählen Sie im Auswertungszeitraum alle Versuche einschließlich Fehlern, Wiederholungsversuchen, Tool-Gebühren und gegebenenfalls Cache-Kosten. Teilen Sie die Summe durch die Zahl der Aufgaben, die dieselben Abnahmekriterien erfüllen:
Besteht keine Aufgabe, nennen Sie keinen endlichen Wert pro Erfolg. Berichten Sie null akzeptierte Aufgaben und die Gesamtausgaben. Erfassen Sie menschliche Prüfzeit separat, außer Sie bewerten sie ausdrücklich monetär und legen den verwendeten Stundensatz offen.
| Kostenaufstellung der Evaluierung | Konfiguration A | Konfiguration B |
|---|---|---|
| Nicht gecachte Eingaben, alle Versuche | $3 | $4 |
| Kosten der Ausgabe-Token, alle Versuche | $5 | $6 |
| Cache-Lesen und -Schreiben, alle Versuche | $1 | $2 |
| Zusätzliche Tool-Gebühren, alle Versuche | $3 | $3 |
| Gesamtkosten | $12 | $15 |
| Akzeptierte Aufgaben aus denselben 12 Aufgaben | 8 | 12 |
| Kosten pro akzeptierter Aufgabe | $1.50 | $1.25 |
Ordnen Sie jede Gebühr genau einmal zu. Fehlversuche und Wiederholungen stecken bereits in den Kategoriensummen; zusätzliche „Retry-Kosten“ würden sie doppelt zählen. Gleichen Sie die Kategorien mit der tatsächlichen Abrechnung ab: Nutzungsfelder einer Route können gecachte Token in einer größeren Eingabesumme enthalten. Berechnen Sie nicht zuerst den ungecachten Tarif für diese Summe und addieren danach nochmals Cache-Kosten.
Konfiguration B kostet im Beispiel insgesamt mehr, aber weniger je akzeptierter Aufgabe. Sie kann dennoch ungeeignet sein, wenn sie eine harte Latenzgrenze verletzt oder einen kritischen Fehler erzeugt. Trennen Sie Kaltstarts von Durchläufen mit wiederverwendetem Kontext, damit warme Caches die Kosten des ersten Durchlaufs nicht verdecken.
| Tokenmix eines Requests | Opus 5.5 | Fable 5.1 | Kostenverhältnis Fable / Opus |
|---|---|---|---|
| 100.000 ungecachte Eingabetokens; kein Cache-Lesen; 2.000 Ausgabetokens | $0.4400 | $1.1000 | 2.50× |
| 10.000 ungecachte Eingabetokens; 90.000 Cache-Lesen; 2.000 Ausgabetokens | $0.0980 | $0.2225 | 2.27× |
| 10.000 ungecachte Eingabetokens; 900.000 Cache-Lesen; 2.000 Ausgabetokens | $0.2600 | $0.4250 | 1.63× |
(10,000 × 4 + 90,000 × 0.20 + 2,000 × 20) / 1,000,000 = $0.098. Ein langer Verlauf mit warmem Cache verringert das Verhältnis. Er macht Fable weder günstiger noch berücksichtigt er den Cache-Aufbau. Reale Modelle können unterschiedliche Tokenmengen erzeugen. Rechnen Sie daher mit dem tatsächlichen Requestmix und den geltenden EvoLink-Routenpreisen, statt die gesamte Rechnung mit 2.5 zu multiplizieren.C sei die durchschnittliche gesamte API-/Tool-Ausgabe je eingereichter Aufgabe einschließlich Wiederholungen und p deren Abnahmequote. Dann betragen die API-Kosten je abgenommener Aufgabe C / p. Ein Kandidat mit Kostenmultiplikator r = C_candidate / C_Opus senkt diese Kosten nur bei p_candidate > r × p_Opus. Bei 80% Baseline und hypothetisch 1.5× Aufgabenkosten wären mehr als 120% Abnahme nötig – auf dieser reinen API-Kostenbasis unmöglich. Genügend eingesparte Arbeitszeit oder vermiedene teure Fehler könnten ihn dennoch rechtfertigen, müssen aber gesondert bewertet werden. Deshalb kann selektive Eskalation sinnvoller sein als der Ersatz jedes Opus-Requests.Spart Fable als Advisor Kosten?
Vergleichen Sie auf denselben Aufgaben drei Konfigurationen: den aktuellen Opus-Workflow, Opus mit einer dokumentierten und verfügbaren Advisor-Kombination sowie – erst nach Verifizierung – den Kandidaten als Hauptmodell. Zählen Sie jeweils den vollständigen Workflow: Hauptmodellaufrufe, Beratungen, Tool-Gebühren, Wiederholungen und abschließende Abnahme.
Beibehalten, gezielt eskalieren oder ersetzen?
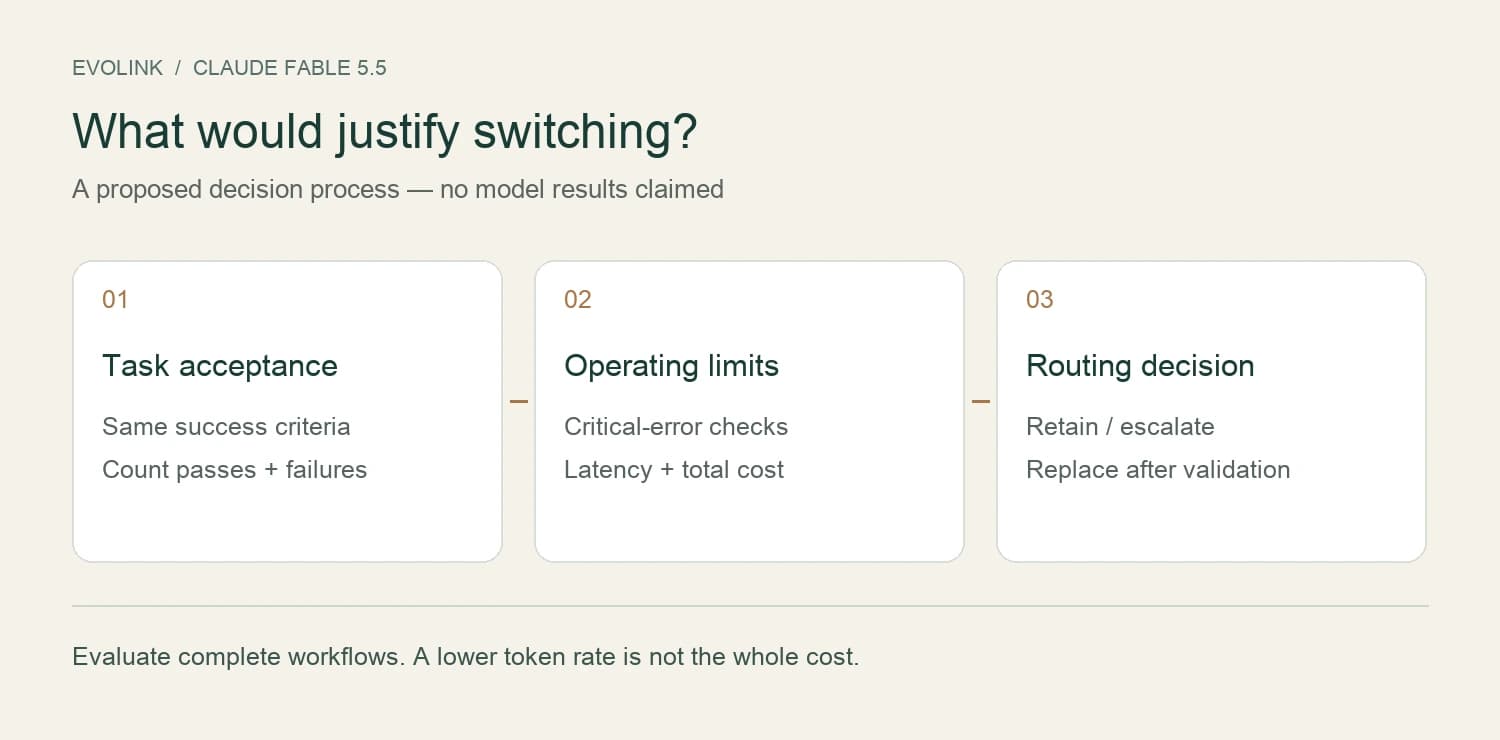
Definieren Sie die Abnahmeregeln vor Sichtung der Kandidatenergebnisse. Sie müssen zur Anwendung passen: Ein schwerer Tool-Fehler kann einen Rollout verhindern, selbst wenn die Durchschnittsqualität steigt. Legen Sie maximale Latenz, Ausgaben und Zuständigkeit für strittige Ausgaben fest.
- Opus beibehalten, wenn es die Anforderungen erfüllt und ein Kandidat keinen nützlichen Vorteil nachgewiesen hat.
- Ausgewählte Aufgaben eskalieren, wenn ein verifizierter Kandidat einer erkennbaren schwierigen Teilmenge hilft, andernorts aber unnötige Kosten oder Verzögerungen verursacht. Testen Sie die Routing-Regel selbst; Fehlklassifikationen können den Nutzen aufheben.
- Den Standard ersetzen erst dann, wenn Qualität, kritische Fehler, Latenz und Kosten auf repräsentativem Verkehr die Vorgaben erfüllen und ein getesteter Fallback vorhanden ist.
EvoLinks einheitliches Gateway kann die Modellauswahl über eine gemeinsame Integrationsschnittstelle ermöglichen. Das macht Modellverhalten nicht austauschbar. Prüfen Sie jeden Routenvertrag. Lassen Sie den Kandidaten ungesetzt, bis Zugang verifiziert ist, und bewerten Sie einen begrenzten Rollout, bevor Sie den Verkehr ausweiten.
FAQ
Ist Fable 5.5 besser als Opus 5.5?
Hier liegt kein verifiziertes Direktvergleichsergebnis vor. Identität, Zugang und Verhalten von Fable 5.5 sind in den geprüften Quellen unbestätigt; ein Sieger lässt sich nicht bestimmen.
Sollte Opus 5.5 mein Standard bleiben?
Behalten Sie einen Standard, der Ihre Anforderungen erfüllt, bis eine verifizierte Alternative Ihre Evaluierung besteht. Entscheidend sind Aufgabenergebnisse, Latenz und Gesamtkosten.
Bedeutet ein größer klingender Modellname oder eine neuere Version besseres Coding?
Nein. Verwenden Sie Repository-Aufgaben mit ausdrücklich erwarteten Änderungen und Regressionsprüfungen. Der Name belegt keinen Erfolg in Ihrer Codebasis.
Sollten beide Modelle identische Effort-Einstellungen nutzen?
Nur wenn die dokumentierten Einstellungen inhaltlich vergleichbar sind. Andernfalls erfassen Sie die jeweils unterstützte Konfiguration, vergleichen innerhalb derselben Betriebsgrenzen und erklären die Unterschiede.
Reichen Tokenpreise für die Entscheidung?
Nein. Wiederholungen, Ausgabelänge, Tools, Cache-Verhalten und gescheiterte Aufgaben verändern die Gesamtkosten. Vergleichen Sie tatsächliche Kosten je akzeptierter Aufgabe mit derselben Erfolgsdefinition.
Was, wenn der Kandidat nur schwierige Aufgaben besser löst?
Erwägen Sie nach Prüfung von Zugang und Verhalten eine selektive Eskalationsroute. Berücksichtigen Sie Kosten und Fehler der Entscheidung, welche Anfragen eskaliert werden.
Ist das ein EvoLink-Leistungsbenchmark?
Nein. Für diesen Artikel wurde kein authentifizierter Fable-5.5-Aufruf ausgeführt. Aufgabenmatrix, Testverfahren und Rechenbeispiel sind Evaluierungshilfen, keine gemessenen Modellergebnisse.
Wo prüfe ich den Veröffentlichungsstatus?
Quellen und Geltungsbereich
- Anthropic-Modellübersicht: Empfehlungen zu dokumentierten Modellen und Identitätsprüfung.
- Anthropic-Nachrichten: Prüfung der Veröffentlichungsbelege.
- EvoLink Opus 5.5: aktuelle Produkt- und Preisreferenz.
- Claude-Code-Advisor-Dokumentation: Advisor-Kontext, zusätzliche Nutzung und Cache-Verhalten; kein Nachweis für Fable-5.5-Unterstützung.