OpenAI Agents API Release: Funktionen und Aufgabenkosten

Hinter dem Release stehen konkrete Betriebsfragen: Läuft eine Aufgabe nach einem Verbindungsabbruch weiter? Bleiben wichtige Vorgaben nach der Kontextkomprimierung erhalten? Rechtfertigen parallele Subagenten ihre zusätzlichen Kosten durch kürzere Bearbeitung? Welche Arbeit verbleibt in deiner Anwendung?
OpenAI Agents API: Was wurde veröffentlicht?
| Frage | Aktueller Stand | Konsequenz für die Einführung |
|---|---|---|
| Nur Ankündigung oder nutzbares Anbieterprodukt? | Öffentliche Beta am 10. September angekündigt | Gegen die Beta-Dokumentation prüfen, keine GA-Zusagen voraussetzen |
| Agents SDK unter neuem Namen? | Nein: API als gehostete Laufzeit, SDK in deiner Anwendung | Eine Migration verändert Betriebsverantwortung |
| Ist der Codex-Harness ein Modell? | Nein: Er koordiniert Modellaufrufe, Werkzeuge und laufende Arbeit | Den gesamten Ablauf bewerten, nicht nur die Modellqualität |
| Über EvoLink verfügbar? | Integration läuft; Aufrufe noch nicht geöffnet | Den verifizierten Weg behalten und einen Pilotfall vorbereiten |
| Bedeutet eine öffentliche API offene Modellgewichte? | Aus diesem Laufzeit-Release folgt keine Aussage zu Gewichten oder Modelllizenzen | Quellcode der Laufzeit, Dienstbedingungen und Modelllizenz getrennt prüfen |
Die Namensähnlichkeit ist relevant: Ein Tutorial zur Installation des Agents SDK demonstriert nicht automatisch die neue verwaltete API. Ebenso belegt ein OpenAI-kompatibler Modellendpunkt keine Unterstützung dauerhafter Agentensitzungen. Identifiziere vor der Übernahme eines Beispiels das tatsächlich verwendete Produkt.
Warum der Zugang zum Codex-Harness relevant ist
Bei Coding- und Analyseprodukten ist der Modellaufruf nur ein Teil der Arbeit. Die Anwendung muss außerdem Werkzeugaktionen auswählen, Ergebnisse weiterreichen, Kontext erhalten und nach Unterbrechungen fortfahren. Der verwaltete Dienst bündelt diese Abläufe in einer Laufzeit. Der größte Nutzen entsteht, wenn deren Wartung einen erheblichen Teil der Teamarbeit ausmacht.
Trenne in der Aufwandserfassung Verbesserungen der Fachaufgabe von Wartung der Ausführungsmechanik. Nur wenn Letztere ins Gewicht fällt und die Dienstgrenze zum Produkt passt, kann die verwaltete Laufzeit einen sinnvollen betrieblichen Vorteil bringen.
Lange Sitzungen und Kontextkomprimierung: Kontinuität prüfen
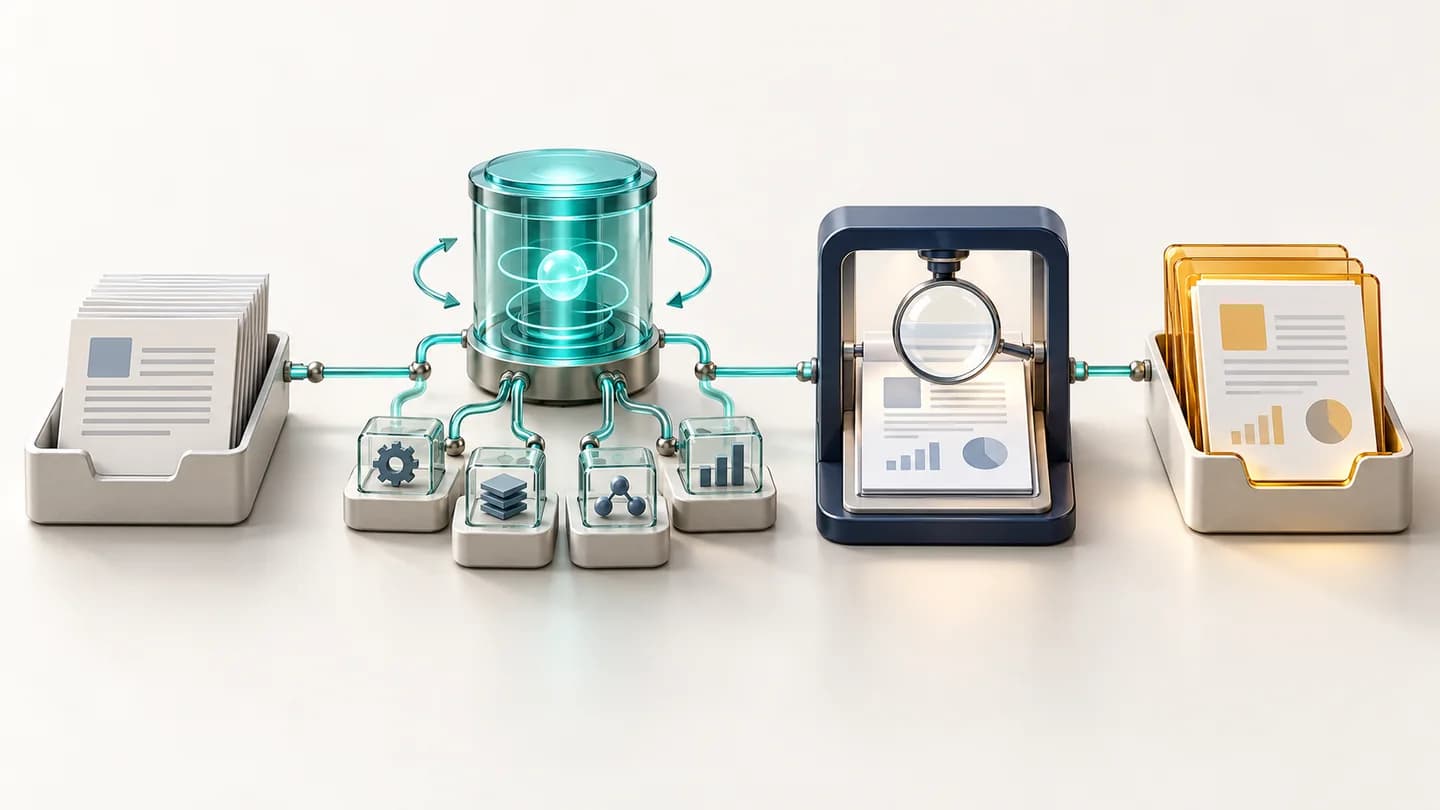
Ein vorgeschlagener Repository-Test lautet: Pagination korrigieren, öffentliches Antwortformat erhalten, Authentifizierung unverändert lassen und relevante Testergebnisse beifügen. Gib nach mehreren Analyse- und Bearbeitungsschritten einen zusätzlichen Grenzfall vor. Entscheidend ist, ob der finale Patch weiterhin alle ursprünglichen Vorgaben erfüllt. Ein langes Gesprächsprotokoll beweist das nicht.
Speichere die Abnahmeregeln im Aufgabenprotokoll der Anwendung. Vergleiche bei der Prüfung geänderte Dateien, Antwort-Fixture und Testbelege mit diesen Regeln. So lassen sich Probleme der Kontextverarbeitung von einer unpräzisen ursprünglichen Aufgabenbeschreibung unterscheiden. Gleichzeitig entsteht eine unabhängige Grundlage für spätere Laufzeitvergleiche.
Dasselbe gilt bei Datenanalysen: Ein Bericht kann sprachlich konsistent bleiben und trotzdem den Abrechnungszeitraum verändern oder einen gewünschten Ausschluss verlieren. Prüfe solche unveränderlichen Vorgaben ausdrücklich. Eine persistente Sitzung ist keine getestete Garantie, dass jede Geschäftsregel jede Fortsetzung übersteht.
Tool Search und programmatische Aufrufe reduzieren unterschiedliche Arbeit
Ein Assistent zur Kundenkontenanalyse könnte viele CRM-Operationen kennen, aber für eine Frage nur wenige benötigen. Unabhängig davon muss er möglicherweise mehrere Kontodatensätze abrufen und zusammenrechnen. Das passende Werkzeug zu finden beseitigt nicht die Kosten für Datenabruf und Verarbeitung.
Halte deshalb getrennt fest, ob das richtige Werkzeug gewählt wurde und ob die berechneten Werte einer unabhängigen Berechnung entsprechen. Eine kurze Endantwort beweist keine korrekte Aggregation. Testdaten sollten fehlende Datensätze, leere Ergebnisse und widersprüchliche Einheiten enthalten.
Unsere Empfehlung: Kundenwirksame Schreibaktionen nicht in einem undurchsichtigen Aggregationsschritt verstecken. Die Analyse schlägt eine Änderung vor; Anwendungscode prüft Ziel und Berechtigung vor der Ausführung. Das ist eine Gestaltungsempfehlung, keine Aussage über bereits verfügbare EvoLink-Werkzeugfunktionen.
Parallele Subagenten: getrennte Arbeit statt pauschaler Beschleunigung
Bei einer vorgeschlagenen Störungsanalyse können Deployment-Änderungen, Fehlerbeispiele und den Zustand der Abhängigkeiten getrennt und schreibgeschützt untersucht werden. Jeder Teil liefert Belege, eine Hypothese und die Grenzen der Verlässlichkeit seiner Einschätzung. Der koordinierende Agent prüft die Vereinbarkeit der Erklärungen, bevor er eine Gegenmaßnahme vorschlägt.
Drei Agenten, die dieselbe Konfigurationsdatei ändern, können dagegen Konflikte und Abstimmungsarbeit erzeugen. Beginne mit getrennter Beweissammlung und einer verantwortlichen Instanz für die finale Änderung. Miss die Zeit bis zum abgenommenen Gesamtergebnis einschließlich Zusammenführung und Konfliktklärung, nicht nur die schnellste Teilaufgabe.
Vergleiche einen einzelnen Agenten mit einer begrenzten Subagenten-Konfiguration auf denselben Störungsfällen. Erfasse Gesamtkosten und manuelle Korrekturen neben der Dauer. Eine schnellere, aber schlechter überprüfbare Antwort verfehlt die Produktanforderung.
Gehostete Sandbox, eigene Umgebung oder keine Sandbox?
| Vorgeschlagene Aufgabe | Erster Testkandidat | Begründung | Verantwortung der Anwendung |
|---|---|---|---|
| Kontenabfrage über Geschäftsfunktionen | Ohne Sandbox | Dienstergebnisse genügen, lokale Berechnung ist unnötig | Benutzer authentifizieren und Zugriffsrechte auf Datensätze durchsetzen |
| CSV-Analyse mit Arbeitsmappe | Gehostete Sandbox | Dateien, Pakete und Ergebnisse stehen im Mittelpunkt | Summen prüfen und abgenommenes Ergebnis speichern |
| Repository-Arbeit mit speziellen Abhängigkeiten | Selbst gehostete Umgebung | Bestehende Rechenumgebung oder Werkzeuge können entscheidend sein | Rechenressourcen bereitstellen, isolieren, wiederherstellen und stilllegen |
/workspace/outputs laut Leitfaden bei Abschluss des Turns als unveränderliche Artefakte veröffentlicht. Ordne beim Abruf sowohl den abgeschlossenen Turn als auch den Dateipfad zu, damit eine überarbeitete Analyse nicht versehentlich den alten Bericht ausliefert. Veröffentlichte Artefakte überdauern die Umgebung; benötigte Kopien müssen vor dem Löschen der Sitzung gesichert werden./workspace/outputs veröffentlicht sie nicht über OpenAIs Artifacts API. Hinter derselben Schaltfläche „Bericht herunterladen“ stehen somit zwei Abrufadapter. Abruf und Lebensdauer.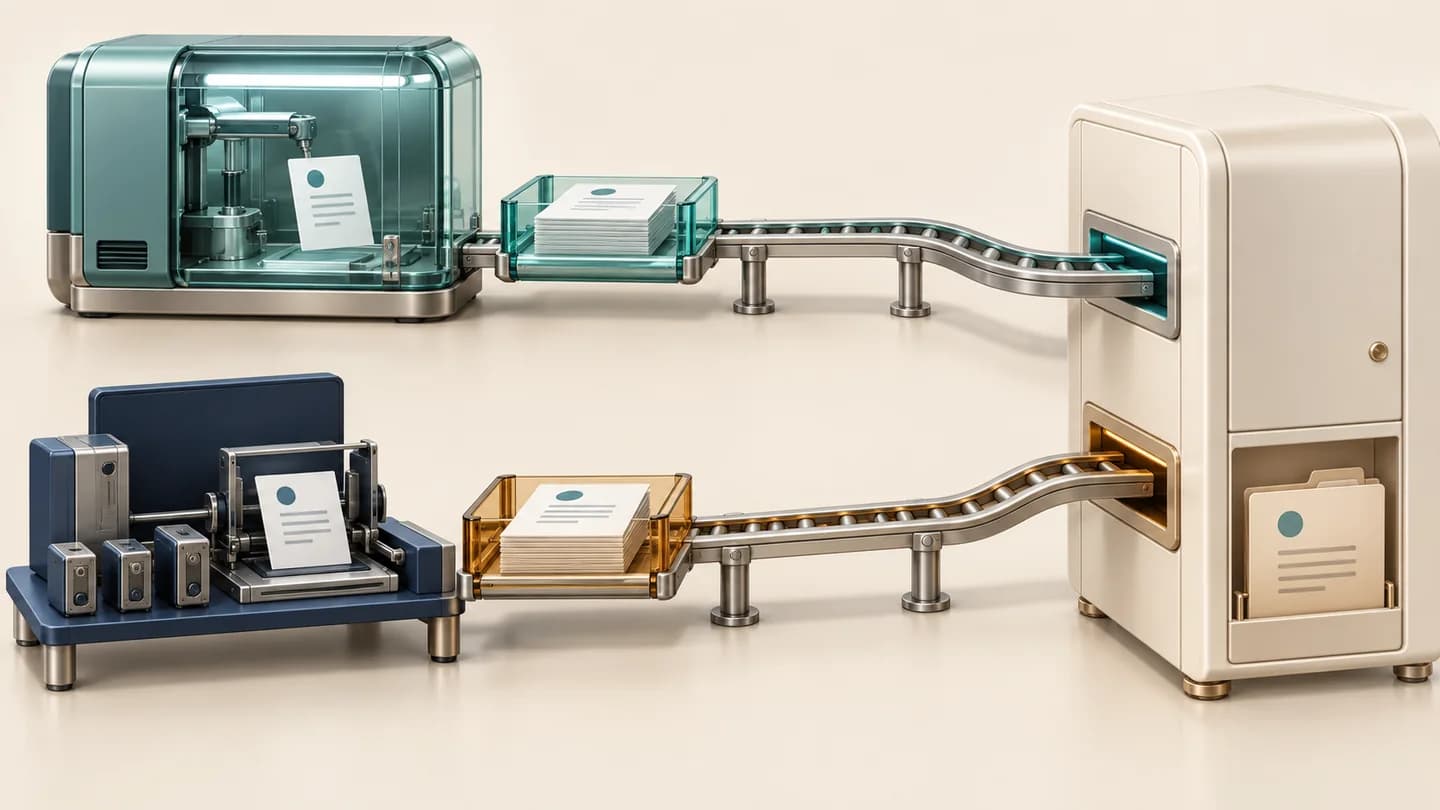
Von der Agentenausführung zum herunterladbaren Bericht
Ein möglicher Produktablauf für die CSV-Aufgabe sieht so aus. Das sind Anwendungszustände, keine API-Ereignisnamen:
| Anzeige für Kunden | Aktion der Anwendung | Voraussetzung für den nächsten Schritt |
|---|---|---|
| Verarbeitung läuft | Geschäftsauftrag mit Sitzung verknüpfen und Fortschritt verfolgen | Ein Ergebnis liegt zur Prüfung vor |
| Ergebnisse werden geprüft | Richtige Berichtsversion abrufen; Summen und Ausnahmen prüfen | Arbeitsmappe erfüllt gespeicherte Abnahmeregeln |
| Download bereit | Abgenommenes Ergebnis speichern und Downloadrechte durchsetzen | Datei ist tatsächlich abrufbar |
| Verbindung wird wiederhergestellt | Nach Stream-Abbruch bestehende Sitzung und gespeicherte Arbeit lesen | Feststellen, ob der ursprüngliche Auftrag läuft oder ein Ergebnis vorliegt |
| Prüfung erforderlich | Verwertbare Ergebnisse erhalten und offene Frage erklären | Korrigierte Eingabe, Prüfentscheidung oder kontrollierter Wiederholungsversuch |
Keine zusätzliche API-Gebühr heißt nicht kostenlos
Führe ein Aufgaben-Kostenbuch mit Modell-, Werkzeug- und Umgebungskosten, Fehlversuchen und abgenommenen Ergebnissen. Eigene Betriebs- und Prüfzeit gehört in eine separate Spalte. Sonst wird eine reine Token-Schätzung mit vollständigen Produktionskosten verglichen.
Welche Beta-Grenzen die Entscheidung verändern
Ein erster Test, der eine Entscheidung ermöglicht
Wähle einen bewusst begrenzten Bericht: zwei CSV-Exporte abgleichen, nicht zugeordnete Zeilen erklären und Arbeitsmappe samt Zusammenfassung erzeugen. Dies ist ein redaktioneller Testentwurf, kein Ergebnisbericht.
| Testfall | Daten oder Unterbrechung | Abnahmebeleg |
|---|---|---|
| Normale Eingabe | Zwei Exporte mit bekannter Übereinstimmungssumme | Summen stimmen mit unabhängiger Berechnung überein |
| Mehrdeutige Daten | Doppelte Kennungen und fehlende Währung | Unklarheiten werden angezeigt, keine still erfundene Zuordnung |
| Client-Abbruch | Stream nach Arbeitsbeginn schließen | Bestehende Arbeit wird gefunden, kein blindes Neueinreichen |
| Geänderte Anweisung | Während der Aufgabe einen Ausschluss ergänzen | Finale Summen und Erklärung berücksichtigen die Änderung |
| Ergebnisabruf | Rechenumgebung nach Sicherung beenden | Anwendung kann das abgenommene Ergebnis abrufen und öffnen |
| Budgetprüfung | Sämtliche Versuche einbeziehen | Ausgaben und Zahl akzeptierter Ergebnisse sind nachvollziehbar |
Häufige Fragen
Wann wurde OpenAI Agents API veröffentlicht?
Die öffentliche Beta wurde am 10. September 2026 angekündigt. Daraus folgt weder GA noch ein EvoLink-Startdatum.
Ist das das Codex-Modell oder das Agents SDK?
Es ist ein verwalteter Dienst um den Codex-Harness. Modellwahl und SDK-Orchestrierung innerhalb einer Anwendung sind eigene Konzepte.
Bedeutet automatische Komprimierung unbegrenztes Gedächtnis?
Nein. Prüfe, ob Vorgaben und Belege über lange Arbeit hinweg nutzbar bleiben. Die fachliche Abnahmedokumentation muss außerhalb des Gesprächs gespeichert werden.
Senken Subagenten immer Kosten oder Latenz?
Nein. Parallelität liefert kein aufgabenunabhängiges Ergebnis. Koordination, doppelte Arbeit und Endprüfung gehören in den Vergleich.
Ist Agents API kostenlos?
Auch ohne separate API-Gebühr fallen Modell-, Werkzeug- und Umgebungskosten an. Unsere Berechnung ist beispielhaft; EvoLink hat noch keine Preise angekündigt.
Kann alles in meiner VPC bleiben?
Das folgt nicht aus einer selbst gehosteten Sandbox. Ausführungsumgebung und verwalteter Dienst sind getrennte Grenzen; aktuelle Residenz- und Aufbewahrungsbedingungen bleiben relevant.
Ist Agents API über EvoLink verfügbar?
Wann wird dieser Artikel aktualisiert?
Bei einem neuen Beta-/GA-Vertrag, geänderten Umgebungs- oder Datenkontrollen, verifiziertem Gateway-Support oder reproduzierbaren Testergebnissen. Dann ändern sich Fakten und Empfehlungen, nicht bloß das Datum.