GPT-6.1 Terra vs GPT-6.1 Sol: Welches Modell passt zu Ihrer Arbeit?
Vergleichen Sie GPT-6.1 Terra und Sol bei Coding, Datenanalyse, Reasoning-Aufwand und Aufgabenkosten.
Himi LiProduct Manager at EvoLink
8 Min. Lesezeit
In diesem Artikel
GPT-6.1 Terra eignet sich als erster Versuch für klar umrissene Aufgaben: Bildschirmarbeit, Texte auf Basis vorhandener Unterlagen und kleine Codekorrekturen. Bei komplexem Coding und Projekten, in denen übersehene Abhängigkeiten teure Nacharbeit verursachen, ist GPT-6.1 Sol die bessere Ausgangsbasis.
Terra hat niedrigere Standard-API-Tokenpreise. Entscheidend ist aber, ob die gewählte Reasoning-Einstellung die benötigte Qualität liefert. Mehr Reasoning kann sowohl die Kosten als auch die Wartezeit verändern. Zur Modellwahl gehört deshalb auch die Wahl des Aufwands.
GPT-6.1 Terra vs GPT-6.1 Sol im Überblick
Entscheidungskriterium
GPT-6.1 Terra
GPT-6.1 Sol
Geeigneter Einstieg
Definierte Bildschirmaufgaben, Schreiben mit vorhandenen Fakten, begrenzte Korrekturen
Komplexes Coding und fachliche Aufgaben mit vielen Abhängigkeiten
Standard-Eingabe / -Ausgabe je 1 Mio. Token
$1 / $5
$2 / $10
Cache-Eingabe je 1 Mio. Token
$0.05
$0.10
Reasoning-Aufwand
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Standardeinstellung
medium
medium
Tool-Aufrufe
Responses API erforderlich
Responses API erforderlich
Offizielle Spezifikationen und Preise: Terra, Sol, Preisliste. Die Tabelle zeigt OpenAIs Standard-Preise. Für langen Kontext und andere Verarbeitungsmodi gelten eigene Bedingungen.
Beide Modelle verarbeiten Text und Bilder und geben Text aus. Beide haben ein Kontextfenster von 1.050.000 Token und eine maximale Ausgabe von 128.000 Token. Die Kontextgröße ist somit kein Unterscheidungsmerkmal. Terra-Referenz; Sol-Referenz.
Welches Modell passt zu Coding, Computerbedienung und Datenanalyse?
Coding: Terra für die einzelne Korrektur, Sol für das vernetzte Projekt
Ein Layoutfehler mit eindeutigen Reproduktionsschritten ist eine passende Terra-Aufgabe. Für eine Funktion, die Anmeldung, Abrechnung und gemeinsamen Zustand betrifft, spricht mehr für Sol: Eine übersehene Verbindung kann mehr Nacharbeit kosten, als der niedrigere Tokenpreis spart. Das entspricht OpenAIs Empfehlungen zur Modellwahl.
Artificial Analysis meldet im Coding Agent Index v2.0 48 Punkte für Terra und 54 für Sol. Der Index umfasst Änderungen am Repository, Terminalaufgaben und Fragen zum Repository. Ein einzelner Terminal-Benchmark bildet daher nicht die gesamte Entwicklungsarbeit ab. AA-Analyse; Methodik.
Eine interessante Ausnahme liefert OpenAI: Bei max übertrifft Terra Sol auf Terminal-Bench-Science 0.1 zu geringeren Kosten. Für besonders komplexes Coding empfiehlt OpenAI weiterhin Sol oder Astra. Wissenschaftliche Terminalaufgaben und eine große Anwendungsumstrukturierung stellen unterschiedliche Anforderungen. OpenAI-Auswertung.
Computerbedienung und Schreiben: Terra zuerst ausprobieren
Terra ist einen Versuch wert, wenn etwa Rechnungen gelesen und deren Felder in eine Anwendung eingetragen werden sollen. OpenAIs Tests zu visueller Verarbeitung und Computerbedienung zeigen die Leistung bei solchen Aufgaben. OpenAI.
Auch bei einem klaren Ergebnis und gelieferten Fakten bietet sich Terra an: etwa Versionshinweise in Kundendokumentation umwandeln oder ein Angebot für eine bestimmte Zielgruppe überarbeiten. Müssen widersprüchliche Informationen eines komplexen Projekts zusammengeführt werden, ist Sol der vorsichtigere Einstieg. Auswahlhilfe.
Datenanalyse: Schwierige Fragen können Sol rechtfertigen
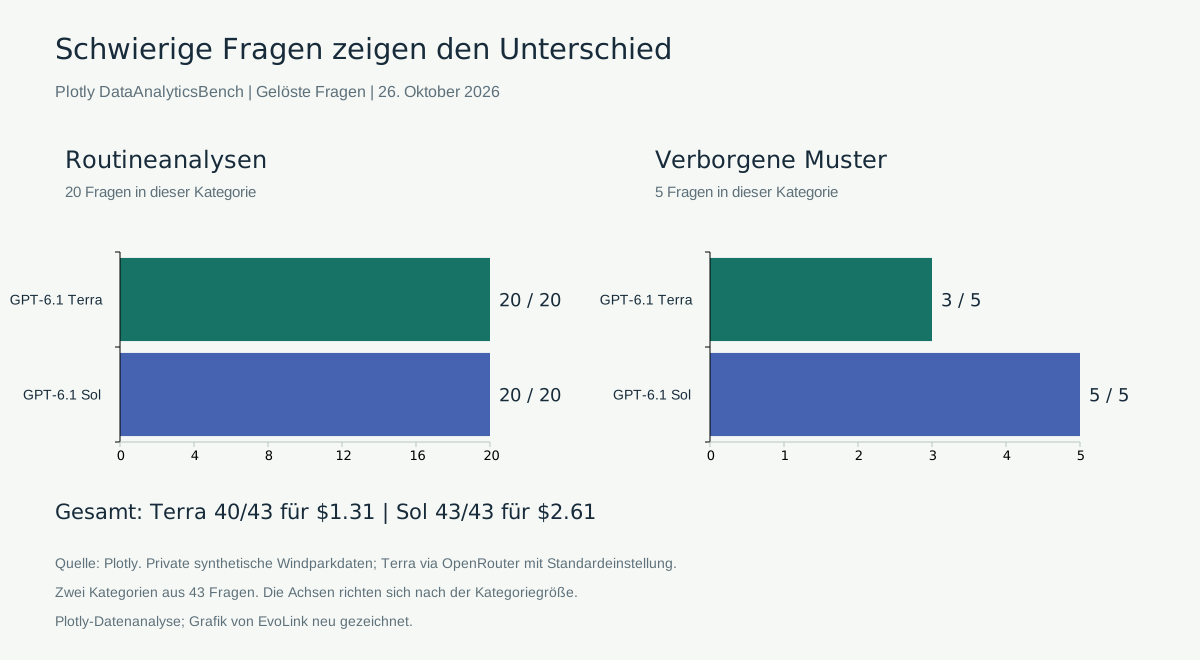
Plotlys Datenanalyseprüfung mit 43 Fragen macht den Unterschied greifbar. Terra löste 40 Fragen für $1.31, Sol alle 43 für $2.61. Bei den 20 Routinefragen lagen beide vollständig richtig. Bei verborgenen Mustern erkannte Terra drei von fünf, Sol alle fünf. Plotly-Ergebnisse.
Plotly: Beide Modelle lösen 20 von 20 Routinefragen; bei verborgenen Mustern erreicht Terra 3 von 5, Sol 5 von 5.
Routineanalysen und die Suche nach verborgenen Mustern können unterschiedliche Modellentscheidungen nahelegen. Neu gezeichnet nach Plotlys veröffentlichten Ergebnissen.
Für wiederkehrende, klar definierte Abfragen ist Terra damit ein plausibler Kandidat. Soll etwas entdeckt werden, das die Frage noch nicht ausdrücklich nennt, lohnt sich Sol. Die Prüfung verwendete private synthetische Windparkdaten. Terra lief über OpenRouter mit der voreingestellten Reasoning-Stufe und starker Cache-Wiederverwendung. Testbedingungen; Benchmark-Aufbau.
Terra high vs Sol medium: Welcher Reasoning-Aufwand lohnt sich?
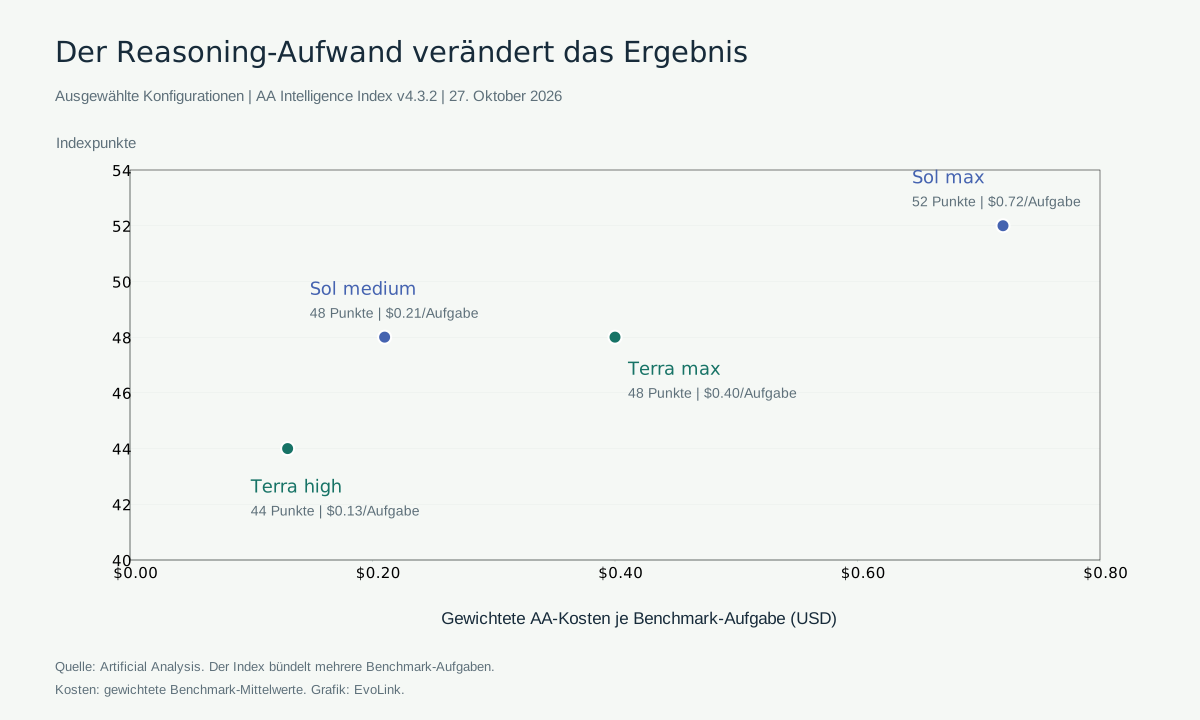
Terra high ist im AA-Vergleich günstiger, Sol medium erreicht jedoch den höheren Gesamtwert.
Modell und Aufwand
AA Intelligence Index
Gewichtete Kosten je AA-Benchmark-Aufgabe
GPT-6.1 Terra · high
44
$0.13
GPT-6.1 Sol · medium
48
$0.21
GPT-6.1 Terra · max
48
$0.40
GPT-6.1 Sol · max
52
$0.72
Datenstand: 27. Oktober 2026. AA-Anbieterliste; max gegen max. Der Index ist ein zusammengesetzter Punktwert, keine Erfolgsquote. Die Kosten sind gewichtete Mittelwerte der Benchmark-Aufgaben.
AA-Konfigurationen: Terra high erreicht 44 Punkte bei $0.13 je Aufgabe, Sol medium 48 bei $0.21, Terra max 48 bei $0.40 und Sol max 52 bei $0.72.
Terra max und Sol medium zeigen beide 48 Punkte, ihre Einzelwerte unterscheiden sich aber: Auf Terminal-Bench 4.0 erzielt Terra max 56 % gegenüber 48 %, auf AutomationBench-AA führt Sol medium mit 63 % gegenüber 60 %. Ein gleicher gerundeter Gesamtwert bedeutet daher keine identischen Ergebnisse für Ihre Aufgabe. Terra max; Sol medium.
AA nennt zudem je nach Ziel andere effiziente Einstellungen: Terra low und medium liegen auf der Effizienzgrenze für allgemeine Intelligenz und Kosten, low und xhigh auf derjenigen für Coding. Stets medium zu wählen oder höhere Stufen grundsätzlich zu vermeiden, lässt diese Unterschiede außer Acht. AA-Analyse.
Ist Terra tatsächlich schneller und günstiger als Sol?
Ausgabegeschwindigkeit und Wartezeit auf die erste Antwort getrennt messen
Artificial Analysis weist Ausgabetempo und Zeit bis zum ersten Token je Konfiguration und Anbieter separat aus. Die Messwerte ändern sich; vergleichen Sie den Endpunkt, den Sie einsetzen möchten. AA-Anbieterliste.
Bei einem interaktiven Assistenten zählt, wann die Antwort beginnt. Bei einem Agenten mit mehreren Tool-Schritten zählt, wann das Ergebnis gespeichert oder ausgeliefert ist. AA erklärt diese Unterschiede in der Performance-Methodik. Die Vergleichsseite berechnet auch eine Antwortzeit für 500 Token; diese entspricht nicht der Dauer einer vollständigen Coding- oder Desktopaufgabe.
Im DataAnalyticsBench von Plotly mit 43 Fragen lag die mediane Zeit von der Frage bis zur finalen Antwort einschließlich Abfragen bei 15 Sekunden für Terra und 18 Sekunden für Sol. Terra löste 40, Sol 43 Fragen. Der Test nutzte private synthetische Windparkdaten; Terra lief über OpenRouter mit der Standard-Reasoning-Einstellung. Plotly-Ergebnisse; Terra-Testbedingungen.
Niedrigere Tokenpreise ergeben nicht automatisch niedrigere Gesamtkosten
Bei derselben Standard-Tokenmenge sind Terras Ein- und Ausgabekosten halb so hoch wie Sols. Verändert der Reasoning-Aufwand den Verbrauch, verändert sich auch das Verhältnis. Bei max nennt AA $0.40 gegenüber $0.72 je Benchmark-Aufgabe, also rund 44 % weniger für Terra. Beim Vergleich unterschiedlicher Stufen ist Sol medium günstiger als Terra max. Offizielle Preise; AA max/max; Anbieterliste.
AA berechnet Aufgabenkosten aus gewichteten Bewertungsdurchschnitten und Tokengebühren. Für ein vom Team abgenommenes Produktionsergebnis ist eine andere Rechnung hilfreich. AA-Kostendefinition:
Kosten je akzeptierter Aufgabe = gesamte Modell- und Toolausgaben einschließlich fehlgeschlagener Versuche ÷ Anzahl akzeptierter Aufgaben
Erfassen Sie zusätzlich die menschliche Prüfzeit. Eine günstige Antwort mit vielen Korrekturrunden kann sich schlechter rechnen als eine klar umrissene Aufgabe, die Terra direkt zuverlässig erledigt. Die Ersparnis hängt davon ab, wie oft der Ablauf ein brauchbares Ergebnis liefert.
Wechseln, Sol behalten oder beide einsetzen?
Beginnen Sie mit einer definierten Aufgabenklasse:
Ihre Arbeit
Einstieg
Wann die Wahl ändern?
Reproduzierbare lokale Codekorrektur
Terra testen
Wiederholte Umfangsfehler oder übersehene Regressionen sprechen für Sol
Funktion oder Refactoring in unbekannten Dateien
Sol als Ausgangsbasis behalten
Terra ausweiten, sobald es Abhängigkeiten zuverlässig behandelt
Bildschirme, Formulare und Texte aus vorhandenem Material
Terra testen
Falsch gespeicherte Felder oder fehlende Fakten erfordern klarere Eingaben oder ein stärkeres Modell
Wiederkehrende Analysen mit bekannten Fragen
Terra testen
Verborgene Muster und schwierigere Analysen sprechen eher für Sol
Bereits zuverlässig mit Sol laufender Ablauf
Sol behalten und Terra für einen begrenzten Teil testen
Wechseln, wenn Qualität, Kosten und Wartezeit überzeugen
Eine Kombination ist sinnvoll, wenn Terra bestimmte Aufgaben zuverlässig erledigt und Sol die schwierigen übernimmt. Die Eskalation sollte sich auf ein prüfbares Signal stützen, etwa fehlgeschlagene Tests oder ein fehlendes Pflichtfeld im gespeicherten Datensatz. Die Zuversicht des Modells ersetzt keine Prüfung.
Geben Sie beiden Modellen zunächst dieselben repräsentativen Eingaben und Abnahmekriterien. Ändern Sie Modell und Reasoning-Stufe getrennt, um die Ursache eines Unterschieds zu erkennen. Wählen Sie dann die Kombination, die Qualität und Antwortzeit zum passenden Preis liefert.
Auch den API-Zugang prüfen
EvoLinks einheitliches API-Gateway bringt die Modellwahl in eine gemeinsame Integration. Auf den Seiten zu GPT-6.1 Sol und GPT-6.1 Terra finden Sie aktuellen Zugang und Preise. Für den Produktionseinsatz muss die gewählte Route den benötigten Tool-Ablauf unterstützen.
Häufige Fragen
Ist GPT-6.1 Terra beim Coding besser als Sol?
Sol hat den höheren AA-Gesamtwert für Coding. Terra bleibt ein Kandidat für begrenzte Korrekturen und bestimmte Terminalaufgaben; OpenAI meldet außerdem einen Vorteil auf seinem wissenschaftlichen Terminaltest. Entscheidend ist die Aufgabenart. AA; OpenAI.
Entspricht Terra high Sol medium?
Es gibt keine feste Gleichsetzung. Im AA-Datenstand erreicht Terra high einen niedrigeren Gesamtwert bei geringeren durchschnittlichen Benchmark-Kosten. Auch Terra max mit demselben angezeigten Gesamtwert wie Sol medium liefert andere Einzelresultate. AA-Liste; Terra max; Sol medium.
Nutzen beide Modelle dieselbe API für Tool-Aufrufe?
OpenAI dokumentiert dafür bei beiden die Responses API. Prüfen Sie zusätzlich die Unterstützung Ihrer Route oder Ihres Clients für diesen Tool-Ablauf. Terra-Referenz; Sol-Referenz.

 Himi LiProduct Manager at EvoLink