GPT-6.1 Terra vs Claude Opus 5.5: Lohnt sich der Aufpreis?
Wann lohnt sich Opus 5.5, wann Terra? Vergleichen Sie Kosten, komplexes Coding, Automatisierung und API-Wechsel.
 Himi LiProduct Manager at EvoLink
In diesem Artikel
Kann GPT-6.1 Terra Opus 5.5 ersetzen?
Für bestehende Opus-Nutzer lautet die konkrete Frage: Welche Arbeit kann zu Terra wechseln, ohne dass zusätzliche Korrekturen die Ersparnis aufzehren? Das kann ein großer Teil der Aufgaben sein, ohne gleich die ganze Anwendung zu umfassen.
Ist Terra viermal oder neunmal günstiger?
Beide Angaben stammen aus veröffentlichten Vergleichen, haben aber unterschiedliche Bezugsgrößen. Terras genannte Standard-Preise gelten bis 272.000 Eingabe-Token pro Anfrage. Oberhalb dieser Grenze gelten höhere Langkontextpreise.
| Kostenvergleich | Ergebnis | Geltungsbereich |
|---|---|---|
| Offizielle Standard-API-Tokenpreise | Terras Ein- und Ausgabepreise liegen 75 % niedriger: $1/$5 gegenüber $4/$20 je Million Token | Modellkosten bei gleicher Tokenmenge |
| OpenAIs Agents’-Last-Exam-Test | OpenAI meldet bei Terra max rund neunmal niedrigere Aufgabenkosten als bei Opus 5.5 | OpenAIs Computerbedienungsprüfung |
| Ausgewählte max-Konfigurationen bei AA | Gewichtete Kosten je Intelligence-Index-Aufgabe: Terra $0.40, Opus mit Default Fallback $5.98, also etwa Faktor 15 | Gewichteter Mittelwert der AA-Benchmark-Aufgaben |
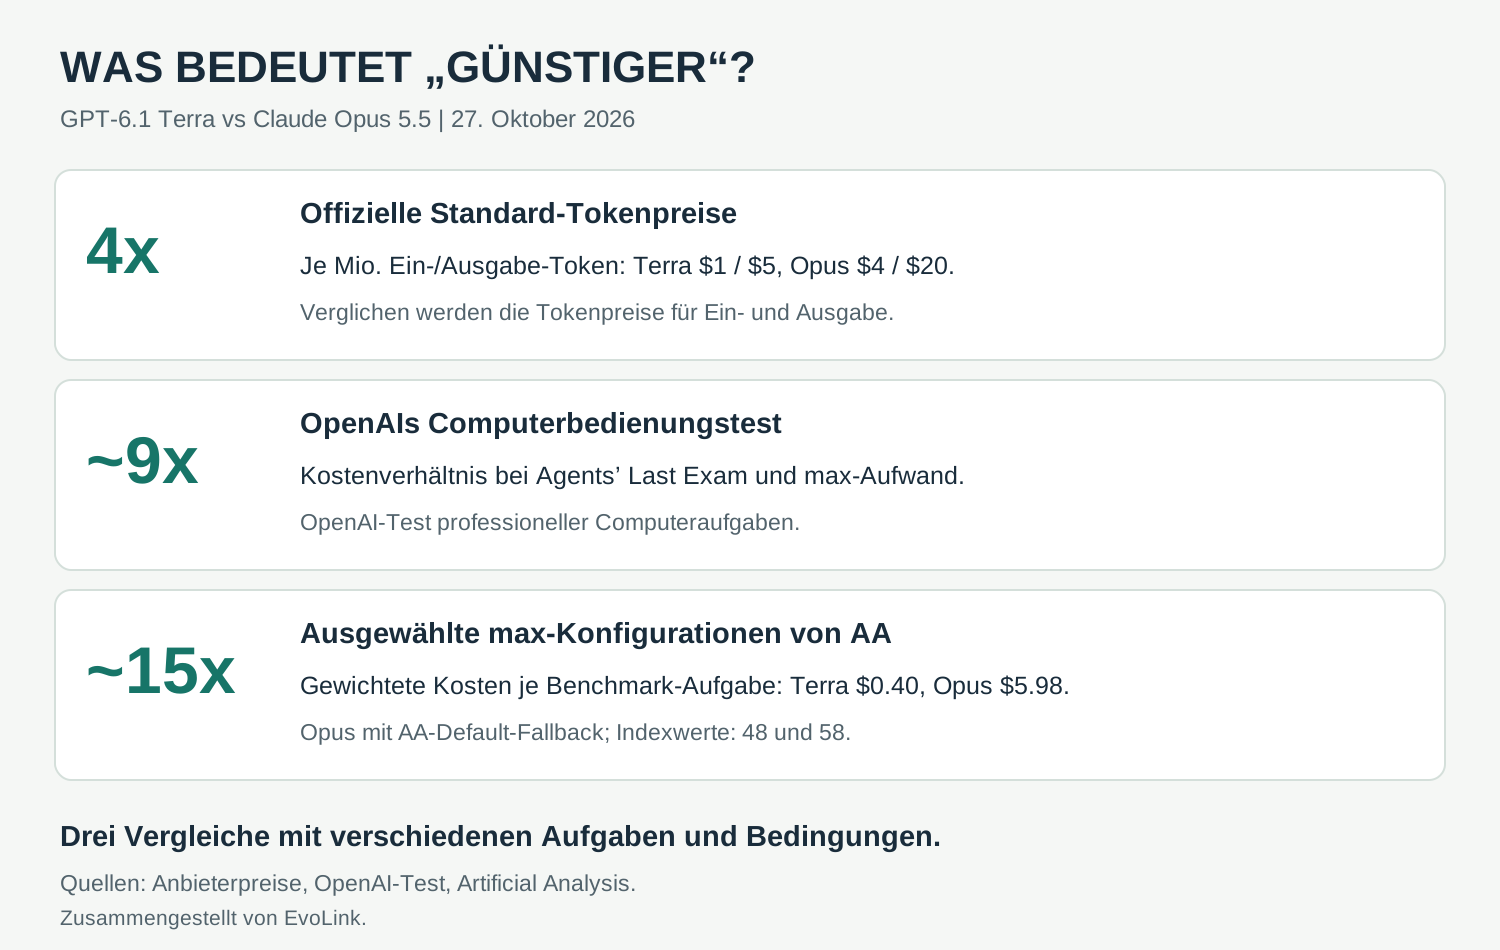
OpenAIs Faktor neun stammt aus der Prüfung professioneller Computeraufgaben. Andere Aufgaben haben andere Tokenverbräuche, Tool-Aufrufe und Wiederholungen.
Für die Produktion addieren Sie Modell- und Toolkosten aller Versuche und teilen sie durch die Anzahl akzeptierter Ergebnisse. Erfassen Sie die menschliche Prüfzeit zusätzlich. Der günstigere Tokenpreis wirkt am stärksten, wenn ein Ablauf ohne wiederholtes Eingreifen ein brauchbares Ergebnis liefert.
Wann lohnt sich der Aufpreis für Opus?
Ein Vergleich desselben Prüfers ist dafür hilfreicher als nebeneinandergestellte Hersteller-Schlagzeilen:
| AA-Ergebnis, ausgewählte max-Konfigurationen | Terra | Opus, Default Fallback |
|---|---|---|
| Intelligence Index | 48 | 58 |
| Terminal-Bench 4.0 | 56% | 60% |
| AutomationBench-AA | 60% | 70% |
Opus liegt bei diesen Kennzahlen vorn, mit je nach Aufgabengruppe unterschiedlichem Abstand. Es ist eine starke Ausgangsbasis für schwieriges Coding und zusammenhängende Agentenabläufe.
EvoLink-Test: Ein Pelikan fährt Fahrrad
Im EvoLink-Vergleich der Pelikan-Fahrradszenen steht GPT-6.1 Terra links und Claude Opus 5.5 rechts.
Dies sind Beispielausgaben, kein kontrollierter Benchmark; daraus lässt sich kein allgemeiner Vorteil bei Codequalität oder Kosten ableiten.
Wann eignet sich Terra besser für Automatisierung?
Was gilt für lange Dokumente, Analysen und Texte?
Für Texte aus einem vollständigen Briefing, etwa Kundendokumentation aus Versionshinweisen, ist Terra ein sinnvoller Kandidat: Fakten und Auslassungen lassen sich prüfen. Müssen widersprüchliche Dokumente abgeglichen werden, sprechen Opus’ breitere Bewertungsergebnisse dafür, es zunächst als Ausgangsbasis zu behalten.
Wenn Stil oder Analyseansatz wichtig sind, testen Sie beide Modelle mit Ihren eigenen Dokumenten und vergleichen Sie Ergebnis sowie Überarbeitungsaufwand.
Lässt sich ein bestehender Claude-Agent auf Terra umstellen?
gpt-6.1-terra und claude-opus-5-5. Eine Namensänderung passt weder Tool-Nachrichten noch Reasoning-Steuerung, Gesprächszustand oder Cache-Regeln automatisch an.Für Agenten sind drei Unterschiede relevant:
- Reasoning und Tools. Terra bietet none bis max, verwendet standardmäßig medium und benötigt für Tool-Aufrufe die Responses API. Opus verwendet stets adaptives Thinking, ebenfalls mit medium als Standard. Die native API schränkt erzwungene Tool-Aufrufe ein. Gleiche Namen bedeuten keinen gleichen Rechenaufwand. Terra; Opus; Claude-Effort-Leitfaden.
- Gesprächsverlauf. Anthropic dokumentiert modell- und gesprächsspezifische Regeln für Thinking-Blöcke. Beim Modellwechsel in einer langen Claude-Sitzung muss der Verlauf entsprechend aufbereitet werden; vollständige interne Verläufe lassen sich nicht ohne Weiteres an einen anderen Anbieter übertragen. Opus-Verhalten.
- Caching. Zu den Standard-API-Preisen der Anbieter kosten Cache-Lesezugriffe je Million Token bei Terra $0.05 und bei Opus $0.20. Cache-Schreibvorgänge kosten bei Terra $1.25 für 30 Minuten oder $2.50 für 12 Stunden, bei Opus $5 für 5 Minuten oder $8 für eine Stunde. Die Laufzeiten unterscheiden sich und beeinflussen Wiederverwendung und erneutes Schreiben. Terras Preise gelten für Anfragen mit höchstens 272.000 Eingabe-Token. OpenAI-Preise; Anthropic-Cachepreise.
Eine Coding-Anwendung bringt außerdem eigene Tools, Kontextverwaltung und Orchestrierung mit. Prüfen Sie deshalb, ob der bestehende Claude-Code- oder andere Clientaufbau das Modell unterstützt. API-Preise und Nutzungsumfang eines Abonnements sind ebenfalls verschiedene Größen.
EvoLinks einheitliches API-Gateway hilft, Modelloptionen über eine gemeinsame Integration zu verwalten. Prüfen Sie vor der Umstellung Endpunkt, Tool-Unterstützung, Reasoning-Steuerung und tatsächliche Abrechnung der Route. Die Anbieterreferenzen beschreiben die nativen Fähigkeiten; die Unterstützung der gewählten Route gehört zum Integrationstest.
Welche Aufgaben sollten zuerst wechseln?
Löst Opus Ihre schwierigsten Coding- und Analyseaufgaben bereits zuverlässig, behalten Sie es dort. Terras sinnvoller erster Einsatz ist eine klar definierte Aufgabenklasse mit direkt prüfbaren Ergebnissen.
So kann Opus eine repositoryweite Änderung verantworten, während Terra einen separaten reproduzierbaren UI-Fehler korrigiert. In einem Betriebsablauf kann Terra bekannte Formularfelder übernehmen, während der stärkere Pfad Ausnahmen untersucht. Eskalation sollte auf einen sichtbaren Fehler oder eine offene Anforderung folgen.
Entscheidend ist, ob die günstigere Route genug dieser Arbeit zuverlässig erledigt. Gezielter Ersatz und klare Zuweisung von Aufgaben sind besser belegt als ein pauschaler Ersatz von Opus.
Häufige Fragen
Kann GPT-6.1 Terra Opus 5.5 beim Coding ersetzen?
Terra eignet sich für klar begrenzte Korrekturen. Verwenden Sie Opus als Ausgangsbasis für komplexes Coding und mehrstufige Agentenabläufe.
Bedeutet die neunfache Kostendifferenz gleiche Qualität?
Nein. Die Angabe stammt aus OpenAIs bestimmtem Computerbedienungstest. Sie beschreibt weder gleiche Qualität noch identische Anbietereinstellungen oder dieselbe Ersparnis bei anderen Aufgaben.