Gemini 4 Neon vs. Claude Opus 5.5 für Code und Kosten
Vergleichen Sie Neon und Opus 5.5 im gleichen Editor und mit den Agenten der Anbieter. Entscheiden Sie anhand der Kosten je abgenommenem Patch.
 EvoLink TeamProduktteam
In diesem Artikel
high bei wiederkehrenden Programmieraufgaben mit automatisierten Tests. Behalten Sie Claude Opus 5.5 als Vergleichsbasis für bewährte Abläufe im Repository. Neon erzielt im Coding über mehrere Dateien konkurrenzfähige Ergebnisse und hat niedrigere Standardpreise für Ein- und Ausgabe. Messen Sie vor dem Wechsel die Abnahmequote im ersten Durchlauf, den Prüfaufwand und die Unterstützung der Werkzeuge, die Ihr Team braucht. CursorBench 4.1 · Google-API-Preise · Anthropic-PreiseGemini 4 Neon und Claude Opus 5.5 in Ihrer Entwicklungsumgebung vergleichen
| Aktuelles Setup | Was Sie testen | Was entscheidet |
|---|---|---|
| Beide Modelle sind im selben Editor verfügbar | Modell ändern, Editor, Tools und Review-Ablauf beibehalten | Abgenommene Patches, Gesamtkosten und Eingriffe im Review |
| Das Team arbeitet vor allem in Claude Code | Claude Code mit Opus und Antigravity mit Neon als vollständige Setups vergleichen | Repository-Anweisungen, Berechtigungen und Übergaben |
| Die Anwendung ruft Modelle per API auf | Identische Aufgaben, zugelassene Tools und Validierung in der Anwendung | Korrekte Tool-Nutzung, gültige Patches, behebbares Fehlerverhalten |
| Das Setup verarbeitet seltene Migrationen mit hohem Risiko | Neon anhand eines früheren Falls oder in einem isolierten Branch testen | Kompatibilitätsprüfungen und manuelle Nacharbeit |
Was die beiden Coding-Benchmarks messen
xhigh mit der Antigravity CLI 59 Punkte bei 6,86 US-Dollar pro Aufgabe. Opus 5.5 max mit Claude Code kam auf 58 Punkte bei 12,61 US-Dollar. Die gerundeten Werte gelten für die jeweilige Kombination. CursorBench 4.1 zeigt einen zweiten Vergleich im selben Editor. Artificial-Analysis-Auswertung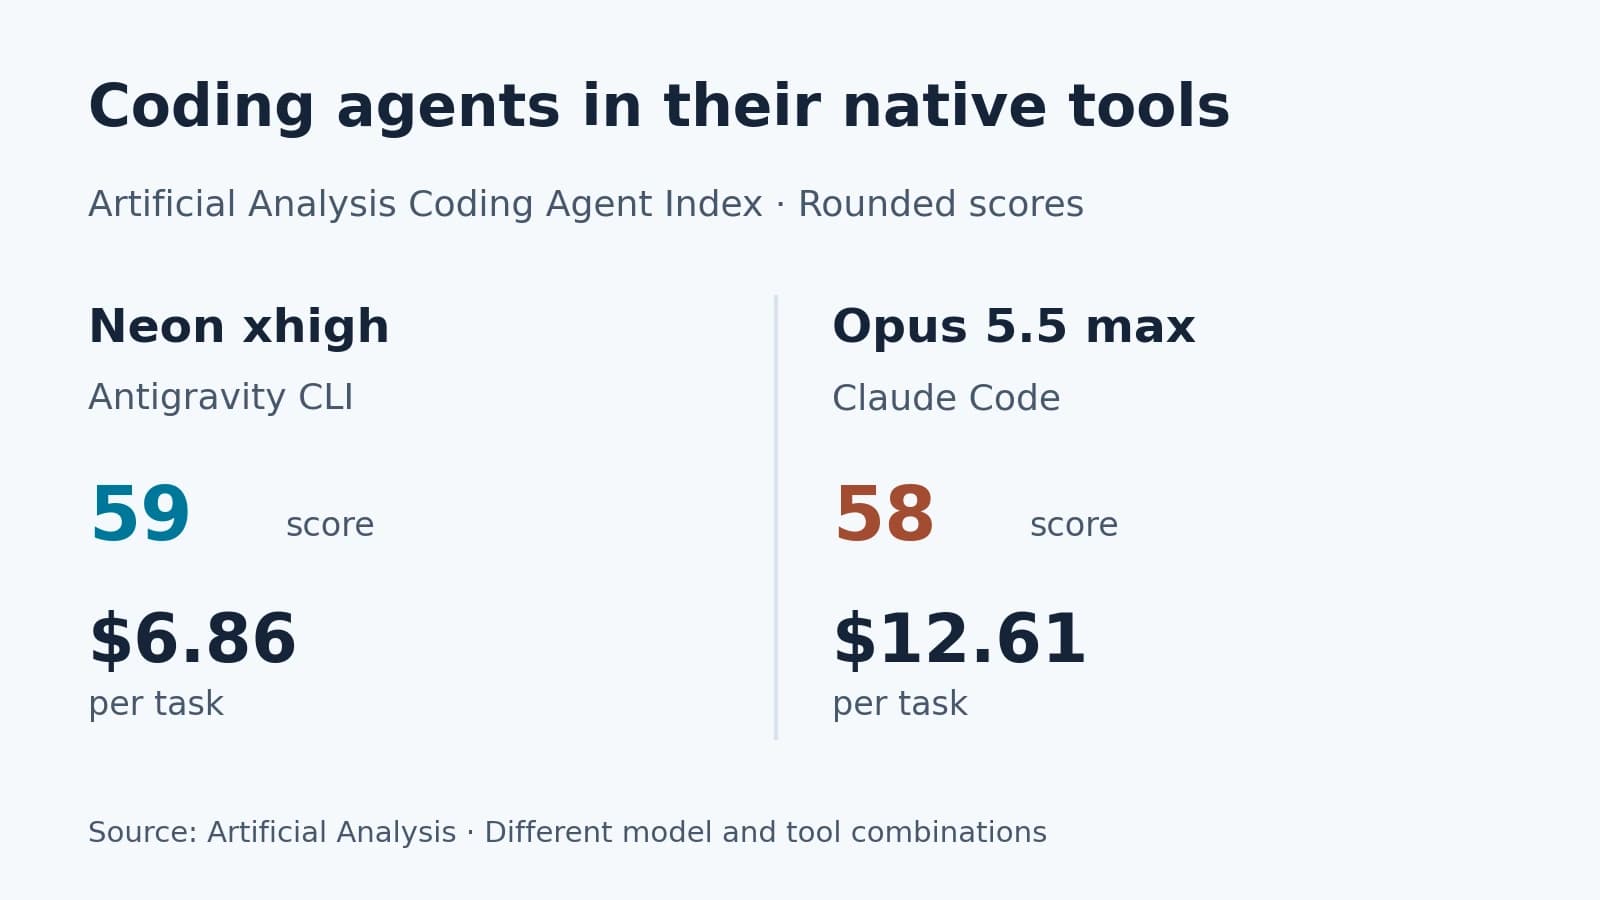
| Konfiguration in CursorBench 4.1 | Ergebnis | Ausgewiesene Kosten pro Aufgabe |
|---|---|---|
Neon medium | 57,7 % | 3,07 US-Dollar |
Opus 5.5 high | 54,5 % | 3,87 US-Dollar |
Neon high | 63,7 % | 6,54 US-Dollar |
Opus 5.5 xhigh | 56,7 % | 6,54 US-Dollar |
Neon xhigh | 65,4 % | 10,67 US-Dollar |
Opus 5.5 max | 58,1 % | 11,88 US-Dollar |
high ist auf dieser Grundlage ein guter Testkandidat. In Googles veröffentlichter Auswertung liegt Opus bei Terminal-Bench 4.1 und FrontierCode 2.0 knapp vorn. Wenn schwieriges Terminal-Debugging oder mergefähige Repository-Änderungen einen Großteil Ihrer Arbeit ausmachen, gehören solche Fälle in den eigenen Durchlauf. Benchmarks helfen bei der Auswahl der Aufgaben. Über den Wechsel entscheiden Ihre Abnahmekriterien. CursorBench-Zahlen geprüft am 19. November 2026. CursorBench · Auswertung von Google DeepMindWie stark die Agentenumgebung die Punktzahl beeinflusst
| SWE-sweep-Konfiguration | Neon | Opus 5.5 |
|---|---|---|
| Agenten-Framework des jeweiligen Anbieters | 39,0 % | 10,1 % |
| Gemeinsames Mini-SWE-Framework | 12,8 % | 3,6 % |

Mit der Agentenumgebung ändern sich die Punktzahlen und der Abstand. Google zufolge kann Antigravity CLI die Suche im Repository auf mehrere Unteragenten verteilen, was sich für Fehlersuchen wie bei SWE-sweep eignet. Testen Sie den Modellwechsel nach Möglichkeit in derselben Umgebung. Für einen IDE-Wechsel vergleichen Sie beide Werkzeugketten mit denselben Berechtigungen und Aufgaben. Erfassen Sie die Einarbeitungszeit und den Aufwand für die Codeprüfung.
Kosten je abgenommenem Patch berechnen
In diesem Rechenbeispiel mit 100 Programmieraufgaben enthalten die Gesamtkosten auch fehlgeschlagene Versuche und Wiederholungen.
| Route | Gesamte API-Kosten | Abgenommene Patches | API-Kosten pro abgenommenem Patch |
|---|---|---|---|
| Neon | $45 | 75 | $0,60 |
| Opus 5.5 | $60 | 90 | $0,67 |
| Neon mit weniger Abnahmen | $45 | 65 | $0,69 |
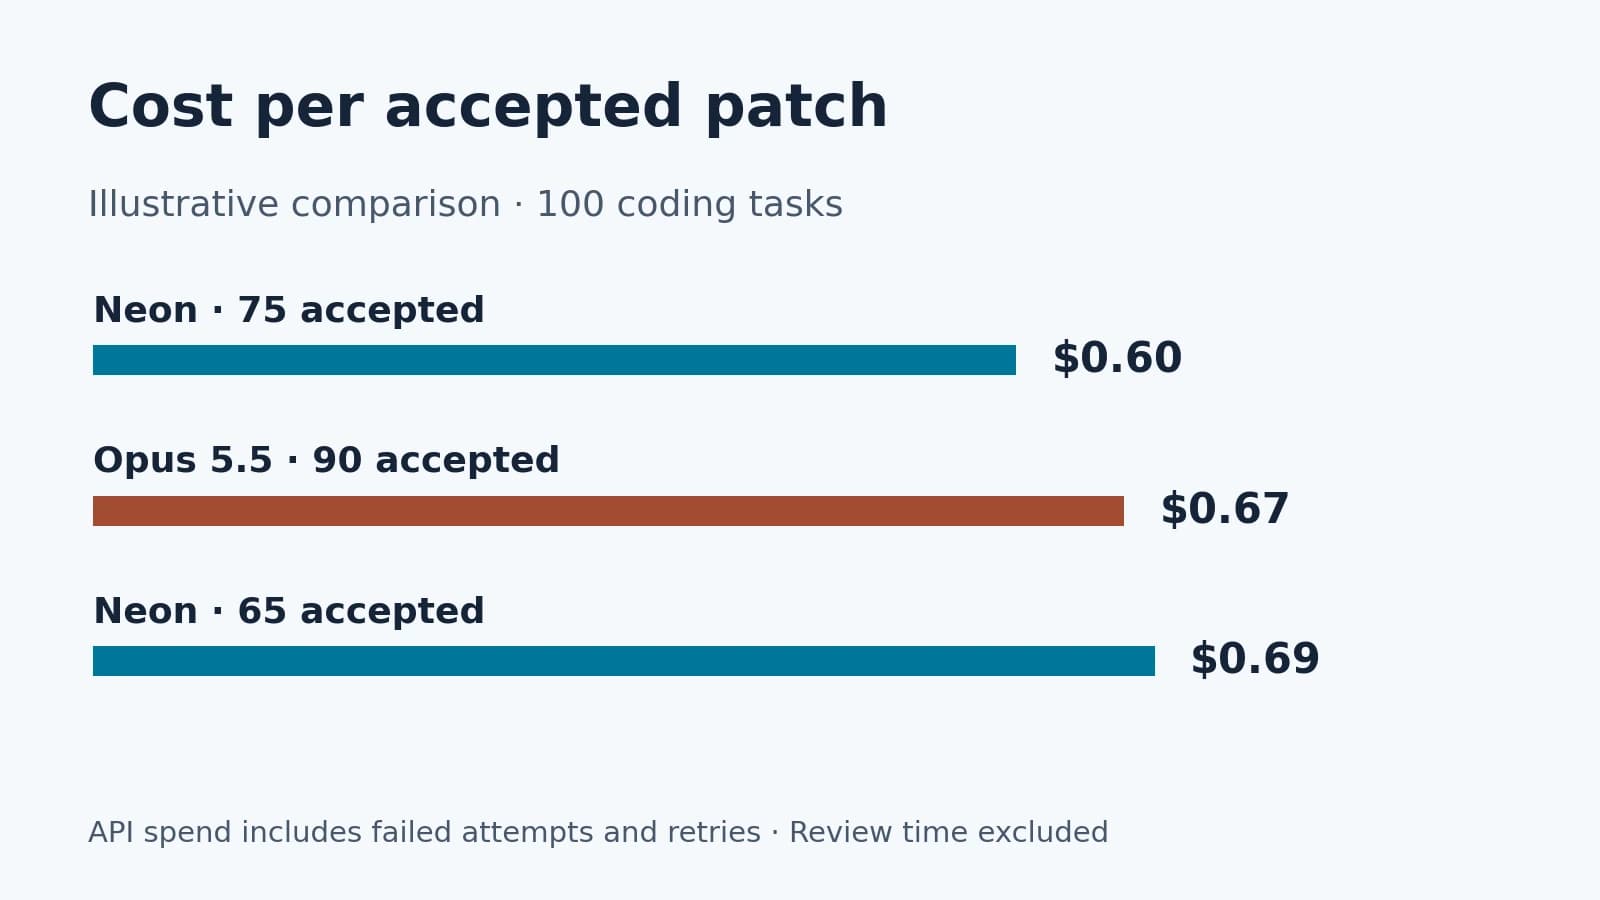
Bei unverändert 45 US-Dollar für Neon kann eine niedrigere Abnahmequote den einzelnen abgenommenen Patch teurer machen als bei Opus 5.5. Rechnen Sie Prüfzeit und manuelle Nacharbeit zu den API-Kosten hinzu. Wenn an einer gemeinsamen Schnittstelle eine Kompatibilitätsanforderung übersehen wird, kann die Korrektur mehr kosten als die Anfrage selbst.
Vor dem Anbieterwechsel die API-Anbindung prüfen
high. Opus 5.5 nutzt adaptives Denken mit medium als Standardaufwand. Testen Sie sowohl bewusst gesetzte Optionen als auch die im Betrieb vorgesehenen Standardeinstellungen. Derselbe Stufenname kann bei zwei Anbietern unterschiedlichen Rechenaufwand bedeuten. Google-Entwicklerleitfaden · Anthropic-Modelldokumentation| Integrationspunkt | Gemini 4 Neon | Claude Opus 5.5 |
|---|---|---|
| Lange Ausgabe über native API | Synchron standardmäßig insgesamt 65.536 Token für Denkprozess und Ausgabe. Long Decode in unterstützten Abläufen | Anthropic nennt maximal 128K Token Ausgabe |
| Cache-Verhalten | Implizite Cache-Treffer, regulär 0,15 US-Dollar pro Million gecachter Eingabetoken | Lesen 0,20 US-Dollar, Schreiben für fünf Minuten 5 US-Dollar oder für eine Stunde 8 US-Dollar pro Million Token |
| Zustand über mehrere Tool-Aufrufe | Interaktionszustand oder Thought Signatures nach Google-Vorgaben erhalten | Tool-Ergebnisse und Denkzustand nach Claude-Messages-Regeln behandeln |
Einen aussagekräftigen Vergleich für den Wechsel planen
Wählen Sie typische Tickets, etwa sporadisch fehlschlagende Tests mit bekanntem Auslöser. Geben Sie beiden Agenten denselben Branch, dieselbe Ticketbeschreibung, identische Tools, dasselbe Zeitbudget und denselben Testbefehl. Isolieren Sie die Versuche und prüfen Sie jeden Diff anhand derselben Checkliste, möglichst ohne den Modellnamen zu kennen.
Abnahmekriterien vor der Patch-Prüfung festlegen
Wählen Sie eine kleine Gruppe typischer Tickets mit messbarem Ergebnis. Stellen Sie Revision, Dependency-Lockfile, Repository-Anweisungen, Werkzeuge und Abbruchregeln gleich ein. Ermitteln Sie in Claude Code, welche Hooks und Befehle zu erfolgreichen Läufen beitragen. Zum Vergleich der Modelle selbst können Sie die Prüfungen in einem modellneutralen Test-Runner nachbilden.
| Prüfkriterium | Konkrete Abnahme |
|---|---|
| Funktion | Der ursprüngliche Fehler lässt sich reproduzieren und der Zieltest besteht nach der Änderung |
| Kompatibilität | Vorhandene Beispiele bestehen weiter und alte Eingaben oder Clients verhalten sich korrekt |
| Umfang | Änderungen bleiben beim Ticket. Umfangreiche Prüfungen werden nicht stillgelegt |
| Wiederaufnahme | Bei Tool-Ausfall meldet der Agent den offenen Zustand und vermeidet unsichere Doppelaktionen |
Protokollieren Sie pro ursprünglicher Aufgabe Erstversuch, endgültiges Ergebnis, Zeit bis zum prüfbaren Diff, abgerechnete Token und Review-Minuten. Gelingt die Behebung erst im zweiten Versuch, zählen beide Aufrufe. Halten Sie auch fest, ob ein Prüfer Informationen ergänzt hat. So wird der Aufwand der Wiederaufnahme sichtbar, und Sie können begründet entscheiden, wo Opus bleibt und welche Tickets Neon übernimmt.
Häufige Fragen
Ist Neon beim Programmieren besser als Opus 5.5?
Neon liegt in den genannten CursorBench-Konfigurationen vorn. Bei manchen Terminal- und Repository-Benchmarks liegt Opus vorn. Wählen Sie den Test, der Ihrer Arbeit am nächsten kommt.
Ist Neon günstiger?
Die regulären Preise für Ein- und Ausgabe sind 25 % niedriger. Die Kosten pro abgenommener Aufgabe hängen von Verbrauch, Caching, Wiederholungen und Review ab.
Sollte ich beide auf der höchsten Stufe vergleichen?
Nehmen Sie diese Einstellung bei besonders schweren Fällen hinzu. Für reguläre Anfragen sind Stufen relevant, die in Budget und Latenzrahmen passen.
Kann ich beide Modelle im selben Editor testen?
Ja, sofern der Editor beide Modelle und die nötigen Funktionen bereitstellt. So bleibt eine wichtige Variable konstant.
Reicht es, für einen laufenden Agenten den Modellnamen zu ändern?
Prüfen Sie zuerst die Integration. Tool-Nachrichten, Denkstufen und Zustandsverwaltung können sich zwischen Anbieter-APIs unterscheiden.
Welche Aufgabe eignet sich für den ersten Test?
Ein wiederkehrendes Ticket mit reproduzierbarem Fehler und eindeutigen Abnahmekriterien. Das Ergebnis hilft bei der Modellauswahl, sobald das Ticket erneut auftritt.