Access GPT Image 2 — the image model released alongside ChatGPT Images 2.0, also searched as gpt-image-2 or ChatGPT Images API — through EvoLink's unified image API. Test text-to-image, reference-image editing with masks, and the flat-rate GPT Image 2 Beta route before integrating.
OpenAI / Azure·Génération d'images·Disponible
À partir de $0.027 / 1K tokens image en sortie$0.030 prix officiel-10%
Texte vers imageImage vers imageMasque d'inpaintingTexte dans l'imageAffiche & infographieEntrée multi-références
Route productionCe taux reflète la disponibilité côté plateforme — seules les erreurs serveur confirmées (HTTP 500 / réponse vide) comptent comme échecs. Les problèmes côté utilisateur (modération de contenu, paramètres invalides, annulation) ainsi que les limites de débit, timeouts et erreurs d'authentification sont exclus. Avant l'arrivée de trafic réel, les intervalles vides peuvent apparaître comme disponibles.Live
Live
Points forts du modèle
Génération fidèle au prompt avec du texte lisible dans l'image
Cas d'usage
Publicités, affiches, infographies, créatif produit, fiches de personnage
Entrée
Prompt texte avec images de référence et masque optionnels
Upload source or reference images for image-to-image and editing. Each one adds image input tokens.
0/16 files
Size
Resolution
Budget de pixels pour le ratio choisi : 1K environ 1,05 MP, 2K environ 4,19 MP, 4K 8,29 MP.
Quality
Effort de rendu. Il détermine le nombre de tokens de sortie : c’est le principal levier de coût.
Background
Transparent keeps an alpha channel in the output. This is a Preview feature — results may be unstable.
Estimate ~$0.0281.8608 cr
medium quality + 16:9 @ 1K + 0 reference images x 1
Quoted up front, settled on the token counts the upstream usage object reports.
Prête
Historique
Les résultats sont conservés 24 heures — téléchargez ce que vous souhaitez garder.
Generated GPT Image 2 tasks will appear here.
Connaissez votre coût de test GPT Image 2 avant de créditer votre compte
Partez du coût d'un seul échantillon, choisissez un budget de test, puis chiffrez votre propre cas dans le calculateur. Les tarifs bruts par token sont en bas.
First Test Cost
GPT Image 2 - 1K - 1:1 - Low - 1 image
-10%1K Low sample
Credits0.3602
One Low-quality image, no reference images
Approx. Cost$0.0053
About … tests with $10 in credits.
In Playground, choose 1K resolution, a 1:1 aspect ratio, Low quality and 1 image with the prompt “Cat”. This is a token-based estimate; the final cost follows actual usage. Longer prompts and reference images add to the cost.
Guide du budget de test pour GPT Image 2
Choisissez un montant selon le nombre de tests prévus.
Final quality checkHigh - 2K - 1 image - prompt only
$0.386/image-10%
26.2034 cr/image·$0.429 prix officiel
Estimated cost for one generated 1:1 image. Final cost is settled against the token counts the upstream usage object reports.
Tarifs de GPT Image 2
This page serves two models and they are billed differently. Each block states its own rule, so read the badge before comparing the numbers.
GPT Image 2-10% vs officialToken-basedgpt-image-2
Billed by token, so there is no fixed per-image price. These are the raw rates; what a request actually costs depends on its size, quality, reference images and count. Use the calculator below to price your own case.
Item
Rule
Rate
Billing
Image output tokens
The generated image itself. Token count grows with the resolution tier and the quality tier.
$0.027/1K tokens-10%
1.836 cr/1K tokens$0.030 prix officiel
Output tokens
Image input tokens
Applied to each reference image in image_urls, and to a mask when one is sent.
$0.0072/1K tokens-10%
0.4896 cr/1K tokens$0.0080 prix officiel
Input tokens
Image cached input tokens
Charged only when the upstream usage object reports cached image tokens.
$0.0018/1K tokens-10%
0.1224 cr/1K tokens$0.0020 prix officiel
Input tokens
Text input tokens
Produced by the prompt itself. Typically under 1% of a request.
$0.0045/1K tokens-10%
0.306 cr/1K tokens$0.0050 prix officiel
Input tokens
Text cached input tokens
Charged only when the upstream usage object reports cached text tokens.
$0.0012/1K tokens-10%
0.0765 cr/1K tokens$0.0013 prix officiel
Input tokens
Image output tokens
The generated image itself. Token count grows with the resolution tier and the quality tier. - Output tokens
$0.027/1K tokens-10%
1.836 cr/1K tokens$0.030 prix officiel
Image input tokens
Applied to each reference image in image_urls, and to a mask when one is sent. - Input tokens
$0.0072/1K tokens-10%
0.4896 cr/1K tokens$0.0080 prix officiel
Image cached input tokens
Charged only when the upstream usage object reports cached image tokens. - Input tokens
$0.0018/1K tokens-10%
0.1224 cr/1K tokens$0.0020 prix officiel
Text input tokens
Produced by the prompt itself. Typically under 1% of a request. - Input tokens
$0.0045/1K tokens-10%
0.306 cr/1K tokens$0.0050 prix officiel
Text cached input tokens
Charged only when the upstream usage object reports cached text tokens. - Input tokens
$0.0012/1K tokens-10%
0.0765 cr/1K tokens$0.0013 prix officiel
EVOLINK · PRICE EST.gpt-image-2
× 1 · real-time
Figures are estimates. Final charges are based on actual token usage.
Your estimate
~$0.0050.360
Per $10
≈ 1,806 images
low quality · 1K · 1:1
Official· saves ~10%
~$0.0060.400
Tokens per image
image output196
image input0
text input0
Quality
Size
Resolution
Aspect
Count
1
Ref images
0
Prompt
0 chars · ~0 tokens
GPT Image 2 BetaFlat per callgpt-image-2-beta
One flat rate per call, whatever the aspect ratio - no token accounting and nothing to estimate. Auto or aspect-ratio sizes at the 1K tier only, one image per call. The OpenAI list price has no equivalent for this route, so no official comparison is shown.
Item
Rule
Rate
Billing
1K output
Any aspect ratio or auto, at the 1K tier. One image per call, regardless of prompt length or reference images.
$0.015/image
1.02 cr/image
Per call
1K output
Any aspect ratio or auto, at the 1K tier. One image per call, regardless of prompt length or reference images. - Per call
$0.015/image
1.02 cr/image
Per $10
≈ 637 images
1K each
Ce que GPT Image 2 sait créer
Générez des images haute fidélité depuis un prompt texte ou des images de référence, avec de solides mises en page d'affiches, des infographies denses, des fiches de personnage, du créatif produit et des workflows d'édition guidés par masque.
GPT Image 2 a été lancé en même temps que ChatGPT Images 2.0 et est disponible via l'API sous l'ID de modèle gpt-image-2. Utilisez-le pour la génération riche en texte et l'édition haute fidélité ; ChatGPT peut y ajouter de l'orchestration et des outils distincts du modèle d'image brut.
Idéal pour: Génération riche en texte et édition d'image haute fidélité · Base de coût: Prompt, taille, qualité et images de référence en entrée · Limite de sortie: Tailles personnalisées jusqu'à un côté de 3840 px ; les grandes sorties sont expérimentales
Route officielle facturée au token avec les qualités low/medium/high, les résolutions 1K/2K/4K, des tailles en pixels explicites, n jusqu’à 10 et un masque d’inpainting.
GPT Image 2 Beta
gpt-image-2-beta
Route alternative à prix fixe d’EvoLink : chaque image 1K coûte le même prix quelle que soit la longueur du prompt ou les références, une image par appel.
Deux façons d’utiliser GPT Image 2 : API EvoLink ou Agent
Utilisez l’API EvoLink pour intégrer le modèle à un produit ou traiter des lots, ou appelez-la depuis Codex, Claude ou Gemini pour des workflows créatifs et de développement rapides. Les deux méthodes partagent la même clé API EvoLink, le même solde, les mêmes routes de modèle et le même historique de tâches.
Option 1
Intégrer avec l’API EvoLink
Idéal pour : backends produit, tâches par lots, workflows automatisés
Appelez l’API image unifiée d’EvoLink depuis votre serveur et contrôlez l’ID du modèle, les paramètres, la file de tâches, les callbacks et le stockage des résultats.
1Tester le rendu et le coût avec un brief réel dans le Playground
2Créer une clé API EvoLink dans la console
3Choisir l’ID de modèle adapté à votre tâche parmi les cartes de routes ci-dessus
4Soumettre la tâche et récupérer le résultat par polling ou callback HTTPS
Idéal pour : création et développement dans Codex, Claude et Gemini
Donnez à l’Agent l’objectif, les ressources et les critères de validation. Il choisit la route, construit la requête, suit la tâche et renvoie le résultat sans vous obliger à coder chaque étape.
1Définir EVOLINK_API_KEY dans l’environnement local, jamais dans le code ni dans un prompt
2Décrire l’objectif, les références et les paramètres clés
3Demander à l’Agent d’appeler une route GPT Image 2 et d’enregistrer le task ID
4Laisser l’Agent suivre l’état final, télécharger le résultat et expliquer les échecs
Aperçu des résultats de GPT Image 2
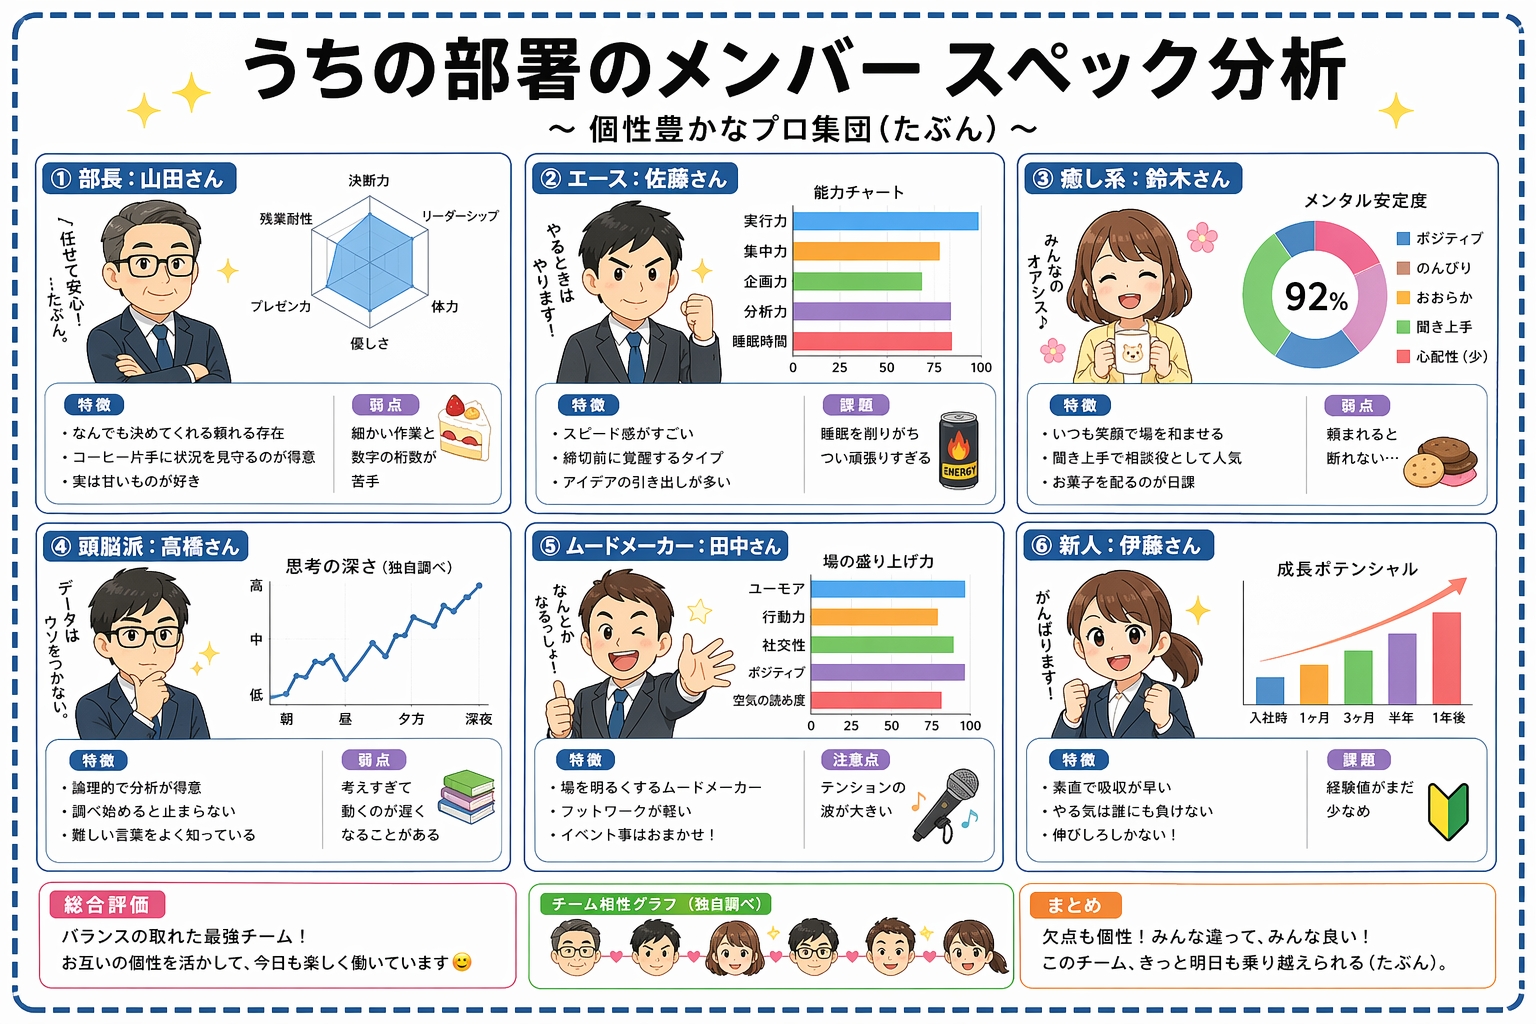
Lisibilité du texte améliorée dans les mises en page denses
Graphiques, libellés et textes multi-colonnes peuvent être rendus plus lisiblement dans l'image, ce qui réduit les retouches typographiques.
Sortie d'exemple ; les résultats réels varient selon le prompt et les réglages.
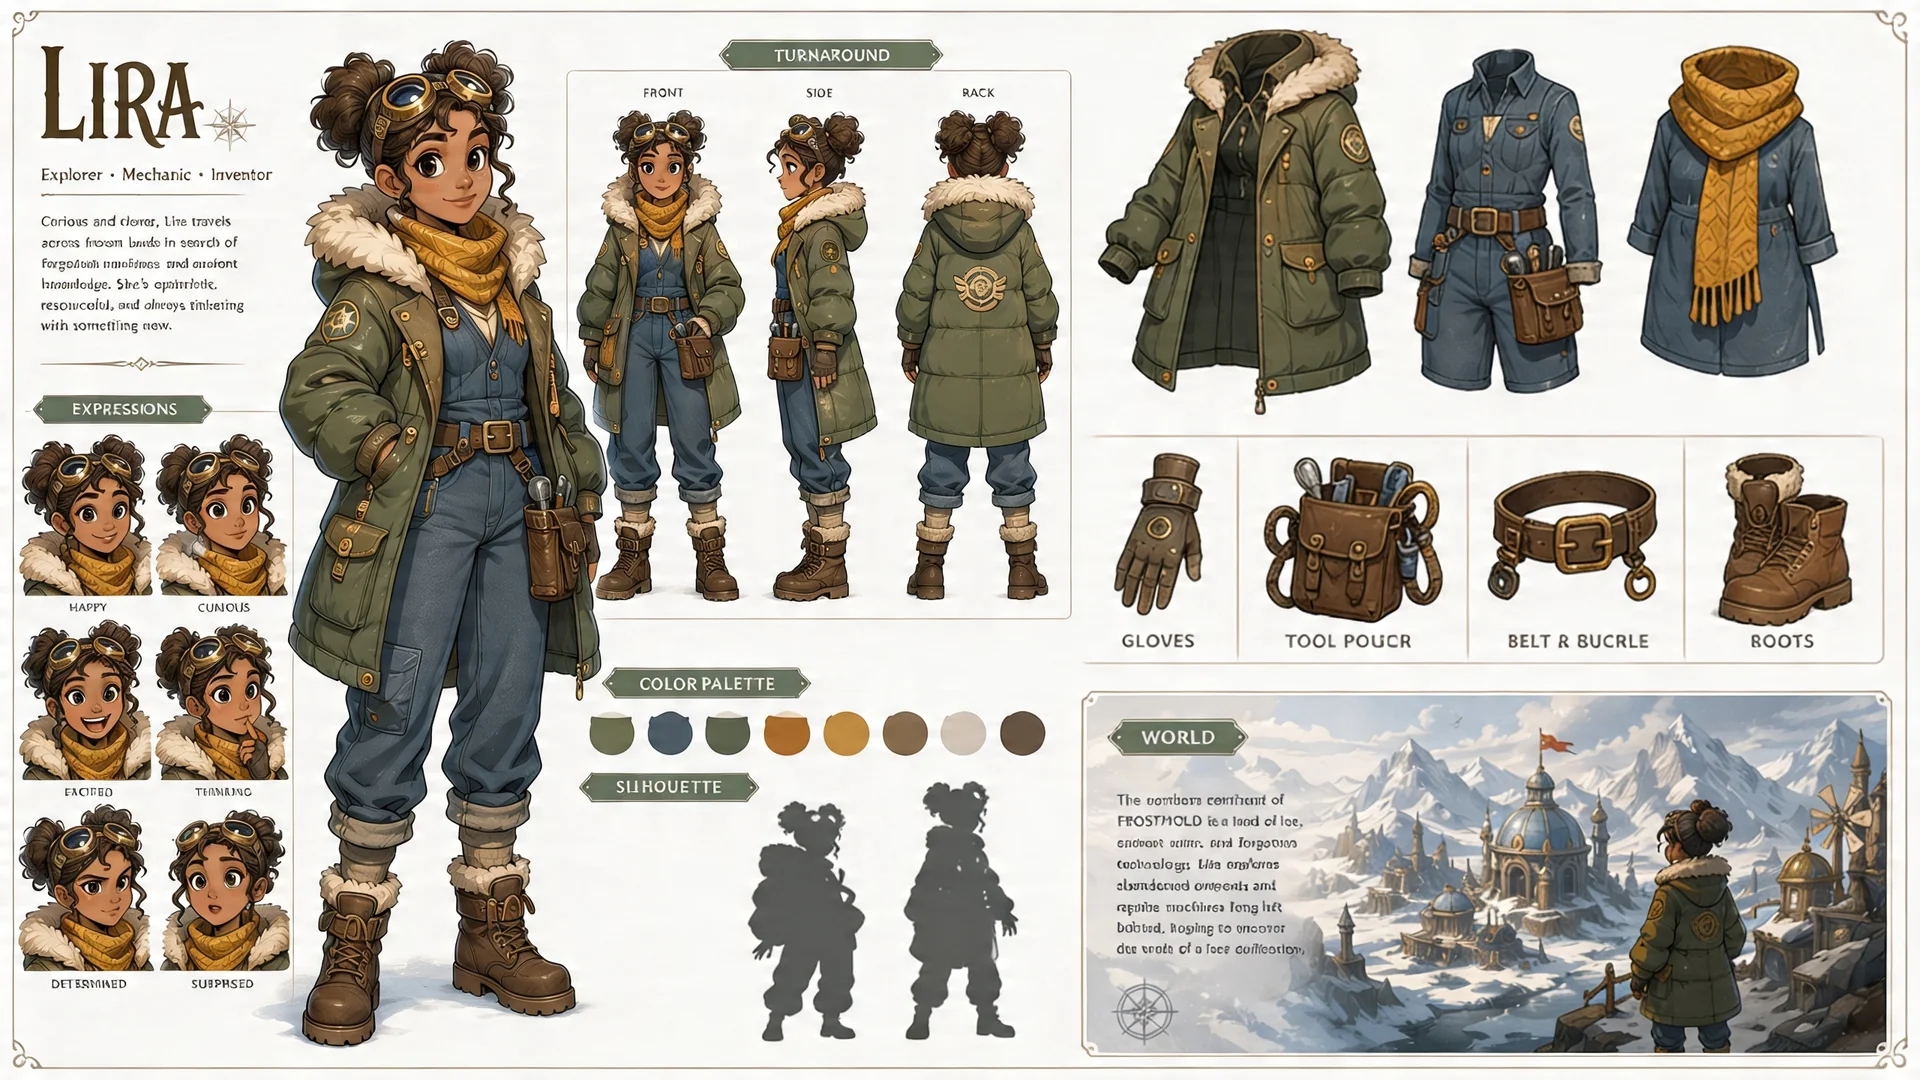
Fiches de personnage multi-panneaux
Vues de rotation, grilles d'expressions et détails d'équipement peuvent conserver une cohérence plus forte au sein d'une même image.
Sortie d'exemple ; les résultats réels varient selon le prompt et les réglages.
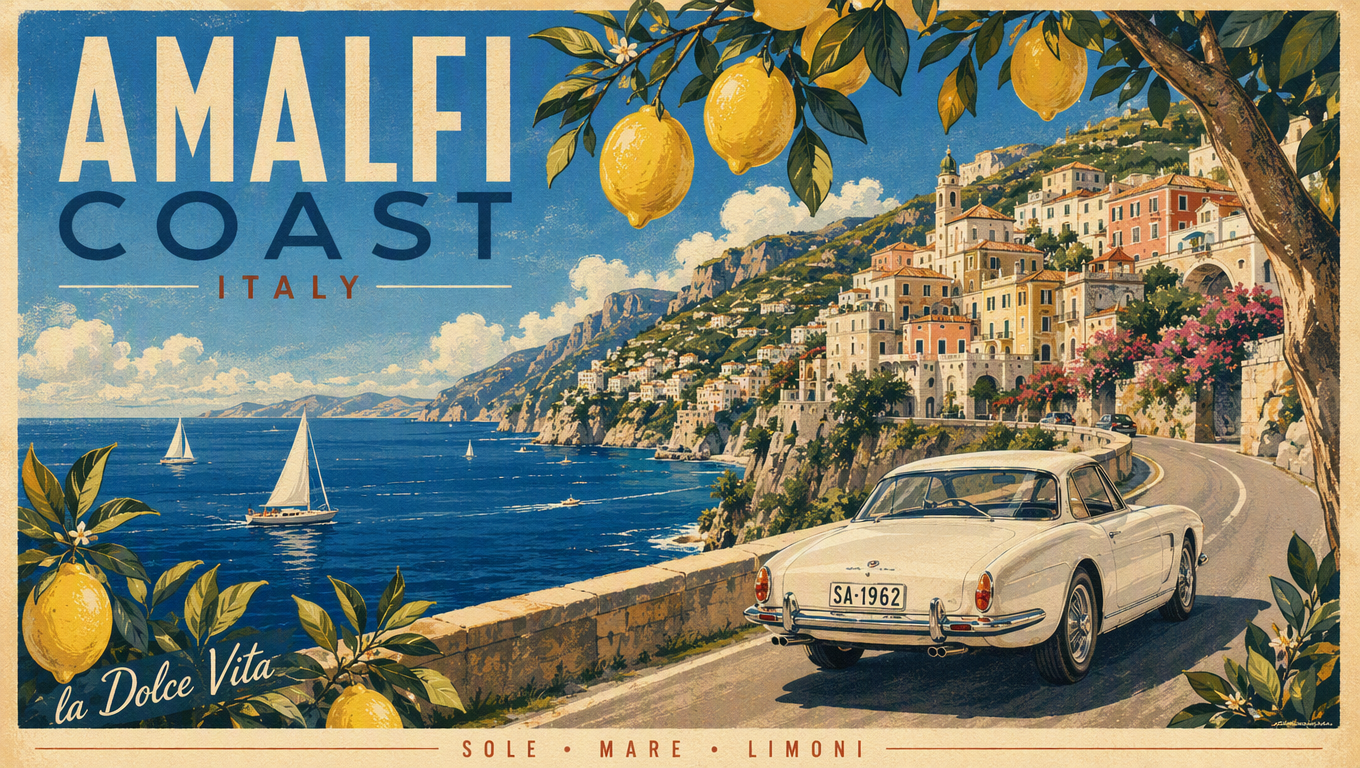
Composition et typographie de niveau affiche
Titre, accroche et bloc de crédits suivent de plus près la mise en page demandée par le prompt, avec une hiérarchie digne du print.
Sortie d'exemple ; les résultats réels varient selon le prompt et les réglages.
Ce que vous pouvez faire avec GPT Image 2
Affiches et infographies riches en texte avec GPT Image 2
Faites rendre titres, accroches, libellés de graphiques et textes multi-colonnes directement dans l'image — la charge de travail pour laquelle GPT Image 2 est le plus discuté.
Fiches de personnage et identités visuelles cohérentes avec GPT Image 2
Vues de rotation, grilles d'expressions et détails d'équipement dans une seule image, avec des images de référence qui conservent la même identité d'une génération à l'autre.
Photos produit e-commerce et publicités style UGC avec GPT Image 2
Transformez une photo produit en visuels principaux, mockups de packaging, scènes lifestyle et créations publicitaires où le produit reste reconnaissable.
Visuels de campagne en lot via l'API GPT Image 2
Générez jusqu'à 10 variations par requête et scriptez des séries de campagne complètes, avec un style unique sur tout le lot.
Édition par référence, transfert de style et masques dans GPT Image 2
Pilotez le style, la cohérence du sujet ou la transformation avec jusqu'à 16 images dans image_urls, ou ne repeignez que la zone masquée avec un PNG alpha.
Premières images pour workflows vidéo IA depuis GPT Image 2
Générez ici l'image clé, puis animez-la avec Seedance sur la même clé API — un workflow assez recherché pour avoir son propre guide ci-dessous.
API GPT Image 2 : exemple de code et gestion des erreurs
Cet exemple montre le flux exécutable minimal : créer une tâche, enregistrer le task ID retourné, puis effectuer un polling ou attendre un callback HTTPS. Consultez l’onglet API pour tous les paramètres et formats de réponse.
curl -X POST https://api.evolink.ai/v1/images/generations \
  -H "Authorization: Bearer $EVOLINK_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2",
    "prompt": "A colorful sunset over the ocean, painterly style",
    "size": "auto",
    "resolution": "1K",
    "quality": "medium",
    "n": 1,
    "callback_url": "https://your-domain.com/webhooks/image-task-completed"
  }'

# Save the returned task ID, then query:
curl https://api.evolink.ai/v1/tasks/{task_id} \
  -H "Authorization: Bearer $EVOLINK_API_KEY"
Échec de validation des paramètres
Vérifiez chaque valeur avec les cartes de paramètres ci-dessus : plages, options autorisées, nombre de ressources et formats de fichiers doivent correspondre à la route choisie.
Problème d’authentification ou de solde
Vérifiez le jeton Authorization Bearer, le solde disponible et la facturation de la tâche dans la console.
Contenu ou ressource refusé
Vérifiez les droits à l’image, les éléments de marque, le texte lisible, le contenu sensible et la conformité des ressources.
Tâche échouée ou expirée
Une tâche GPT Image 2 dont l’état final est « échoué » n’est pas facturée. Conservez le task ID et identifiez s’il s’agit d’un problème de validation, de modération ou d’exécution avant de relancer.
Callback non reçu
callback_url doit être une URL HTTPS publique, et non localhost ou une adresse de réseau privé. Conservez toujours le task ID comme solution de repli pour le polling.
Choisir le bon modèle d’image : GPT Image 2 et alternatives
Critère
GPT Image 2
Nano Banana
Seedream
Prix de départ
~$0.048 / image
Options moins chères
Paliers par image
Modèle de facturation
Au token
Par image générée
Par image selon le palier
Qualité de sortie
Low / Medium / High x 1K / 2K / 4K
1K / 2K / 4K selon le modèle
1K / 1.5K / 2K
Entrée de référence
Jusqu'à 16 images plus masque
Dépend du modèle
Jusqu'à 10 images
Idéal pour
Affiches, infographies, texte dans l'image
Génération d'images haute qualité
Publicité, créatif produit, édition d'images
Prix de départ
GPT Image 2~$0.048 / image
Nano BananaOptions moins chères
SeedreamPaliers par image
Modèle de facturation
GPT Image 2Au token
Nano BananaPar image générée
SeedreamPar image selon le palier
Qualité de sortie
GPT Image 2Low / Medium / High x 1K / 2K / 4K
Nano Banana1K / 2K / 4K selon le modèle
Seedream1K / 1.5K / 2K
Entrée de référence
GPT Image 2Jusqu'à 16 images plus masque
Nano BananaDépend du modèle
SeedreamJusqu'à 10 images
Idéal pour
GPT Image 2Affiches, infographies, texte dans l'image
Size et resolution fonctionnent ensemble dans GPT Image 2
En mode ratio, le palier de résolution fixe le budget de pixels (1K environ 1,05 MP, 2K environ 4,19 MP, 4K exactement 8,29 MP). En mode auto ou pixels personnalisés, resolution est ignoré.
Quality dans GPT Image 2 signifie effort de rendu
Low, medium et high déterminent le nombre de tokens de sortie consommés. Itérez vos prompts en low, puis passez le rendu final en high.
La facturation de GPT Image 2 suit l'objet usage
Les crédits sont débités selon les tokens rapportés par l'objet usage en amont : devis avant exécution, règlement sur les chiffres réels ensuite.
Principaux paramètres de requête de GPT Image 2
Les champs qui déterminent la sortie et le coût sur POST /v1/images/generations. La génération est asynchrone : interrogez le task ID renvoyé ou utilisez un callback, et sauvegardez vite les résultats, car les liens d'image restent valides 24 heures. Les schémas complets et les exemples de code se trouvent dans l'onglet API.
Paramètre
Type
Rôle
model
string · requis
'gpt-image-2' pour la route officielle facturée au token, ou 'gpt-image-2-beta' pour la route 1K à prix forfaitaire.
prompt
string · requis
L'instruction texte. Les tokens du prompt sont comptés comme entrée texte sur la route au token.
size
string · auto par défaut
'auto', l'un des 15 ratios comme 1:1 ou 16:9, ou des pixels WxH explicites en multiples de 16.
resolution
string · 1K / 2K / 4K
Budget de pixels en mode ratio ; ignoré quand size est auto ou en pixels explicites.
quality
string · low / medium / high
Effort de rendu. Détermine la consommation de tokens de sortie sur la route au token — itérez en low, passez le rendu final en high.
background
string · opaque / transparent
Canal alpha de la sortie. Par défaut opaque ; transparent est en Preview et les résultats peuvent être instables.
output_format
string · png / jpeg / webp
Format de fichier de l'image renvoyée. Par défaut png ; s'applique à la génération et à l'édition. Une sortie transparente exige png ou webp.
n
integer · 1–10
Images par requête sur gpt-image-2 ; le coût augmente linéairement. GPT Image 2 Beta renvoie une image par appel.
image_urls
array · jusqu'à 16
Images de référence pour l'image-to-image et l'édition. Chacune ajoute des tokens d'entrée image.
mask_url
string · optionnel
PNG à canal alpha dont les dimensions en pixels correspondent à l'image de référence ; les zones transparentes sont régénérées.
callback_url
string · optionnel
Webhook HTTPS qui reçoit le résultat de la tâche, en alternative au polling.
Limites de production de GPT Image 2 à anticiper
Texte et mise en page à vérifier
Le rendu du texte s'est amélioré, mais le placement exact, la netteté et la composition structurée peuvent encore s'écarter du prompt.
Les grandes sorties sont expérimentales
Les tailles personnalisées peuvent atteindre un côté de 3840 px, mais les sorties dépassant 3 686 400 pixels au total — le nombre de pixels de 2560x1440 — sont pour l'instant expérimentales.
Le fond transparent est en Preview
background: "transparent" est disponible, mais encore en Preview — les résultats peuvent être instables.
Les requêtes complexes peuvent être plus longues
OpenAI indique que les prompts complexes peuvent nécessiter jusqu'à deux minutes de traitement.
La facturation au token est la partie de GPT Image 2 la plus difficile à budgéter : les tokens de sortie image augmentent avec la résolution et le palier de qualité, chaque image de référence ajoute des tokens d'entrée, et le prompt lui-même est comptabilisé. EvoLink en fait un chiffre annoncé avant l'envoi — le calculateur de prix et le Playground tarifent exactement la combinaison de taille, résolution, qualité et références que vous vous apprêtez à envoyer.
Cela change votre façon de tester : itérez vos prompts sur le palier low, observez l'effet de chaque modification sur l'estimation, et ne passez en high que le rendu final — au lieu de découvrir la structure des coûts sur la facture de fin de mois.
Sous le prix catalogue OpenAI, ligne par ligne
La section tarifs de cette page place le tarif EvoLink à côté du prix officiel OpenAI pour chaque type de token — sortie image, entrée image, entrée en cache et texte — et affiche l'économie actuelle ligne par ligne, avec la garantie du prix le plus bas d'EvoLink.
Comme la comparaison est calculée à partir des prix SKU en direct et non d'un argument marketing, vous pouvez la vérifier au moment d'intégrer, puis la recontrôler dès que votre volume rend l'écart significatif.
Deux routes de facturation sur une page
gpt-image-2 et gpt-image-2-beta sont servis côte à côte : la route officielle facturée au token, avec toute la surface 1K/2K/4K, paliers de qualité, masque et multi-références, et une route au forfait où chaque image 1K coûte le même prix, quelle que soit la longueur du prompt ou le nombre de références.
En pratique, les équipes placent brouillons, itération de prompts et lots 1K sur la route au forfait, au coût parfaitement prévisible, et réservent la route au token aux rendus finaux 2K/4K, aux masques et aux éditions riches en références. Basculer, c'est changer de model ID, pas migrer de fournisseur.
Une clé API pour les routes image, vidéo, audio et LLM
La même clé API qui appelle gpt-image-2 appelle aussi Seedance pour la vidéo, Nano Banana 2 et Seedream comme routes image alternatives, et le catalogue LLM — un seul solde, un seul historique de tâches, un seul chemin d'authentification.
C'est décisif pour l'image justement parce que les pipelines s'arrêtent rarement à une image fixe : générez l'image clé avec GPT Image 2, animez-la avec Seedance, et repliez-vous sur un autre modèle image quand une tâche s'y prête mieux — sans maintenir des comptes, clés et relevés de facturation séparés par fournisseur.
Un état des tâches auditable avant de payer
Chaque génération se déclare soumise, en cours, terminée ou en échec, avec le détail des erreurs dans la réponse et la console. Les tâches en échec ne sont pas comptées comme des générations facturables réussies : un lot de tâches raté ne se transforme pas discrètement en facture.
Pour les systèmes en production, c'est la différence entre « requête envoyée » et « image livrée » : interrogez la tâche, vérifiez l'état final, et rapprochez les dépenses des enregistrements par tâche dans la console quand vous devez justifier un chiffre.
Famille de modèles GPT Image
Comparez les générations GPT Image avec un seul compte et une seule clé API EvoLink, puis choisissez selon la qualité de sortie, la latence et le coût.
Générez des images haute fidélité depuis un prompt texte ou des images de référence, avec de solides mises en page d'affiches, des infographies denses, des fiches de personnage, du créatif produit et des workflows d'édition guidés par masque.
GPT Image 1.5
Route image OpenAI précédente, tailles fixes de classe 1024, facturation au token et comportement de production éprouvé.
Quel est le lien entre GPT Image 2 et ChatGPT Images 2.0 ?
GPT Image 2 est le modèle d'image accessible par API lancé en même temps que ChatGPT Images 2.0, avec l'ID de modèle gpt-image-2. ChatGPT peut combiner la génération d'images avec du raisonnement, de la recherche web ou de l'orchestration multi-images ; le modèle API brut ne doit donc pas être considéré comme identique à chaque workflow produit de ChatGPT.
Quelle est la différence entre GPT Image 2 et GPT Image 2 Beta ?
Ce sont deux variantes de route distinctes chez EvoLink. gpt-image-2 utilise la route officielle facturée au token, avec les qualités low/medium/high, les résolutions 1K/2K/4K, des pixels WxH explicites, n jusqu'à 10 et un masque d'inpainting. gpt-image-2-beta est la route alternative à prix fixe d'EvoLink pour une sortie 1K et une image par appel ; ce n'est pas un ID de modèle officiel OpenAI.
Combien coûte GPT Image 2 ?
La facturation se fait au token. Les tokens de sortie image dominent la facture et augmentent avec les paliers de résolution et de qualité ; les tokens d'entrée image s'ajoutent par image de référence ; les tokens d'entrée texte viennent du prompt. Le Playground estime la combinaison choisie avant l'envoi. Pour un prix fixe par image, GPT Image 2 Beta facture un forfait par appel, et le calculateur de tarifs estime votre coût par image.
Comment les tarifs EvoLink de GPT Image 2 se comparent-ils à ceux d'OpenAI ?
La section tarifs compare le tarif EvoLink actuel au prix catalogue OpenAI et affiche l'économie disponible au moment où vous consultez. Utilisez le calculateur pour votre combinaison exacte de taille, de qualité et d'images de référence plutôt que de vous fier à une affirmation universelle par image.
Faut-il utiliser l'Image API ou la Responses API pour GPT Image 2 ?
Avec l'Image API, choisissez directement gpt-image-2 pour la génération ou l'édition. Avec la Responses API, choisissez un modèle principal qui prend en charge l'outil image_generation ; l'outil gère la sélection du modèle d'image pour les workflows conversationnels ou multi-étapes. EvoLink propose sa propre route unifiée pour l'accès direct au modèle.
Puis-je prévisualiser avant d'intégrer l'API ?
Oui. Utilisez le Playground pour tester la qualité, estimer les crédits et inspecter le JSON de requête avant de l'intégrer à votre produit.
Quelle est la différence entre size et resolution ?
size choisit la forme — auto, l'un des 15 ratios ou des pixels WxH explicites. resolution ne fixe le budget de pixels qu'en mode ratio, et est ignoré en auto ou en pixels explicites.
Les images de référence sont-elles facturées ?
Oui. Chaque image dans image_urls ajoute des tokens d'entrée image. Un masque est réservé comme une image d'entrée supplémentaire au moment du devis, puis régularisé sur l'usage réel en amont.
Quelles sont les limites des tailles en pixels personnalisées ?
La largeur et la hauteur doivent être des multiples de 16, le total de pixels doit être compris entre 655 360 et 8 294 400, aucun côté ne doit dépasser 3840 px, et le ratio doit rester entre 1:3 et 3:1. Les sorties dépassant 3 686 400 pixels au total — le nombre de pixels de 2560x1440 — sont pour l'instant expérimentales.
Puis-je générer plusieurs images en une requête ?
Sur gpt-image-2 oui — n accepte 1 à 10 et le coût évolue linéairement. GPT Image 2 Beta renvoie une seule image par appel.
Comment fonctionne le masque d'inpainting ?
mask_url attend un PNG avec canal alpha dont les dimensions correspondent exactement à l'image de référence. Les pixels transparents marquent la zone à régénérer, les pixels opaques sont préservés. Envoyé sans image de référence, le masque est ignoré.
Que faire si une génération échoue ?
Consultez l'état de la tâche et le détail de l'erreur dans la réponse ou la console. Une tâche en échec ne doit pas être comptée comme une génération facturable réussie.
Quelles sont les principales limites de GPT Image 2 ?
Les prompts complexes peuvent prendre jusqu'à deux minutes. Le placement du texte, la cohérence des personnages récurrents et la composition structurée précise peuvent encore demander des itérations.