OpenAI Agents API vs Agents SDK : lequel choisir ?

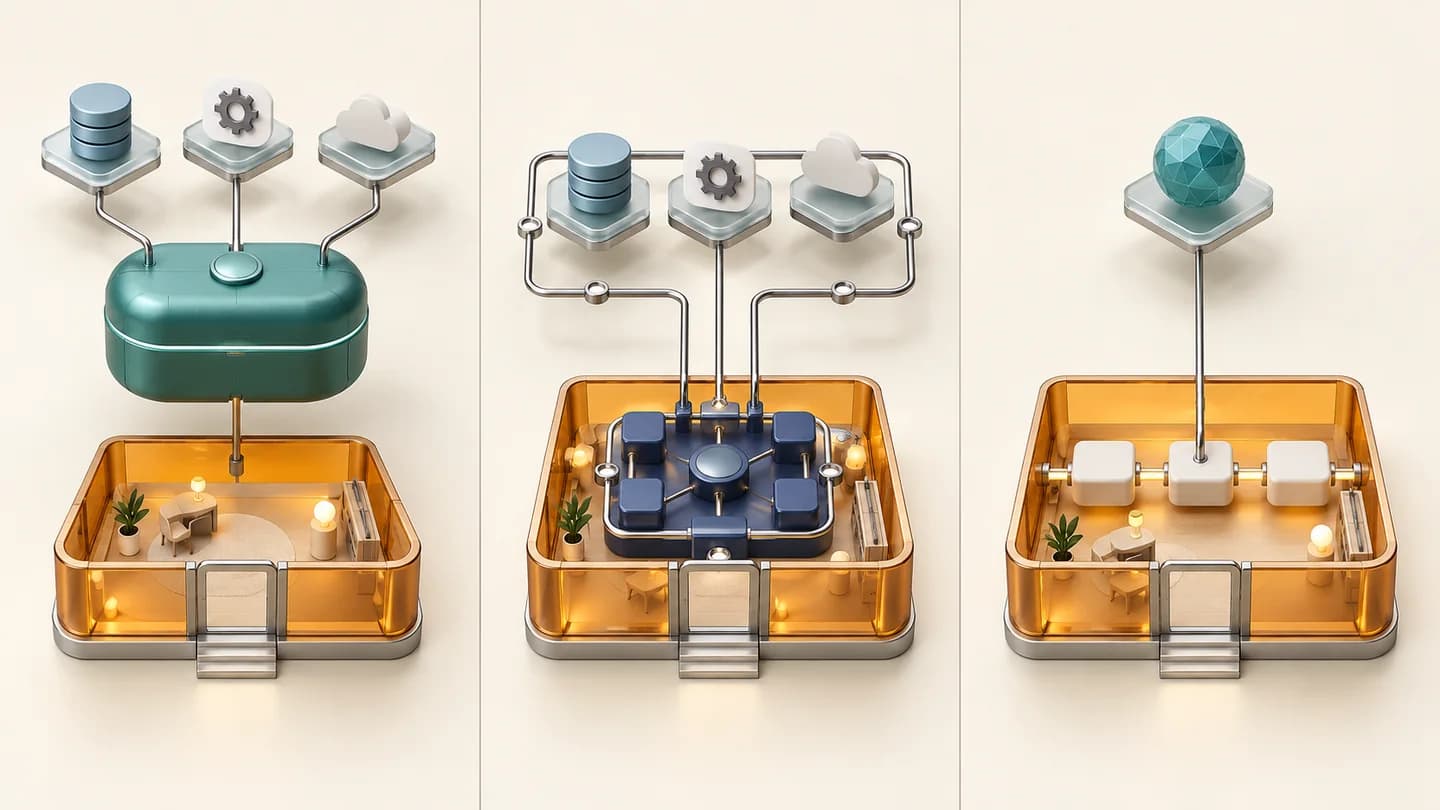
Agents API vs Agents SDK vs Responses : qui exécute quoi ?
| Décision | Agents API | Agents SDK | Responses API directe |
|---|---|---|---|
| Qui exécute l'orchestration ? | Service géré par OpenAI | Votre application avec le SDK | Application ou moteur de workflow existant |
| Où est conservé l’état du travail en cours ? | Sessions gérées reliées aux tâches métier | Intégration de session/état choisie | Fiche de workflow et fonctions d'état API utilisées |
| Comment exécuter les outils métier ? | Les gestionnaires applicatifs exécutent toujours les fonctions | Outils SDK intégrés au code applicatif | Votre répartiteur traite les outils à votre charge |
| Principal compromis d'ingénierie ? | Moins d'exploitation, frontière d'un service externe | Contrôle de l'exécution et responsabilité de déploiement | Composition directe et propriété explicite du workflow |
| Qu’est-ce qui reste réutilisable après un changement de moteur ? | Seulement ce qui reste portable hors du service | Données métier et adaptateurs indépendants | Données métier et contrats de workflow conservés |
La dernière ligne est une recommandation d'architecture. Aucun nom de produit ne garantit la portabilité. L'implémentation d'un outil peut être réutilisable alors que les enregistrements de ses appels en attente, son état d’approbation et son enveloppe de résultat nécessitent une adaptation.
Agents API va-t-elle remplacer LangGraph ou votre framework ?
Cela dépend de ce que le framework fait dans votre produit. S'il entretient surtout une boucle générique modèle/outils, un moteur géré peut remplacer beaucoup de travail. S'il encode routage métier, transitions d'approbation, échéances et état métier durable, ces responsabilités doivent toujours être prises en charge.
Un workflow de documents d'assurance peut extraire des données, attendre un examinateur autorisé et transmettre le résultat validé. Le raisonnement peut changer de moteur sans changer les personnes habilitées à approuver. Remplacer tout le workflow parce qu'une étape est devenue gérée confond politique métier et infrastructure.
Classez chaque composant en règle métier, mécanisme d'exécution ou adaptateur d'intégration. Identifiez ensuite les mécanismes réellement remplaçables. L'estimation de migration sera plus utile qu'un décompte des lignes de deux quickstarts.
Une architecture hybride est légitime : gardez un workflow externe déterministe et déléguez une investigation bornée à Agents API. Définissez une entrée, les preuves attendues et une condition de retour. Évitez que workflow externe et moteur interne décident séparément de répéter la même écriture.
Ce raisonnement ne prétend ni que tous les frameworks cités sont dépourvus de fonctions gérées, ni qu'un framework est obsolète. Il concerne votre répartition des responsabilités, pas un classement universel.
Sessions, mémoire et approbations : trois états à distinguer
RunState. La différence porte sur qui déploie et exploite ces mécanismes, pas sur l'existence de mémoire ou d'approbations.Pour un assistant de remboursement, distinguez conceptuellement :
| Enregistrement | Exemple de contenu | Pourquoi la conversation ne suffit pas |
|---|---|---|
| Contexte de travail | Preuves et explication candidate | Aide le raisonnement, mais ne constitue pas le dossier d’autorisation |
| État d'exécution | Exécution actuelle, appel d’outil en attente, référence de continuation | Indique où reprendre |
| État métier | Client, montant proposé, examinateur, identifiant final de transaction | Établit ce qui était autorisé et ce qui a eu lieu |
Ce sont des catégories applicatives proposées, pas trois tables obligatoires ni un schéma OpenAI. Elles permettent de vérifier l'autorisation avant d'agir à la reprise. Si le client annule pendant l'attente, reprendre l'exécution ne doit pas réactiver l'ancienne permission.
Reliez la session gérée au travail métier. Avec le SDK, choisissez le stockage des sessions et des exécutions suspendues, puis leur récupération par un worker. Avec Responses, définissez la continuation équivalente dans le workflow existant. Testez toujours un redémarrage de processus pendant l'approbation : une démo en mémoire ne prouve pas la reprise.
Une sandbox privée équivaut-elle à tout auto-héberger ?
Cartographiez les flux réels. Pour une investigation sur base de données, distinguez requête, lignes renvoyées, résultat d'outil transmis au modèle et trace conservée. Une base dans un VPC ne signifie pas que le résultat de la requête n'en sort jamais.
Et si le choix entre plusieurs modèles est indispensable ?
Séparez interface de modèle et interface d'exécution. Une passerelle donnant accès à plusieurs modèles simplifie leur choix, mais n'unifie pas automatiquement tous les cycles de session ou protocoles d'outils.
Procédez en deux temps : comparez d'abord les moteurs avec le même modèle, les mêmes outils, données et critères d’acceptation lorsque c'est possible ; comparez ensuite les modèles dans l'architecture retenue. Si un candidat exige un autre modèle ou d'autres outils, présentez le résultat comme une comparaison de systèmes complets, sans attribuer tout gain au moteur.
Pour une route SDK, vérifiez les capacités effectives de l'adaptateur : messages, arguments et résultats d'outils, sortie structurée, streaming, données de consommation et gestion des erreurs. Une réponse textuelle ne prouve pas la compatibilité d'un agent fortement outillé. La flexibilité des fournisseurs du SDK ne signifie pas qu'Agents API accepte tout modèle de passerelle.
La frontière utile pour un repli est souvent une nouvelle tâche métier. Dirigez-la vers une alternative vérifiée avec un nouvel enregistrement d'exécution. Transférer une session en cours exige conversion d'état et politique de rejeu ; changer la base URL n'en tient pas lieu.
Choisir selon la tâche, y compris garder l'existant
| Tâche et système existant | Premier candidat | Pourquoi | Motif de changement de choix |
|---|---|---|---|
| Petite équipe, recherches de durée variable, peu d'orchestration | Agents API | Exploiter un moteur serait une charge nouvelle importante | Frontière de données incompatible ou aucun gain de qualité/exploitation |
| Produit avec approbations spécifiques et workers | Agents SDK | Exécution proche des contrôles existants | Exploitation des workers et de l'état plus coûteuse que le contrôle gagné |
| Moteur fiable avec quelques étapes de modèle fixes | Responses directe | Réutilisation de la machine à états | Boucle adaptative nécessaire, trop coûteuse à maintenir |
| Fichiers nombreux et calcul interne spécialisé | SDK ou API gérée avec environnement propre | Les deux méritent un test sur l'infrastructure réelle | Connexion, isolation ou récupération impossibles à satisfaire |
| Collectes de preuves indépendantes | Orchestration gérée ou SDK | Le parallélisme peut raccourcir le chemin critique | Synthèse, doublons ou vérification annulent le gain |
Tester la reprise là où un doublon devient possible
Utilisez un environnement de test de gestion des tickets, hors production. La tâche enquête puis crée exactement un ticket après approbation. Coupez le client après acceptation du ticket par le système destinataire, mais avant l'enregistrement du résultat de l'outil. C'est un scénario proposé d'injection de panne, pas un défaut fournisseur constaté.
Le test ne passe que si l’application peut déterminer si le ticket existe, évite un doublon et reprend ou termine dans un état connu. Une ambiguïté doit aller en revue. Une relance aveugle peut rendre la production moins fiable malgré une démo apparemment résiliente.
Comparer le coût du résultat accepté, pas seulement les tokens
Rapportez les dépenses directes aux résultats acceptés et séparez l'effort d'ingénierie. Incluez échecs, outils, environnements et rattrapages. Réduire l'exploitation peut augmenter la facture API, ou inversement ; rendez ce compromis visible.
La migration a aussi un seuil de rentabilité. Avec 1 200 USD de coût interne estimé pour intégrer et valider, puis 0,04 USD d'économie vérifiée par tâche acceptée en régime stable, il faut 30 000 tâches acceptées pour amortir l'investissement, sans tenir compte des écarts récurrents de coûts d’exploitation. Ce sont des hypothèses à remplacer. Un volume inférieur peut rendre la migration injustifiée malgré le gain unitaire.
Mesurez des délais comparables : temps jusqu’au premier signe de progression, temps jusqu’à l’artefact accepté et durée de la revue manuelle. Ne comparez pas premier token et rapport validé. Notez préparation et nettoyage des environnements en plus du traitement actif pour identifier démarrages à froid et attentes.
Exporter les traces ne suffit pas à auditer le métier
Une trace exportée et un résultat métier accepté répondent cependant à des questions différentes. Reliez travail applicatif, trace, appel d'outil et ticket destinataire. Une personne qui n'a pas exécuté le test doit pouvoir expliquer pourquoi le ticket a été créé et si l'action était autorisée. Exporter davantage de spans ne répare pas à lui seul une chaîne de preuves manquante.
Gardez observations modèle/outils et facturation séparées jusqu'à rapprochement. Une capture de tableau de bord ne prouve pas le coût unitaire final ; un appel enregistré ne prouve pas la validation de l'écriture dans le système aval.
Migrer avec une vraie limite de retour arrière
- Figer la référence. Sauvegarder jeux de tâches, versions d'outils, critères et résultats. Inclure tâche longue, ambiguïté, attente d'approbation et action externe échouée.
- Exécuter des essais appariés. Même modèle et mêmes budgets si possible ; documenter les écarts. Conserver plusieurs tentatives pour les tâches variables et publier la taille de l'échantillon, pas seulement le meilleur résultat.
- Comparer en lecture seule. Le candidat en mode fantôme ne doit ni envoyer de messages ni doubler les écritures. Appliquer les mêmes règles d'acceptation.
- Ouvrir progressivement aux nouvelles tâches. Affecter le moteur à la création du travail métier et garder ce propriétaire pendant tout le cycle. Ne pas partager une tâche entre contrôleurs désynchronisés.
- Revenir explicitement à la référence. Réorienter les nouvelles tâches. Laisser finir celles en cours ou réconcilier effets et artefacts avant de démarrer un remplacement. Conserver les preuves de la transition.
Fixez les seuils avant de voir les résultats. La qualité doit satisfaire les exigences existantes ; écritures non autorisées et effets dupliqués bloquent le déploiement. Les budgets de coût et de latence doivent être définis à partir des tâches métier. Aucun seuil universel de « 95 % prêt pour la production » ne remplace ces conditions.
Exemple : garder le support, remplacer l'investigation
Une application SDK reçoit un problème, collecte des preuves de compte, attend l'approbation puis crée un ticket. Une première migration utile ne remplace que la collecte. La tâche gérée renvoie un brouillon et ses références ; l'application conserve approbation et création. C'est une conception proposée, pas une migration testée.
| Composant existant | Conserver ou adapter ? | Travail concret |
|---|---|---|
| Identité, droits sur les comptes, schéma du ticket | Conserver le contrat métier | Fournir mêmes dossiers autorisés et champs obligatoires |
| Runner SDK d'investigation | Remplacer pour le pilote | Créer une session gérée et la relier au travail existant |
| Implémentations d'outils | Réutiliser si compatibles ; adapter la répartition | Traduire arguments/résultats, préserver les contrôles d’autorisation et journaliser les échecs des outils |
Approbation en attente et RunState stocké | Garder le propriétaire actuel des travaux en cours | Finir ou réconcilier l'ancien run, sans prétendre importer sa sérialisation comme session gérée |
| Progression et résultat à l'écran | Adapter le mapping applicatif | Distinguer investigation, brouillon à examiner et ticket réellement créé |
| Traces et facturation | Ajouter les nouvelles références | Relier chaque essai à la même tâche, au verdict et au registre des coûts |
Le premier pilote peut s'arrêter à « brouillon prêt à examiner ». Tout le workflow ne doit pas déménager d'un coup. Si l'investigation progresse mais que la reprise des approbations régresse, gardez cette dernière dans l'application et réduisez le périmètre.
RunState sérialisé contient travail en attente et décisions, mais sa désérialisation n'authentifie pas l'expéditeur. Stockez-le sous contrôle applicatif, vérifiez l’autorisation de l’examinateur pour l’action en attente et coordonnez la reprise pour éviter de consommer deux fois la même approbation. Changer le moteur d'investigation ne supprime pas ce travail.Questions fréquentes
Agents API rend-elle les frameworks obsolètes ?
Elle peut remplacer la mécanique générique d'exécution. Politique métier, approbations et état du domaine gardent un responsable. Évaluez les composants, pas les noms.
Agents SDK est-il sans état ?
Non. Il documente sessions et implémentations persistantes. L'application reste responsable du déploiement et du stockage.
Peut-on garder la validation humaine avec le SDK ?
Oui : interruptions et état reprenable sont documentés. Testez redémarrages et changements d'autorisation dans votre déploiement, au-delà d'une démo en mémoire.
Le calcul auto-hébergé rend-il Agents API compatible ZDR ?
Non selon la documentation actuelle. Examinez également le chemin complet des données des alternatives SDK ; l’orchestration locale ne garantit pas à elle seule le respect des exigences de conservation des données.
Changer la base URL suffit-il à changer de moteur ?
Ne le supposez pas. Les outils peuvent être réutilisables, mais sessions, appels en attente, état et résultats nécessitent adaptateur explicite et tests.
Quelle option coûte le moins cher ?
Mesurez le même résultat métier accepté, échecs et rattrapages inclus, puis migration et exploitation. Les calculs ci-dessus sont hypothétiques, sans vainqueur déclaré.
Peut-on exporter les traces d'Agents API ?
La documentation officielle décrit OTLP JSON. Préparez le raccordement au monitoring et consultez les documents de lancement EvoLink pour le chemin d'intégration disponible.
Peut-on utiliser Agents API via EvoLink aujourd'hui ?
Sources et périmètre
Les affirmations techniques sont accompagnées de sources primaires. HN et Reddit servent seulement à identifier les questions API/SDK et frameworks. Scénarios, calculs et recommandations de déploiement sont des propositions éditoriales, sans benchmark contrôlé, économie universelle ni compatibilité gateway en production revendiqués.