Lancement d’OpenAI Agents API : fonctionnalités et coûts par tâche

Les questions utiles vont au-delà de la définition d'un agent géré. Le travail continue-t-il après une déconnexion ? La compaction du contexte conserve-t-elle les contraintes essentielles ? Le gain de temps des sous-agents justifie-t-il leur coût ? Que doit encore faire l'application si OpenAI gère le harness ?
Lancement d'OpenAI Agents API : qu'est-ce qui est disponible ?
| Question | Réponse actuelle | Conséquence pour l'adoption |
|---|---|---|
| Annonce ou produit utilisable chez le fournisseur ? | Bêta publique annoncée le 10 septembre | Évaluer la documentation bêta sans supposer un contrat de disponibilité générale |
| Nouveau nom d'Agents SDK ? | Non : couche d’exécution hébergée pour l’API, SDK exécuté dans l’application | La migration déplace la responsabilité d'exploitation |
| Le harness de Codex est-il un modèle ? | Non : il coordonne appels au modèle, outils et travail en cours | Évaluer le workflow complet, pas seulement le modèle |
| Accessible via EvoLink ? | Intégration en cours, appels pas encore ouverts | Garder le chemin validé tout en préparant une tâche pilote |
| Une API publiée implique-t-elle des poids de modèle ouverts ? | Ce lancement ne dit rien des poids ou de la licence du modèle | Distinguer disponibilité du code source de la couche d’exécution, conditions du service hébergé et licence du modèle |
La confusion des noms a des effets concrets. Un tutoriel qui installe Agents SDK ne démontre pas la nouvelle API gérée. De même, un endpoint de modèle compatible OpenAI ne prouve pas la prise en charge de sessions d'agents durables. Identifiez le produit appelé avant de réutiliser un exemple.
Pourquoi exposer le harness de Codex change la décision
Dans un produit de développement ou d'analyse, appeler le modèle n'est qu'une étape. Il faut choisir l'action suivante, transmettre les résultats, préserver le contexte et reprendre après interruption. Le service géré regroupe cette mécanique dans une couche d'exécution. Son intérêt est maximal lorsque son entretien représente une part importante du travail de l'équipe.
Profitez du lancement pour distinguer le travail d'amélioration du métier de l'entretien du moteur d'exécution. Une couche gérée n'apporte une économie opérationnelle utile que si ce second poste est significatif et si la frontière du service convient au produit.
Sessions longues et compaction : vérifier la continuité
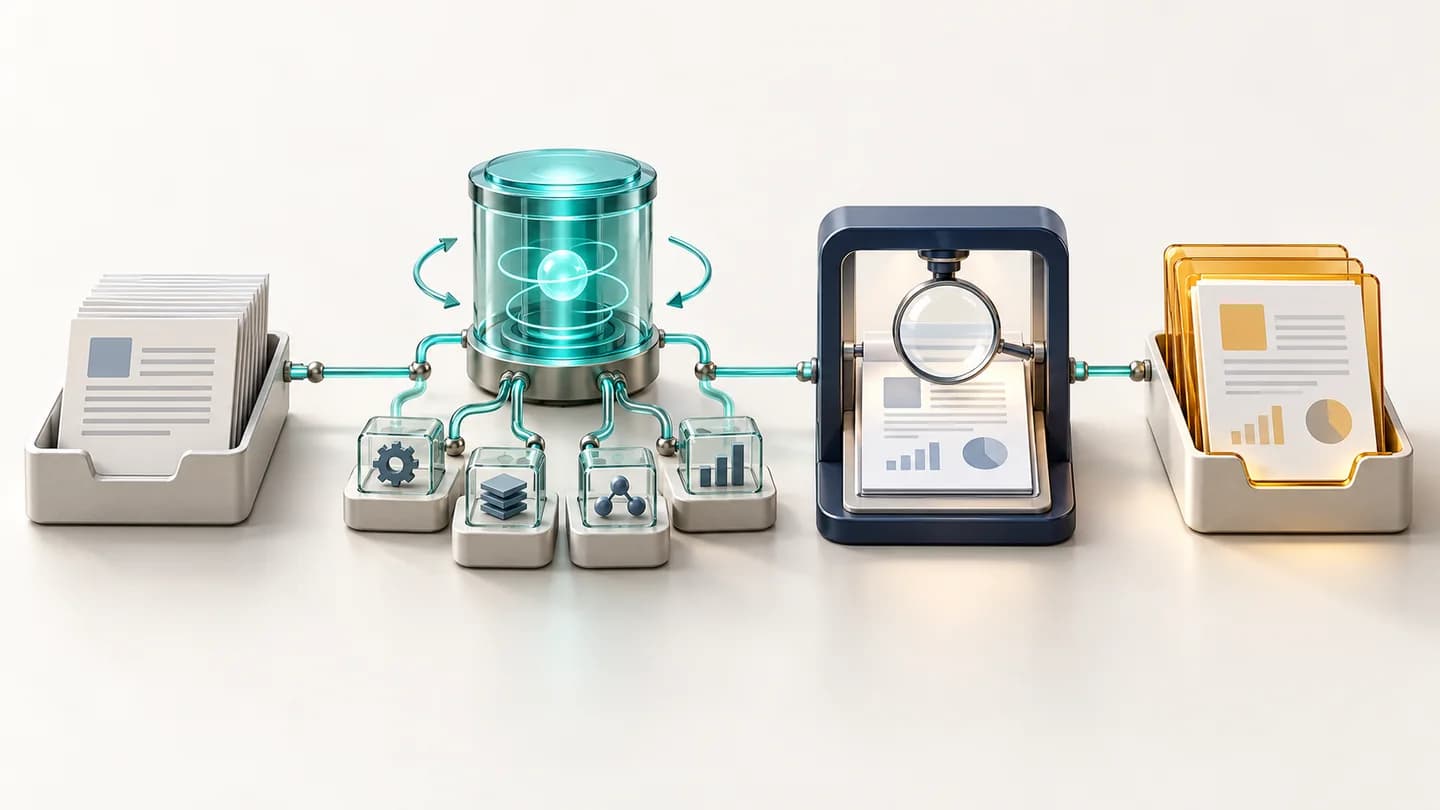
Prenons un test de maintenance de dépôt : corriger une pagination, conserver le format public des réponses, ne pas modifier l'authentification et joindre les résultats de tests pertinents. Après plusieurs étapes, ajoutez un cas limite. Le correctif final respecte-t-il encore les contraintes initiales ? La longueur de la conversation ne permet pas de le prouver.
Conservez les critères d'acceptation dans la fiche de tâche de l'application. Lors de la revue, comparez les fichiers modifiés, les réponses de référence et les tests à ces critères. Vous pourrez distinguer une perte de contexte d'une consigne initiale insuffisante, et conserver une référence indépendante pour évaluer une autre couche d'exécution.
Même principe pour l'analyse de données : un rapport peut rester cohérent dans la conversation tout en changeant de période comptable ou en oubliant une exclusion. Testez explicitement ces invariants. « Session persistante » ne garantit pas que chaque contrainte métier survivra à chaque reprise.
Recherche d'outils et appels programmatiques : deux problèmes différents
Un assistant d'analyse de comptes peut avoir accès à de nombreuses opérations CRM, mais n'en avoir besoin que de quelques-unes. Il peut aussi devoir récupérer plusieurs dossiers et calculer un total. Trouver la bonne opération n'élimine ni le coût de récupération ni celui de traitement des données.
L'évaluation doit donc noter séparément la sélection du bon outil et la conformité du résultat à un calcul indépendant. Une réponse finale courte ne prouve pas une agrégation correcte. Prévoyez des enregistrements manquants, des réponses vides et des unités incompatibles dans les données de test.
Nous recommandons de laisser les écritures ayant un effet sur le client hors d'une agrégation opaque. L'analyse propose une modification ; le code applicatif valide la cible et l'autorisation avant de l'appliquer. C'est un choix de conception, pas une affirmation selon laquelle EvoLink expose déjà ces mécanismes.
Sous-agents parallèles : utiles si le travail se sépare
Pour un incident, séparez les changements de déploiement, les échantillons d'erreurs et l'état des dépendances en tâches indépendantes en lecture seule. Chaque tâche fournit des éléments probants, une hypothèse et les limites du degré de confiance accordé à celle-ci. L'agent coordinateur confronte les explications avant de proposer une correction.
À l'inverse, trois agents modifiant le même fichier de configuration peuvent créer des conflits et un travail supplémentaire pour les résoudre. Commencez par séparer la collecte des preuves et confier la modification finale à un seul responsable. Mesurez le délai jusqu'au résultat accepté, synthèse et résolution des conflits comprises, pas seulement la sous-tâche la plus rapide.
Comparez un agent unique et un nombre borné de sous-agents sur les mêmes incidents. Relevez dépense totale et corrections manuelles avec le temps. Une réponse plus rapide mais moins vérifiable ne satisfait pas le besoin produit.
Sandbox hébergée, environnement interne ou aucune sandbox ?
| Tâche proposée | Point de départ à tester | Pourquoi | Responsabilité applicative |
|---|---|---|---|
| Recherche de compte par fonctions métier | Sans sandbox | Les réponses des services suffisent, sans calcul local | Authentifier l’utilisateur et faire respecter ses droits d’accès aux dossiers |
| Analyse CSV produisant un classeur | Sandbox hébergée | Fichiers, bibliothèques et livrables sont centraux | Contrôler les totaux et conserver le résultat accepté |
| Travail sur dépôt avec dépendances spécifiques | Environnement auto-hébergé | Infrastructure ou outils existants importants | Provisionner, isoler, restaurer et retirer du service les ressources de calcul |
/workspace/outputs sont publiés comme artefacts immuables à la fin du tour. Associez le tour terminé et le chemin du fichier pour ne pas servir une version précédente après révision. Les artefacts publiés survivent à l'expiration de l'environnement ; sauvegardez les copies nécessaires avant de supprimer la session./workspace/outputs ne les publie pas via l'Artifacts API d'OpenAI. Le même bouton « Télécharger le rapport » doit donc masquer deux adaptateurs différents. Récupération et durée de vie.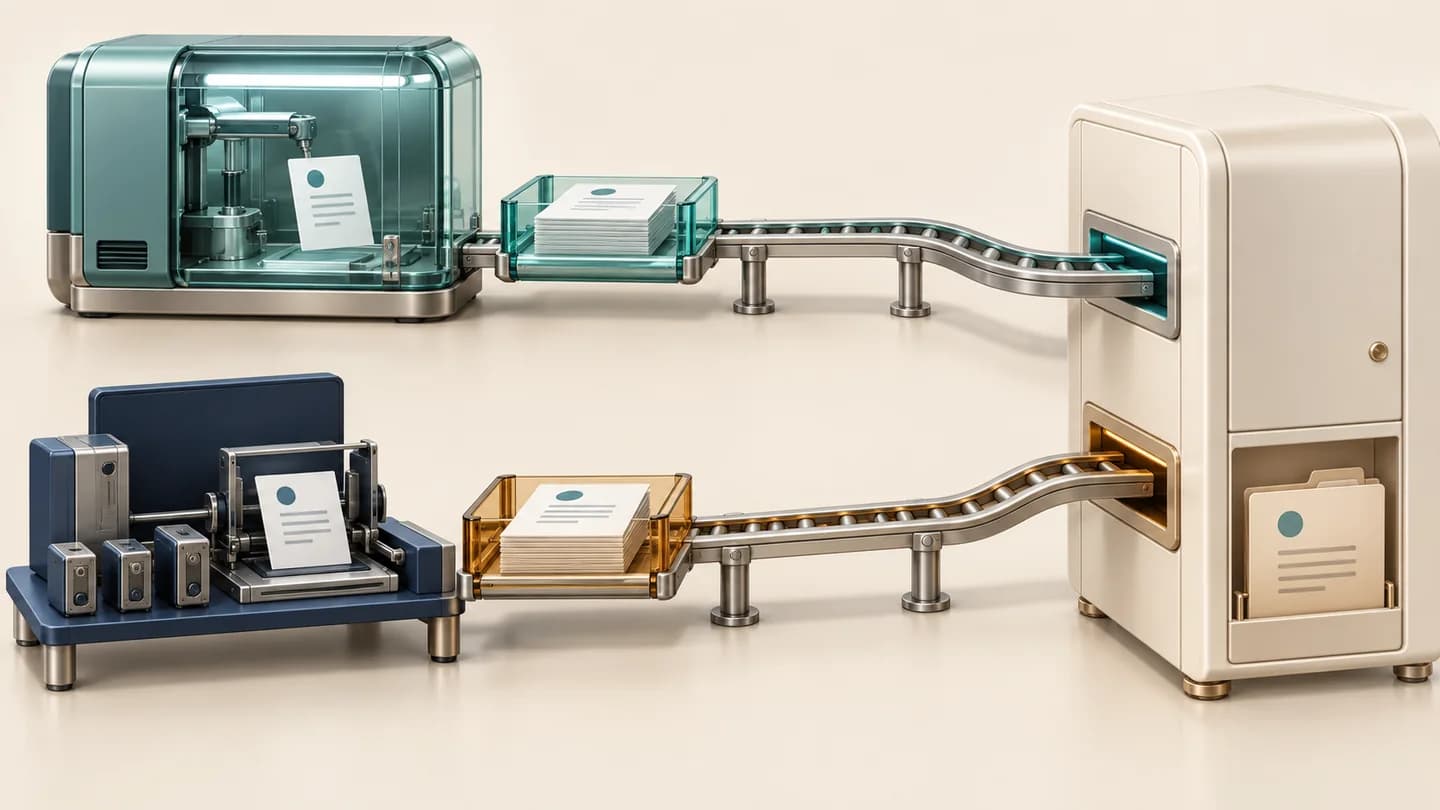
De l'exécution au rapport téléchargeable
Voici un parcours proposé pour la tâche CSV. Il s'agit d'états applicatifs, pas de noms d'événements API :
| Ce que voit le client | Action applicative | Condition de passage |
|---|---|---|
| Traitement en cours | Relier le travail métier à la session et suivre sa progression | Un résultat peut être examiné |
| Vérification des résultats | Récupérer la bonne version et contrôler totaux et exceptions | Le classeur respecte les critères enregistrés |
| Téléchargement disponible | Conserver le résultat accepté et contrôler les droits | Le fichier est réellement récupérable |
| Reconnexion | Lire la session et le travail sauvegardé après interruption du flux | Savoir si le travail initial continue ou dispose d'un résultat |
| Intervention nécessaire | Préserver les éléments utiles et expliquer le problème | Entrée corrigée, décision de revue ou reprise contrôlée |
« Pas de frais API supplémentaires » ne veut pas dire gratuit
Pour le budget, consignez modèles, outils, environnement, tentatives échouées et sorties acceptées. Séparez votre temps d'exploitation et de revue. Cela évite de comparer une estimation en tokens avec un coût complet de production.
Limites de la bêta qui peuvent changer le choix
Une première évaluation pour décider
Choisissez un rapport volontairement borné : rapprocher deux exports CSV, expliquer les lignes non appariées, produire un classeur et une synthèse. Ce protocole est une proposition éditoriale, sans résultat revendiqué.
| Cas | Données ou interruption | Preuve d'acceptation |
|---|---|---|
| Entrée normale | Deux exports avec total de rapprochement connu | Totaux égaux au calcul indépendant |
| Données ambiguës | Identifiants dupliqués et devise absente | Ambiguïtés signalées, aucun rapprochement inventé en silence |
| Déconnexion client | Fermer le flux après démarrage | Travail existant retrouvé, sans resoumission aveugle |
| Consigne modifiée | Ajouter une exclusion en cours de tâche | Totaux et explication reflètent le nouveau périmètre |
| Récupération de sortie | Arrêter les ressources de calcul après conservation du résultat | Application capable de récupérer et ouvrir le livrable accepté |
| Revue budgétaire | Inclure toutes les tentatives | Dépense et nombre de résultats acceptés réconciliables |
Questions fréquentes
Quand OpenAI Agents API a-t-elle été lancée ?
OpenAI a annoncé la bêta publique le 10 septembre 2026. Cette date ne prouve ni disponibilité générale ni lancement EvoLink.
Est-ce le modèle Codex ou Agents SDK ?
C'est un service géré autour du harness de Codex. Le choix du modèle et l'orchestration du SDK dans l'application sont distincts.
La compaction donne-t-elle une mémoire illimitée ?
Non. Testez la conservation des contraintes et des preuves sur une tâche longue. Gardez le dossier d’acceptation métier hors de la conversation.
Les sous-agents réduisent-ils toujours coût et latence ?
Non. La parallélisation n'implique aucun résultat universel. Comptez coordination, travail dupliqué et vérification finale.
Agents API est-elle gratuite ?
L'absence de frais API séparés n'annule pas ceux des modèles, outils et environnements. Les calculs sont illustratifs ; les prix EvoLink ne sont pas annoncés.
Puis-je tout garder dans mon VPC ?
Ne le déduisez pas d'une sandbox auto-hébergée. Environnement et service géré restent deux frontières ; les limites de résidence et de conservation s'appliquent toujours.
Est-elle disponible via EvoLink ?
Qu'est-ce qui ferait évoluer cet article ?
Un nouveau contrat bêta/GA, des contrôles de données ou d'environnement différents, une intégration gateway validée ou des résultats reproductibles. Ces changements doivent actualiser les faits et les recommandations, pas seulement la date.