Claude Fable 5.5 vs Opus 5.5 : quand changer de modèle ?

Que peut-on comparer aujourd’hui ?
| Élément de décision | Référence Opus 5.5 | Candidat Fable 5.5 |
|---|---|---|
| Identité et accès | Utiliser la route documentée actuelle et vérifier le compte | Non établis par les sources consultées |
| Qualité des tâches | Mesurer sur vos tâches validées et échouées | Aucun résultat vérifié fourni ici |
| Coût et latence | Relever les frais réels, les nouvelles tentatives et la durée | Inconnus tant qu’une route appelable ne peut pas être évaluée |
| Rôle en production | Conserver si les exigences sont satisfaites | Indécis ; un numéro de version n’est pas un test d’acceptation |
Le modèle de référence est déjà devenu plus difficile à battre
xhigh ; la plupart des autres résultats Opus du tableau utilisent max. Ce sont des évaluations du fournisseur concernant Opus 5.5 et Fable 5.1, pas des preuves sur Fable 5.5 ni des mesures d'une route EvoLink. Anthropic précise aussi que ses protections de production étaient activées : lorsqu’elles intervenaient, les tâches de cybersécurité étaient transférées à Opus 4.8 et celles de biologie ou de développement de LLM de pointe à Opus 5. Ces résultats décrivent cette configuration d’évaluation ; ils ne prouvent pas que chaque tâche a été exécutée uniquement par Opus 5.5.medium pour Opus 5.5 et high pour Fable 5.1. Des fenêtres égales ne tranchent pas la qualité de récupération d'information ; des valeurs par défaut différentes peuvent faire comparer des conditions de fonctionnement différentes si l'on ne change aucun réglage.Pour une future évaluation de Fable 5.5, conservez des colonnes séparées pour les tâches uniques, toutes les tentatives, la réussite au premier essai et la réussite finale. Un pourcentage en titre peut masquer une amélioration de la première réponse ou seulement davantage de solutions après plusieurs tentatives. Pour le routage, identifiez les tâches qu'Opus échoue encore à résoudre dans votre budget réel : c'est là qu'un candidat plus coûteux doit justifier sa place.
Choisir des tâches pour lesquelles un changement aurait un intérêt
La question générale « quel modèle est le plus intelligent ? » résout rarement un choix de production. Commencez par une tâche dont l’amélioration a une valeur opérationnelle claire. Incluez aussi des tâches courantes afin qu’un progrès sur un cas difficile ne masque pas des régressions quotidiennes.
| Charge de travail | Critère de réussite | Échec à surveiller | Question pour le changement |
|---|---|---|---|
| Modification de code sur plusieurs fichiers | Tests requis réussis et comportement voulu modifié | Corrections partielles, régressions, API inventées | Le candidat réduit-il la revue et les réparations ? |
| Recherche fondée sur des sources | Affirmations étayées par les preuves fournies | Conclusions non étayées ou contraintes omises | Plus de réponses validées sans davantage de vérification factuelle ? |
| Workflow piloté par outils | Arguments corrects et état final attendu | Mauvais outil, arguments invalides, effets externes répétés | Le workflow aboutit-il de façon fiable ? |
| Extraction structurée courante | Validation du schéma et contrôle de chaque champ | Champs plausibles mais erronés | Le surcoût ou le délai est-il justifié à ce volume ? |
Ce sont des catégories de tests proposées, pas des affirmations sur les fonctions prises en charge par les modèles. Ne testez une fonction qu’après confirmation par la documentation de la route et une requête.
Tester directement le raisonnement entre fichiers et l’usage du contexte
Utilisez les mêmes jeux de test pour la référence et le candidat. Il s’agit de cas proposés, pas de sorties de modèles ; quelques réussites ne suffisent pas à établir un classement universel.
Comparer dans des conditions contrôlées après vérification de l’accès
Figez un ensemble versionné de tâches et de résultats attendus avant de lancer le candidat. Incluez les réussites et les échecs d’Opus : ne tester que ses échecs peut rendre le candidat séduisant tout en masquant ce qu’il dégrade. Séparez le jeu de développement utilisé pour ajuster les prompts d’un jeu réservé à la décision finale.
Gardez constants données d’entrée, définitions et environnement des outils, ainsi que grille de notation. Consignez identifiants exacts des routes, dates, réglages, versions des prompts et politique de nouvelles tentatives. Un réglage ou un niveau d’effort de même nom n’a pas nécessairement le même sens entre modèles. Si chacun exige des réglages différents, publiez-les et comparez les configurations complètes dans les mêmes contraintes de budget et de latence.
Répétez les tâches dont les sorties varient. Si possible, faites examiner les cas importants sans afficher le nom du modèle. Publiez numérateur et dénominateur plutôt qu’un simple pourcentage : « 18 tâches validées sur 20 » indique la taille de l’échantillon. Conservez les jugements ambigus et ne transformez pas une petite réexécution en affirmation de performance universelle.
Séparer la comparaison API de celle des workflows Claude Code
Les deux expériences sont utiles. Un résultat de workflow indique si l’équipe termine un travail plus efficacement dans son environnement réel. Il n’isole pas la part due au modèle, à l’assemblage du contexte ou à l’orchestration. Si ces éléments changent entre essais, présentez une comparaison de configurations plutôt que d’attribuer tout le gain à Fable 5.5.
Comparer le coût par tâche validée
Le tarif par token n’est qu’une partie du coût. Additionnez les frais de toutes les tentatives dans la fenêtre d’évaluation, y compris échecs, reprises, outils et cache applicable. Divisez ensuite par le nombre de tâches satisfaisant les mêmes critères d’acceptation :
Si aucune tâche ne réussit, ne publiez pas de coût fini par tâche validée. Indiquez zéro réussite et la dépense totale. Mesurez séparément le temps de revue humaine, sauf si vous lui attribuez volontairement un tarif monétaire en précisant cette hypothèse.
| Relevé de l’évaluation | Configuration A | Configuration B |
|---|---|---|
| Entrée hors cache, toutes les tentatives | $3 | $4 |
| Sortie, toutes les tentatives | $5 | $6 |
| Lecture/écriture du cache, toutes les tentatives | $1 | $2 |
| Frais supplémentaires d’outils, toutes les tentatives | $3 | $3 |
| Frais totaux | $12 | $15 |
| Tâches validées sur les mêmes 12 tâches | 8 | 12 |
| Coût par tâche validée | $1.50 | $1.25 |
Ne comptabilisez chaque poste de frais qu’une fois. Échecs et nouvelles tentatives sont déjà inclus dans les totaux par catégorie ; ajouter un poste « coût des reprises » les compterait deux fois. Rapprochez les catégories de la facture réelle : les champs d’usage d’une route peuvent inclure les tokens en cache dans un total d’entrée plus large. N’appliquez pas le tarif hors cache à ce total avant d’ajouter encore les frais de cache.
Dans cet exemple, B coûte davantage pour l’évaluation, mais moins par tâche validée. Elle peut néanmoins être inadaptée si elle dépasse une limite stricte de latence ou produit une erreur critique. Séparez les démarrages à froid des essais réutilisant du contexte afin qu’un cache chaud ne masque pas les coûts du premier passage.
| Tokens d'une requête | Opus 5.5 | Fable 5.1 | Rapport de coût Fable / Opus |
|---|---|---|---|
| 100 000 en entrée hors cache ; aucune lecture de cache ; 2 000 en sortie | $0.4400 | $1.1000 | 2.50× |
| 10 000 en entrée hors cache ; 90 000 lus dans le cache ; 2 000 en sortie | $0.0980 | $0.2225 | 2.27× |
| 10 000 en entrée hors cache ; 900 000 lus dans le cache ; 2 000 en sortie | $0.2600 | $0.4250 | 1.63× |
(10,000 × 4 + 90,000 × 0.20 + 2,000 × 20) / 1,000,000 = $0.098. Un long historique déjà en cache réduit le rapport ; il ne rend pas Fable moins cher et n'inclut pas la constitution du cache. Les modèles réels peuvent consommer des volumes différents. Recalculez avec vos requêtes et les tarifs de route EvoLink applicables, plutôt que de multiplier toute une facture par 2.5.C la dépense moyenne totale API/outils par tâche soumise, reprises incluses, et p la proportion de tâches acceptées. Le coût API par tâche acceptée vaut C / p. Un candidat de multiplicateur r = C_candidate / C_Opus ne le réduit que si p_candidate > r × p_Opus. Avec 80% d'acceptation de référence et un coût hypothétique de 1.5×, il faudrait dépasser 120% d'acceptation : impossible selon cette seule mesure du coût API. Des économies de travail humain ou l'évitement d'échecs coûteux peuvent encore le justifier, mais nécessitent une valorisation séparée. L'escalade sélective peut donc être plus pertinente que le remplacement de toutes les requêtes Opus.Utiliser Fable uniquement comme advisor réduit-il le coût ?
Comparez trois configurations sur les mêmes tâches : votre workflow Opus actuel, Opus avec une association advisor documentée et disponible, puis — seulement après vérification — le candidat comme modèle principal. Comptez à chaque fois l’ensemble : appels du modèle principal, consultations, outils, nouvelles tentatives et validation finale.
Conserver, réserver aux cas difficiles ou remplacer ?
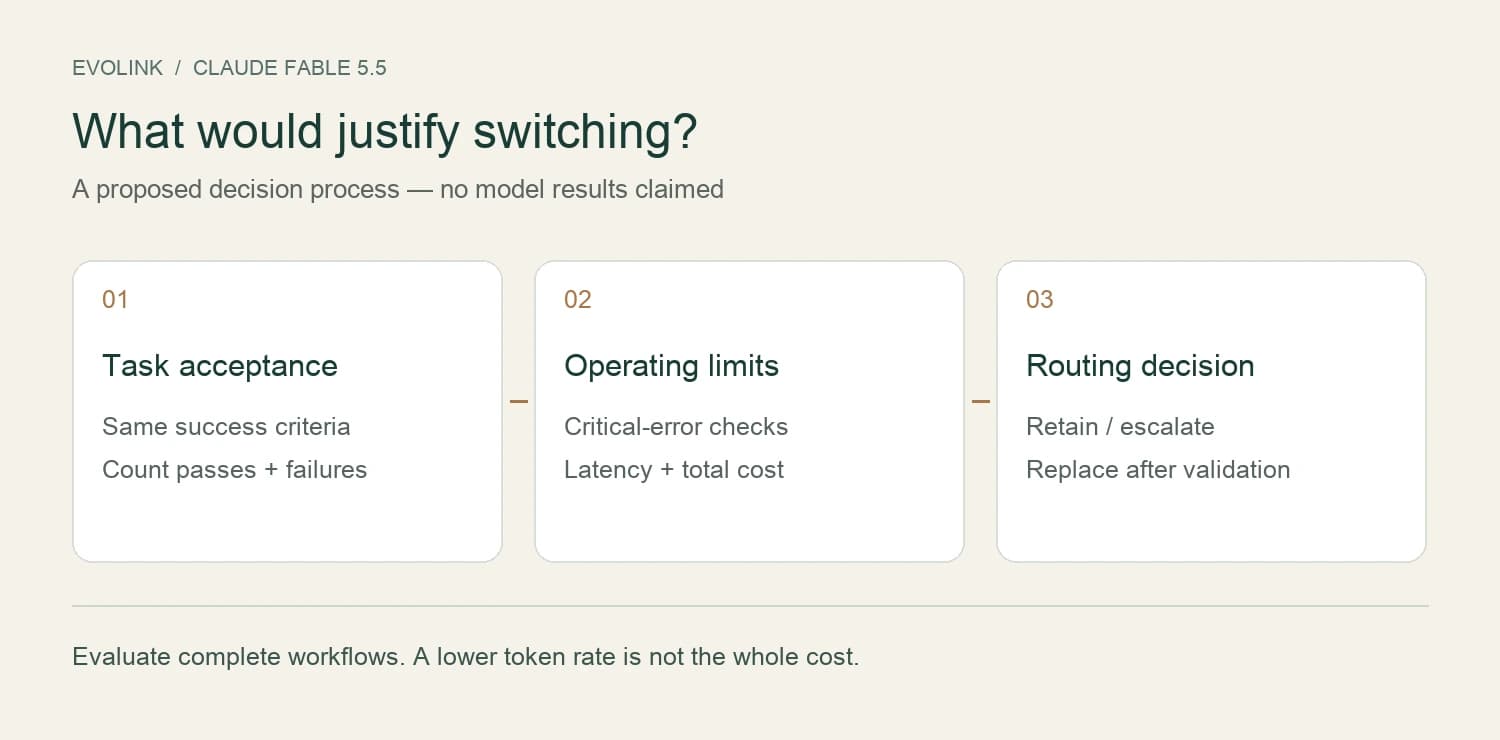
Fixez les règles d’acceptation avant de consulter les résultats du candidat. Elles doivent refléter l’application : une erreur grave d’outil peut interdire un déploiement même si la qualité moyenne progresse. Définissez latence et dépenses maximales, ainsi que la personne qui tranche les sorties contestées.
- Conserver Opus s’il satisfait les exigences et qu’un candidat n’a pas démontré d’amélioration utile.
- Réserver le candidat à certaines tâches s’il aide un sous-ensemble difficile identifiable, mais ajoute ailleurs coûts ou délais inutiles. Testez aussi la règle de routage : une mauvaise classification peut annuler le bénéfice.
- Remplacer le modèle par défaut seulement si qualité, erreurs critiques, latence et coûts respectent les exigences sur un trafic représentatif, avec un repli testé.
La passerelle unifiée d’EvoLink peut maintenir le choix des modèles dans une interface d’intégration commune ; elle ne rend pas leurs comportements interchangeables. Vérifiez le contrat de chaque route. Ne configurez pas le candidat avant vérification de l’accès et examinez un déploiement limité avant d’augmenter le trafic.
FAQ
Fable 5.5 est-il meilleur qu’Opus 5.5 ?
Aucun résultat face à face vérifié n’est fourni ici. Identité, accès et comportement de Fable 5.5 restent non confirmés dans les sources consultées ; on ne peut pas désigner de gagnant.
Opus 5.5 doit-il rester mon modèle par défaut ?
Conservez un modèle qui satisfait vos exigences jusqu’à ce qu’une alternative vérifiée réussisse votre évaluation. La décision dépend des résultats des tâches, de la latence et du coût total.
Un nom de modèle plus imposant ou une version plus récente implique-t-il un meilleur code ?
Non. Utilisez des tâches sur dépôt avec modifications attendues explicites et contrôles de régression. Le nom seul ne prouve rien sur votre code.
Les deux modèles doivent-ils avoir le même réglage d’effort ?
Uniquement si les réglages documentés sont réellement comparables. Sinon, consignez chaque configuration prise en charge et comparez dans les mêmes contraintes opérationnelles en expliquant les différences.
Peut-on décider avec les seuls tarifs par token ?
Non. Reprises, longueur des sorties, outils, cache et tâches échouées changent le total. Comparez les frais réels par tâche validée avec la même définition de réussite.
Et si le candidat gagne seulement sur les tâches difficiles ?
Envisagez un routage sélectif après vérification de l’accès et du comportement. Incluez le coût et les erreurs du choix des requêtes à lui confier.
S’agit-il d’un benchmark EvoLink ?
Non. Aucun appel authentifié Fable 5.5 n’a été réalisé pour cet article. La matrice de tâches, le protocole et le calcul sont des aides à l’évaluation, pas des mesures de modèles.
Où vérifier le statut de sortie ?
Sources et périmètre
- Présentation des modèles Anthropic : recommandations sur les modèles documentés et vérification d’identité.
- Actualités Anthropic : recherche de preuves de sortie.
- EvoLink Opus 5.5 : référence actuelle de produit et de prix.
- Documentation advisor Claude Code : contexte, consommation supplémentaire et cache ; aucune preuve de prise en charge de Fable 5.5.