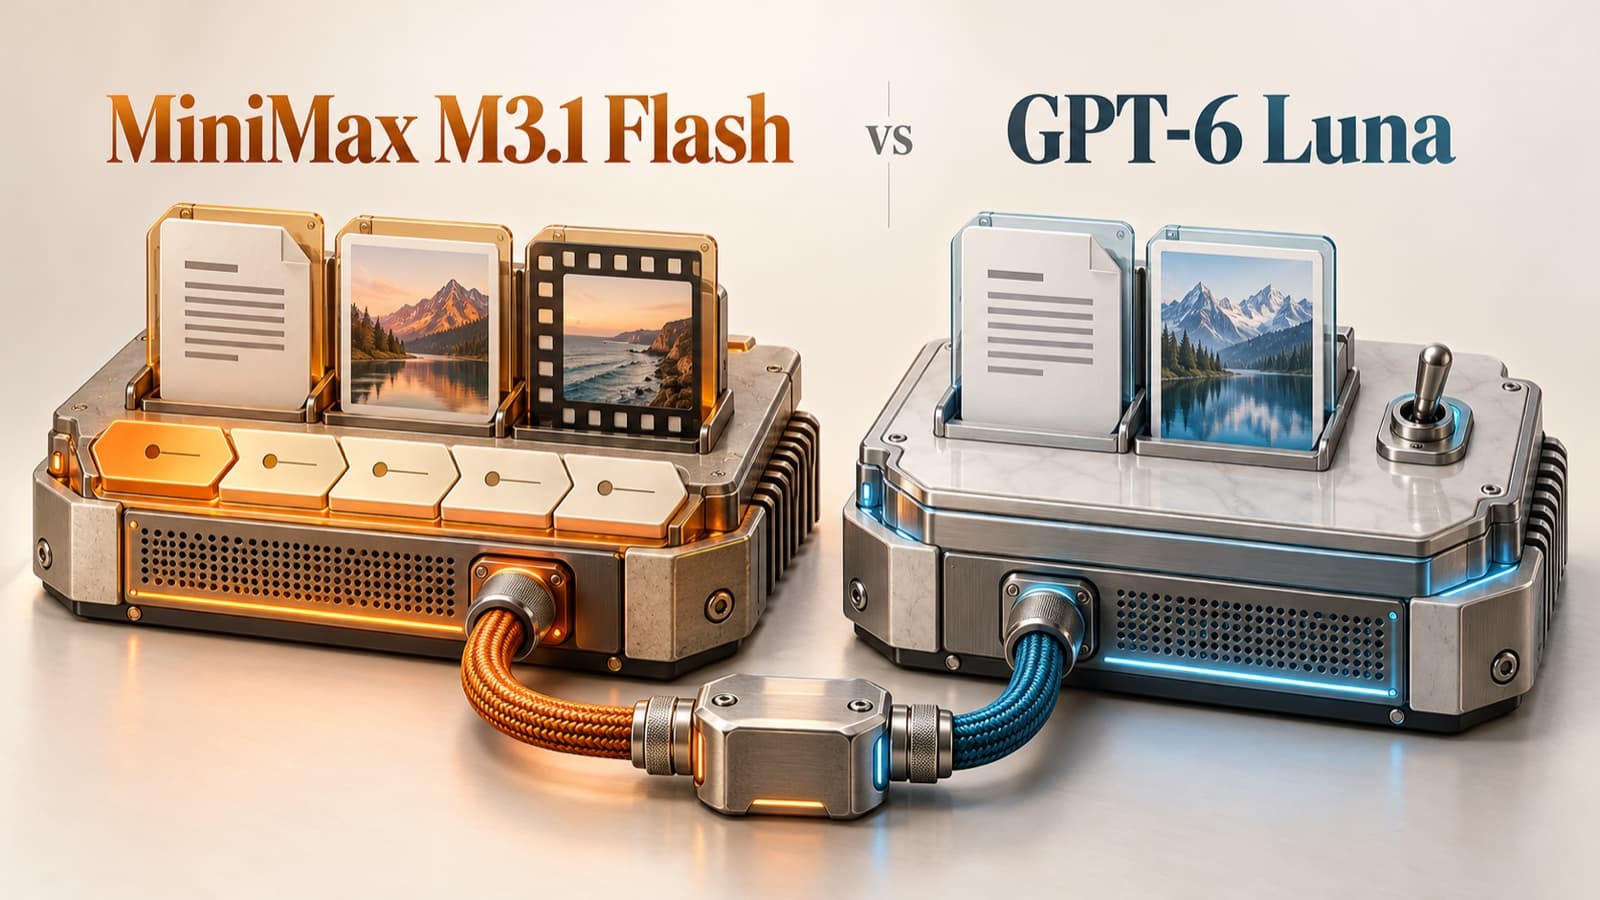
MiniMax M3.1 Flash vs M3 : faut-il changer de modèle ?

La migration dépend surtout des hypothèses de votre application : raisonnement, champs de réponse et définition du travail terminé. Une extraction courte qui doit éviter le raisonnement ne pose pas la même question qu'un agent de code à plusieurs étapes.
Cette comparaison porte sur les comportements documentés et une méthode de migration. Elle ne fournit aucune mesure comparative nouvelle de qualité, vitesse ou coût. EvoLink assure l'accès unifié aux modèles ; sélection des tâches et retour arrière restent des décisions applicatives.
MiniMax M3.1 Flash vs M3 : les différences utiles à la migration
Le tableau distingue documentation API actuelle et comparaison Preview publiée. Pour votre route M3, vérifiez le comportement réellement envoyé, sans reprendre un réglage d'un autre service.
| Dimension | MiniMax-M3 | MiniMax-M3.1-Flash | Conséquence |
|---|---|---|---|
| ID exact du modèle | MiniMax-M3 | MiniMax-M3.1-Flash | Employer l’ID documenté pour chaque route |
| Entrées | MiniMax documente texte, image et vidéo ; vérifier le service choisi | MiniMax documente texte, image et vidéo ; vérifier le service choisi | Rejouer les entrées utilisées par votre application |
| Contexte | 1 000 000 tokens dans le catalogue actuel | 1 000 000 tokens dans le même catalogue | La capacité seule ne justifie pas le changement |
| Interrupteur de raisonnement | La comparaison MiniMax décrit activation/désactivation | Le guide actuel interdit la désactivation | Auditer les requêtes qui le coupent |
| Profondeur | La comparaison ne présente pas les cinq niveaux | low, medium, high, xhigh, max ; défaut max | Fixer explicitement l'effort du candidat |
| Extraction de réponse | Vérifier la forme de votre route actuelle | EvoLink Chat sépare réponse finale et raisonnement | Examiner l'adaptateur avant de changer l'ID |
| Configuration produit | Configuration et tarifs EvoLink propres | Configuration et tarifs EvoLink propres | Comparer les pages actuelles puis l'usage réel |
Quatre hypothèses à vérifier dans votre intégration
1. Une requête désactive-t-elle le raisonnement ?
Inspectez constructeur de requêtes et défauts du SDK, tâches de fond et anciennes configurations d'agents sauvegardées. Un wrapper partagé peut continuer à injecter une option alors que l'interface affiche le nouveau modèle.
Si l'absence de raisonnement est une exigence, gardez-la dans les critères de validation. Un effort faible est un autre comportement. Décidez si la tâche peut l'accepter avant de considérer la migration comme un simple changement de nom.
2. La profondeur reste-t-elle implicite ?
Enregistrez le réglage explicite avec les entrées. Sinon une modification du prompt ou du SDK peut être confondue avec un changement d'effort. Le libellé choisi dans le client ne prouve pas que le champ correspondant est envoyé.
Pour comparer, figez la configuration voulue de chaque modèle et documentez les différences. Deux systèmes de contrôle différents n'ont pas besoin d'être présentés comme identiques.
3. Quel champ votre adaptateur affiche-t-il ?
Inspectez les données reçues, y compris les événements de streaming si vous les utilisez : texte visible, appels d'outils et valeurs optionnelles absentes.
Un adaptateur attendant des balises de raisonnement dans le texte ou un ancien champ unique peut échouer malgré une requête réussie. Testez l'extraction avec une réponse sauvegardée du service choisi. Conservez réponse brute et valeur extraite ensemble pour localiser un écart.
4. Réponse reçue ou tâche validée ?
Un succès de transport peut contenir une sortie incomplète, un mauvais format ou un correctif dont les tests échouent. Relevez séparément fin de génération, disponibilité de sortie, résultats des outils et contrôles de tâche. Appliquez la même définition aux deux modèles.
| Hypothèse ancienne | Contrôle du candidat | Preuve à garder |
|---|---|---|
| Le wrapper peut couper le raisonnement | Retirer l'option non supportée ou conserver la route requise | Requête sérialisée sans secrets |
| Le défaut du client convient | Envoyer un réglage explicite propre au protocole | Version du client, configuration, champ envoyé |
| Un parseur convient à tous | Extraire texte final et outils selon le format documenté | Réponse brute et résultat parsé |
| HTTP réussi signifie terminé | Vérifier livrable et condition de fin | Fiche de validation |
reasoning_content s'il existe et tool_calls, ou tous les blocs Messages. Ajoutez aux corrections un aller-retour d'outil déterministe et une recherche en contexte long. Rejouez image ou vidéo seulement si le service les accepte. Inspectez les cache hits sans les supposer. Ces contrôles couvrent le protocole, sans prouver une qualité supérieure.Décider par type de tâche et coût d'échec
Cette grille est une aide éditoriale à la décision, pas un classement de performance.
| Charge | Motif d'évaluer M3.1 Flash | Motif de conserver M3 pour le moment |
|---|---|---|
| Extraction ou classification courte | Le raisonnement est acceptable et son effet sur les erreurs mérite un essai | Le workflow validé exige de l'éviter ou une latence stricte |
| Agent de code en plusieurs étapes | Besoin d'effort réglable avec inspection des correctifs et outils | Qualité et dépense actuelles satisfaisantes, sans gain démontré |
| Frontend à partir d'images | Références réelles, boucle navigateur et contrôles de comportement | Pas encore de comparaison exécutable à conditions égales |
| Grand contexte documentaire ou de code | Une défaillance précise du workflow actuel est ciblée | Capacité et résultats validés sont déjà suffisants |
| Client à adaptateur ancien | Adaptateur modifiable et testable séparément | Impossible d'inspecter requête et réponse réelles |
Dans une application de support, séparez par exemple classification de tickets et agent de correction outillé. Un bon correctif ne dit presque rien sur les exigences de format et de latence du classifieur.
Si seul l'adaptateur bloque, validez-le contre la référence de format. Si le correctif est faux malgré un adaptateur correct, revenez aux entrées et aux critères de tâche. Mélanger ces pannes fausse le jugement sur le modèle.
Comparer le coût par tâche validée
Pour un lot figé :
Coût par tâche validée =
  total des frais réels du modèle sur toutes les tentatives
  / nombre de tâches satisfaisant les contrôles définis à l'avance
Incluez échecs et réparations au numérateur. Si aucune tâche n'est validée, indiquez « aucun résultat accepté » : diviser par zéro ou écarter les échecs masquerait le résultat. Notez la relecture humaine à côté des coûts, sans la traiter implicitement comme gratuite.
Partez de l'usage et de la facturation réels. Vérifiez traitement du cache et du raisonnement/de la sortie dans le canal avant de reconstituer une facture en tokens. Un tarif inférieur ne compense pas automatiquement les sorties plus longues et les reprises.
Rejouer un lot limité avant de modifier les défauts
- Figer les preuves. Version d'entrée, commit, données, versions d'outils et résultat attendu.
- Écrire la validation. Reproduction, régression et périmètre d'un correctif ; schéma, valeurs et erreurs tolérées d'une extraction.
- Sauvegarder chaque configuration. ID, service, protocole, raisonnement, limite de sortie et timeout. Garder prompt et outils équivalents lorsque les interfaces le permettent.
- Rejouer et inspecter. Conserver échecs, réponses brutes, usage et durée ; séparer adaptateur et tâche.
- Définir entrée et sortie. Fixer qualité, temps et coût acceptables avant de lire les résultats. Migrer d'abord la seule charge testée, avec une restauration de configuration déjà vérifiée.
| Tâche/version | Modèle/configuration | Validation | Temps total | Usage/frais | Réparations | Relecture |
|---|---|---|---|---|---|---|
| Entrée réelle | Valeurs exactes | Réussi/échoué/non vérifié | Mesuré | Données réelles | Nombre | Preuves et points ouverts |
Le retour arrière doit être implémenté et testé dans l'application. Une passerelle unifiée ne fournit pas automatiquement votre politique de routage par qualité ou de récupération.
Avec EvoLink, partez des deux configurations actuelles et de l'intégration existante. La première décision utile est la charge qui mérite un rejeu, avant toute généralisation.
Questions fréquentes
Suffit-il de changer l'ID du modèle ?
Seulement après les vérifications ci-dessus. Contrôles de raisonnement, extraction et limites peuvent nécessiter des ajustements même avec un format API familier.
Faut-il retirer M3 si le candidat réussit ?
Non. Gardez des configurations par charge. Un succès sur un groupe ne couvre pas les autres ; un petit lot ne prouve rien sur le trafic non testé.
Une démonstration Preview prouve-t-elle que ma route sera meilleure ?
Non. Elle aide à choisir des tâches. Fichiers, outils, réglages et service peuvent différer. Une conclusion de déploiement demande les traces du chemin réellement utilisé.
Un contexte identique implique-t-il une qualité identique ?
Non. Il décrit la quantité d'entrée, pas l'usage correct des instructions, dépendances et preuves. Comparez le livrable sur la même tâche réelle.
Sources
- Catalogue MiniMax.
- Guide d'appel MiniMax.
- Comparaison Preview.
- M3 et M3.1 Flash EvoLink.
- EvoLink Chat Completions.
Vérification le 19 octobre 2026. Exemple de charge et méthode éditoriaux ; aucun nouvel essai comparatif entre modèles.