Comparison
MiniMax M3.1 Flash vs GPT-6 Luna : entrées et outils

EvoLink Team
Équipe produit
19 octobre 2026
4 min de lecture
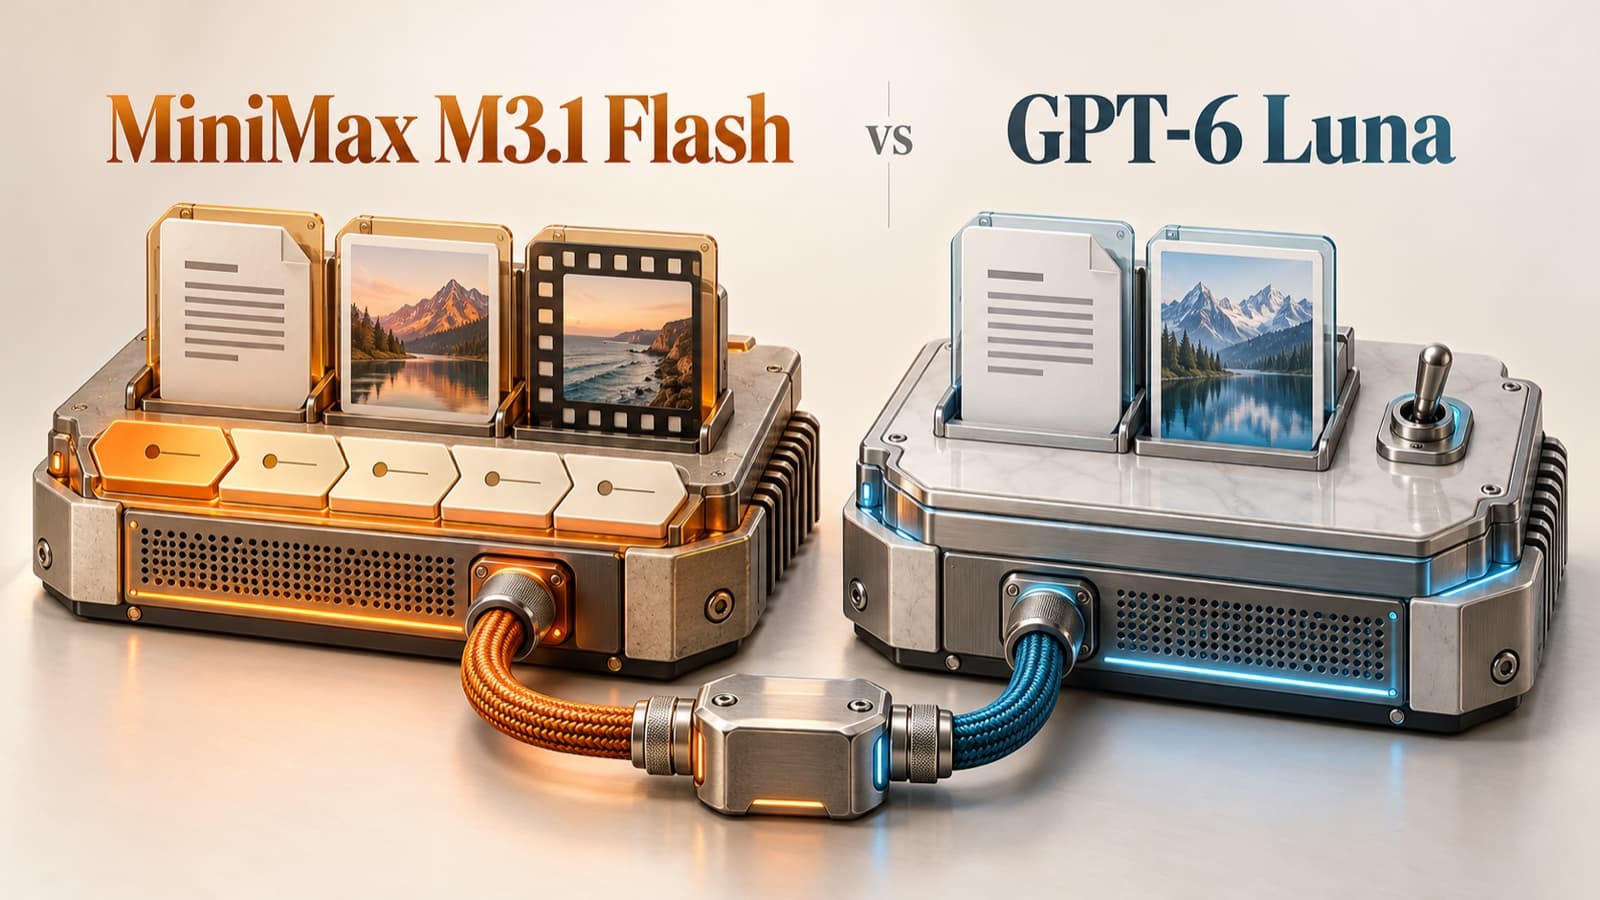
Comparez MiniMax M3.1 Flash et GPT-6 Luna selon les entrées et le protocole d'outils nécessaires, avant d'interpréter les prix. Les deux dépassent le million de tokens de contexte, mais leurs configurations ne sont pas interchangeables. MiniMax accepte la vidéo et garde le raisonnement actif ; Luna accepte texte et images, peut le désactiver et offre jusqu'à 128 000 tokens de sortie.
Il s'agit de contrats documentés, pas d'un benchmark de qualité entre les modèles. Les pages MiniMax et Luna maintiennent accès et tarifs EvoLink actuels. La décision porte sur cette paire précise, sans classement général du code ni guide de mise à niveau entre générations GPT.
MiniMax M3.1 Flash vs GPT-6 Luna : entrées et appels d'outils
| Paramètre | MiniMax M3.1 Flash | GPT-6 Luna |
|---|---|---|
| Fournisseur | MiniMax | OpenAI |
| ID officiel | MiniMax-M3.1-Flash | gpt-6-luna |
| Positionnement | Code, agents, multimodal et contexte long | Résumé, classification et extraction ciblés à grand volume |
| Contexte | 1 000 000 tokens | 1 050 000 tokens |
| Entrées | Texte, images, vidéo | Texte et images ; ni audio ni vidéo natifs |
| Sortie | Texte | Texte |
| Niveaux | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Défaut | max ; désactivation impossible | medium ; none désactive le raisonnement |
| Appels de fonctions | Raisonnement entrelacé ; garder toute la réponse assistant entre les tours | Responses associe raisonnement et fonctions ; Chat Completions exige reasoning_effort: none pour les fonctions |
| Prix officiel entrée/sortie | $0.15 / $0.60 par million de tokens | $0.10 / $0.50 par million, Standard jusqu'à 272K tokens d'entrée |
| Prix officiel lecture du cache | $0.015 par million de tokens | $0.01 par million dans la même tranche |
Spécifications et prix fournisseurs vérifiés le 19 octobre 2026 : invocation MiniMax, prix MiniMax, référence Luna d'OpenAI. Ce sont des tarifs natifs. Luna facture séparément l'écriture du cache ; au-delà de 272K tokens d'entrée, entrée et cache doublent et la sortie passe à 1,5 fois le tarif pour toute la requête. Pour EvoLink, utilisez les sections existantes MiniMax et Luna.
Ce que ces écarts changent dans l'application
Vidéo : MiniMax documente cette entrée. Avec Luna, il faut d'abord extraire des images ou un transcript texte. Ce prétraitement appartient à l'application ; il ne devient pas une capacité vidéo native. Vérifiez aussi la forme de requête acceptée par la passerelle choisie.
Raisonnement : les cinq niveaux MiniMax règlent la profondeur en gardant le raisonnement actif. Luna ajoute
none et utilise medium par défaut. Rendez le choix explicite lors du changement. Une tâche exigeant l'absence de raisonnement ne peut pas assimiler MiniMax low à Luna none.Outils : MiniMax conserve tout l'historique assistant, dont
reasoning_content s'il existe et tool_calls, ou tous les blocs Anthropic. Pour Luna avec raisonnement et fonctions, utilisez Responses ; Chat Completions impose de couper le raisonnement. Le seul libellé « compatible OpenAI » ne prouve ni comportement identique ni support de toutes les fonctions natives par une passerelle.Choisir entre ces deux modèles via EvoLink
EvoLink réunit authentification, configuration et usage. Vérifiez d'abord entrées et protocole, puis le travail réel. Plus de contexte indique ce qui peut tenir, pas la justesse d'utilisation des preuves. Un token moins cher ne prouve pas un coût inférieur par résultat validé.
Gardez prompt, révision d'entrée et outils comparables. Contrôlez réglage sérialisé, réponse finale, ID d'outils, fin, reprises, durée totale et facture réelle. Comparez la tâche complète, pas seulement le débit de streaming. Langue et format attendus appartiennent aux critères de validation ; ce guide ne fournit pas de classement linguistique mesuré.
Consultez la configuration Luna ou la référence d'outils MiniMax. L'application implémente routage et reprise : la passerelle unifiée ne crée pas automatiquement un basculement fondé sur la qualité.
Consulter les deux configurations actuelles
Les pages modèles existantes réunissent spécifications, tarifs et points d'entrée.