Claude Fable 5.2 est disponible : nouveautés code et agents
Les nouveautés de Fable 5.2 : code, raisonnement, démos matérielles et jeu, tarifs standard réduits de 20 %, effort et migration API.
 EvoLink TeamÉquipe produit
Dans cet article
La question pratique est sa capacité à faire avancer un projet long : comprendre le code existant, décomposer les problèmes, utiliser les outils, vérifier les résultats et adapter sa démarche après une erreur. Une réponse plus complète et un projet plus facile à livrer sont deux résultats distincts. Le second dépend aussi des outils, du temps d'exécution, des corrections humaines et de la facture finale.
Quelle place pour Fable 5.2 dans la gamme Claude ?
Fable vise les travaux techniques difficiles qui demandent un raisonnement soutenu. Anthropic recommande de commencer la plupart des tâches avec le dernier modèle Opus, puis de passer à Fable 5.2 si les évaluations restent insuffisantes avec un niveau d'effort Opus plus élevé.
Pour une modification de style, un endpoint courant ou des documents à classer selon des règles claires, un modèle déjà fiable peut rester économique. Les dépendances complexes, les choix de conception et les validations répétées donnent davantage d'intérêt à un modèle plus puissant. Une migration peut combiner structures de données, comportement métier, déploiement et contraintes de performance. Éviter une mauvaise décision et les reprises associées peut compter davantage que le prix d'un appel.
Mythos 5.2 repose sur le même modèle. Fable intègre des protections en cybersécurité et en biologie permettant un accès plus large ; Mythos est proposé aux organisations approuvées dans les programmes de vérification d'Anthropic. Les résultats de ces domaines doivent rester attribués à la variante concernée.
Un contexte de 1 million de tokens et une sortie de 128K
claude-fable-5-2. Le modèle accepte 1 million de tokens de contexte, produit jusqu'à 128K tokens en sortie, reçoit du texte et des images et renvoie du texte. La réflexion adaptative reste toujours active et l'effort par défaut de l'API est high.Ce volume permet de fournir interfaces, implémentation, tests et historique de conception pour un dépôt, ou plusieurs rapports et leurs définitions de données pour une recherche. La manière de présenter ces éléments reste essentielle. Précisez :
- Le livrable : code exécutable, plan de migration ou analyse complète.
- Les contraintes : compatibilité des interfaces, cohérence des données ou latence.
- Les vérifications disponibles : tests, contrôle des types, builds ou scripts de validation.
- Les décisions que le modèle peut prendre et les arbitrages réservés à une personne.
Des objectifs clairs et des contrôles exécutables rendent les progrès vérifiables. Le contexte fournit un espace de travail ; la structure de la tâche détermine son utilisation.
Fable 5.2 progresse en code, raisonnement et lecture de graphiques
Les résultats publiés par Anthropic couvrent plusieurs composantes du travail technique. Le graphique compare FrontierCode 2.0, FrontierSWE v2, Humanity's Last Exam avec outils et Chartography sans outils.
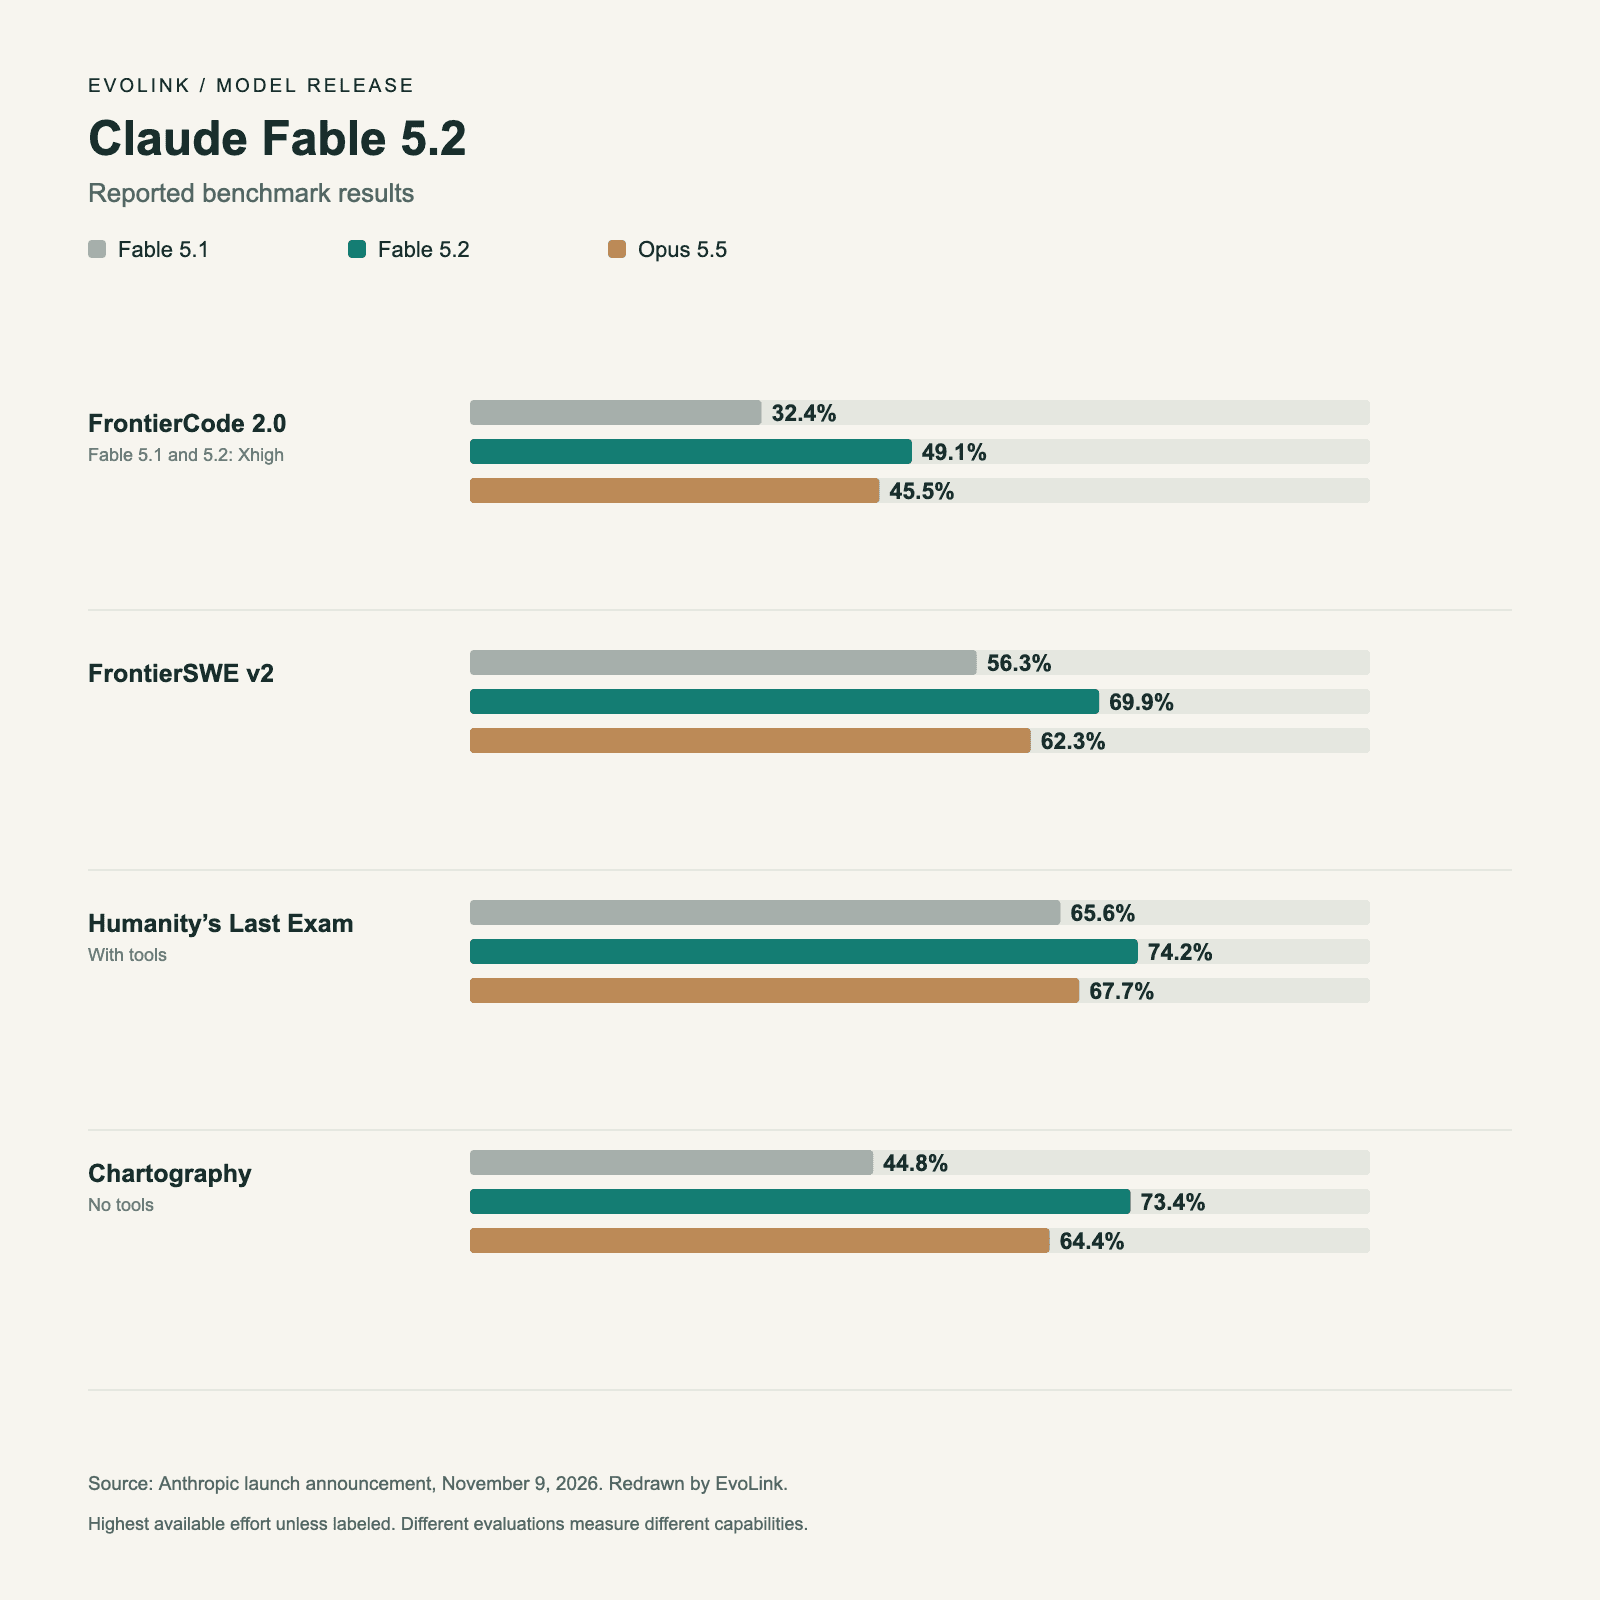
Le code, l'analyse en plusieurs étapes et l'extraction d'informations visuelles se rejoignent souvent. Un développeur peut fournir courbes de performance et journaux d'erreurs pour trouver un goulot d'étranglement ; un chercheur peut lire un graphique puis écrire du code pour tester une explication ; une équipe produit peut transformer une référence visuelle en interface interactive.
Évaluez le modèle avec vos entrées réelles. Si votre travail comprend captures d'écran, graphiques et code, utilisez les trois. Un seul prompt textuel peut masquer des différences importantes dans le processus complet.
Des prototypes électroniques illustrent un travail d'ingénierie en plusieurs étapes
Anthropic et Diode ont demandé à Fable 5.2 de concevoir un haut-parleur de conférence USB, un boîtier d'assistant vocal domestique et un animal virtuel de poche. Le modèle a traité spécifications, schémas, placement des composants, routage des circuits imprimés, boîtiers et micrologiciels. Les ingénieurs de Diode ont fabriqué et testé les appareils. Selon Anthropic, les trois ont fonctionné sans correction de leurs circuits.
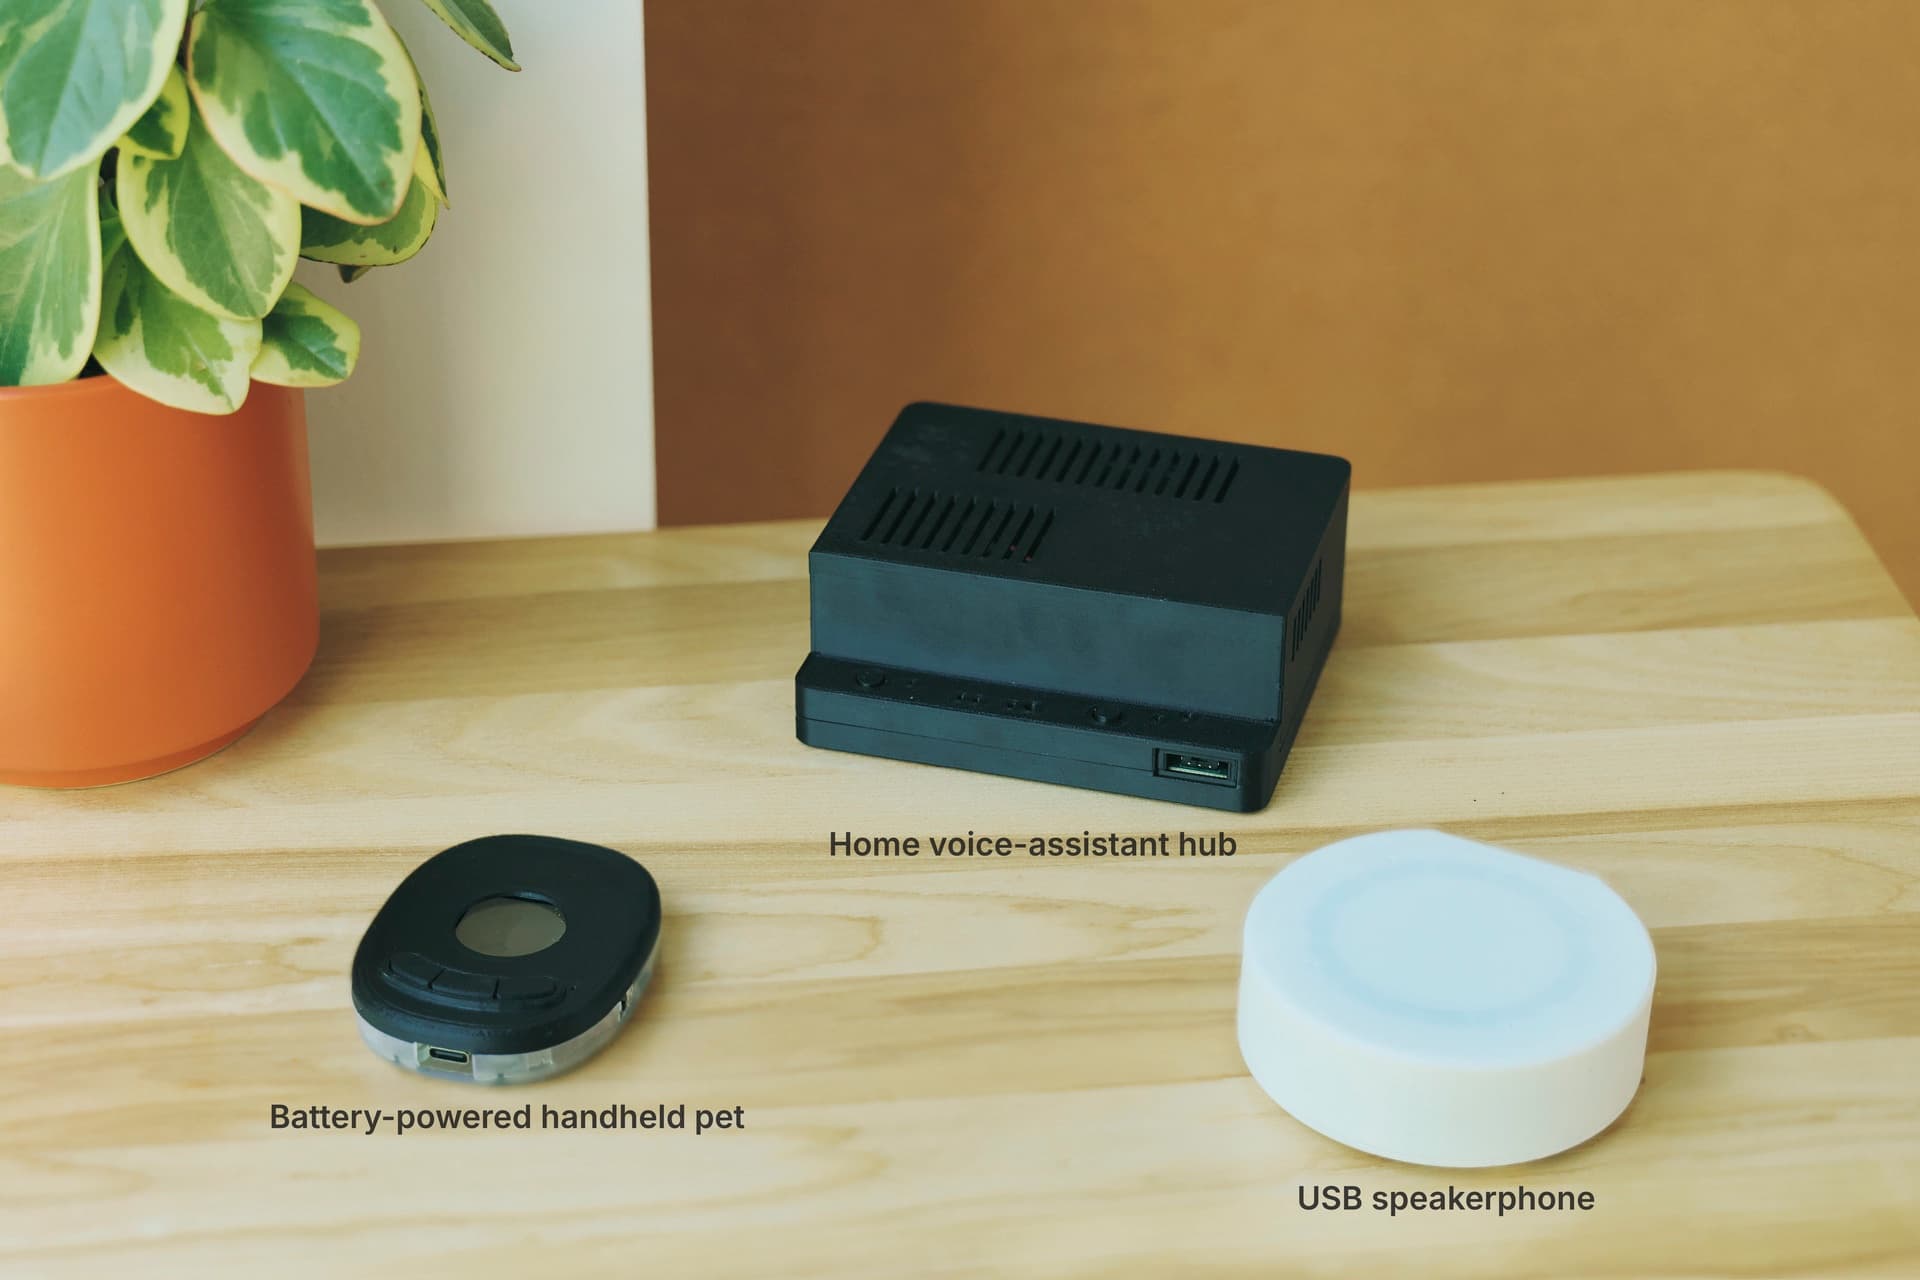
Le placement influence le routage, les connecteurs déterminent les ouvertures du boîtier et l'assemblage affecte la mécanique. Une décision raisonnable à une étape peut créer un problème plus tard. Ce cas illustre l'intérêt de suivre les contraintes et leurs conséquences pendant tout le projet.
Ces appareils restent des prototypes : validation électrique, réglage des antennes, essais thermiques et certification sont encore nécessaires. Les conceptions ne sont pas prêtes pour la production en série. Le prototype fonctionne, mais le développement produit doit continuer. En logiciel, on peut vérifier de même si le modèle a prévu déploiement, supervision, retour arrière et maintenance, au-delà du code exécutable.
Une expérience à 1 000 agents explore la collaboration prolongée
L'enjeu système est la façon dont les agents prennent en charge des tâches dépendantes, partagent l'avancement, soumettent leurs résultats et réunissent les contributions. Un état partagé et des contrôles fiables facilitent la continuité. Une migration importante exige des interfaces communes, une coordination évitant les modifications en double et des tests unifiés. Des sous-tâches de recherche ont besoin de définitions de données cohérentes pour produire des analyses compatibles.
Commencez par des sous-tâches indépendantes et clairement vérifiables avant de multiplier les agents. La concurrence introduit un coût de coordination ; le découpage compte autant que le nombre d'agents.
Jeux et démonstrations interactives rendent les capacités visibles
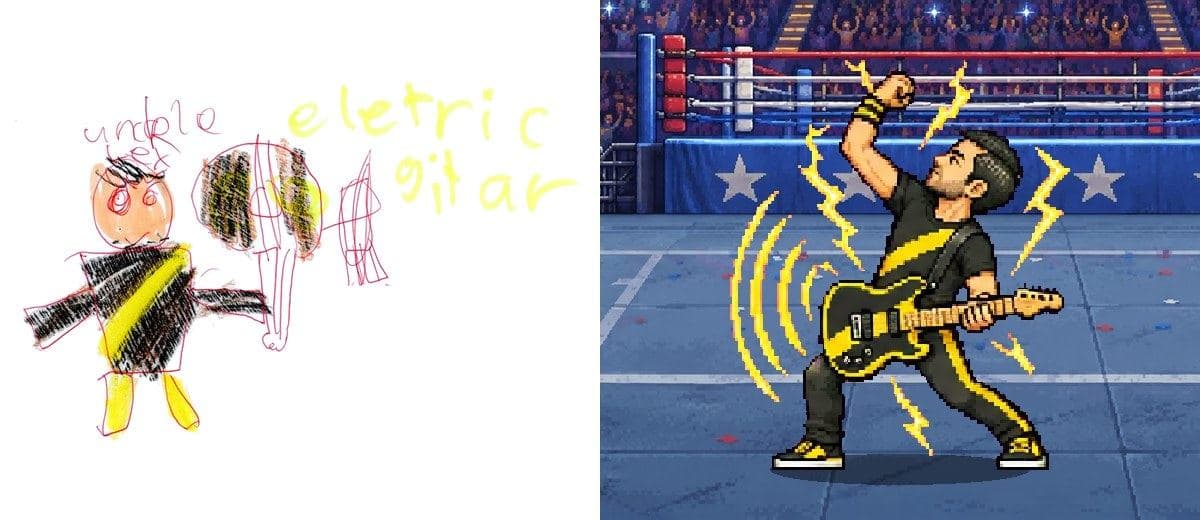
L'intérêt est un travail de production continu : transformer personnages, histoire et objectif en code, appels d'outils de création et tests. Pour des outils éducatifs, des démonstrations interactives ou des expériences de marque, une explication produit à paramètres ajustables ou une simulation manipulable peut aider à vérifier la compréhension d'une idée.
Évaluez aussi le retour des interactions, la stabilité et la facilité de modification. Les prototypes changent souvent ; un code source éditable et des médias bien organisés influencent le coût des reprises.
Tarifs standard en baisse de 20 %, avec une option Fast mode
Les tarifs standard publiés par Anthropic diminuent de 20 % par rapport à Fable 5.1 :
| USD par million de tokens | Fable 5.1 standard | Fable 5.2 standard | Fable 5.2 Fast mode |
|---|---|---|---|
| Entrée | $10 | $8 | $16 |
| Sortie | $50 | $40 | $80 |
Fast mode peut être utile lorsque l'attente a un coût, comme en débogage interactif. Pour les travaux de fond en file d'attente, vérifiez que le gain de temps justifie le tarif supérieur.
Le cache et la facture complète restent importants
Un agent peut réutiliser le contexte du projet et les définitions d'outils entre plusieurs appels. Si les conditions du cache sont remplies, ces tokens suivent une facturation différente des entrées ordinaires. Les nombreuses lectures de cache du projet de jeu montrent aussi l'intérêt de séparer les catégories.
Mesurez entrées ordinaires, écritures et lectures du cache, puis sorties. Ajoutez les outils externes et les reprises humaines pour calculer le coût d'un livrable accepté. Un tarif unitaire inférieur améliore le calcul initial ; le déroulement réel détermine l'économie finale.
L'effort fait partie du choix du modèle
low, medium, high, xhigh et max, avec high par défaut dans l'API. Anthropic conseille de commencer à High, d'essayer Xhigh après avoir mesuré des gains sur des tâches difficiles et de réserver Max à l'exploration des limites ou aux rares travaux où temps et tokens sont secondaires.Résultats Artificial Analysis consultés le 10 novembre 2026 :
| Configuration | Intelligence Index | Coût moyen pondéré d'évaluation par tâche |
|---|---|---|
| Medium | 56 | $3.80 |
| High | 62 | $9.08 |
| Max | 65 | $26.54 |
Ces configurations portent la mention Default Fallback. Les tâches et coûts relèvent de la méthodologie AA et ne constituent pas des devis pour un usage ordinaire. De High à Max, le score progresse dans cet instantané, mais les dépenses d'évaluation augmentent fortement.
Gardez entrées, outils et critères d'acceptation identiques en changeant l'effort. Repérez le premier niveau suffisant, puis vérifiez si un budget accru améliore vraiment le résultat. Un classement d'informations courant et une migration aux dépendances complexes peuvent justifier des réglages différents.
Revoir les anciens prompts lors de la migration
Le guide d'Anthropic indique que les instructions permanentes demandant davantage de sous-agents peuvent provoquer des délégations inutiles. De grands budgets de tokens écrits dans le prompt peuvent aussi affecter la consommation : leur retrait a réduit le coût pour une performance proche dans certains tests de code. Cette observation concerne les budgets en texte, pas la fonction task budgets de l'API.
Vérifiez si chaque tâche exige du parallélisme, toutes les solutions possibles ou des règles anciennes en double. Des critères de fin clairs facilitent l'évaluation. Conservez le prompt initial et testez les changements un par un sur qualité, dépenses et exécution pour distinguer les effets du modèle de ceux du processus.
Points à vérifier pour une intégration en production
Les canaux officiels comprennent Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry et Claude Platform on AWS. Identifiants, fonctionnalités et facturation doivent être vérifiés dans la documentation de chaque canal.
Quatre changements concernent les intégrations existantes :
- Historique : modifier le prompt système, les outils ou les messages précédents peut invalider les blocs de réflexion renvoyés. Le contrôle de préfixe s'applique à tous les comptes. Un bloc invalide avec
prefix_mismatch_behaviornon défini entraîne une erreur 400. - Changement de modèle : passer de Fable 5.2 à Opus 5.5 dans la Claude API supprime les blocs de réflexion Fable, même si la requête aboutit.
- Computer use : l'ancien outil
computer_20251124doit migrer vers le nouvel ensemble d'outils, sauf sur Amazon Bedrock. - Advisor : un exécuteur Fable 5.2 nécessite un advisor compatible Fable 5.2 ou Mythos 5.2.
Avec une passerelle API unifiée, vérifiez la transmission des paramètres, la facturation et la gestion de l'historique lors des changements de modèle dans les longues conversations. Ces comportements affectent directement la production.
Quelles équipes devraient évaluer Fable 5.2 en priorité ?
Les utilisateurs de Fable 5.1 peuvent reprendre des tâches dont la qualité et les coûts sont déjà documentés, puis mesurer achèvement, corrections et dépenses. Les équipes Opus peuvent choisir les difficultés récurrentes : code qui échoue encore aux tests après plusieurs corrections, ou plans qui ne satisfont pas des contraintes liées.
Les équipes de produits à agents peuvent évaluer Fable pour la planification, les analyses difficiles et les vérifications critiques, avec des modèles moins coûteux pour les étapes d'exécution bien définies. Mesurez les transmissions d'informations et la facture complète avant d'adopter ce partage.
Un point de départ concret comprend une tâche courante, un problème connu comme difficile et un projet plus long. Comparez qualité du livrable, durée, coût total et modifications humaines pour choisir modèle par défaut, règle d'escalade et effort. Fable 5.2 offre un plafond de capacité supérieur et des tarifs standard réduits ; les tâches familières révèlent où cela produit des livraisons fiables à un coût acceptable.
Questions fréquentes
Quand Claude Fable 5.2 est-il sorti et que change-t-il par rapport à 5.1 ?
La sortie de Fable 5.2 justifie-t-elle de remplacer Opus 5.5 ?
Quelle différence entre Fable 5.2 et Mythos 5.2 ?
Quel effet la baisse de 20 % par rapport à Fable 5.1 a-t-elle sur le coût total d’une tâche ?
Fable 5.2 peut-il générer directement des images ou des vidéos ?
Que signifient le contexte de 1 million de tokens et la sortie de 128K pour les tâches longues ?
Quels canaux d’accès sont annoncés pour Fable 5.2 ?
claude-fable-5-2. Les autres canaux officiels comprennent Amazon Bedrock, Google Cloud, Microsoft Foundry et Claude Platform on AWS. Vérifiez les identifiants, fonctions et modalités de facturation de chaque canal. Pour EvoLink, consultez la page Fable 5.2 afin de connaître l'intégration et les tarifs actuels ; la compatibilité des paramètres et de l'historique doit aussi être vérifiée pour les routes tierces. Disponibilité officielleQuel niveau d'effort choisir pour commencer ?
high par défaut ; les niveaux sont low, medium, high, xhigh et max. Commencez à High et comparez les autres niveaux avec les mêmes entrées, outils et critères d'acceptation. Essayez Xhigh après avoir mesuré un gain sur les tâches difficiles ; utilisez Max si l'exploration des limites justifie davantage de temps et de tokens. Conseils sur l'effortPourquoi une conversation existante peut-elle renvoyer une erreur 400 après migration ?
prefix_mismatch_behavior produit une erreur 400. Vérifiez la gestion de l'historique et le comportement documenté en cas de préfixe différent. Autre comportement distinct : passer de Fable 5.2 à Opus 5.5 dans la Claude API peut supprimer les blocs de réflexion alors que la requête réussit. Changements de migration