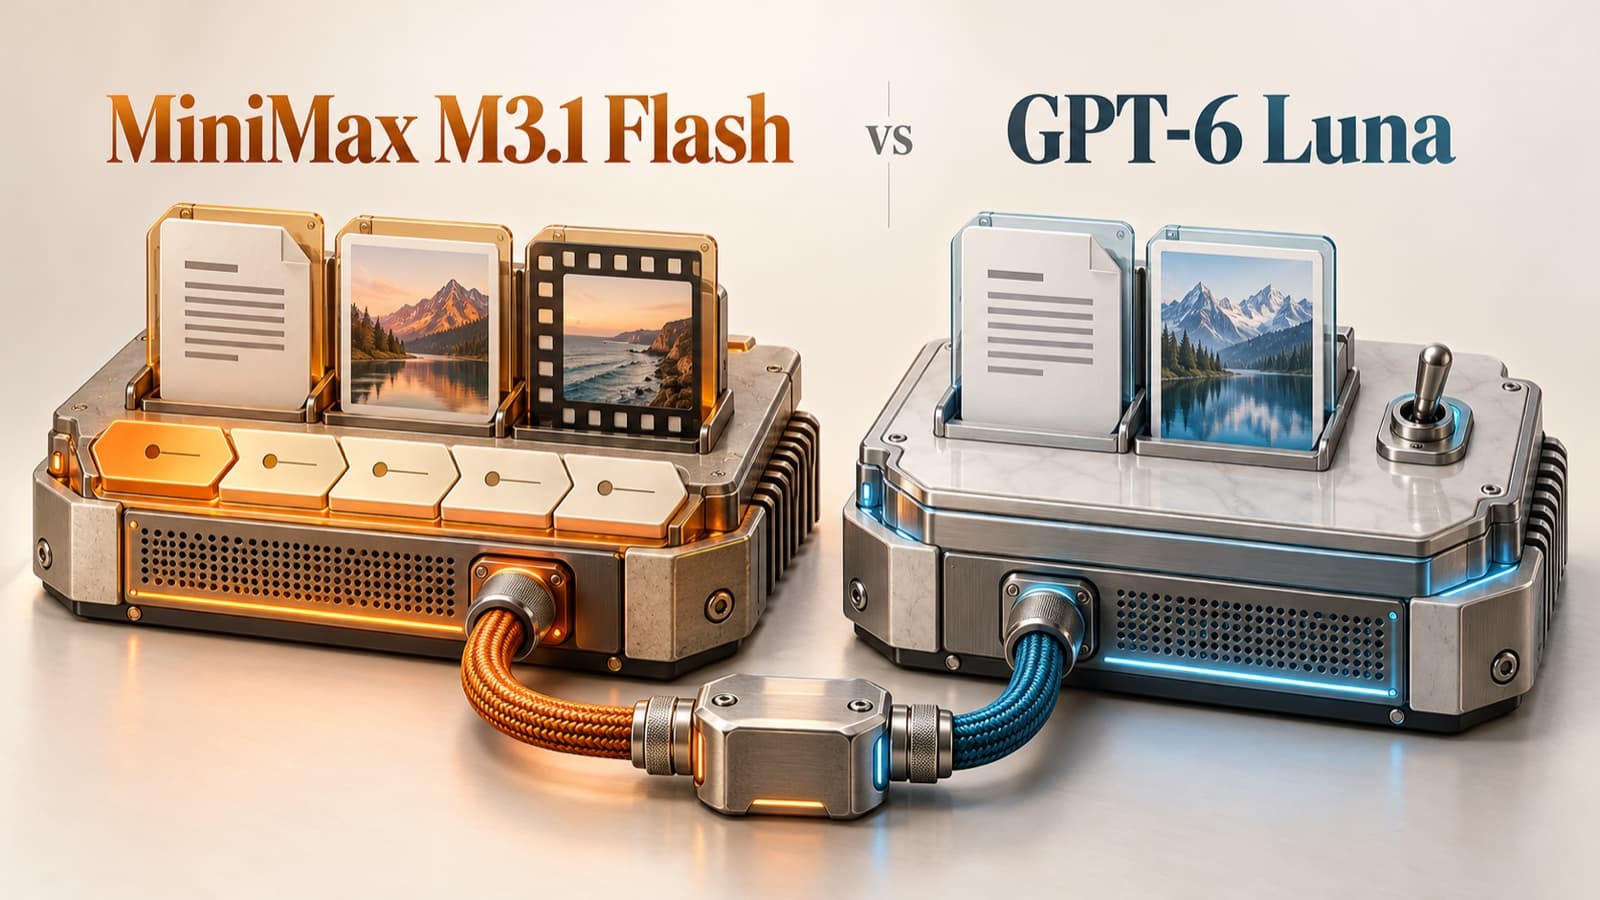
MiniMax M3.1 Flash vs. GPT-6 Luna: Eingaben und Tools

MiniMax M3.1 Flash vs. GPT-6 Luna: Eingaben und Tool-Verträge
| Parameter | MiniMax M3.1 Flash | GPT-6 Luna |
|---|---|---|
| Anbieter | MiniMax | OpenAI |
| Offizielle Modell-ID | MiniMax-M3.1-Flash | gpt-6-luna |
| Ausrichtung | Coding, Agents, multimodale und lange Kontexte | Klar begrenzte Zusammenfassung, Klassifikation und Extraktion in großem Umfang |
| Kontextfenster | 1.000.000 Tokens | 1.050.000 Tokens |
| Eingaben | Text, Bilder und Video | Text und Bilder; kein natives Audio oder Video |
| Ausgabe | Text | Text |
| Denkstufen | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Standard | max; nicht abschaltbar | medium; mit none abschaltbar |
| Function Calling | Interleaved Thinking; vollständige Assistant-Antwort zwischen Runden erhalten | Responses verbindet Reasoning und Funktionen; Chat Completions verlangt für Funktionen reasoning_effort: none |
| Offizieller Input-/Output-Preis | $0.15 / $0.60 je Million Tokens | $0.10 / $0.50 je Million Tokens, Standard bis 272K Input-Tokens |
| Offizieller Cache-Lesepreis | $0.015 je Million Tokens | $0.01 je Million Tokens im selben Eingabeband |
Was diese Unterschiede in der Anwendung ändern
none und startet standardmäßig mit medium. Setzen Sie den beabsichtigten Wert beim Wechsel explizit. Verlangt eine Aufgabe kein Reasoning, ist MiniMax low nicht derselbe Vertrag wie Luna none.reasoning_content und tool_calls oder sämtlichen Anthropic-Inhaltsblöcken. Für Luna mit Reasoning und Funktionen nutzen Sie Responses; bei Chat Completions muss Reasoning für Function Calling aus sein. „OpenAI-kompatibel“ allein beweist weder gleiches Tool-Verhalten noch alle nativen Funktionen beim Gateway.Das konkrete Modellpaar über EvoLink auswählen
EvoLink bündelt Authentifizierung, Modellkonfiguration und Nutzungsdaten. Gleichen Sie erst Eingabe und Protokoll ab, dann die tatsächliche Aufgabe. Mehr Kontext beschreibt Kapazität, nicht korrekte Belegnutzung. Ein niedrigerer Tokenpreis beweist keine geringeren Kosten pro abgenommenem Ergebnis.
Halten Sie Prompt, Input-Version und Tools vergleichbar. Prüfen Sie serialisierte Einstellung, finale Antwort, Tool-IDs, Ende, Wiederholungen, Gesamtdauer und reale Kosten. Bewerten Sie die komplette Aufgabe statt nur Streaming-Geschwindigkeit. Gewünschte Ausgabesprache und Format gehören in die Abnahme; ein gemessenes Sprachqualitätsranking liefert dieser Beitrag nicht.
Beide aktuellen Modellkonfigurationen ansehen
Spezifikationen, Preise und Request-Einstiege stehen auf den vorhandenen Modellseiten.