
Kimi K3.1 Pro API 价格:Token 费率、缓存费用与预算算例
查看 Kimi K3.1 Pro 与 Highspeed 的输入、输出、缓存读取和写入费率,通过单次调用、缓存续期和每千次请求算例估算 API 预算。
 EvoLink Team
文章目录
EvoLink 同时提供两种缓存写入选项。单次调用的费用,取决于输入、输出、缓存和工具的实际用量。
下面先看完整费率,再通过具体算例计算一次请求和每月调用预算。
在 EvoLink 使用 Kimi K3.1 Pro 多少钱?
| 计费项目 | K3.1 Pro 标准版 | K3.1 Pro Highspeed |
|---|---|---|
| 普通输入 | $2.00 | $4.00 |
| 输出 | $10.00 | $20.00 |
| 缓存读取 | $0.20 | $0.20 |
| 缓存写入:5 分钟 | $2.00 | $4.00 |
| 缓存写入:1 小时 | $4.00 | $8.00 |
理解这张表,可以先区分三类输入:
- 普通输入:按普通输入费率结算的内容。
- 缓存读取:成功复用已有缓存的内容。
- 缓存写入:新写入缓存、按有效期计费的内容。
一次 API 调用要花多少钱?
Kimi K3.1 Pro 按 Token 用量收费,没有统一的按次价格。短问答、长文档分析和重复上下文请求,会形成不同的账单。
下表按上述费率计算三种用量:
| 每次请求的用量 | 标准版单次费用 | Highspeed 单次费用 | 标准版调用 1,000 次 |
|---|---|---|---|
| 2,000 普通输入+1,000 输出 Token | $0.014 | $0.028 | $14 |
| 100,000 普通输入+10,000 输出 Token | $0.30 | $0.60 | $300 |
| 100,000 缓存读取+1,000 普通输入+2,000 输出 Token | $0.042 | $0.064 | $42 |
小型请求:标准版每次 0.014 美元
一次请求使用 2,000 普通输入 Token,生成 1,000 输出 Token:
普通输入:2,000 ÷ 1,000,000 × $2  = $0.004
输出:    1,000 ÷ 1,000,000 × $10 = $0.010

合计:$0.014较大请求:标准版每次 0.30 美元
一次请求使用 100,000 普通输入 Token,生成 10,000 输出 Token:
普通输入:100,000 ÷ 1,000,000 × $2  = $0.20
输出:     10,000 ÷ 1,000,000 × $10 = $0.10

合计:$0.30估算月度预算时,可以将应用里的请求分成几类,分别计算单次费用,再乘以各自的调用次数。
Highspeed 的费用会翻倍吗?
Highspeed 的普通输入、输出和缓存写入单价都是标准版的两倍,但缓存读取价格保持不变。
如果一次请求只包含普通输入和输出,相同用量下的 Token 费用会翻倍:
100,000 普通输入+10,000 输出 Token

标准版:  $0.30
Highspeed:$0.60
如果请求中包含大量缓存读取,差距会缩小:
100,000 缓存读取+1,000 普通输入+2,000 输出 Token

标准版:  $0.042
Highspeed:$0.064这些算例固定 Token 用量,以说明费率差异;实际调用应按接口报告的各项用量分别计算。
缓存费用:首次写入和后续读取怎么算?
标准版缓存读取单价是普通输入的十分之一,但首次建立缓存需要支付写入费用。
假设一次标准版请求包含:
- 100,000 Token 的可复用前缀,首次写入 5 分钟缓存;
- 1,000 普通输入 Token;
- 2,000 计费输出 Token。
首次请求的费用为:
缓存写入:100,000 ÷ 1,000,000 × $2  = $0.200
普通输入:  1,000 ÷ 1,000,000 × $2  = $0.002
输出:      2,000 ÷ 1,000,000 × $10 = $0.020

首次请求合计:$0.222
后续请求成功复用这 100,000 Token 的缓存时,费用变为:
缓存读取:100,000 ÷ 1,000,000 × $0.20 = $0.020
普通输入:  1,000 ÷ 1,000,000 × $2    = $0.002
输出:      2,000 ÷ 1,000,000 × $10   = $0.020

后续单次合计:$0.042
如果首次写入后,另外九次请求都成功命中缓存:
十次请求总费用
= $0.222+9 × $0.042
= $0.60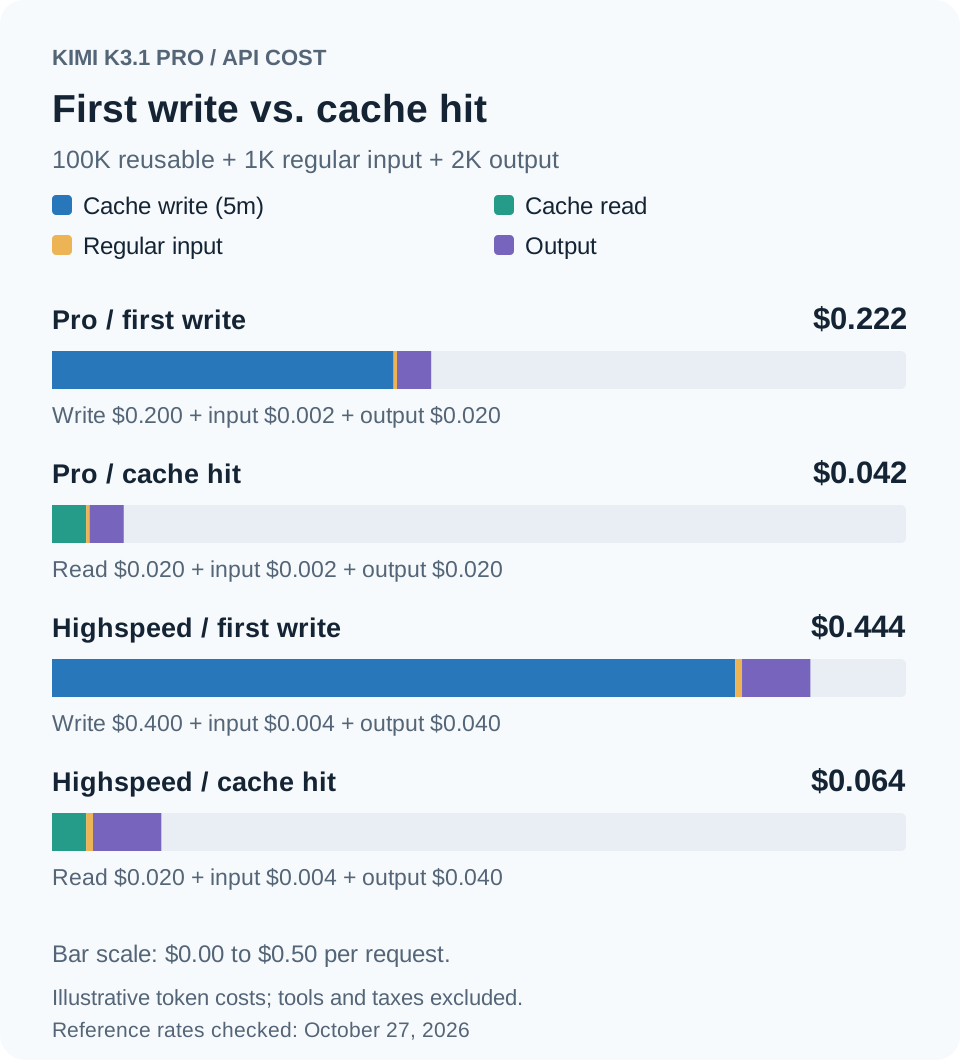
5 分钟和 1 小时缓存有什么价格区别?
标准版的缓存写入价格分别为:
- 5 分钟:每百万 Token 2 美元。
- 1 小时:每百万 Token 4 美元。
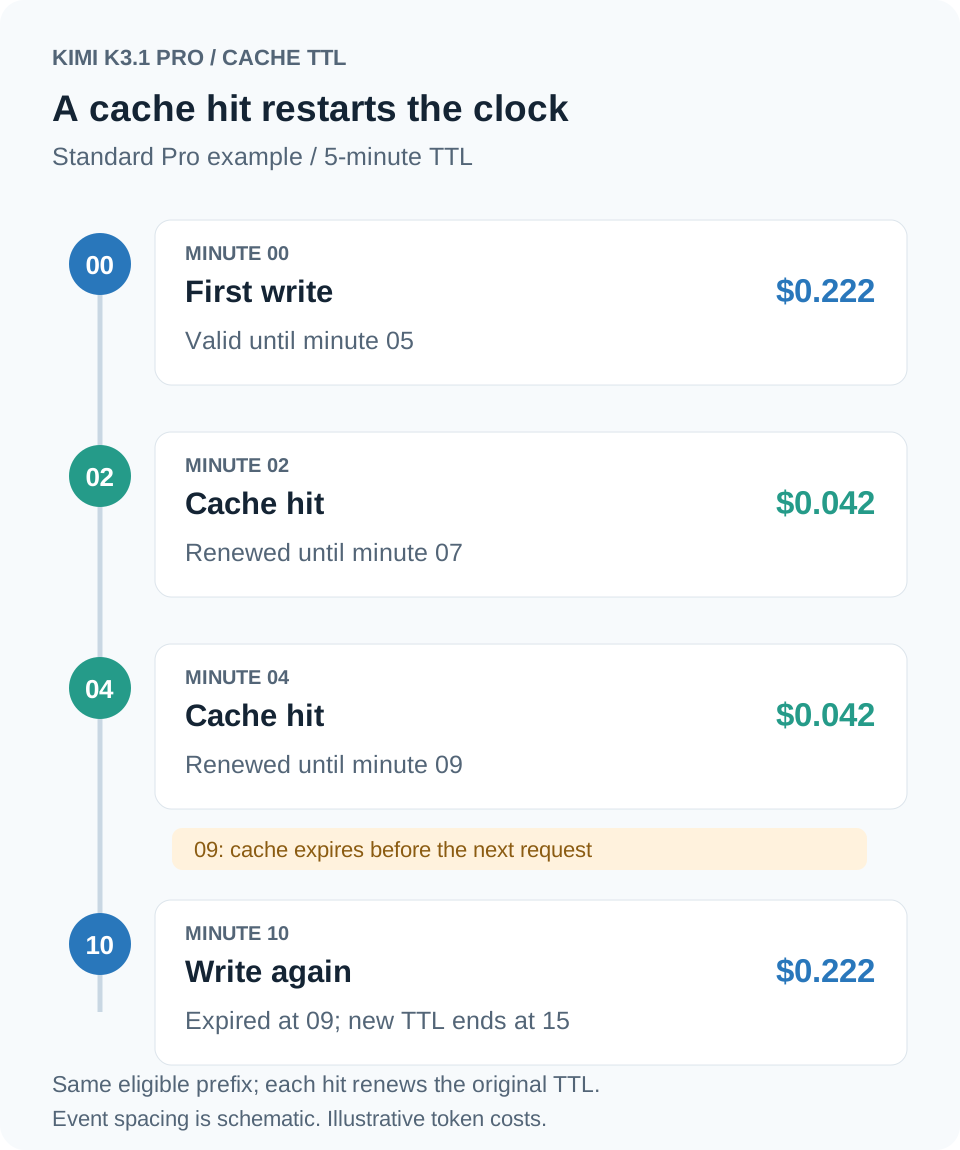
计算重复请求费用时,调用次数和请求间隔都需要考虑。相同的十次调用,全部命中缓存与多次过期重写,会得到不同的总价。
推理 Token 怎么收费?
例如,一次请求的全部计费输出为 10,000 Token,其中包含:
- 9,000 推理 Token;
- 1,000 最终答案 Token。
标准版输出费用为:
10,000 ÷ 1,000,000 × $10 = $0.10这里的推理 Token 已经包含在总输出中,不应再次相加。核对账单时,使用接口报告的全部计费输出即可。
工具费和最低收费
三次符合收费条件的搜索,对应工具费为:
3 × $0.005 = $0.015工具费需要与模型 Token 费用合并计算。搜索返回内容进入后续请求时,也可能增加模型输入用量。
用代码计算自己的 Token 费用
下面的 JavaScript 示例使用标准版参考费率。修改用量后,即可计算对应的 Token 费用。
// Standard Pro reference rates checked on October 27, 2026.
// Input categories must not overlap.
const tokens = {
  regularInput: 1_000,
  cachedInput: 100_000,
  cacheWrite5m: 0,
  cacheWrite1h: 0,
  output: 2_000, // Includes billed reasoning tokens.
};

const ratePerMillion = {
  regularInput: 2,
  cachedInput: 0.2,
  cacheWrite5m: 2,
  cacheWrite1h: 4,
  output: 10,
};

const tokenCost = Object.entries(tokens).reduce(
  (total, [category, count]) =>
    total + (count * ratePerMillion[category]) / 1_000_000,
  0
);

console.log(`Estimated token cost: $${tokenCost.toFixed(6)}`);
// Estimated token cost: $0.042000ratePerMillion。常见问题
Kimi K3.1 Pro 每个 Token 多少钱?
按标准版基础费率换算:
- 普通输入:每 Token 0.000002 美元。
- 输出:每 Token 0.00001 美元。
- 缓存读取:每 Token 0.0000002 美元。
这些是各类 Token 的单价,单次调用费用取决于对应数量。
缓存读取便宜 90%,整次请求也会便宜 90% 吗?
不会。90% 是标准版缓存读取单价相对普通输入单价的降幅,整次请求还可能包含输出、缓存写入和工具费用。
为什么不同网站显示的价格不同?
核对报价时,应确认模型名称、标准版或 Highspeed、提供商、币种、计费单位和更新日期。公开标价、账户优惠价和按特定用量计算的加权均价,也属于不同口径。


