
Kimi K3.1 Pro 评测解读:编程、3D 建模与研究能力
从代码修复、Blender 与 CAD 建模到数据分析,结合公开评测与具体案例了解 Kimi K3.1 Pro 的表现、使用重点和最终答案等待时间。
 EvoLink Team
文章目录
Kimi K3.1 Pro 在公开测试中完成了代码修复和数据调查,也在浏览器验证、数据分组等环节暴露出问题。官方展示的 Blender 与 CAD 案例,则把它的任务范围延伸到了三维场景和结构化模型。
这些产出能做到什么程度,哪些地方需要检查,最终答案又要等多久?下面结合 Artificial Analysis、Atomic Agent、PacBench、Plotly 的结果和月之暗面的官方案例,逐项来看。
Kimi K3.1 Pro 评测结果:编程、Agent 与推理
Artificial Analysis 在 2026 年 10 月 23 日的首发评估中,测试了终端任务、SaaS 工作流、知识工作和高难度推理:
| 评测 | K3.1 Pro 结果 | 主要观察对象 |
|---|---|---|
| Terminal-Bench 4.0 | 67% | 终端环境中的编程与操作任务 |
| AutomationBench-AA | 73% | Agent 执行 SaaS 工作流的能力 |
| GDPval-AA | 1,846 Elo | 知识工作交付物的相对表现 |
| Humanity’s Last Exam | 52% | 高难度知识与推理问题 |
这四项评测对应的工作并不相同:终端与 SaaS 任务要求 Agent 在环境中执行操作,知识工作评测关注交付物,高难度问答则更侧重推理与求解。它们放在一起,能帮助读者区分“会回答问题”和“能推进任务”这两类能力。某一类任务表现好,也可能在工作流的其他环节留下弱点。
具体到开发工作,修复一个代码库问题,需要读文件、修改代码、运行检查并解释失败;交付一个交互应用,还多了控制、渲染和实际使用行为。接下来的案例,可以看到这些差异如何影响最终产出。
编程能力:代码修复与长任务
一个 Python 修复任务中的 Low 与 Max
Atomic Agent 在一个 Python 包中设置了五个缺陷和两个缺失功能:结算函数与命令行工具。任务提示很短,要求 Agent 读取任务文件、完成工作,并运行测试直到通过;运行环境使用 Atomic Agent v0.6.9,任务和工具保持一致。
每种推理档位运行三次,每次另用 32 项隐藏断言检查。这些隐藏检查与 Agent 工作时可见的测试分开。两种设置均全部通过:
| 设置 | 三次运行累计通过断言 | 平均耗时 | 平均模型调用次数 |
|---|---|---|---|
| Low | 96/96 | 2.2 分钟 | 19 次 |
| Max | 96/96 | 4.9 分钟 | 28 次 |
按报告中的平均值计算,max 的耗时约为 low 的 2.2 倍,模型调用次数多约 47%,通过结果相同。
对于代码修复,最终应比较补丁本身:是否修复目标行为,是否保留原有接口,是否引入无关修改。更高的推理档位如果改善了这些结果,就有实际价值;解释更长、调用次数更多,则首先是执行方式的差异。
长任务中,能否换一个方向查问题
这个模拟器建立在 human-atlas 人体解剖模型上,包含 296 个骨骼组件和 402 个肌肉组件。官方描述的排查过程包括对动力学进行开环探查,再修正计算并重新训练控制器。
在相互依赖的系统里,训练结果不佳可能来自控制器,也可能来自模拟器。类似地,应用代码的问题可能出在依赖、测试夹具或底层数值假设中。一直调整外层参数,未必能触及真正的故障点;这个案例中的变化,是从训练目标转向了定义训练环境的底层计算。
长任务的有效推进,也包括这样的诊断转向:读取依赖、检查一个数值前提,或在新结果出现后修改原来的判断。交付时保留改动文件、测试命令和结果,才能让后续开发者接着工作。
生成的游戏,以及没完成的浏览器验证
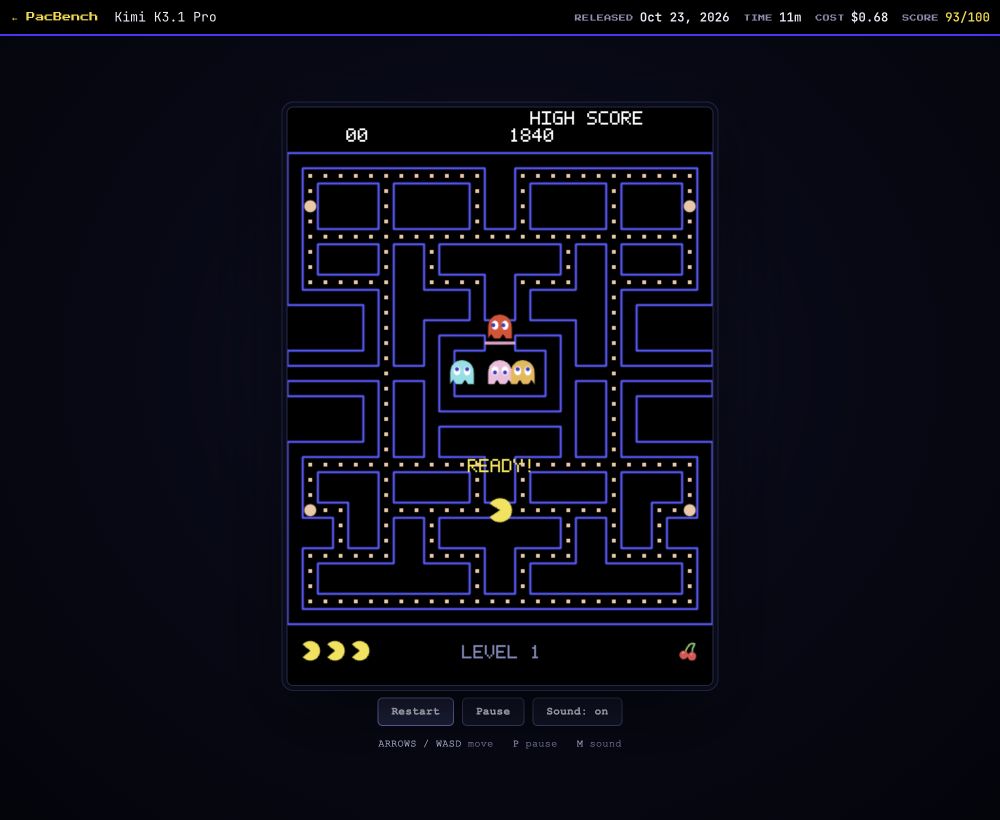
PacBench 的 K3.1 Pro 条目使用 high 档位,经历 17 次模型响应,耗时约 11.5 分钟。生成的 Pac-Man 游戏和运行记录均已公开,可以直接查看。
评测者也记录了已经做好的部分:经典的 28×31 迷宫布局,244 个豆子均可到达,在所测帧率下没有卡死移动。这让剩余问题比一句“能玩”或“不能玩”更具体。
这些问题对应着不同的验证层次。Node 替代环境可以检查游戏状态变化,键盘焦点和后台音频则属于浏览器行为。检查能否通关,与检查玩家实际操作时的体验,是交互程序验收中的两件事。
3D 建模:Blender、CAD 与作品检查
CAD 评测重建的是什么?
指标 Voxel IoU 衡量生成形状与参考形状在体素空间中的重叠程度,反映几何相似度,不是可直接投入生产的资产比例。这类任务更接近恢复物体结构,而不只是生成一张看起来可信的图片。
从可见形状到可继续编辑的资产
观察一个具体作品时,可以分三层检查:
| 观察层面 | 能够了解什么 |
|---|---|
| 整体形态 | 轮廓、比例、空间布局 |
| 局部结构 | 连接、遮挡、对称与细节 |
| 实际使用 | 源文件、尺寸、拓扑和导出结果 |
作品检查清单:本文整理。
对于机械对象,可以关注连接部件是否真正对齐,改变尺寸后连接关系是否保持;对于建筑场景,可以检查重复构件、开口与空间布局。这些检查可以发现单一视角下容易隐藏的穿插和连接缺失。
交付格式同样重要:预览图便于看外观,可编辑文件便于继续修改,导出文件则服务于下一个工具或制作环节。开始任务时就确定最终需要哪种格式,更容易分清一个漂亮展示和一份能交给别人继续工作的资产。
数据分析:Plotly 测试中的 42/43 与分组失误
模型通过了 42 个问题,包括全部五个隐藏规律问题和三个数据质量问题。
找出问题里没有明确提示的异常
在数据质量案例中,Plotly 记录了模型发现重复行、月末最后一天数据缺失,并区分“已退役而没有数据的风机”和“确实没有发电的风机”。这些状态在业务含义上不同,简单汇总时却很容易混在一起。
隐藏规律题则要求模型在没有被直接告知目标的情况下继续调查。这与探索性分析很接近:下一条查询,要根据上一条查询发现了什么来决定。它考察的不只是写出一条 SQL,还包括能否选择值得追下去的问题。
一个小的分组错误,怎样改变最终答案
“没有使用这个固件”和“使用了其他固件”并不是同一组记录,因为还存在没有安装固件的状态。把这部分数据加进去,在统计检验开始前就已经改变了比较基线。
因此,一个分析过程可以看起来严谨,实际回答的问题却已经发生偏移。检查时先看哪些记录进入了各组、哪些被排除、缺失状态代表什么,再检查计算过程和文字解释。只有分组定义与业务问题一致,后续计算才是在回答同一个问题。
金融与研究产出
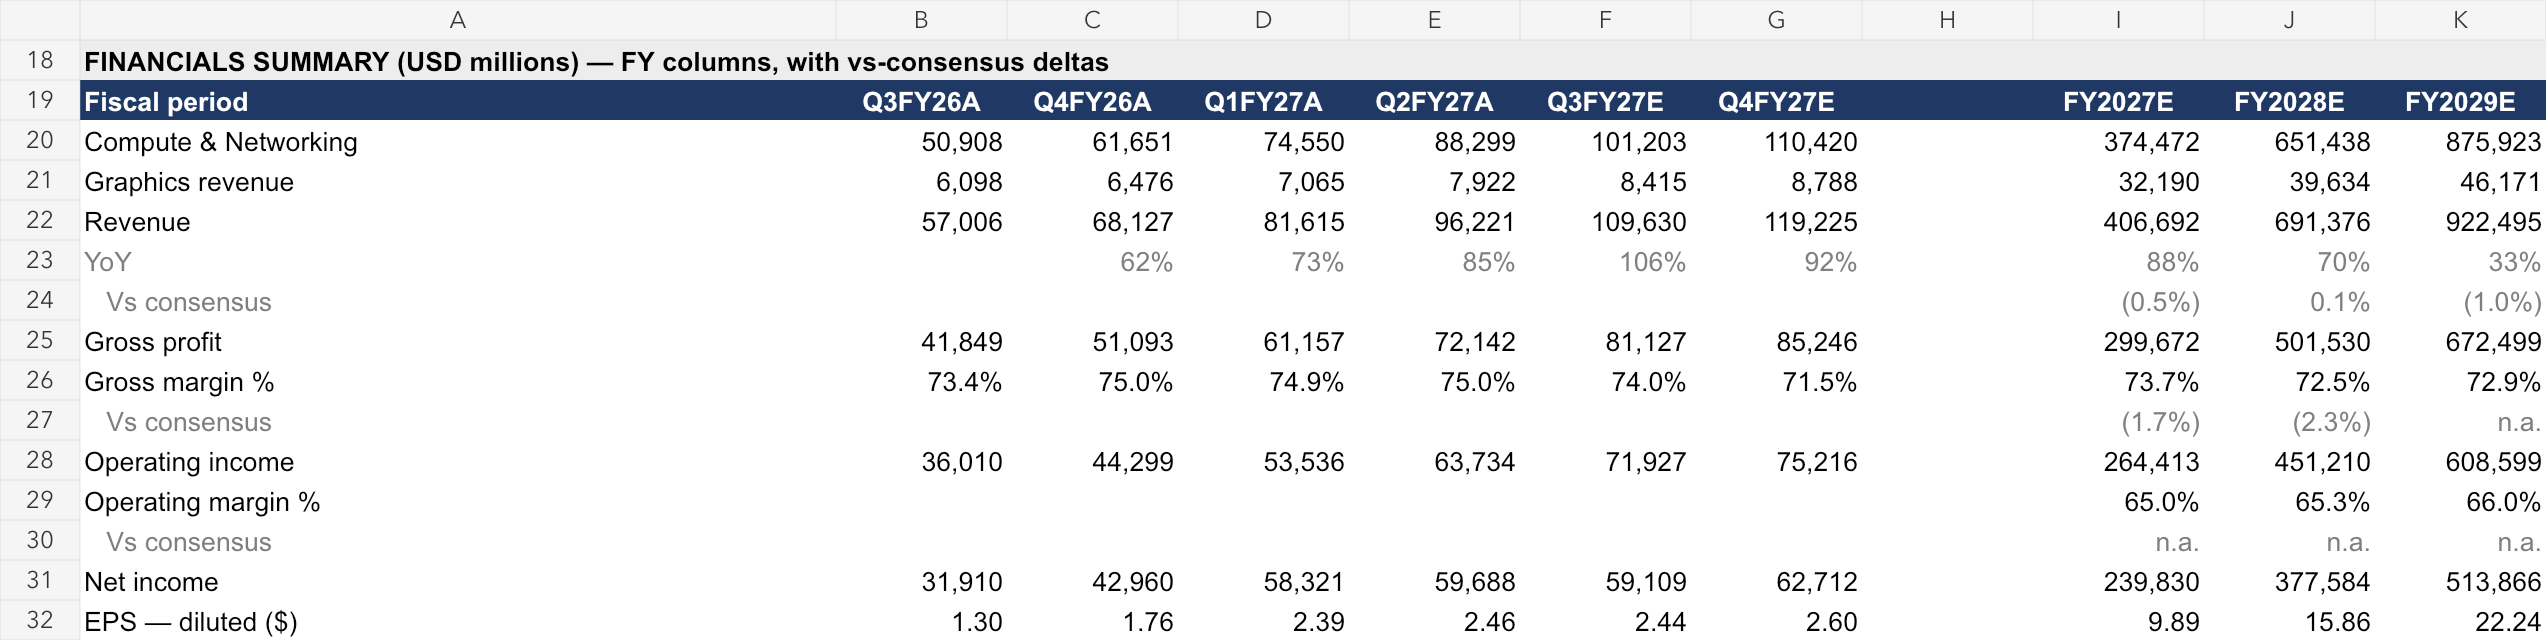
NVDA 截图把季度与年度列、收入、利润、利润率和稀释每股收益放在同一个财务汇总页中。读者能否从这些汇总数字追溯到背后的假设和工作表,是这类文件是否便于使用的重要部分。
检查建模工作簿时,可以沿着一个预测值,从假设追到公式引用,再追到汇总页,核对财务期间是否一致,以及改变假设后是否更新了预期输出。检查报告或演示稿时,则沿着重要结论回查来源,确认图表和文字使用相同期间与口径。
这也说明研究交付不只是写一篇长回答:工作簿需要数值之间的依赖关系,演示稿需要论证顺序,报告需要可追溯的依据。模型的价值,也包括把这些关系组织成别人能够检查、修改和继续使用的文件。
图片与视频理解:接入时检查什么?
- 图表任务:同时核对数值、单位和统计口径。
- 空间任务:检查对象之间的位置与关系。
- 视频任务:测试跨画面的动作顺序和状态变化。
图表任务很能体现“读到内容”和“理解内容”的差别。读出两个数字之后,还要把数字对应到正确的坐标轴、图例和说明;如果单位、期间或统计范围不同,直接比较就可能产生错误结论。
content 应使用消息片段数组,图片通过 base64 或已上传文件引用传入。官方指南按关键帧解释视频处理,帧数与分辨率会影响输入量,具体格式见视觉输入文档。视频任务应选取必须理解先后顺序才能回答的样例,例如故障前发生了什么变化,或哪一个动作先于另一个动作。上文公开测试主要集中在编程和数据工作;视觉应用还需要覆盖它实际要识别的事件与细节。
推理延迟:为什么最终答案要等更久?
2026 年 10 月 24 日,AIHubMix 用一个解释哈希表并附带 Python 代码的提示,对标准 Pro 进行了三次 low 档位测试。首个推理 token 与首个最终回答 token 的等待时间有明显差距:
首个推理 token 与最终回答 token 的等待时间
标准 Pro · 一个提示 · low 档位 · 三次运行
- 首个推理 token
- 3.6–4.5 秒
- 首个最终回答 token
- 71–91 秒
自请求开始的时间(秒)
这组三次运行中,推理约占完成 token 的 85%–90%,其中一次触及了 8,192 个完成 token 的上限。如果界面只展示最终答案,模型已经在输出推理时,用户仍可能看到一个没有进展的页面。
流式进度与可用答案,是不同的时间点
一次请求至少有三个值得区分的时间点:流开始返回、最终答案开始输出、整个响应完成。连接正常,并不意味着用户已经拿到可用答案;很快收到第一个 token,也不能说明完整等待很短。
对于交互式应用,应使用真实提示记录这三个时间点,同时记录推理档位和完成 token 上限,区分“回答很快但被截断”和“完整交付了答案”。对于后台任务,最终质量与总耗时往往比首次出现文字的时间更重要。
reasoning_content 对应推理增量,content 对应最终回答增量。应用可以据此区分处理状态和最终需要展示、解析的答案。多轮工具任务中,官方快速开始还要求保留完整 assistant 消息及匹配的工具结果,不能只留下最后的回答文字。这让延迟问题与 Agent 执行过程联系起来:应用管理的是一个持续任务,包括工具请求、返回观察和最终答案。推理档位只是其中一个控制项,验证方式和消息处理也会影响任务能否正确交付。
Kimi K3.1 Pro 适合哪些任务?
不同案例对应着不同的使用重点:
| 能力方向 | 现有证据支持的认识 | 仍需保留的边界 |
|---|---|---|
| 编程与长任务 | 完成代码修复并持续调试 | 更复杂项目的稳定性仍需在目标环境验证 |
| 3D 与空间 | 借助工具构建三维场景和对象 | 几何重叠度不能说明拓扑或导出质量 |
| 数据与研究 | 在 Plotly 专项测试中取得较好结果 | 分组规则与假设仍可能出错 |
| 视觉理解 | 官方支持图片与视频输入 | 上述测试尚未覆盖专项视觉任务的准确性 |
| 推理与执行 | 投入较多推理和工具调用 | 额外投入可能增加延迟,却不改善已测结果 |
根据上文所引来源整理。
可以先从一个能够明确验收的任务开始:代码修复保留原来的失败用例,并检查最终 diff;数据分析准备一组已知答案,加入缺失值或特殊状态;三维交付则先约定源文件与导出格式,再查看预览。
同时记录最终质量、执行时间、工具调用和 token 用量,再扩展到更开放的任务。Atomic 的档位比较、PacBench 的浏览器验证缺口、Plotly 的分组错误,都能转化为具体检查项。这些检查让评估更贴近模型实际要完成的工作。
常见问题
Kimi K3.1 Pro 能生成可编辑的 3D 模型吗?
写代码时,low 和 max 推理档位怎么选?
先用有代表性的任务集比较。Atomic Agent 的 Python 实验中,两种设置通过相同断言;low 平均耗时 2.2 分钟、调用 19 次,max 为 4.9 分钟、28 次。当更高档位能改善补丁质量或通过率,再判断收益是否值得增加的时间与用量。
为什么 Kimi K3.1 Pro 已经开始流式输出,却迟迟没有最终答案?
Plotly 测试通过 42/43,研究结论可以直接用吗?
这是模型在 Plotly 合成风电场数据上的一项较好成绩。未通过的固件问题说明,比较对象与分组规则仍值得重点检查。换到自己的数据后,需要核对缺失值、期间、公式,以及来源是否支持相应结论。


