
Kimi K3.1 Pro 对比 K3:哪些任务值得升级?

从 K3 到 K3.1 Pro,改变了什么?
月之暗面称 K3.1 Pro 是投入更多后训练算力的 K3 版本。长上下文和视觉理解延续自 K3,不是升级后新增的容量;真正要判断的是行为变化是否改善交付。
| 维度 | Kimi K3 | Kimi K3.1 Pro | 如何判断 |
|---|---|---|---|
| 家族位置 | 上一代基线 | 进一步后训练的版本 | 保存现有 K3 结果作为基线 |
| 上下文 | 1,048,576 tokens | 1,048,576 tokens | 不以更大的标称上下文为升级理由 |
| 任务方向 | 编程与长任务 | 官方强调编程、3D 和研究提升 | 找真实工作流中的薄弱点测试 |
| 服务选择 | 现有 K3 路由 | Pro 与 Pro Highspeed | 明确选择变体 |
| 网关费用 | 当前 K3 账户费率 | 当前 K3.1 账户费率 | 比同一账户,不混用不同价目表 |
独立首发评估能证明什么?
Artificial Analysis 于 2026 年 10 月 23 日发布以下快照,基线为 Kimi K3 的 max 配置。这是该机构的评估,不是 EvoLink 实测。
| 指标 | K3 | K3.1 Pro | 解读 |
|---|---|---|---|
| Intelligence Index | 44 | 55 | 该综合评估提高 11 分 |
| 每个 Index 任务输出 | 约 48,000 tokens | 约 55,000 tokens | 更多计费生成可能抵消部分降价 |
| 每个 Index 任务费用 | 与 Pro 大致相当 | 约 $1.98 | 该测试的费用快照,不是你的预算 |
低 Token 单价不等于低任务成本
2026 年 10 月 24 日核对的 Moonshot 国际参考价,K3 普通输入/输出为每百万 Token $3/$15,标准 Pro 为 $2/$10。这是提供商直连标价,不是 EvoLink 当前账户报价。缓存读写、工具、税费和重试另行考虑。
| 情况 | 普通输入 | 计费输出 | 参考费用 |
|---|---|---|---|
| K3 基线 | 100,000 | 10,000 | $0.45 |
| Pro,Token 数相同 | 100,000 | 10,000 | $0.30 |
| Pro,生成量增加 | 100,000 | 25,000 | $0.45 |
第二行省钱的前提是固定 Token 数;第三行还没有加入重试或工具,费用就达到基线。生产中应衡量获得一个验收结果的成本:
accepted_task_cost =
  (initial_call_costs + retry_costs + fallback_costs + tool_fees + review_cost)
/ accepted_deliverables按工作负载决定是否升级
| 工作负载 | 适合先试 Pro 的情况 | 适合保留既有路由的情况 |
|---|---|---|
| 仓库修复 | K3 卡住、反复纠正或漏过测试 | 当前补丁质量和预算已达标 |
| 长文档 | 跨文档核对或输出完整性不足 | 真正瓶颈在提取和检索 |
| 交互应用 | 需要更高完成质量,且 Pro 响应达标 | 等待仍不可接受;Highspeed 另测 |
| 批处理与重复任务 | 同一样本中,每个验收结果的总成本下降 | 额外推理或审查吃掉表面节省 |
Highspeed 是另一个服务选择。官方约 2–3 倍输出速度的主张,并不让构建、工具循环或整个 Agent 运行等比加速。先建立 Pro 的质量与账单基线,再在生成时间主导延迟时比较 Highspeed。
用记录让替换决策可复核
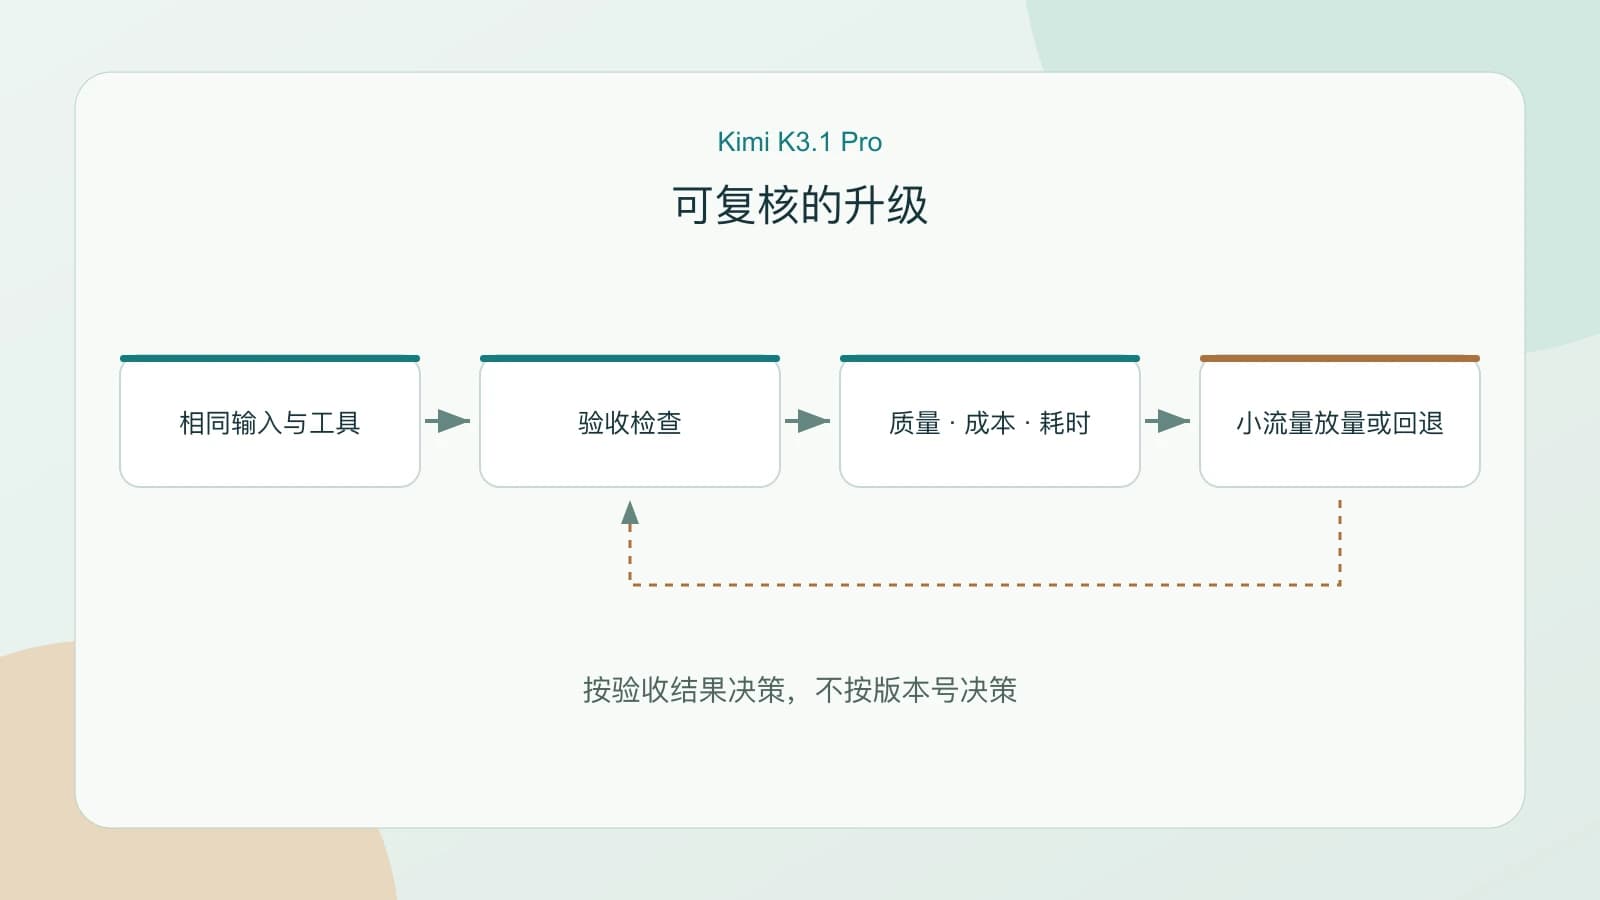
固定仓库提交或文档集、任务提示词、工具环境与验收测试,让两个模型分别处理相同输入。单次运行内保留完整助手与工具状态;切换模型或推理配置后,不要沿用旧会话再把结果称作受控比较。
| 记录 | 需要保存的内容 |
|---|---|
| 配置 | 精确模型、推理档位、输出预算、路由 |
| Usage | 普通输入、缓存读取、各 TTL 写入、计费输出、工具次数 |
| 质量 | 验收测试、引用准确性、制品检查与遗留缺陷 |
| 运行 | 首次响应、完整耗时、重试和失败 |
| 成本 | 实际账户费用、回退费用与审查投入 |
按返回 usage 区分缓存读取与各写入类别,不把写入再次计入普通输入。密钥、协议与图片上传契约要跟随所选服务;请求形状兼容不保证行为相同。
只放量已经通过的工作负载
先在不转移用户流量的情况下比较。查看结果前,确定质量底线、支出限制和延迟目标。替代方案达标后再迁移一小部分负载,同时保留旧配置供回退。观察真实流量的失败与账单后再扩量,不凭一次好看的回答全面切换。
例如,仓库任务虽然通过测试,却需要更多人工修补,应计入审查成本;长文档失败若源于提取阶段遗漏表格,应先修提取,再判断模型。这些反例有助于找到真正瓶颈。
FAQ
K3.1 Pro 一定比 K3 好吗?
不一定。首发证据支持评估,但替代方案必须满足你的工作负载质量、费用与延迟条件。
上下文变大了吗?
没有。两款列出的窗口都是 1,048,576 tokens,输入、推理与输出共享可用预算。
单价降低就一定省钱吗?
不一定。输出量、缓存计量、工具、重试与审查都会影响通过验收的单个结果总成本。本文算例明确固定了假设。
应该直接用 Highspeed 吗?
除非响应时限已使 Pro 不适用,否则先建立 Pro 基线,再用同任务与当前费率测 Highspeed。
应选哪个推理档位?
使用文档支持的设置,在自己的验收测试上比较。不能由另一配置的跑分推断 low/high/max 的质量。
可以原样沿用旧会话吗?
单次运行内保留必需工具状态;更换模型或推理设置时开启独立对照运行,并核对服务的会话要求。
什么时候应保留 K3?
当已验证路由满足目标,而替代方案尚未证明更低的单个验收结果总成本或更高的质量时。
本文是否包含 EvoLink 双模型实测?
不包含。本文结合有归因的首发证据、人工预算算例和评估流程,未填写的测试记录不是实测成绩。


