Claude Fable 5.2 veröffentlicht: Neuerungen für Code und Agenten
Was Fable 5.2 verbessert: Coding und Schlussfolgern, Hardware- und Spieledemos, 20 % niedrigere Tokenpreise sowie Effort und API-Migration.
 EvoLink TeamProduktteam
In diesem Artikel
Entscheidend ist, ob das Modell längere Projekte voranbringt: vorhandenen Code verstehen, Probleme zerlegen, Werkzeuge einsetzen, Ergebnisse prüfen und nach Fehlern umplanen. Eine ausführlichere Antwort und ein leichter lieferbares Projekt sind unterschiedliche Ergebnisse. Für Letzteres zählen auch Werkzeuge, Laufzeit, menschliche Korrekturen und die Gesamtrechnung.
Welche Rolle spielt Fable 5.2 in der Claude-Familie?
Fable ist für schwierige technische Aufgaben mit anhaltendem Denkaufwand gedacht. Anthropic empfiehlt, die meisten Aufgaben zunächst mit dem neuesten Opus-Modell zu bearbeiten und Fable 5.2 einzusetzen, wenn auch höhere Opus-Effort-Stufen in eigenen Tests die Anforderungen verfehlen.
Bei Stiländerungen, üblichen API-Endpunkten oder Dokumenten mit klaren Ordnungsregeln kann ein bereits zuverlässiges Modell wirtschaftlich bleiben. Komplexe Abhängigkeiten, konkurrierende Lösungswege und wiederholte Prüfungen bieten einem stärkeren Modell mehr Spielraum. Eine Migration verbindet etwa Datenstrukturen, Geschäftsverhalten, Bereitstellung und Leistungsgrenzen. Eine vermiedene Fehlentscheidung samt Nacharbeit kann mehr wert sein als ein günstigerer Einzelaufruf.
Mythos 5.2 basiert auf demselben Modell. Fable enthält Schutzmaßnahmen für Cybersicherheit und Biologie und ist dadurch breiter zugänglich; Mythos steht Organisationen nach Freigabe über Anthropics Verifizierungsprogramme offen. Ergebnisse in diesen Bereichen müssen der jeweils verwendeten Variante zugeordnet bleiben.
1 Million Token Kontext und 128K Ausgabe für längere Aufgaben
claude-fable-5-2. Unterstützt werden 1 Million Kontext-Token, maximal 128K Ausgabe-Token, Text- und Bildeingaben sowie Textausgaben. Adaptives Denken ist immer aktiv; die API verwendet standardmäßig high als Effort-Stufe.So passen Schnittstellendefinitionen, Implementierung, Tests und frühere Entwurfsentscheidungen in eine Repository-Aufgabe oder mehrere Berichte samt Datendefinitionen in eine Recherche. Die Zusammenstellung bleibt wichtig. Hilfreiche Eingaben legen fest:
- Das Ergebnis: lauffähiger Code, Migrationsplan oder vollständige Analyse.
- Verbindliche Grenzen: Schnittstellenkompatibilität, Datenkonsistenz oder Latenz.
- Prüfwerkzeuge: Tests, Typprüfung, Builds oder Skripte zur Datenvalidierung.
- Welche Entscheidungen das Modell treffen darf und welche Abwägungen ein Mensch klären muss.
Klare Ziele und ausführbare Prüfungen machen Fortschritt erkennbar. Das Kontextfenster schafft Arbeitsraum; die Aufgabenstruktur bestimmt seine Nutzung.
Fable 5.2 verbessert Programmierung, Schlussfolgern und Diagrammverständnis
Die von Anthropic veröffentlichten Ergebnisse decken mehrere Bereiche technischer Arbeit ab. Die Grafik vergleicht FrontierCode 2.0, FrontierSWE v2, Humanity's Last Exam mit Werkzeugen und Chartography ohne Werkzeuge.
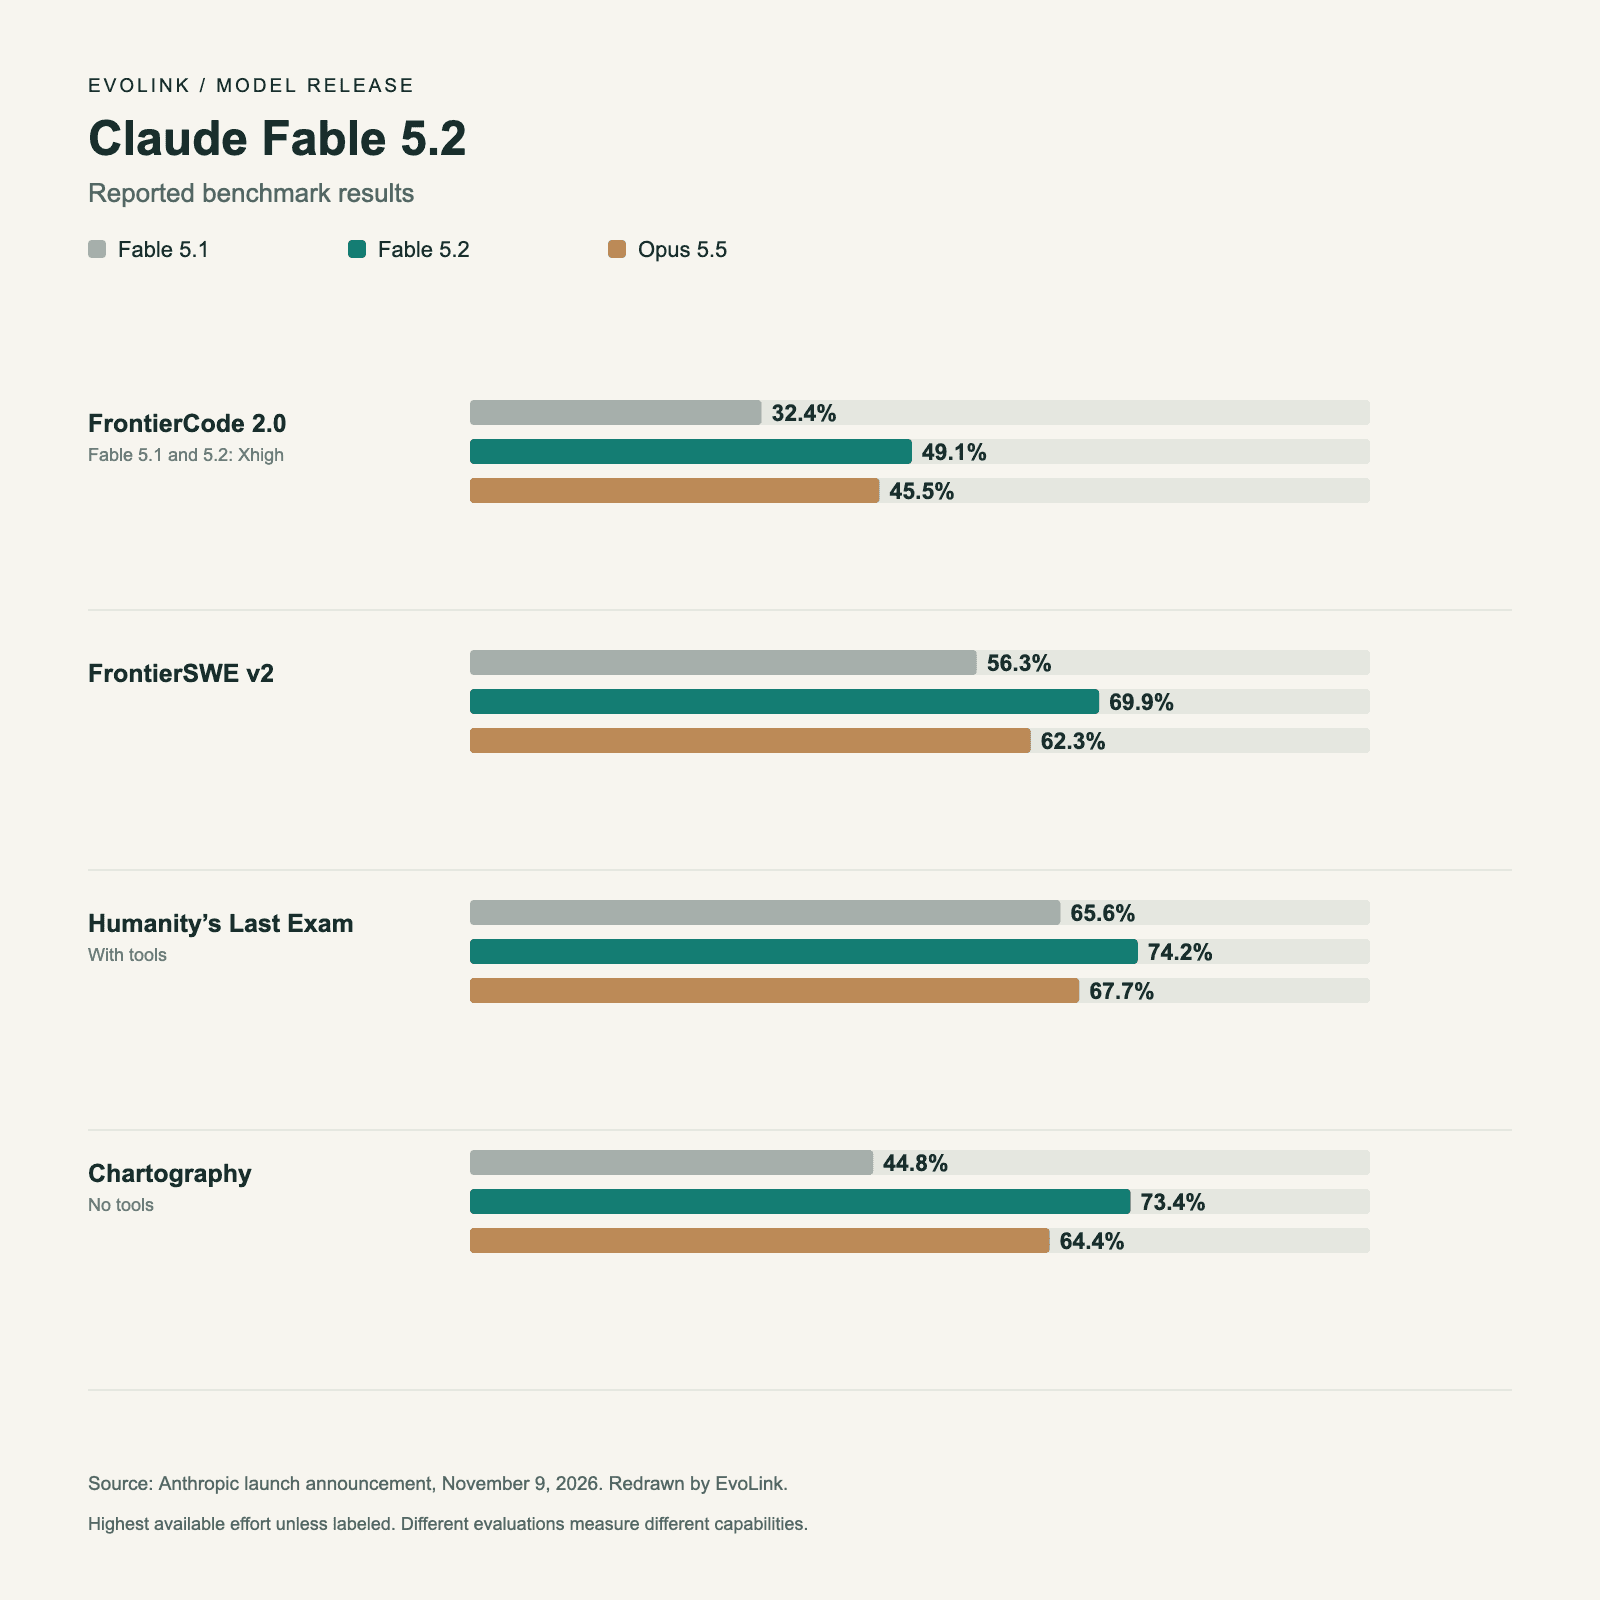
Programmierung, mehrstufige Analyse und das Lesen von Diagrammen treffen häufig zusammen. Entwickler können Leistungskurven und Fehlerprotokolle zur Engpasssuche übergeben; Forschende lesen ein Diagramm und prüfen eine Erklärung mit Code; Produktteams setzen visuelle Vorlagen als interaktive Oberfläche um.
Testen Sie mit den tatsächlichen Eingaben Ihres Teams. Gehören Screenshots, Diagramme und Code dazu, sollten alle drei vorkommen. Ein einzelner Textprompt kann relevante Unterschiede im Ablauf übersehen.
Hardware-Prototypen zeigen mehrstufige Entwicklungsarbeit
Anthropic und Diode ließen Fable 5.2 eine USB-Freisprecheinrichtung, einen Sprachassistenten-Hub für zu Hause und ein tragbares virtuelles Haustier entwerfen. Das Modell bearbeitete Spezifikationen, Schaltpläne, Bauteilplatzierung, Leiterplattenrouting, Gehäuse und Firmware. Diode-Ingenieure fertigten und testeten die Geräte. Laut Anthropic funktionierten alle drei ohne Schaltungskorrekturen.
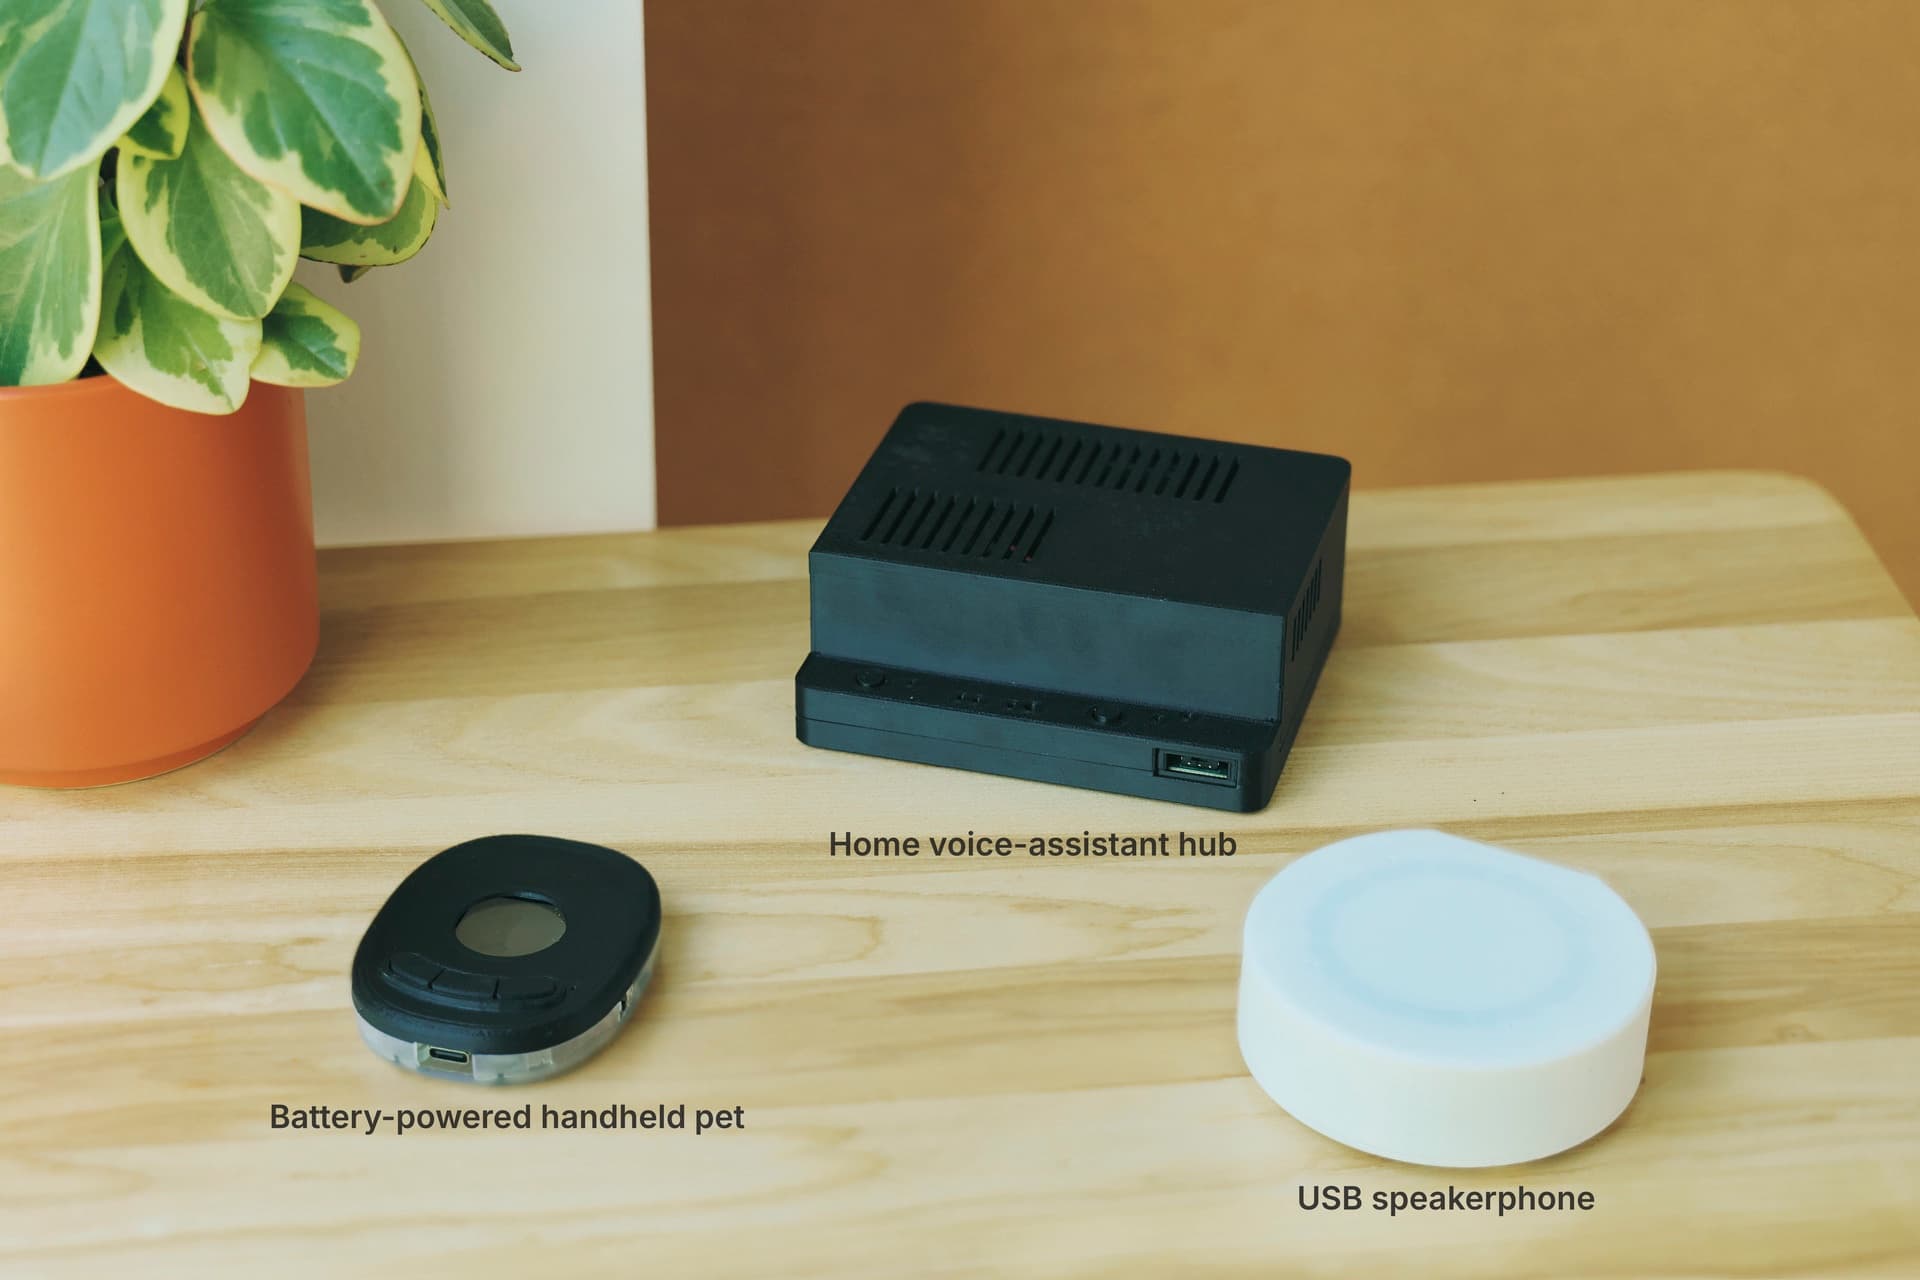
Bauteilpositionen beeinflussen Leiterbahnen, Anschlüsse die Gehäuseöffnungen und die Montage die Mechanik. Eine lokal plausible Entscheidung kann später Probleme auslösen. Der Fall zeigt den Wert kontinuierlich verfolgter Anforderungen und Folgewirkungen.
Es sind Prototypen. Elektrische Validierung, Antennenabstimmung, thermische Tests und Zertifizierung stehen noch aus; die Entwürfe sind nicht für die Serienfertigung bereit. Nach dem funktionierenden Prototyp folgt weitere Produktentwicklung. Softwareteams können ähnlich prüfen, ob das Modell neben lauffähigem Code auch Bereitstellung, Überwachung, Rollback und Wartung berücksichtigt hat.
Ein Experiment mit 1.000 Agenten untersucht langfristige Zusammenarbeit
Für Agentensysteme ist interessant, wie sie abhängige Aufgaben übernehmen, Fortschritt teilen, Ergebnisse einreichen und Beiträge zusammenführen. Gemeinsamer Aufgabenstatus und zuverlässige Prüfungen ermöglichen weiteres Arbeiten. Bei einer großen Migration benötigen Ausführungseinheiten gemeinsame Schnittstellen, Schutz vor doppelten Änderungen und einheitliche Tests. Rechercheteilaufgaben brauchen konsistente Datendefinitionen, damit die Analysen zusammenpassen.
Beginnen Sie mit unabhängig bearbeitbaren, eindeutig prüfbaren Teilaufgaben, bevor Sie die Agentenzahl erhöhen. Parallelität verursacht Koordinationskosten; sinnvolle Aufgabengrenzen sind ebenso wichtig wie die Anzahl der Agenten.
Spiele und interaktive Demos machen Fähigkeiten anschaulich
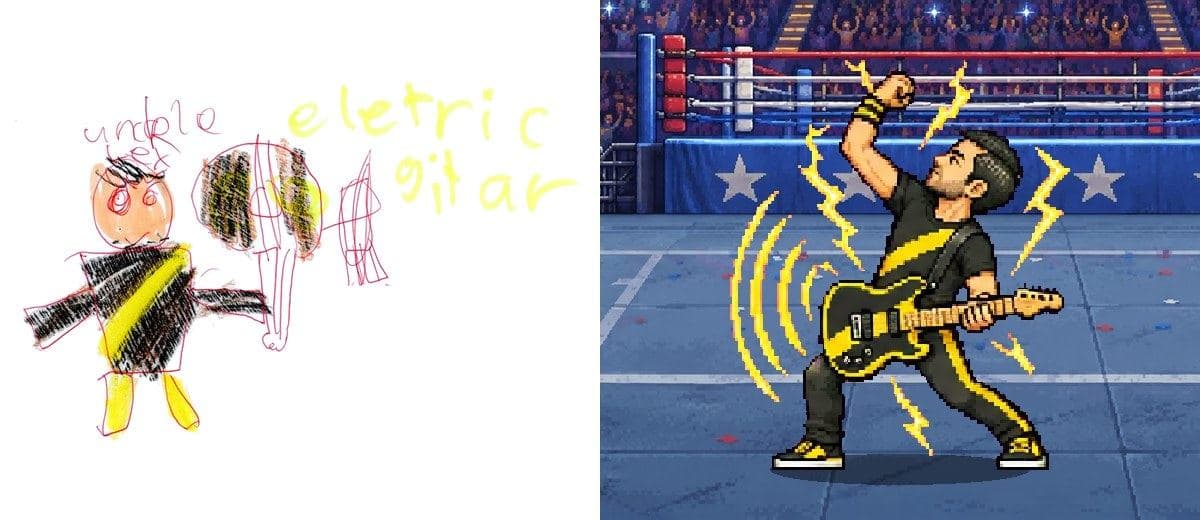
Interessant ist die fortlaufende Produktion: Figuren, Geschichte und Ziel werden zu Code, Aufrufen von Medienwerkzeugen und Tests. Teams für Lernwerkzeuge, interaktive Demos oder Markenerlebnisse könnten eine veränderbare Produkterklärung oder bedienbare Prozesssimulation erproben, um die Verständlichkeit einer Idee zu prüfen.
Bewerten Sie neben der Darstellung auch Rückmeldungen auf Eingaben, Stabilität und Änderbarkeit. Prototypen werden wiederholt überarbeitet; editierbarer Quellcode und klar geordnete Medien beeinflussen die Folgekosten.
Reguläre Tokenpreise sinken um 20 Prozent; Fast mode bietet mehr Tempo
Anthropics reguläre Preise liegen 20 % unter denen von Fable 5.1:
| USD je Million Token | Fable 5.1 regulär | Fable 5.2 regulär | Fable 5.2 Fast mode |
|---|---|---|---|
| Eingabe | $10 | $8 | $16 |
| Ausgabe | $50 | $40 | $80 |
Fast mode kann sich lohnen, wenn Wartezeit Kosten verursacht, etwa beim interaktiven Debugging. Prüfen Sie bei Hintergrundaufgaben in Warteschlangen, ob der Zeitgewinn den höheren Tarif rechtfertigt.
Cache und Gesamtkosten bleiben entscheidend
Ein Agent kann Projektkontext und Werkzeugdefinitionen mehrfach verwenden. Sind die Cache-Bedingungen erfüllt, werden diese Token anders als normale Eingaben berechnet. Die vielen Cache-Lesezugriffe im Spielprojekt zeigen ebenfalls, warum Tokenkategorien getrennt betrachtet werden sollten.
Erfassen Sie normale Eingaben, Cache-Schreiben, Cache-Lesen und Ausgaben separat. Beziehen Sie externe Werkzeugkosten und menschliche Nacharbeit in die Kosten eines akzeptierten Ergebnisses ein. Niedrigere Stückpreise verbessern die Ausgangslage; der tatsächliche Ablauf bestimmt die Ersparnis.
Effort gehört zur Modellauswahl
low, medium, high, xhigh und max; API-Standard ist high. Anthropic empfiehlt High als Einstieg, Xhigh nach gemessenem Nutzen bei schwierigen Aufgaben und Max für das Erkunden der Leistungsgrenze oder seltene Aufgaben mit nachrangigen Zeit- und Tokenkosten.Am 10. November 2026 abgefragte Ergebnisse von Artificial Analysis:
| Konfiguration | Intelligence Index | Gewichtete Evaluationskosten je Aufgabe |
|---|---|---|
| Medium | 56 | $3.80 |
| High | 62 | $9.08 |
| Max | 65 | $26.54 |
Die Konfigurationen tragen die Kennzeichnung Default Fallback. Kosten und Aufgaben entsprechen der AA-Evaluation und sind keine Preisangebote für übliche Nutzeraufgaben. Von High zu Max steigt in dieser Momentaufnahme der Wert, zugleich nehmen die Evaluationskosten deutlich zu.
Halten Sie Eingaben, Werkzeuge und Abnahmekriterien konstant, während Sie Effort verändern. Ermitteln Sie die erste ausreichende Stufe und prüfen Sie, ob mehr Budget das tatsächliche Ergebnis verbessert. Routinemäßige Informationsordnung und eine Migration mit komplexen Abhängigkeiten können unterschiedliche Einstellungen brauchen.
Beim Upgrade auch ältere Prompts prüfen
Anthropics Prompting-Leitfaden weist darauf hin, dass dauerhafte Aufforderungen zu mehr Subagenten unnötige Delegation auslösen können. Große Tokenbudgets im Prompt beeinflussen möglicherweise den Verbrauch: In manchen Coding-Tests sank nach ihrer Entfernung der Preis bei ähnlicher Leistung. Das betrifft Budgets als Prompttext und nicht die Task-Budgets-Funktion der API.
Prüfen Sie, ob jede Aufgabe Parallelität, sämtliche Alternativen oder angesammelte doppelte Regeln braucht. Klare Abschlusskriterien erleichtern die Bewertung. Bewahren Sie den ursprünglichen Prompt auf und testen Sie Änderungen einzeln anhand von Qualität, Kosten und Ausführung, um Modell- und Workfloweffekte auseinanderzuhalten.
Was beim Produktionseinsatz zu prüfen ist
Offizielle Zugänge sind Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry und Claude Platform on AWS. Modell-IDs, Funktionen und Abrechnung hängen vom Kanal ab und müssen in dessen Dokumentation geprüft werden.
Für vorhandene Integrationen sind vier Änderungen relevant:
- Gesprächsverlauf: Änderungen an Systemprompt, Werkzeugen oder früheren Nachrichten können zurückgesendete Denkblöcke ungültig machen. Die Präfixprüfung gilt für alle Konten. Ein ungültiger Block führt bei nicht gesetztem
prefix_mismatch_behaviorzu Fehler 400. - Modellwechsel: Beim Wechsel von Fable 5.2 zu Opus 5.5 in der Claude API entfallen Fables Denkblöcke; die Anfrage kann trotzdem erfolgreich sein.
- Computer use: Das ältere Werkzeug
computer_20251124muss außer bei Amazon Bedrock auf das neue Werkzeugset umgestellt werden. - Advisor: Ein Fable-5.2-Executor braucht einen kompatiblen Advisor mit Fable 5.2 oder Mythos 5.2.
Bei einem einheitlichen API-Gateway sind Parameterweitergabe, Abrechnung und Verlaufsbehandlung beim Modellwechsel in langen Gesprächen zu prüfen. Sie beeinflussen den produktiven Ablauf unmittelbar.
Welche Teams sollten Fable 5.2 zuerst evaluieren?
Fable-5.1-Nutzer können mit Aufgaben beginnen, zu denen Qualitäts- und Kostenaufzeichnungen vorliegen, und Abschlussrate, Korrekturen und Ausgaben vergleichen. Opus-Nutzer sollten wiederkehrende Problemfälle wählen: Code, der trotz mehrerer Korrekturen Tests verfehlt, oder Pläne, die verknüpfte Anforderungen wiederholt nicht erfüllen.
Teams mit Agentenprodukten können Fable für Planung, schwierige Analysen und kritische Prüfung evaluieren und klar definierte Ausführungsschritte günstigeren Modellen zuweisen. Messen Sie Informationsübergaben und Gesamtkosten, bevor Sie diese Arbeitsteilung übernehmen.
Ein sinnvoller Anfang sind eine Routineaufgabe, ein bekannt schwieriges Problem und ein längeres Projekt. Vergleichen Sie Ergebnisqualität, Dauer, Gesamtausgaben und menschliche Änderungen. Daraus lassen sich Standardmodell, Eskalationsregel und Effort-Stufen ableiten. Fable 5.2 erweitert die Leistungsgrenze bei niedrigeren regulären Tokenpreisen; vertraute Aufgaben zeigen, wo daraus verlässliche und bezahlbare Ergebnisse entstehen.
Häufige Fragen
Wann erschien Claude Fable 5.2 und was ändert sich gegenüber 5.1?
Sollte ich nach der Veröffentlichung von Fable 5.2 Opus 5.5 ersetzen?
Was unterscheidet Fable 5.2 von Mythos 5.2?
Wie wirkt sich die Preissenkung um 20 % gegenüber Fable 5.1 auf die Aufgabenkosten aus?
Kann Fable 5.2 direkt Bilder oder Videos erzeugen?
Was bedeuten 1 Million Kontext-Token und 128K Ausgabe für längere Aufgaben?
Welche Zugangswege nennt die Veröffentlichung von Fable 5.2?
claude-fable-5-2. Weitere offizielle Kanäle sind Amazon Bedrock, Google Cloud, Microsoft Foundry und Claude Platform on AWS. Prüfen Sie Kennungen, Funktionen und Abrechnung des jeweiligen Kanals. Für EvoLink zeigt die Fable-5.2-Modellseite aktuelle Integrationshinweise und Preise; Parameter und Verlaufsbehandlung müssen auch bei Drittanbieterrouten auf Kompatibilität geprüft werden. VerfügbarkeitMit welcher Effort-Stufe sollte ich anfangen?
high; verfügbar sind low, medium, high, xhigh und max. Beginnen Sie mit High und vergleichen Sie andere Stufen mit identischen Eingaben, Werkzeugen und Abnahmekriterien. Versuchen Sie Xhigh nach gemessenem Nutzen bei schwierigen Aufgaben; Max eignet sich, wenn das Erkunden der Leistungsgrenze zusätzliche Zeit und Token rechtfertigt. Effort-EmpfehlungenWarum kann ein bestehendes Gespräch nach dem Upgrade Fehler 400 liefern?
prefix_mismatch_behavior erneut gesendet, folgt Fehler 400. Prüfen Sie bei der Migration Denkverlauf und dokumentiertes Verhalten bei Präfixabweichungen. Davon zu unterscheiden ist der Wechsel von Fable 5.2 zu Opus 5.5 in der Claude API: Denkblöcke entfallen, obwohl die Anfrage erfolgreich sein kann. Migrationsänderungen