Gemini 4 Hydrogen 正式发布:功能变化与采用指南
Gemini 4 Hydrogen 已在 EvoLink 上线可用。了解多模态输入、思考控制与共享上下文怎样用于编程、文档和工具工作流。
 EvoLink Team产品团队
文章目录
gemini-4-hydrogen 列为正式可用(GA)模型。对于通过 EvoLink 选型的团队,接下来有价值的问题是:哪个应用任务值得进行一次受控评估,而不是仅凭新型号名称就替换现有路由。这次发布实际确认了什么
正式发布改变了事实依据。此前的文章讨论的是 Flash 档代号和盲测中的模型踪迹;现在,Google 带有日期的开发者文档确立了公开型号。应使用文档中的 ID,而不是推测出来的 Arena 别名。“Gemini 4 Flash”可以解释读者最初如何听说这个模型,但不能据此编造请求标识符,也不能推断模型架构。
| 问题 | 上游已确认事实 | 对应用的影响 |
|---|---|---|
| 能读取什么? | Google 模型页列出文本、图像、音频、视频和 PDF | 先定义输出约定,再分别评估每种输入类型 |
| 返回什么? | 文本,并支持结构化输出和函数调用 | 仍须校验数据;应用负责授权与执行自己的函数工具 |
| 上下文预算是多少? | 输入、思考和输出共享 1,048,576 Token | 填充上下文前,先给回答预留空间 |
| 能回答多长? | 每段同步响应的思考与回答合计最多 65,536 Token,长解码可扩展整个工作流 | 将长文本生成设计为可恢复的工作流 |
| 如何控制思考? | 上游文档列出 low、medium、high、xhigh,默认 high | 显式设置路由支持的档位,并测量完整费用 |
| 如何处理缓存? | 隐式缓存,不支持显式创建缓存 | 重新检查旧版显式缓存集成 |
xhigh,本身不能证明网关也支持该参数。仅限原生 API 的文件格式和长输出处理,也应按所选协议核对。Gemini 4 Hydrogen 的功能怎样改变工作流
能力只有改变了可验收的任务,才有实际意义。“支持图像”不等于已经有完整的文档处理规则,“能调用函数”也不是 Agent 的任务完成指标。先选择一个有边界的任务,明确输出约定,并设计拒绝“看似合理、实际错误”响应的方法。
文档理解:把证据转成经过校验的记录
以供应商入驻系统读取多页产品规格书为例。任务可以是抽取允许的工作温度、认证,以及每个值对应的来源页。要求返回来源引用,并明确如何表示缺失值;不要让模型用常识补齐不完整的表格。
验收约定需要三层检查。第一,响应符合 schema。第二,每个值都与所给文档一致,包括单位和限定条件。第三,应用能处理缺失与冲突:无法辨认的表格转复核,区分“未说明”与“不支持”,拒绝指向错误页码的引用。语法合法的记录,仍可能在后两层验收中失败。
这适合作为首次评估,因为字段错误可以逐项检查。样本应包括扫描页、相互冲突的版本和缺失字段,不只测试整洁示例。记录合格记录数、人工复核比例和所有尝试的计费用量。更大的上下文窗口可能允许纳入更多证据,但不保证模型能正确解决版本冲突。
编程:评估可用改动,而不是好看的演示
为编程助手选择一个行为可观察的小型仓库任务,例如修复分页问题并保留筛选,或为现有端点补充幂等处理。记录起始代码版本、测试命令、允许改动的文件与约束。在沙箱中运行生成的改动,依赖版本与基线保持一致。
任务通过的条件是:目标行为可用,相关测试通过,改动没有越界。界面再漂亮,丢失键盘操作支持也应判失败;补丁再像正确答案,删除了校验逻辑同样不能通过。记录从开始到得到可供审查结果的时间,计入安装、测试失败和修正轮次;仅计算响应生成时间,会漏掉用户等待的一大部分。
不要把代码生成的动画理解为原生视频生成。Hydrogen 文档列出的输出是文本。代码可以创建交互或视觉作品,但仍需要执行和检查。
工具工作流:要求动作确实完成且得到授权
客服 Agent 可以读取订单、查询物流状态,再拟定客户回复。评估时应检查:是否选择允许的工具、提供有效标识符、正确解释工具返回状态,并在信息缺失时停止。对于自己的函数工具,由应用而不是模型检查权限,并执行有副作用的操作。Google 搜索等提供方托管的工具,有各自的执行与计费约定。
保留所用协议要求的对话历史与思考签名。测试集中应包括工具超时和授权拒绝。查询失败后,模型不能编造物流进展,也不能盲目重试写入。分别记录完成任务和安全转交处理的情况:正确拒绝,可能比自信地宣称虚假完成更有价值。
| 工作流 | 需要保留的证据 | 应阻止自动验收的失败 |
|---|---|---|
| 产品文档抽取 | 来源页、单位、schema 和参考值 | 无依据的值、版本冲突或无法辨认的证据 |
| 仓库改动 | 起始版本、补丁、测试输出和审查标准 | 回归、改动越界或执行失败 |
| 订单状态 Agent | 工具参数、授权结果和工具响应 | 未授权操作、编造状态或工具循环未完成 |
共享上下文怎样改变长任务预算
用一个容量计算例子说明:在 1,048,576 Token 窗口内,800,000 个输入 Token 最多给思考和输出合计留下 248,576 Token。如果输入估算未包括系统指令、工具定义或其他计数材料,这些内容还会进一步占用空间。这只是算术,不是观察到的模型响应,也不是建议采用的提示词长度。
启用长输出前,先回答运维问题:部分输出存在哪里,断线后怎么办,怎样避免同一片段被重复追加,以及哪些情况下部分文档应判为不可用。实现中应处理结束原因、累计用量和任务级截止时间。百万 Token 上限并没有消除这些要求。
思考档位是工作负载控制项,不是质量保证
xhigh,意味着多了一个可评估的设置。它并没有确立所有应用的新默认值,也不能证明网关已经开放该选项。Google 建议将更高档位留给困难任务,同时提醒 Token 消耗与延迟会增加。请先核对所选路由支持哪些控制项。文档抽取比较字段准确率和无依据值的比例;编程比较测试结果与修正轮次;工具任务比较已完成操作和失败处理是否安全。调整思考档位时,保持这些验收标准不变。保留某个设置,应是因为它对任务有帮助,而不是因为名称听起来更强。
比较时显式设置配置。否则,模型默认值的差异可能被误认成代际变化。输出上限也包含思考:请求可能在输出足够的可见回答之前,就已经用完预算。同时记录配置预算与返回用量,才能区分回答截断和知识不足。
可用性取决于你指的是哪个渠道
| 渠道,核对日期 11 月 12 日 | 当前证据支持什么 | 使用前需要核对什么 |
|---|---|---|
| Google Gemini API | 官方正式发布,已有文档化模型 ID | 项目资格、配额、条款和支持的 API 接口 |
| Google AI Studio | 官方迁移指南列出访问入口 | 账户实际权限与使用条件 |
| Gemini 消费者应用 | 用户报告属于特定账户的观察 | 当前账户、地区和功能可用性 |
| Antigravity 桌面产品 | 可见的模型选择器是另一项产品信号 | 实际返回型号和账户权限 |
| Google 托管的 Antigravity Agent | 官方更新日志将 Hydrogen 列为其默认模型 | 托管 Agent 的使用约定;不能推及所有 Antigravity 产品 |
| EvoLink | Hydrogen 已可通过统一 API 使用 | 当前账户费率、所选协议与支持的控制项 |
这张表用于避免两种常见误判。消费者订阅不等于 API 计费协议;上游功能发布,也不证明网关已实现每个新参数。EvoLink 的价值是提供一致的接入点,便于比较和选择受支持路由,而不是消除不同渠道的控制项与限制。
估算完整任务,而不只算首次响应
规划应用成本时,应汇总所有尝试的未缓存输入、缓存读取、计费输出与工具费用。如果测量人工修正成本,单独列出。将对应总费用除以合格任务数,并同时报告失败率,避免一条路由因为拒绝困难任务而显得成本特别低。
做一次有明确边界的首次评估
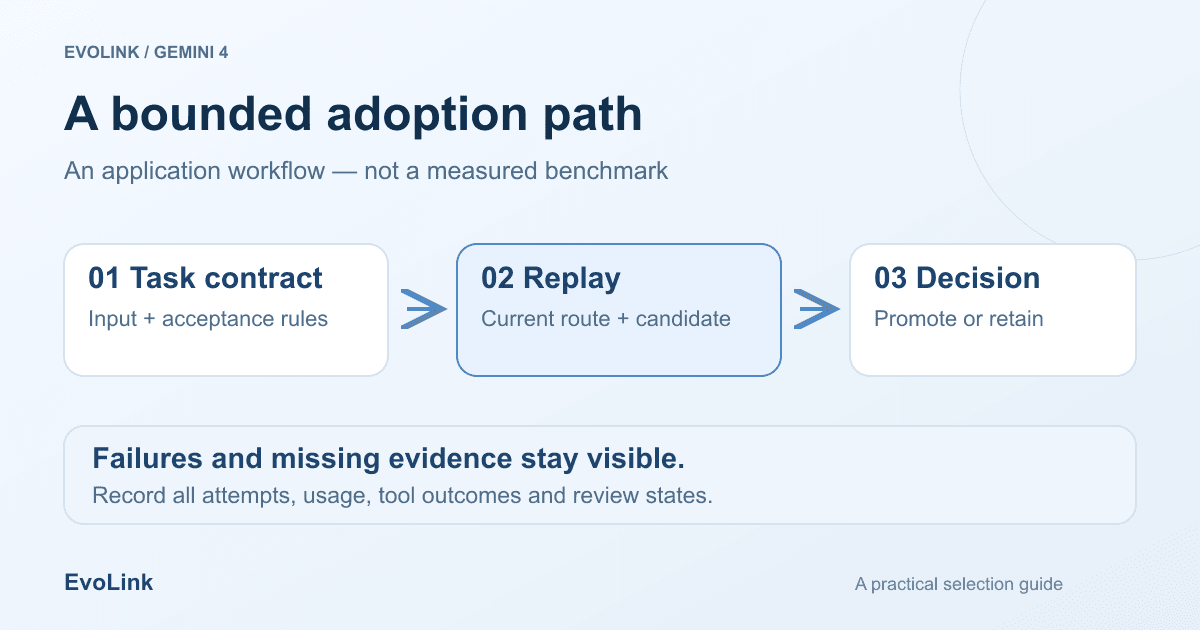
先选一个能解释失败原因的工作负载。一份实用的评估材料应包括输入、验收规则、当前基线输出、失败类别、工具测试数据和预算。敏感来源材料继续遵循已批准的数据处理规则;新模型发布,不是改变这些规则的理由。
分别用当前模型与 Hydrogen 候选配置回放该工作负载。纳入常规样本与已知失败,记录每次尝试的配置,并按书面标准评分。检查两者的分歧:总分更高,仍可能掩盖某个规模小但业务价值高的任务类别发生了严重回归。
只让达到要求的任务类别进入下一阶段。少量生产流量也应配好备用路由、错误预算,以及能够停用候选配置的负责人。其他流量继续留在正常工作的路由。这些是应用发布建议,不代表 EvoLink 会自动替你执行评估或回退。
常见问题
Gemini 4 Hydrogen 什么时候发布?
Google Gemini API 更新日志记录的正式可用日期是 2026 年 11 月 12 日。访问权限与商业条款仍取决于实际使用的产品和账户。
Hydrogen 就是传闻中的 Gemini 4 Flash 吗?
Flash 是理解早期搜索与报道的历史称呼,但现在应使用公开名称 Gemini 4 Hydrogen 及文档中的标识符。社区别名不能证明模型架构、另一个可调用 ID,或早期盲测的真实型号。
所有 Gemini 产品都会自动开放吗?
不能根据一条更新日志得出这个结论。Google API、AI Studio、消费者应用、托管 Agent、IDE 产品和网关都需要分别核对访问权限。
它能生成图像、音频或视频吗?
Google 列出的是多模态输入与文本输出。理解媒体,或生成可渲染动画的代码,与原生图像、音频、视频生成不同。
是否应该始终使用 xhigh 思考?
只有路由支持该档位,而且任务实测结果值得付出额外时间与 Token 时,才考虑使用。当前 EvoLink 集成所记录的设置,必须独立于上游公告核对。
一个普通请求能返回百万 Token 的回答吗?
不要把长解码上限当作单次响应保证。输入与思考共享窗口,长输出需要相关 API 支持的续写或后台机制。
应该立刻替换 3.8 Flash 或 Argon 吗?
先保留可用路由,直到有代表性的评估证明值得切换。两篇对比指南回答不同问题:升级现有基线,以及在模型之间分配任务。
EvoLink 用户应该从哪里开始?
打开已上线的 Hydrogen 模型页,核对当前账户费率,选定输入和验收约定,再使用受支持协议完成一次有边界的首次任务。
来源与证据边界
- Google Gemini API 更新日志:发布日期与上游生命周期。
- Google Hydrogen 模型规格:模态、上下文与能力基线。
- Google Hydrogen 变化与迁移指南:思考与长解码设计。
- Google Standard 价格表:上游商业参考,核对日期为 2026 年 11 月 12 日。
- EvoLink 原生 API 文档:网关协议依据。
文中的工作流示例是建议采用的验收约定,不是已发布的 Hydrogen 跑分、账户级可用性测试或实测应用节省数据。