
Precio de la API de Kimi K3.1 Pro: tokens, caché y ejemplos de costes
Compara las tarifas de Kimi K3.1 Pro y Highspeed: entrada, salida, escritura de caché, razonamiento y ejemplos por solicitud y para el presupuesto mensual.
 EvoLink Team
En este artículo
El coste de una solicitud depende de la entrada, la salida, la actividad de caché y las herramientas utilizadas. Esta guía desglosa esos cargos y muestra cómo estimar el coste de una solicitud o de miles de llamadas mensuales.
¿Cuánto cuesta la API de Kimi K3.1 Pro en EvoLink?
| Concepto facturado | K3.1 Pro Standard | K3.1 Pro Highspeed |
|---|---|---|
| Entrada normal | $2.00 | $4.00 |
| Salida | $10.00 | $20.00 |
| Lectura de caché | $0.20 | $0.20 |
| Escritura de caché: 5 minutos | $2.00 | $4.00 |
| Escritura de caché: 1 hora | $4.00 | $8.00 |
Los cargos de entrada se dividen en tres categorías:
- Entrada normal: contenido facturado a la tarifa habitual de entrada.
- Lecturas de caché: contenido reutilizado correctamente desde una caché existente.
- Escrituras de caché: contenido almacenado en la caché y facturado según su periodo de validez.
¿Cuánto cuesta una solicitud a la API?
Kimi K3.1 Pro cobra según los tokens utilizados, sin una tarifa fija por solicitud. Una pregunta corta, un documento extenso y una solicitud que reutiliza contexto en caché pueden generar facturas muy diferentes.
Estos tres ejemplos utilizan las tarifas anteriores:
| Uso por solicitud | Coste Standard | Coste Highspeed | Standard: 1.000 solicitudes |
|---|---|---|---|
| 2.000 tokens de entrada normal + 1.000 de salida | $0.014 | $0.028 | $14 |
| 100.000 tokens de entrada normal + 10.000 de salida | $0.30 | $0.60 | $300 |
| 100.000 tokens leídos de caché + 1.000 de entrada normal + 2.000 de salida | $0.042 | $0.064 | $42 |
Solicitud pequeña: 0,014 dólares en Standard
Una solicitud con 2.000 tokens de entrada normal que genera 1.000 tokens de salida cuesta:
Regular input: 2,000 ÷ 1,000,000 × $2  = $0.004
Output:        1,000 ÷ 1,000,000 × $10 = $0.010

Total: $0.014Solicitud más grande: 0,30 dólares en Standard
Una solicitud con 100.000 tokens de entrada normal que genera 10.000 tokens de salida cuesta:
Regular input: 100,000 ÷ 1,000,000 × $2  = $0.20
Output:         10,000 ÷ 1,000,000 × $10 = $0.10

Total: $0.30Para elaborar un presupuesto mensual, agrupa las solicitudes según su consumo habitual, calcula el coste de cada grupo y multiplícalo por el número previsto de llamadas.
¿Highspeed duplica el coste?
Las tarifas de entrada normal, salida y escritura de caché de Highspeed duplican las de Standard. La tarifa de lectura de caché no cambia.
Si una solicitud solo contiene entrada normal y salida, el mismo consumo duplica el coste por tokens:
100,000 regular input + 10,000 output tokens

Standard:  $0.30
Highspeed: $0.60
Si predominan las lecturas de caché, la diferencia es menor:
100,000 cached input + 1,000 regular input + 2,000 output tokens

Standard:  $0.042
Highspeed: $0.064Estos cálculos mantienen constante el uso de tokens para mostrar el efecto de las tarifas. En llamadas reales, calcula cada factura a partir del consumo que informe la API.
Precio de la caché: primera escritura y lecturas posteriores
La tarifa de lectura de caché de Standard es una décima parte de la tarifa de entrada normal, pero crear la caché genera un cargo de escritura independiente.
Considera una solicitud Standard con:
- un prefijo reutilizable de 100.000 tokens que se escribe por primera vez en una caché de cinco minutos;
- otros 1.000 tokens de entrada normal;
- 2.000 tokens de salida facturables.
La primera solicitud cuesta:
Cache write:   100,000 ÷ 1,000,000 × $2  = $0.200
Regular input:   1,000 ÷ 1,000,000 × $2  = $0.002
Output:          2,000 ÷ 1,000,000 × $10 = $0.020

First request total: $0.222
Cuando una solicitud posterior reutiliza correctamente esos 100.000 tokens en caché, el coste pasa a ser:
Cache read:    100,000 ÷ 1,000,000 × $0.20 = $0.020
Regular input:   1,000 ÷ 1,000,000 × $2    = $0.002
Output:          2,000 ÷ 1,000,000 × $10   = $0.020

Subsequent request total: $0.042
Si a la primera escritura le siguen nueve solicitudes que aciertan en la caché:
Total for ten requests
= $0.222 + 9 × $0.042
= $0.60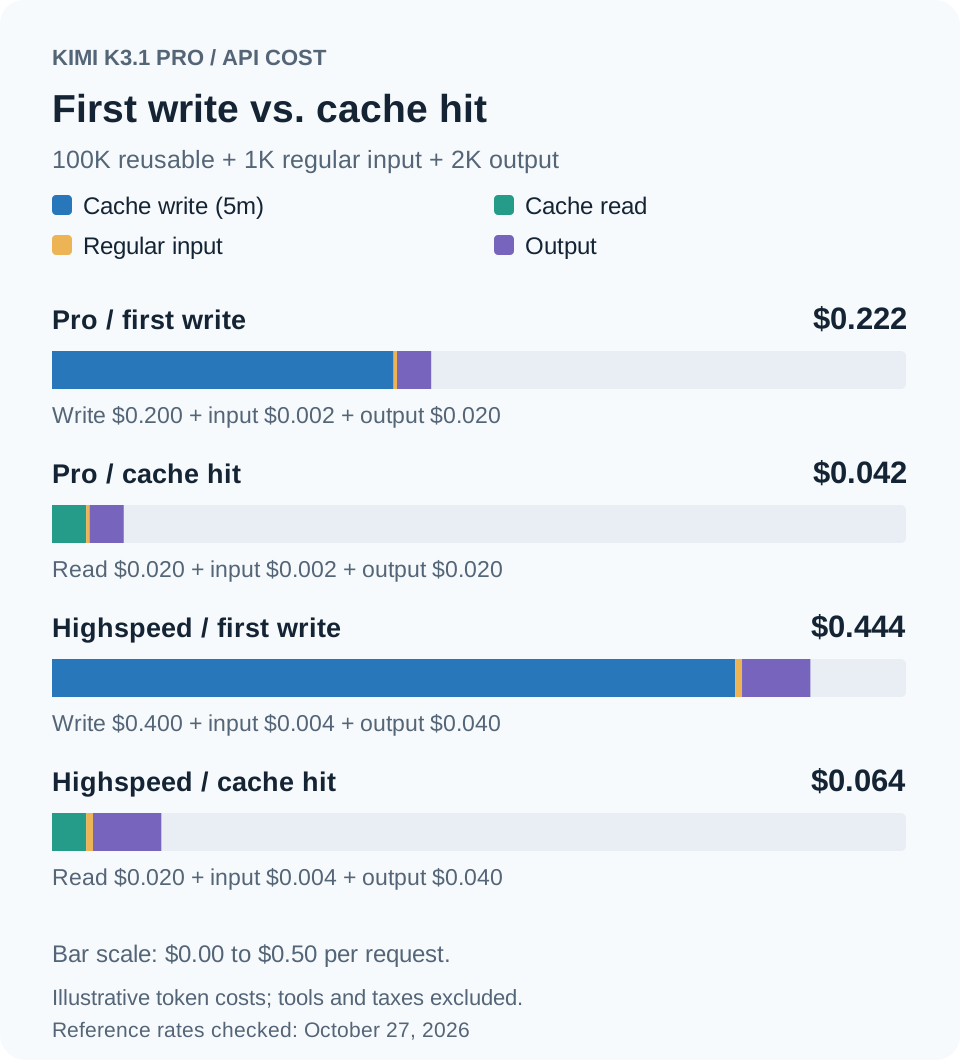
Caché de cinco minutos o de una hora: diferencias de precio
Las tarifas de escritura de Standard son:
- Cinco minutos: 2 dólares por millón de tokens.
- Una hora: 4 dólares por millón de tokens.
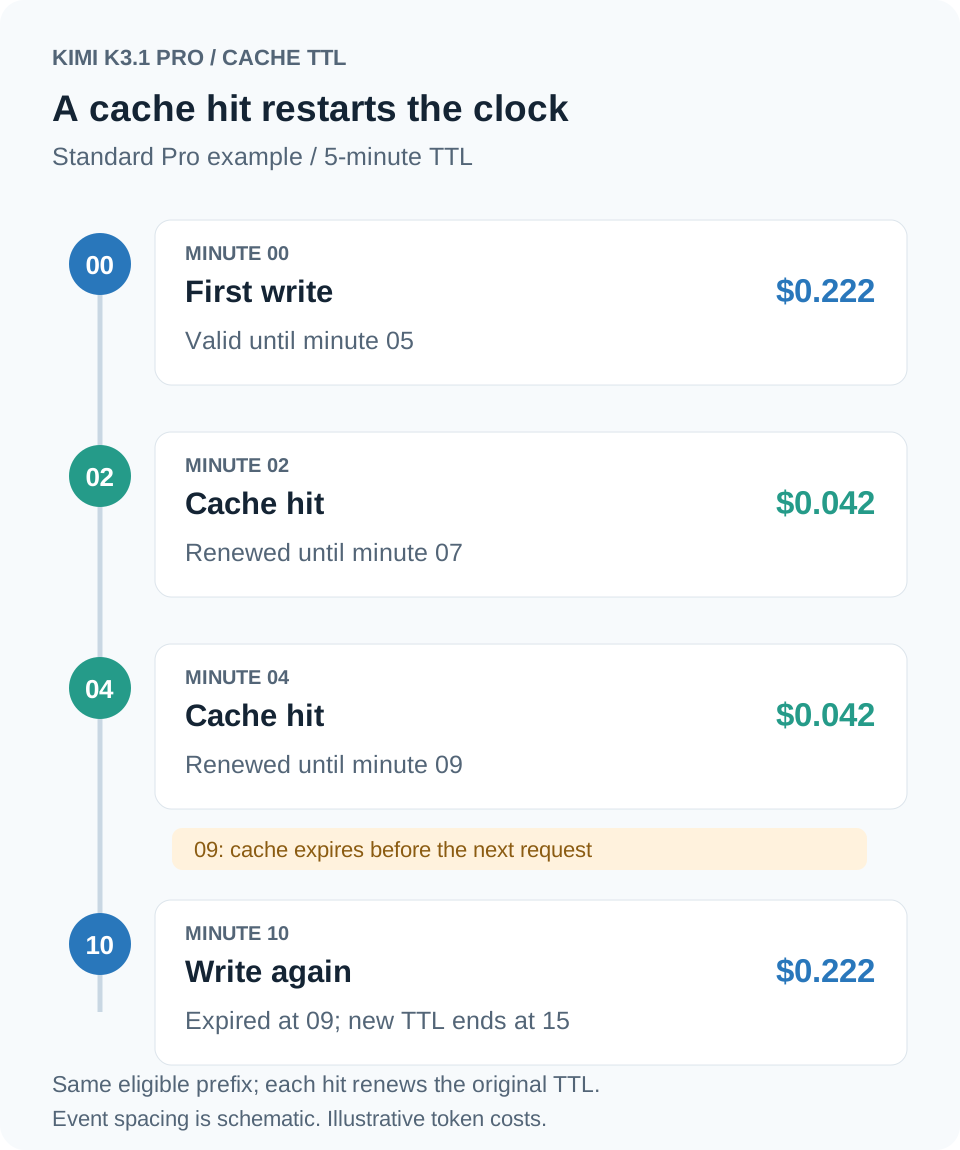
Tanto el número de solicitudes como el intervalo entre ellas afectan a los costes recurrentes. Diez solicitudes que reutilizan correctamente la caché pueden costar una cantidad distinta de diez solicitudes que llegan repetidamente después de que caduque.
¿Cómo se cobran los tokens de razonamiento?
Por ejemplo, una solicitud informa de 10.000 tokens de salida facturables en total, compuestos por:
- 9.000 tokens de razonamiento;
- 1.000 tokens de respuesta final.
El cargo de salida de Standard es:
10,000 ÷ 1,000,000 × $10 = $0.10Los tokens de razonamiento ya están incluidos en el total de salida. No los sumes una segunda vez. Utiliza el total de salida facturable que informe la API para calcular el cargo.
Cargos por herramientas y cobro mínimo
Tres búsquedas facturables añaden:
3 × $0.005 = $0.015Suma los cargos por herramientas a los cargos por tokens del modelo. Los resultados de búsqueda incluidos en una solicitud posterior también pueden aumentar el consumo de entrada.
Calcula el coste de tokens con código
Este ejemplo de JavaScript utiliza las tarifas de referencia de Standard. Sustituye los recuentos de tokens por tu consumo para calcular el coste correspondiente.
// Standard Pro reference rates checked on October 27, 2026.
// Input categories must not overlap.
const tokens = {
  regularInput: 1_000,
  cachedInput: 100_000,
  cacheWrite5m: 0,
  cacheWrite1h: 0,
  output: 2_000, // Includes billed reasoning tokens.
};

const ratePerMillion = {
  regularInput: 2,
  cachedInput: 0.2,
  cacheWrite5m: 2,
  cacheWrite1h: 4,
  output: 10,
};

const tokenCost = Object.entries(tokens).reduce(
  (total, [category, count]) =>
    total + (count * ratePerMillion[category]) / 1_000_000,
  0
);

console.log(`Estimated token cost: $${tokenCost.toFixed(6)}`);
// Estimated token cost: $0.042000ratePerMillion cuando cambien las tarifas de tu cuenta.Preguntas frecuentes
¿Cuánto cuesta Kimi K3.1 Pro por token?
Con las tarifas base de Standard:
- Entrada normal: 0,000002 dólares por token.
- Salida: 0,00001 dólares por token.
- Lectura de caché: 0,0000002 dólares por token.
Son tarifas específicas para cada categoría. El precio de una solicitud depende de cuántos tokens se facturen en cada una.
Si leer la caché cuesta un 90 % menos, ¿toda la solicitud cuesta un 90 % menos?
No. Esa reducción del 90 % compara la tarifa de lectura de caché de Standard con su tarifa de entrada normal. La salida, las escrituras de caché y las herramientas pueden seguir contribuyendo al coste total.
¿Por qué aparecen precios distintos en diferentes sitios?
Comprueba el nombre exacto del modelo, la variante Standard o Highspeed, el proveedor, la moneda, la unidad de facturación y la fecha de actualización. Los precios públicos, los descuentos de la cuenta y los precios medios ponderados también son conceptos diferentes.


