
Análisis de Kimi K3.1 Pro: programación, 3D e investigación
Análisis de Kimi K3.1 Pro: reparación de código, Blender y CAD, análisis de datos y latencia, con pruebas públicas y ejemplos de tareas.
 EvoLink Team
En este artículo
Las pruebas públicas de Kimi K3.1 Pro muestran reparaciones de código e investigaciones de datos resueltas, junto con carencias en la validación del navegador y un error al agrupar datos. Los ejemplos 3D oficiales de Moonshot AI amplían esa imagen: el modelo puede utilizar Blender y herramientas CAD para crear escenas y objetos estructurados.
Las preguntas prácticas son cómo funcionan esos resultados, qué conviene revisar y cuánto tarda el modelo en llegar a una respuesta final. Artificial Analysis, Atomic Agent, PacBench y Plotly aportan resultados concretos para examinar junto con los ejemplos oficiales de Moonshot AI.
Análisis de Kimi K3.1 Pro: programación, agentes y razonamiento
La evaluación de lanzamiento de Artificial Analysis, publicada el 23 de octubre de 2026, abarca tareas de terminal, flujos SaaS, trabajo del conocimiento y preguntas de razonamiento difíciles:
| Evaluación | Resultado de K3.1 Pro | Qué examina |
|---|---|---|
| Terminal-Bench 4.0 | 67% | Programación y operaciones en un entorno de terminal |
| AutomationBench-AA | 73% | Agentes que ejecutan flujos de trabajo SaaS |
| GDPval-AA | 1.846 Elo | Rendimiento relativo de entregables de trabajo del conocimiento |
| Humanity’s Last Exam | 52% | Preguntas difíciles de conocimiento y razonamiento |
Las cuatro evaluaciones cubren trabajos diferentes. Las tareas de terminal y SaaS piden al agente actuar en un entorno, mientras que las de trabajo del conocimiento examinan el entregable. Las preguntas difíciles añaden otra dimensión: alcanzar una respuesta correcta cuando el razonamiento es exigente. Un buen resultado en una categoría puede coexistir con una debilidad en otra parte del flujo.
Para un desarrollador, esta distinción explica por qué un benchmark de programación y una aplicación generada pueden dar impresiones distintas. Resolver una tarea de un repositorio implica leer archivos, hacer cambios, ejecutar comprobaciones e interpretar fallos. Entregar una aplicación interactiva añade controles, renderizado y el comportamiento que encuentra el usuario después de iniciarla. Los siguientes ejemplos permiten ver esas diferencias.
Programación: reparación de código y tareas largas
Low y max en una reparación de Python
Atomic Agent probó un paquete Python con cinco errores introducidos deliberadamente y dos funciones pendientes: una función de liquidación y una herramienta de línea de comandos. El agente recibió una instrucción breve: leer el archivo de la tarea, completar el trabajo y ejecutar las pruebas hasta superarlas. Las ejecuciones utilizaron Atomic Agent v0.6.9 con la misma tarea y las mismas herramientas.
Cada nivel de razonamiento se ejecutó tres veces, con 32 aserciones ocultas por ejecución. Esas comprobaciones estaban separadas de las pruebas que el agente podía consultar mientras trabajaba. Ambos niveles superaron todas las aserciones:
| Configuración | Aserciones superadas en tres ejecuciones | Tiempo medio | Llamadas al modelo de media |
|---|---|---|---|
| Low | 96/96 | 2,2 minutos | 19 |
| Max | 96/96 | 4,9 minutos | 28 |
Para esta tarea, low fue la opción más eficiente. Calculado a partir de las medias publicadas, max tardó unas 2,2 veces más y realizó aproximadamente un 47% más de llamadas al modelo, con el mismo resultado de aprobación.
En una reparación, lo útil es comparar el parche terminado. ¿Corrige el comportamiento solicitado, mantiene la interfaz pública y evita cambios ajenos a la tarea? Un nivel superior de razonamiento se justifica cuando mejora esos resultados. Una explicación más larga o más llamadas a herramientas describen la ejecución; por sí solas no hacen que el parche sea mejor.
Cambiar el diagnóstico durante una tarea larga
El simulador se construyó sobre el modelo anatómico human-atlas, con 296 componentes esqueléticos y 402 musculares. Moonshot describe cómo el modelo utilizó pruebas de dinámica en lazo abierto para investigar el movimiento de los brazos antes de cambiar los cálculos y volver a entrenar el controlador.
Ese orden importa en un sistema acoplado. Un controlador puede entrenarse contra una simulación incorrecta, igual que una aplicación puede ajustarse alrededor de una dependencia defectuosa o una preparación de pruebas errónea. Mejorar repetidamente el bucle exterior puede dejar intacto el defecto de fondo. Aquí el modelo pasó del objetivo de entrenamiento al simulador que definía el entorno de entrenamiento.
En una tarea larga de programación, avanzar también puede significar cambiar de diagnóstico: leer una dependencia, comprobar una hipótesis numérica o revisar la explicación inicial tras un nuevo resultado. El entregable debe conservar suficientes rastros —archivos modificados, comandos de prueba y resultados medidos— para que otro desarrollador pueda continuar el trabajo.
Un juego generado y su carencia de validación
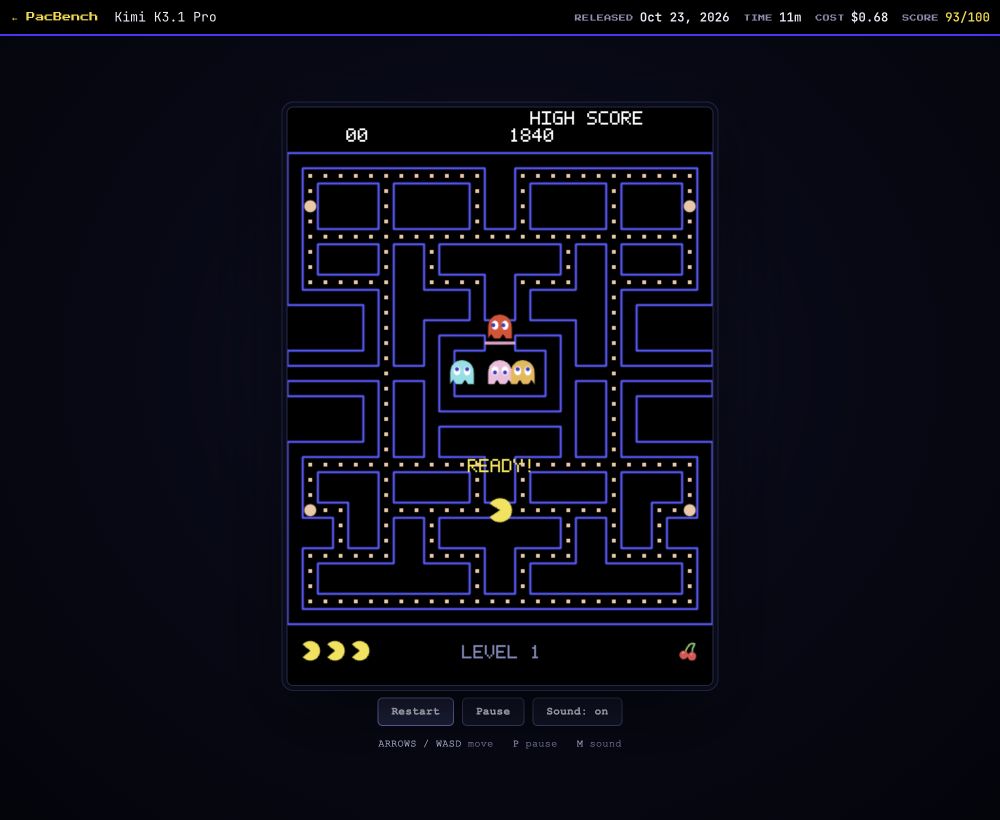
La entrada de K3.1 Pro en PacBench utilizó high, incluyó 17 respuestas del modelo y tardó unos 11,5 minutos. El Pac-Man generado se puede jugar públicamente, junto con su registro de ejecución.
El evaluador también registró lo que funcionaba: un laberinto clásico de 28×31, los 244 puntos accesibles y ningún movimiento bloqueado con las tasas de fotogramas probadas. Esto hace que los defectos restantes sean más informativos que una etiqueta de «funciona» o «no funciona».
Quedaba pendiente validar en el navegador. El sustituto en Node podía ejercitar las transiciones del juego, pero el foco del teclado y el audio de las pestañas en segundo plano son comportamientos del navegador. Para un entregable interactivo, comprobar la condición de victoria y comprobar la experiencia de jugar son dos partes distintas del trabajo.
Modelado 3D: Blender, CAD y revisión de los archivos
Qué reconstruye el benchmark CAD
La métrica es Voxel IoU: el solapamiento geométrico entre la forma generada y la de referencia en el espacio de vóxeles. Mide similitud de forma, no el porcentaje de recursos listos para producción. La tarea se aproxima más a recuperar la estructura de un objeto que a producir una imagen convincente del mismo.
De una forma visible a un recurso editable
Para un recurso concreto, revise tres niveles:
| Nivel | Qué revisar |
|---|---|
| Forma global | Silueta, proporciones y disposición espacial |
| Estructura local | Conexiones, oclusiones, simetría y detalle |
| Uso práctico | Archivos fuente, dimensiones, topología y resultados de exportación |
Lista de revisión de recursos: elaborada para este artículo.
En un objeto mecánico, conviene comprobar si las piezas conectadas se encuentran donde deben y si un cambio de dimensión conserva su relación. En una escena arquitectónica, revise los componentes repetidos, las aberturas y la disposición de los espacios. Estas comprobaciones revelan intersecciones y conexiones ausentes que una sola vista puede ocultar.
También importa el formato de entrega. Una vista previa permite revisar el aspecto; los archivos editables permiten continuar los cambios; una exportación permite usar el resultado en otra herramienta. Pedir el formato previsto desde el principio ayuda a distinguir una buena presentación de un recurso con el que otra persona pueda seguir trabajando.
Análisis de datos: el 42/43 de Plotly y un error de agrupación
El modelo superó 42, incluidas las cinco preguntas de patrones ocultos y las tres de calidad de datos.
Detectar problemas que la pregunta no menciona
En los casos de calidad de datos, Plotly indica que K3.1 Pro identificó filas duplicadas y la ausencia del último día del mes, además de distinguir turbinas retiradas sin datos de turbinas cuya producción era cero. Son estados diferentes, aunque una agregación simple pueda hacerlos parecer iguales.
Las preguntas de patrones ocultos añaden otro trabajo: investigar relaciones sin que se indique exactamente qué encontrar. Esto hace que el resultado sea relevante para el análisis exploratorio, donde la siguiente consulta depende de lo que haya revelado la anterior.
Cómo un pequeño error de agrupación cambia la respuesta
Esto cambia la población comparada. «No tener este firmware» y «tener otro firmware» describen grupos distintos cuando algunos registros no tienen ninguno. Incluir los registros de ese estado ausente modifica la referencia antes de aplicar cualquier prueba estadística.
El método analítico puede parecer cuidadoso cuando la pregunta ya ha cambiado. Una revisión útil empieza por la población: qué registros entran en cada grupo, cuáles se excluyen y qué significa un valor ausente en esos datos. Después se examina el cálculo y se comprueba que el texto describe los filtros realmente utilizados. El cálculo solo responde a la pregunta prevista si los grupos coinciden con su definición de negocio.
Entregables financieros y de investigación
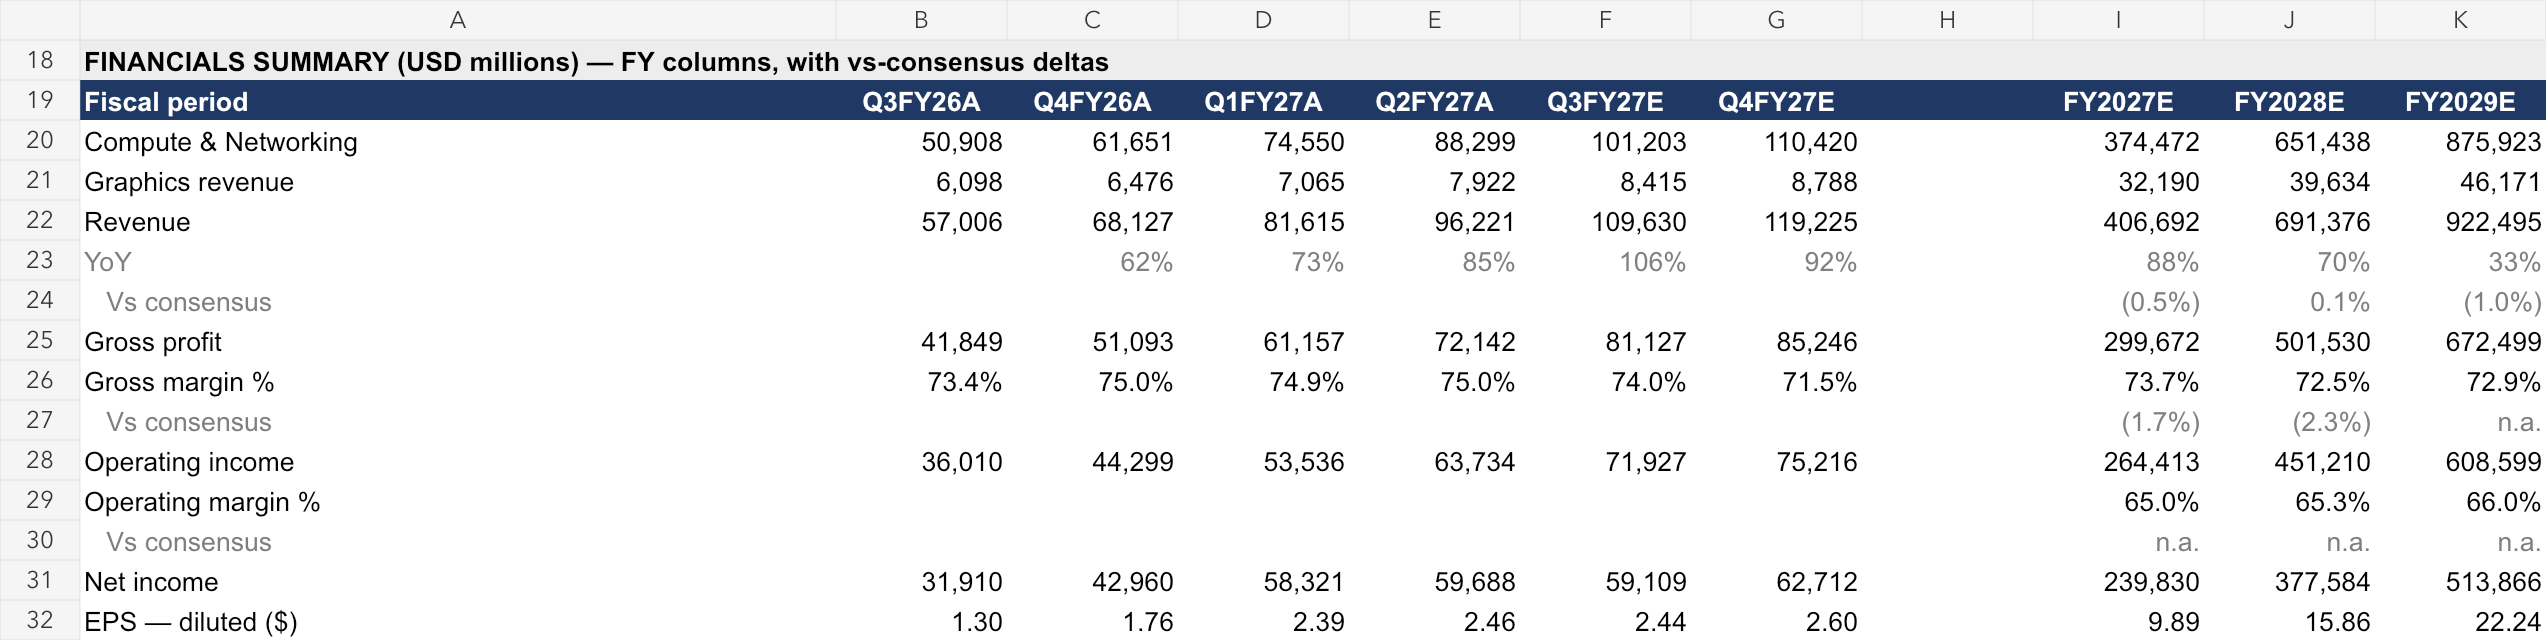
La captura de NVDA presenta columnas trimestrales y anuales junto con ingresos, beneficio, márgenes y beneficio diluido por acción. Como página de resumen financiero, su utilidad depende de la claridad con la que se puedan conectar esas cifras principales con las hipótesis y hojas que las sustentan.
En un libro de modelado, siga una previsión desde una hipótesis, pasando por las referencias de fórmulas, hasta el resumen. Compruebe que los periodos fiscales coinciden y que cambiar una hipótesis actualiza las salidas esperadas. En un informe o presentación, siga las afirmaciones importantes hasta sus fuentes y compruebe que gráficos y conclusiones escritas usan el mismo periodo y la misma definición.
Estos archivos también muestran que entregar una investigación es más que generar una respuesta larga. Un libro tiene dependencias numéricas; unas diapositivas necesitan una secuencia clara de argumentos; un informe necesita respaldo rastreable para sus conclusiones. La aportación del modelo incluye organizar esas relaciones en un formato que otra persona pueda revisar y modificar.
Comprensión de imágenes y vídeo: comprobaciones prácticas
- En gráficos, verificar juntos los valores, las unidades y las definiciones estadísticas.
- En tareas espaciales, comprobar las posiciones y relaciones entre objetos.
- En vídeo, probar el orden de las acciones y los cambios de estado entre fotogramas.
Un gráfico ilustra la diferencia entre leer e interpretar. Extraer dos valores es solo el principio si una serie utiliza otra unidad, otro periodo o una población distinta. Una respuesta útil debe mantener cada valor unido a su eje, leyenda y explicación correspondientes.
content multimodal como un array de partes del mensaje, con imágenes en base64 o referencias a archivos subidos. La guía explica el procesamiento de vídeo mediante fotogramas clave: su número y resolución afectan al volumen de entrada. Los detalles están en la guía de entradas visuales.Para vídeo, elija ejemplos cuya respuesta dependa de la secuencia y no de un único fotograma: qué cambió antes de un fallo o qué acción precedió a otra. Las pruebas públicas examinadas aquí se centran en programación y datos; una aplicación visual necesita ejemplos propios de los acontecimientos y detalles que debe reconocer.
Latencia de razonamiento: esperar la respuesta final
El 24 de octubre de 2026, AIHubMix probó un prompt que pedía explicar una tabla hash con código Python y ejecutó Pro estándar tres veces en low. La espera medida cambió mucho entre el primer token de razonamiento y el primer token de respuesta final:
Espera hasta el primer token de razonamiento y de respuesta final
Pro estándar · un prompt · nivel low · tres ejecuciones
- Primer token de razonamiento
- 3,6–4,5 s
- Primer token de respuesta final
- 71–91 s
Segundos desde el inicio de la solicitud
El razonamiento representó alrededor del 85%–90% de los tokens de finalización en esas ejecuciones, y una alcanzó el límite de 8.192 tokens de finalización. Una interfaz que solo muestre respuestas finales puede parecer inactiva mientras el modelo ya está transmitiendo razonamiento.
Progreso del flujo y respuesta utilizable
Tres tiempos describen partes distintas de la experiencia: cuándo comienza el flujo, cuándo empieza el texto de respuesta final y cuándo termina la respuesta. Una conexión que funciona puede dejar al usuario esperando una respuesta útil. Por eso, un primer token rápido no describe toda la espera.
En una aplicación interactiva, mida los tres tiempos con los prompts reales de los usuarios. Registre también el nivel de razonamiento y el límite de finalización para distinguir una respuesta rápida pero truncada de una respuesta completa. En tareas en segundo plano, la calidad y duración total pueden importar más que la rapidez con la que aparece texto.
reasoning_content para los incrementos de razonamiento y content para los de la respuesta final. La aplicación puede distinguir el estado del procesamiento de la respuesta que presenta o analiza. En flujos de herramientas de varios turnos, la guía de inicio también exige conservar el mensaje assistant completo y los resultados de herramientas correspondientes, en vez de guardar solo el texto final.Esto conecta la medición del tiempo con el comportamiento del agente. La aplicación gestiona una tarea en curso, con solicitudes de herramientas, observaciones devueltas y la respuesta final. El nivel de razonamiento es uno de los controles de ese proceso; la validación y la gestión de mensajes siguen determinando si el trabajo se entrega correctamente.
Para qué tareas encaja Kimi K3.1 Pro
Los casos sugieren prioridades distintas para cada carga de trabajo:
| Capacidad | Qué respaldan las pruebas | Límites pendientes |
|---|---|---|
| Programación y tareas largas | Reparaciones completadas y depuración sostenida | La fiabilidad en proyectos mayores debe validarse en el entorno objetivo |
| 3D y razonamiento espacial | Construcción de escenas y objetos mediante herramientas | El solapamiento de formas no demuestra la topología ni la calidad de exportación |
| Análisis de datos e investigación | Buenos resultados en la prueba especializada de Plotly | Las reglas de agrupación y las hipótesis todavía pueden fallar |
| Comprensión visual | Soporte oficial de imágenes y vídeo | Estas pruebas no establecen la precisión en tareas visuales especializadas |
| Razonamiento y ejecución | Uso considerable de razonamiento y herramientas | El esfuerzo extra puede añadir latencia sin mejorar el resultado medido |
Resumen de las fuentes examinadas anteriormente.
Empiece con una reparación de código o un análisis que pueda evaluar. En una reparación, conserve el caso fallido original y revise el diff resultante. En un análisis, mantenga algunas respuestas conocidas e incluya estados ausentes o excepcionales. Para un entregable 3D, acuerde los formatos fuente y de exportación antes de revisar la vista previa.
Compare la calidad final, el tiempo de ejecución, las llamadas a herramientas y el uso de tokens antes de ampliar a trabajos menos estructurados. La comparación low/max de Atomic, la carencia de validación en navegador de PacBench y el error de agrupación de Plotly ofrecen controles concretos que incorporar. Juntos conectan la evaluación con el trabajo que realmente hará el modelo.
Preguntas frecuentes
¿Puede Kimi K3.1 Pro crear modelos 3D editables?
¿Conviene usar low o max para programar?
Compárelos primero con tareas representativas. En el experimento Python de Atomic Agent, ambos superaron las mismas aserciones; low promedió 2,2 minutos y 19 llamadas, frente a 4,9 minutos y 28 llamadas de max. Aumente el nivel si mejora los parches o la tasa de aprobación lo suficiente para justificar el tiempo y consumo extra.
¿Por qué Kimi K3.1 Pro transmite datos sin dar una respuesta final?
¿El 42/43 de Plotly permite usar directamente las conclusiones?
Es un buen resultado sobre el conjunto sintético de datos eólicos de Plotly. La pregunta fallida sobre firmware muestra por qué sigue siendo importante revisar la población y las reglas de agrupación. En otros datos, compruebe valores ausentes, periodos, fórmulas y fuentes antes de utilizar las conclusiones.


