Gemini 4 Neon 对比 Claude Opus 5.5:编程能力、成本与切换指南
结合相同编辑器和各自原生 Agent 工具的公开评测,对比 Gemini 4 Neon 与 Claude Opus 5.5,拆解公开跑分差异背后的原因,并用「单个合格补丁的真实成本」判断是否值得切换。
 EvoLink Team产品团队
文章目录
high 跑一轮;团队已经磨合稳定的核心仓库工作流,则继续保留 Claude Opus 5.5 作为基线。 Neon 在多文件编程评测中表现很有竞争力,标准输入与输出单价也更低。但是否真正值得切换,最终还要看补丁一次通过率、人工评审耗时,以及新配置能否无缝承接团队依赖的工具链。参考 CursorBench 4.1 · Google API 定价 · Anthropic 定价。在真实编程环境中对比 Neon 与 Opus 5.5
| 当前开发环境 | 推荐测试方法 | 重点观察指标 |
|---|---|---|
| 同一编辑器同时支持两款模型 | 固定编辑器、工具集与评审流程,只切换底层模型 | 合格补丁数量、总调用费用与人工介入频率 |
| 团队主力工具是 Claude Code | 将「Claude Code + Opus」与「Antigravity + Neon」作为两套完整环境对照 | 仓库指令、权限边界与任务交接能否照常运转 |
| 自研应用通过 API 调用模型 | 下发同一项任务、同一组授权工具和验收规则 | 工具调用准确率、补丁有效性及失败后的恢复能力 |
| 当前配置承担低频高风险迁移 | 让 Neon 回放历史迁移任务,或在独立分支试跑 | 兼容性检查通过率与人工返工量 |
两份主流编程评测分别测了什么
xhigh 搭配 Antigravity CLI 拿到 59 分,单任务成本 $6.86;Opus 5.5 max 搭配 Claude Code 拿到 58 分,单任务成本 $12.61。分数经过取整,反映的是各自「模型 + 原生工具」组合的整体表现(详见 Artificial Analysis 评测)。而 CursorBench 4.1 则提供了同一编辑器环境下的横向对照: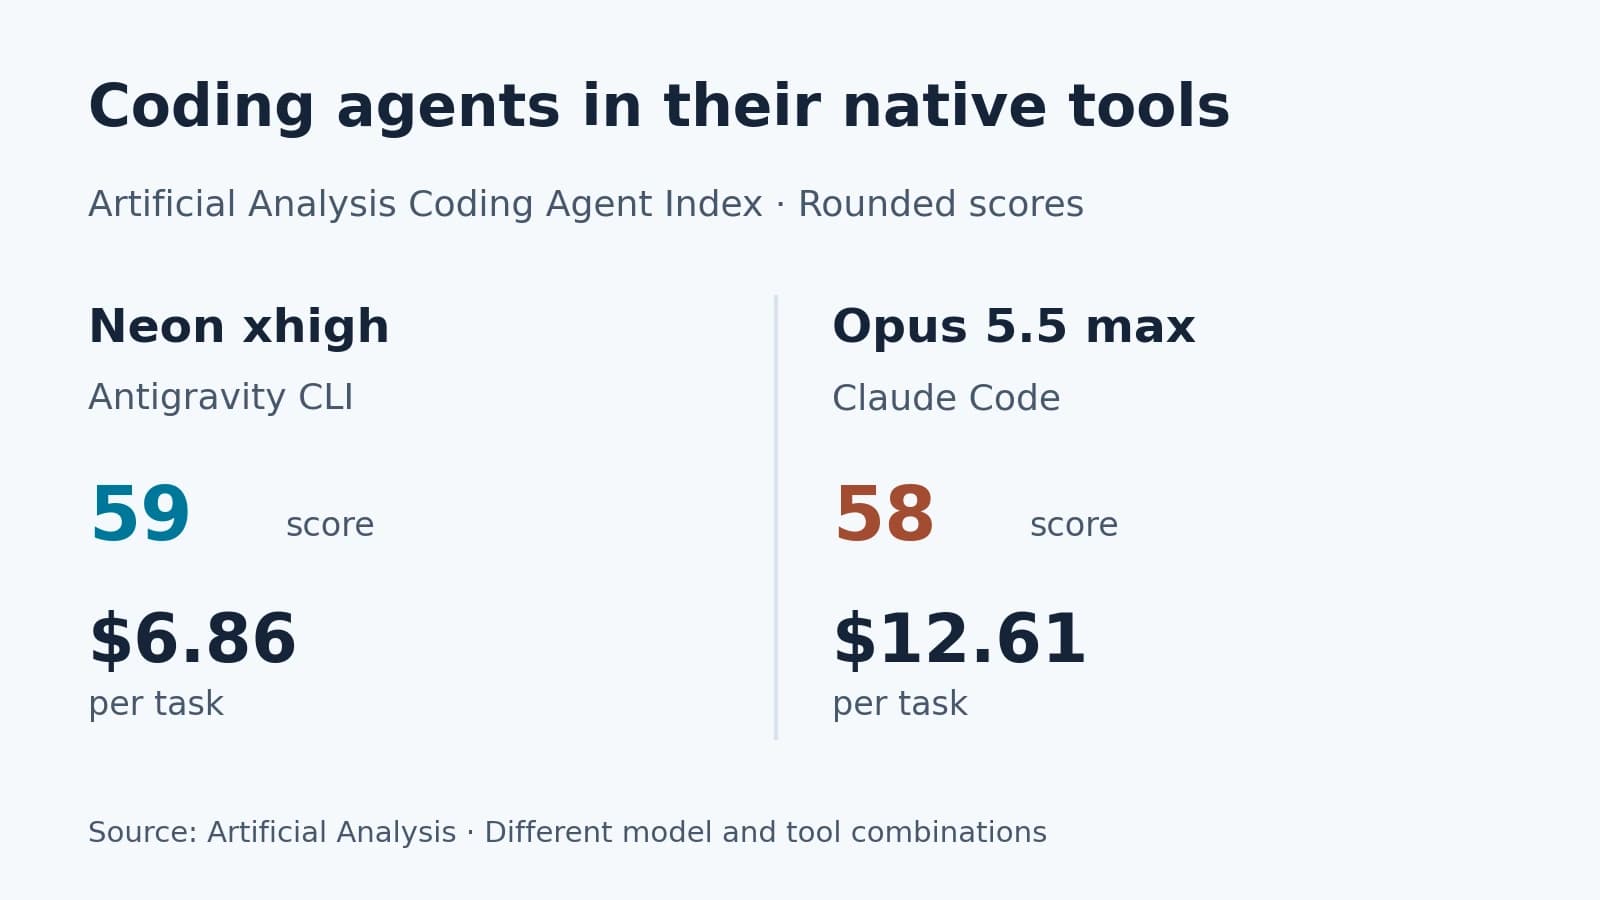
| CursorBench 4.1 配置 | 得分 | 评测所列单任务成本 |
|---|---|---|
Neon medium | 57.7% | $3.07 |
Opus 5.5 high | 54.5% | $3.87 |
Neon high | 63.7% | $6.54 |
Opus 5.5 xhigh | 56.7% | $6.54 |
Neon xhigh | 65.4% | $10.67 |
Opus 5.5 max | 58.1% | $11.88 |
high 是一个性价比很扎实的起点。不过在 Google 公布的另一批评测中,Opus 在 Terminal-Bench 4.1 和 FrontierCode 2.0 上依然略占上风。如果团队日常工作偏重复杂终端调试,或对代码改动的可合并标准要求极高,建议把这类真实工单也放进回放集。公开基准适合用来缩小候选范围,最终要不要切流,还是要看自家仓库的验收结果。以上 CursorBench 数据核对于 2026 年 11 月 19 日。参考 CursorBench · Google DeepMind 评测。Agent 框架对跑分的影响有多大
| SWE-sweep 配置 | Neon | Opus 5.5 |
|---|---|---|
| 各用自家 Agent 框架 | 39.0% | 10.1% |
| 统一使用 mini-SWE 框架 | 12.8% | 3.6% |

可以看到,换掉外层框架后,两款模型的绝对分数和彼此差距都发生了明显变化。Google 提到,Antigravity CLI 支持通过子 Agent 并行检索仓库,这尤其适用于 SWE-sweep 这类仓库缺陷定位任务。因此,如果你的目标只是给现有 Agent 换底层模型,尽量在同一个框架里做对照;如果是打算整体更换 IDE,就需要把整套工具链拉在一起评估,固定权限与操作边界,同时把团队熟悉新工具和评审代码的时间成本算进去。
按「单个合格补丁」核算真实成本
以 100 个编程任务为例,假设各路由的总费用均已包含失败尝试及重试的开销:
| 路由方案 | API 总费用 | 合格补丁数 | 单个合格补丁的 API 成本 |
|---|---|---|---|
| Neon | $45 | 75 | $0.60 |
| Opus 5.5 | $60 | 90 | $0.67 |
| Neon(合格率下降) | $45 | 65 | $0.69 |
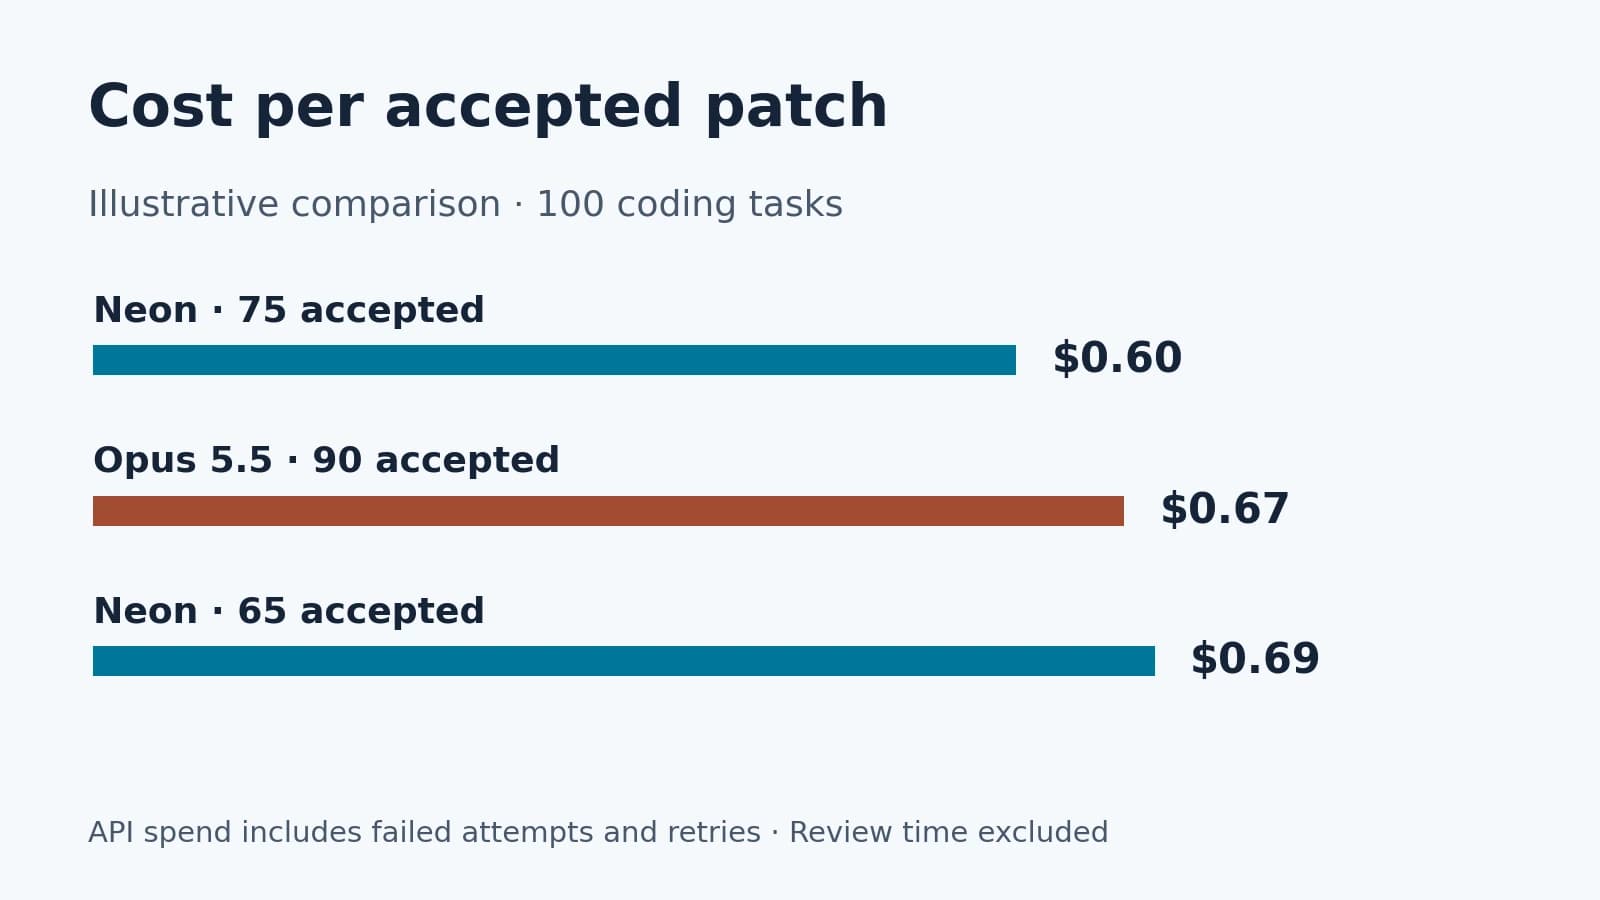
同样是 $45 的 API 账单,一旦合格率往下掉,单个合格补丁的实际成本反而比 Opus 5.5 更高。如果工程师还得手动返工,记得把人工评审的分钟数和 API 费用放在一起算总账——在涉及共享接口的改动里,漏掉一条兼容性约束带来的返工代价,往往远超 Token 账单本身。
跨供应商切换前,先核对接入差异
high,而 Opus 5.5 的自适应思考默认档位是 medium。测试时建议同时覆盖线上默认配置与显式指定的档位——即便两家厂商使用了相同的档位名称,背后对应的实际推理深度也未必一致。参考 Google 开发指南 · Anthropic 模型文档。| 接入项 | Gemini 4 Neon | Claude Opus 5.5 |
|---|---|---|
| 原生 API 长输出 | 同步请求默认允许思考与输出合计 65,536 个 Token,支持的流程可开启长解码 | Anthropic 标注最大输出 128K |
| 缓存计费 | Google 标准档隐式命中为每百万输入 Token $0.15 | Anthropic 每百万 Token 读取 $0.20,写入 5 分钟缓存 $5、1 小时缓存 $8 |
| 多轮工具状态 | 需按接口规范保留 Google 的交互状态或思考签名 | 需遵循 Claude Messages 的工具结果与思考状态约定 |
如何设计一轮能指导切换的对照测试
先挑出一类团队经常遇到的典型工单,例如具备明确复现条件的偶发测试失败(Flaky Test)。给两边分配完全相同的代码分支、工单描述、工具权限、时间预算和测试命令;每次执行相互独立,审阅 diff 时尽量隐去模型名称,统一按同一张检查表打分。
看补丁之前,先把验收标准写清楚
先圈定一小批结果可测的代表性工单,提前锁定代码版本、依赖锁文件、仓库指令、可用工具以及停止条件。如果团队现有流程依赖 Claude Code,先把实际生效的仓库钩子(Hooks)和命令完整记下来;想要纯粹对比模型本身的能力,可以把这些检查迁移到不绑定特定模型的测试运行器中复现。
| 验收维度 | 核查方式 |
|---|---|
| 功能正确性 | 修改前能够稳定复现原缺陷,修改后目标测试用例通过 |
| 向后兼容 | 既有用例全部通过,旧输入格式与历史客户端行为符合预期 |
| 改动范围 | 修改严格收敛在工单范围内,没有通过大面积禁用断言来绕过测试 |
| 异常恢复 | 工具调用中断时能清晰说明未完成部分,避免重复触发有副作用的操作 |
为每个原始任务单独记录一行日志,涵盖首轮结果、最终结果、产出可审阅 diff 的耗时、计费 Token 以及人工评审分钟数。如果第二次重试才跑通,两次调用费用要合并累计,并注明评审者是否额外补充了线索。只有这样,你才能算清故障恢复的真实代价,精准划出哪些工单适合从 Opus 迁到 Neon。
常见问题
Neon 的编程能力比 Opus 5.5 更强吗?
在本文列出的 CursorBench 配置中,Neon 的得分高于 Opus 5.5;但 Opus 在部分终端调试和仓库级评测中依然领先。建议优先参考与自己日常任务最接近的评测维度。
Neon 一定更便宜吗?
单看标准输入和输出单价,Neon 比 Opus 5.5 低 25%。但具体到每个合格任务的真实成本,还要综合考虑 Token 消耗量、缓存命中率、重试次数以及人工评审开销。
对比测试时两边都要开最高思考档吗?
不用一刀切。高难度工单可以加测最高档,但面向日常流量做选型时,应该直接对比预算和延迟都在可接受范围内的常规档位。
可以不换编辑器直接做对比吗?
可以,前提是当前编辑器同时支持两款模型及任务所需的全部工具能力。这样做还能顺带固定编辑器变量,对比结果更干净。
线上正在跑的 Agent,直接改模型名就能切换吗?
不能直接硬切,务必先核对协议差异。不同厂商 API 在工具消息结构、思考参数配置和会话状态维护上的要求并不完全一致。
第一批测试该选什么任务?
优先选一类反复出现、容易复现、验收标准清晰的问题。跑出来的结果可以直接用来制定后续同类工单的路由规则。