

Gemini 4 Argon vs GPT-6 Astra : code et coûts

| Votre situation | Point de départ | Preuve nécessaire avant de changer |
|---|---|---|
| Astra réussit déjà vos contrôles de code | Gardez Astra en production ; rejouez les mêmes tâches sur Argon | Correctifs acceptés, temps de revue et coût par modification acceptée |
| Rapports longs ou grands changements de code atteignent les limites de sortie | Testez Argon avec un budget de sortie adapté à la tâche | Sorties complètes acceptées, dans les limites de latence et de dépenses |
| Votre agent dépend du comportement Responses propre à Astra | Préservez ce workflow et isolez une comparaison portable | Comportement d’outils équivalent et gain de migration mesuré |
| Un petit modèle traite déjà les tâches courantes à bas coût | Gardez cette référence moins chère | Gain par rapport à cette référence, pas seulement à Astra |
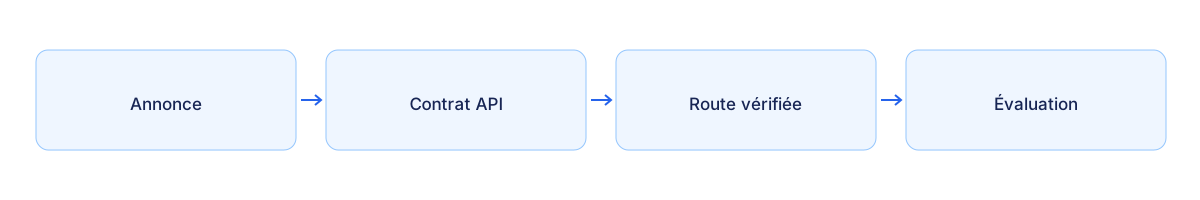
Qu’est-ce qui est réellement comparable aujourd’hui ?
| Question | Gemini 4 | GPT-6 Astra | Décision sûre |
|---|---|---|---|
| Statut produit officiel | Annoncé · Accès restreint | Sorti chez OpenAI le 3 septembre 2026 ; accès API élargi à partir du 4 septembre | Les tarifs nominaux et évaluations fournisseur sont comparables ; le test EvoLink à charge et conditions identiques reste à effectuer. |
| ID API fournisseur | Non établi par l’annonce ; utilisez l’identifiant EvoLink configuré sur la page modèle pour les requêtes de passerelle | gpt-6-astra (OpenAI) ; pas d’alias générique gpt-6 | Distinguer identifiants fournisseur et passerelle ; utiliser celui documenté pour la route choisie |
| Spécifications publiées (contexte, sortie, entrées) | Google annonce une limite de sortie de 1 million de tokens pour le raisonnement et la génération prolongés. Ce n'est ni une fenêtre de contexte d'entrée confirmée ni une garantie de paramètre EvoLink. | Contexte de 1,05M tokens, 128K de sortie maximale, entrée texte et image, sortie texte (OpenAI) | Ne pas inférer les limites de Gemini 4 à partir de Gemini 3.x |
| Prix catalogue | Google annonce 2 dollars par million de tokens en entrée et 10 dollars par million en sortie pendant la période de lancement, puis 4 et 20 dollars. La date de fin n'est pas précisée. Il s'agit des tarifs Google, pas d'une offre EvoLink. | 10 $ en entrée / 50 $ en sortie par 1M de tokens ; entrée cachée 1 $ (niveau Standard OpenAI) | Les tarifs nominaux et évaluations fournisseur sont comparables ; le test EvoLink à charge et conditions identiques reste à effectuer. |
| Surface d’appel d’outils | Non publiée | API Responses uniquement ; OpenAI documente que Chat Completions ne prend pas en charge le function calling avec Astra | Déplacer les boucles d’outils vers Responses quelle que soit la décision Gemini |
| Route EvoLink | Gemini 4 Argon est disponible via EvoLink. Consultez la page modèle pour les prix actuels et l’exemple de requête. | Appelable ; ID de modèle de requête gpt-6-astra | Établir la référence sur la route vérifiée |
| Test à charge identique | À exécuter via EvoLink ; aucun résultat revendiqué ici | À comparer à votre référence actuelle | Exécutez un comparatif par charge de travail via EvoLink en conservant votre référence, vos critères d’acceptation et votre solution de repli pendant le rejeu, le trafic miroir et le déploiement progressif. L’accès API permet l’évaluation ; il ne prouve aucun gain de qualité ou de coût. |
Les évaluations Google permettent une première comparaison, mais ne sont pas un test EvoLink à conditions égales. Elles ne prouvent ni latence, ni coût par tâche acceptée, ni supériorité universelle. Le tableau montre un résultat favorable à Argon et un autre où il reste derrière le modèle comparé.
Résultats d'évaluation publiés par Google
| Évaluation | Gemini 4 Argon | GPT-6 Astra |
|---|---|---|
| DeepSWE v1.1 | 77.9% | 74.1% |
| FrontierSWE v2 | 55.0% | 65.5% |
Vérifiez les réglages avant d’interpréter l’écart. La méthodologie Google utilise pass@1 sauf indication contraire et généralement le niveau de raisonnement maximal disponible. DeepSWE combine une exécution Argon avec mini-swe et des résultats comparatifs issus de classements publics ou de fiches système ; FrontierSWE provient du classement Proximal. Les deux modèles n’ont pas été réexécutés dans un même banc d’essai EvoLink. Conservez la version du benchmark, le banc d’essai, le réglage de raisonnement et la source à côté de chaque score. Un écart en points de pourcentage ne prédit pas le taux de réussite en production.
| Champ de preuve | DeepSWE v1.1 | FrontierSWE v2 |
|---|---|---|
| Versions des modèles | Gemini 4 Argon / GPT-6 Astra | Gemini 4 Argon / GPT-6 Astra |
| Banc d’essai et source des scores | Argon : exécution mini-swe ; Astra : classement public cité par Google | Classement Proximal cité par Google |
| Raisonnement et métrique | Google indique le raisonnement maximal disponible et pass@1 sauf exception ; des réglages identiques ne sont pas établis | Réglages propres au benchmark dans la méthodologie liée ; des budgets identiques ne sont pas établis |
| Vérification des preuves | 13 octobre 2026 ; ce n’est pas la date d’un test apparié | 13 octobre 2026 ; ce n’est pas la date d’un test apparié |
| Limite d’interprétation | Sources de résultats différentes ; pas de comparaison EvoLink contrôlée | Ne prédit pas la réussite sur votre dépôt |
Définir le périmètre de l’évaluation avant de déplacer le trafic
Commencez par une tâche évaluable : réparation de dépôt, réécriture de document ou workflow d’outils avec état final connu. Figez entrée de référence, critères d’acceptation, budget de nouvelles tentatives et durée limite. La sortie longue d’Argon n’est utile que si elle aide à terminer la tâche ; elle ne justifie pas de relever le budget de chaque requête.
Mesurez aussi le travail d’intégration : adapter une boucle d’outils, modifier la gestion d’état et maintenir un second parseur peut coûter davantage que les petites économies par requête. Ne migrez que les classes de tâches dont le bénéfice observé couvre ce travail.
Ce que votre workflow OpenAI devrait adapter pour Gemini
model. Elle ne rend pas identiques les sémantiques natives des fournisseurs : la gestion des schémas d’outils, les frontières des événements de streaming, les contrôles de raisonnement, les mécanismes de cache, les codes d’erreur et l’identité renvoyée dans la réponse restent définis par le contrat de chaque fournisseur. Une seule clé API sur une gateway ne garantit pas que chaque fonctionnalité native se comporte de la même façon d’un fournisseur à l’autre. La page produit Argon décrit l’intégration EvoLink. La colonne de droite liste les vérifications de compatibilité de votre application, sans promettre la correspondance de toutes les fonctions natives.| Surface | Ce qu’Astra documente aujourd’hui (OpenAI) | À vérifier sur la route Argon |
|---|---|---|
| Protocole requête/réponse | Endpoints Responses, Chat Completions et Batch | Utilisez l’exemple Chat Completions EvoLink ou le format natif Gemini ; testez le parseur et les champs requis au lieu de transmettre un payload Responses inchangé |
| Schéma d’outils/fonctions | Function calling sur Responses uniquement ; appel d’outils asynchrone documenté | Format du schéma, prise en charge parallèle et asynchrone, modes de choix d’outil, comportement en cas de choix forcé ; à vérifier dans la documentation de la route choisie et dans votre trace applicative |
| Gestion de l’état et de la conversation | État basé sur Responses ; configuration_update change l’effort en cours de conversation en préservant le cache — pour les requêtes standard avec un seul agent ; vérifier les limites de compatibilité documentées | Comment l’état multi-tours, les résultats d’outils antérieurs et les préfixes en cache sont transportés entre les tours ; à vérifier dans la documentation de la route choisie et dans votre trace applicative |
| Streaming | Streaming pris en charge ; pilotage en cours de tour via WebSocket response.steer | Forme des événements, livraison partielle des arguments d’outils, remontée de l’usage dans le flux ; à vérifier dans la documentation de la route choisie et dans votre trace applicative |
| Contrats de retry et d’erreurs | Limites par niveau de compte dans la documentation actuelle du modèle ; les limites du fournisseur ne sont pas celles de la route EvoLink ; HTTP 400 sur l’effort none ou minimal ; la surveillance de désalignement peut arrêter une tâche API en cours | Codes d’erreur, structure des rate limits, tout comportement d’interruption de sécurité, consignes de retry ; à vérifier dans la documentation de la route choisie et dans votre trace applicative |
| Contrôles de raisonnement/thinking | reasoning.effort à low, medium, high, xhigh, max ; reasoning.mode standard ou pro sur Responses ; temperature, top_p, logprobs refusés | Si le thinking est exposé, budgété ou toujours actif ; quels paramètres d’échantillonnage existent ; à vérifier dans la documentation de la route choisie et dans votre trace applicative |
| Cache de prompt | Pris en charge ; prompt_cache_options.ttl n’accepte que "30m" ; entrée cachée 1 $ par 1M | Mécanisme de cache, options de TTL, prix en lecture et en écriture ; à vérifier dans la documentation de la route choisie et dans votre trace applicative |
| Facturation du contexte long | Requête entière facturée à 2× l’entrée et le cache, 1,5× la sortie au-delà de 272K tokens d’entrée | Existence de paliers tarifaires et position des seuils ; à vérifier dans la documentation de la route choisie et dans votre trace applicative |
| Route gateway | gpt-6-astra sur EvoLink ; l’entrée image via EvoLink nécessite une vérification de route séparée | Identité de modèle renvoyée, compteurs d’usage et enregistrement de facturation sur la route EvoLink ; à vérifier lors de l’intégration |
temperature et top_p et le réglage de l’effort restent propres à Astra. La colonne Argon sert à vérifier la compatibilité de la route utilisée. Une clé commune réduit la création de comptes, sans supprimer le travail de migration de protocole.Matrice de tâches : code, agents multi-outils, documents longs
Google présente Argon pour le génie logiciel, le travail intellectuel en entreprise et la cyberdéfense, avec des évaluations publiées. Ce sont des résultats du fournisseur, pas des tests EvoLink ni une garantie pour votre charge de travail. Les tarifs nominaux et évaluations fournisseur sont comparables ; le test EvoLink à charge et conditions identiques reste à effectuer.
| Classe de workload | Quoi mesurer | Ce qu’Astra permet de mesurer maintenant | Condition d’entrée pour Gemini 4 |
|---|---|---|---|
| Code à l’échelle du dépôt | Taux de patchs acceptés, temps de correction humaine, retries par changement accepté, tokens par changement accepté | OpenAI positionne Astra pour le code et le raisonnement complexe ; exécutez votre jeu de tâches sur Responses aux efforts medium et high pour fixer une référence | Même harness, même jeu de tâches, même grille : un taux de patchs acceptés au moins égal à celui d’Astra et un coût par patch accepté inférieur ou égal à celui de la référence Astra figée, avec un contrat de modèle publié derrière le résultat |
| Agents multi-outils (computer use, navigation, API internes) | Achèvement de la trace entière, taux de mauvais outil, taux de boucles, reprise après un appel d’outil échoué | OpenAI documente le computer use, l’appel d’outils asynchrone et le pilotage en cours de tour ; mesurez avec et sans ces fonctionnalités natives et étiquetez les voies | Un contrat d’appel d’outils et de streaming publié, puis un taux d’achèvement sur une voie portable appariée avant toute comparaison de voie native |
| Documents longs et recherche | Précision de la récupération sur tout le contexte, complétude de la sortie, coût par tranche de taille d’entrée | OpenAI documente un contexte de 1,05M tokens et un usage en recherche et création de documents ; relevez le coût des deux côtés du seuil de 272K | Limites de contexte et de sortie publiées, paliers tarifaires publiés, même jeu de documents, coût relevé à chaque tranche de taille d’entrée |
| Tâches courantes à fort volume | Latence p95, coût par tâche, taux d’erreur | La bonne référence est souvent un niveau GPT-5.6 plutôt qu’Astra | Doit battre la référence la moins chère, pas seulement Astra |
Deux règles gardent la matrice honnête. Premièrement, le positionnement documenté par un fournisseur est une hypothèse sur où tester, jamais un résultat. Deuxièmement, un avantage de fonctionnalité native (par exemple les appels d’outils asynchrones d’Astra) doit être rapporté comme un résultat de voie, pas converti en classement universel.
Pour de grands ensembles de questions techniques, validez le nombre de réponses et leur schéma, vérifiez indépendamment un échantillon de raisonnements et relancez les tests de code. Une réponse qui exploite la capacité de sortie mais omet des questions ou contredit des réponses précédentes échoue à l’acceptation. Le découpage et les nouvelles tentatives restent soumis au même budget total par tâche.
Coût d’intégration et coût par tâche acceptée
L’unité qui compte est le coût par tâche acceptée : tout ce qui est dépensé pour faire passer une tâche en revue, y compris les tokens d’entrée, les écritures et lectures de cache, les tokens de sortie, la surcharge des appels d’outils, les retries, les requêtes de fallback et le temps de correction humaine. Le prix au token seul masque l’essentiel.
Passer du rejeu au trafic miroir puis au déploiement progressif
- Copiez le contrat d’intégration depuis la page modèle. Utilisez l’identifiant et l’exemple de requête EvoLink actuels. Gardez la route en configuration et consignez le protocole de chaque voie de test.
- Rejouez des tâches figées. Utilisez les mêmes instantanés de dépôt, permissions d’outils, tests d’acceptation et budgets de sortie. Enregistrez échecs et résultats acceptés.
- Testez un échantillon représentatif en trafic miroir. Continuez à servir Astra et évaluez séparément les sorties Argon. Incluez requêtes longues et reprises après erreur d’outil, pas seulement les succès courts.
- Déployez progressivement une classe de tâches. Fixez part de trafic et fenêtre d’observation à l’avance. Élargissez uniquement si acceptation, coût et latence respectent les seuils ; gardez la référence pour le retour arrière.
Vérifiez ensemble métadonnées de réponse, usage et facturation. L’étiquette de modèle renvoyée sert au contrôle de cohérence, sans prouver indépendamment l’identité du modèle sous-jacent. Résolvez les écarts inexpliqués de routage ou de facturation avant d’élargir le trafic.
Quand conserver votre routage actuel
Un Gemini 4 sorti ne remplace pas automatiquement Astra ou un niveau GPT-5.6 moins cher. Gardez la route actuelle dès que l’une des conditions suivantes est vraie :
- La route actuelle atteint déjà la barre d’acceptation pour cette classe de workload et le candidat n’améliore pas le coût par tâche acceptée.
- Le candidat ne prend pas en charge un comportement d’outil dont votre agent dépend, ou seulement sous une forme que votre gateway ne peut pas mapper.
- Le workload est réglementé et le candidat n’a pas passé la revue de résidence des données, de conservation ou de politique.
- Le candidat dégrade la latence p95 ou le coût par tâche acceptée sans gain de qualité suffisant pour le justifier.
- L’identité de modèle renvoyée sur la route est floue, ou les enregistrements d’usage et de facturation ne se rapprochent pas du modèle demandé.
Le routage existe pour réserver la capacité coûteuse aux classes de tâches où elle change le résultat livré, pas pour envoyer chaque requête vers le nom le plus récent.
Un plan en 5 étapes
- Figez la référence sur Astra maintenant. Sauvegardez des tâches représentatives, des traces complètes, des évaluateurs et les chiffres actuels de coût et de latence par classe de workload, avec
gpt-6-astrasur Responses. - Gardez la sélection du modèle en configuration. Routez via la gateway pour qu’un futur candidat soit un changement de configuration, pas de code ; ne dispersez pas les ID fournisseur dans le code applicatif.
- Écrivez dès aujourd’hui les seuils d’acceptation et de rollback. Taux de tâches acceptées, coût par tâche acceptée, latence p95, budget d’erreurs et déclencheur de rollback, fixés avant de voir le moindre résultat du candidat.
- Ajoutez Argon via la route EvoLink documentée. Suivez le rejeu, le trafic miroir et le déploiement progressif ci-dessus ; ne reprenez pas les limites ou prix Gemini 3.x.
- Conservez la route précédente pendant toute la fenêtre d’observation. Gardez Astra (et le fallback GPT-5.6) en ligne jusqu’à ce que le candidat survive au replay, au shadow et au canary.
FAQ
Puis-je comparer directement Gemini 4 et GPT-6 Astra aujourd’hui ?
Oui : exécutez les mêmes tâches sur les deux routes EvoLink. Cet article compare les preuves publiées et définit le test ; il ne rapporte pas une expérimentation comparative EvoLink terminée. Consultez chaque page modèle pour les prix actuels.
Dois-je migrer mon intégration API pour utiliser Gemini 4 ?
temperature, top_p et les efforts none ou minimal. L’endpoint compatible OpenAI d’une gateway conserve votre clé et votre URL de base, mais le comportement natif du fournisseur, comme les schémas d’outils, les événements de streaming et les contrôles de raisonnement, devra encore être vérifié par fournisseur à partir de la documentation de la route choisie.Comment décider si le travail de migration en vaut la peine ?
Comparez le coût d’adaptation et de maintenance de l’intégration au bénéfice mesuré par tâche acceptée. Gardez la route actuelle en service pendant l’évaluation d’Argon ; un lancement API ne justifie pas à lui seul de déplacer tout le trafic.
Comment rendre l’appel d’outils comparable entre fournisseurs ?
Exécutez d’abord une voie portable : mêmes définitions d’outils, permissions, budget de retries et règles d’arrêt sur les deux routes, fonctionnalités propres au fournisseur désactivées. Puis exécutez des voies natives (pour Astra, l’appel d’outils asynchrone et le pilotage en cours de tour sur Responses) et étiquetez-les séparément. Rapportez l’achèvement de la trace entière, le taux de mauvais outil et le taux de boucles par voie. Vérifiez les fonctions d’outils prises en charge par la route Argon avant de les inclure dans la voie portable.
Quand Gemini 4 pourra-t-il entrer dans le routage de production ?
Lorsque les résultats de rejeu, de trafic miroir et de déploiement progressif respectent les seuils de qualité, de latence et de coût fixés avant les tests. Utilisez la route EvoLink documentée, rapprochez usage et facturation, et conservez Astra pour le retour arrière.
GPT-6 Astra est-il la même chose que le Project Astra de Google ?
gpt-6-astra. Le Project Astra de Google est un nom de projet de recherche et d’assistant de Google sans rapport. Aucun des deux n’est Gemini 4, et aucun ne doit servir de preuve concernant Gemini 4. Distinguez aussi Gemini 4 de Gemma 4, la famille de modèles à poids ouverts de Google.Sources
- Annonce Argon de Google — 30 septembre 2026
- Évaluations publiées par Google
- Google : lettre de résultats du T2 2026 d’Alphabet (déclaration sur le pré-entraînement de Gemini 4)
- Google : annonce de Gemini 3.6 Flash (déclaration sur le pré-entraînement de Gemini 4)
- Google : catalogue de modèles de l’API Gemini
- OpenAI : documentation du modèle GPT-6 Astra
- OpenAI : annonce de GPT-6 Astra
- Tarifs de l’API OpenAI
- OpenAI : guide du dernier modèle (appel d’outils réservé à Responses, paramètres retirés)
- Statut de l’API Gemini 4 sur EvoLink
- API GPT-6 Astra sur EvoLink
- EvoLink : suivi de la date de sortie de Gemini 4
- EvoLink : Claude Fable 5.1 vs GPT-6 Astra


