对比
MiniMax M3.1 Flash vs GPT-6 Luna:输入与工具协议

EvoLink Team
产品团队
2026年10月19日
5 分钟阅读
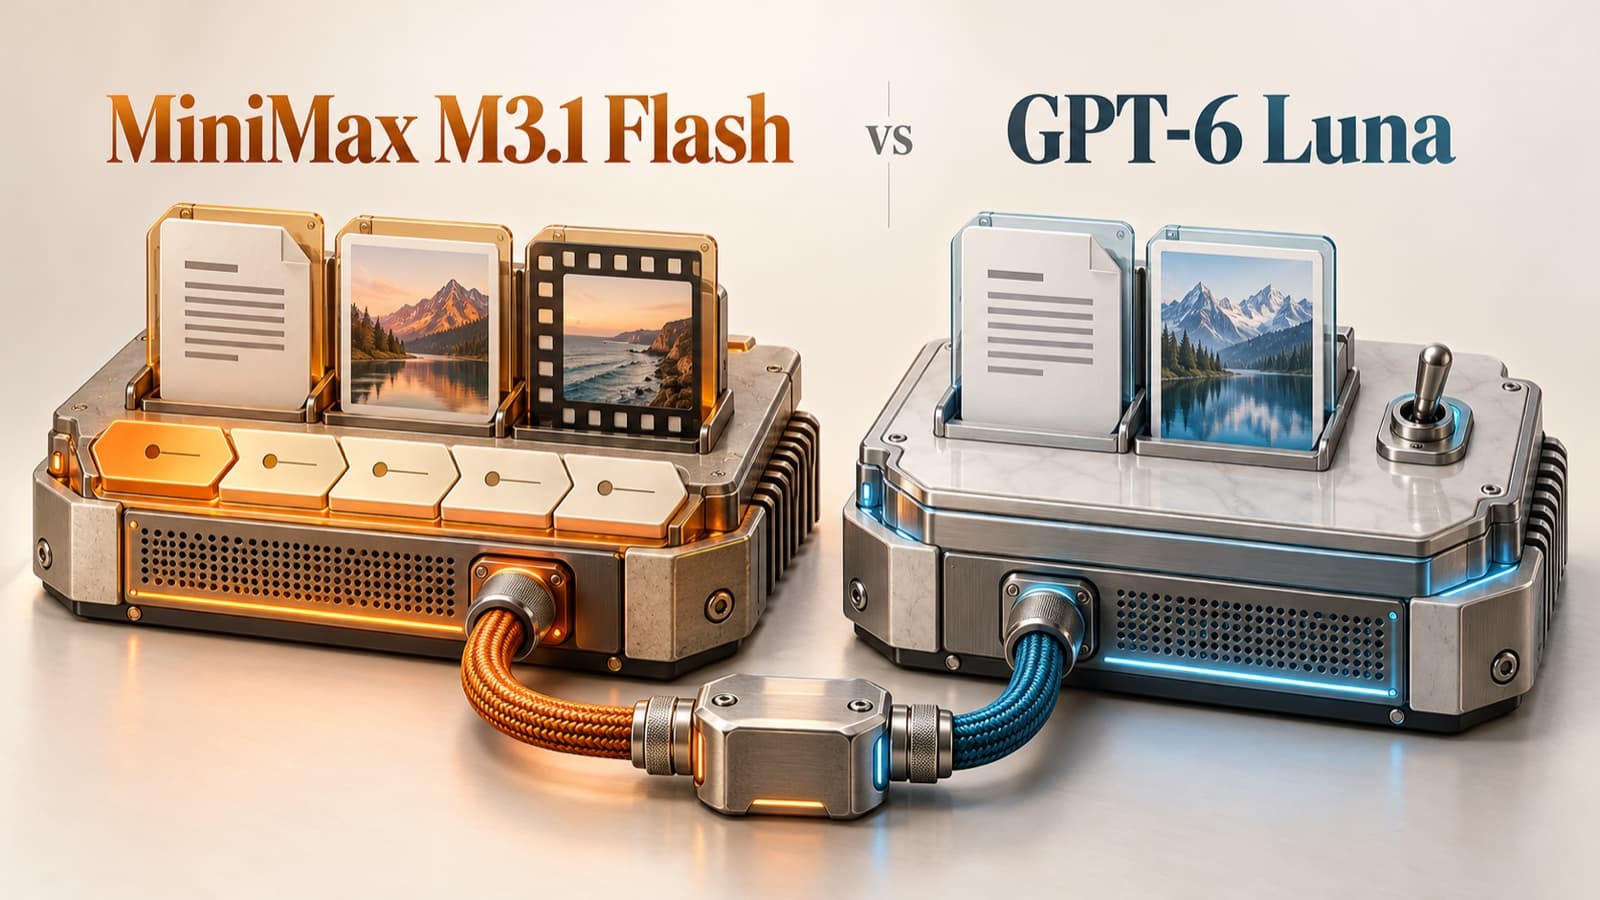
比较 MiniMax M3.1 Flash 与 GPT-6 Luna,先判断输入类型和工具协议,再解释价格差异。 两者都是百万级上下文,但不能当成同一套请求配置:MiniMax 接受视频且思考始终开启;Luna 接受文本和图片,可关闭思考,最大输出为 128,000 Token。
本文比较文档规定的契约,不是质量实测。MiniMax 模型页与 Luna 模型页维护当前 EvoLink 接入与费率。这里回答两款具体模型怎么选,不做通用编程模型排名,也不替代 GPT 代际升级指南。
MiniMax M3.1 Flash 与 GPT-6 Luna:输入和工具契约
| 参数 | MiniMax M3.1 Flash | GPT-6 Luna |
|---|---|---|
| 提供商 | MiniMax | OpenAI |
| 官方模型 ID | MiniMax-M3.1-Flash | gpt-6-luna |
| 定位 | 编程、Agent、多模态与长上下文工作 | 目标明确的高频摘要、分类与抽取 |
| 上下文窗口 | 1,000,000 Token | 1,050,000 Token |
| 输入类型 | 文本、图片、视频 | 文本、图片;不支持原生音频或视频 |
| 输出类型 | 文本 | 文本 |
| 思考档位 | low、medium、high、xhigh、max | none、low、medium、high、xhigh、max |
| 默认思考 | max;不能关闭 | medium;none 可关闭 |
| 函数调用 | 交错思考;轮次间保留完整 assistant 响应 | Responses 可结合思考与函数调用;Chat Completions 函数调用要求 reasoning_effort: none |
| 官方输入/输出价 | 每百万 Token $0.15/$0.60 | 每百万 Token $0.10/$0.50,Standard 且输入不超过 272K Token |
| 官方缓存读取价 | 每百万 Token $0.015 | 同一输入档位每百万 Token $0.01 |
参数与提供商价格核查于 2026 年 10 月 19 日,来源:MiniMax 调用文档、MiniMax 价格页、OpenAI Luna 文档。这是原生直连价格。Luna 另收缓存写入费用;输入超过 272K 时,整条请求的输入与缓存费率为 2 倍、输出费率为 1.5 倍。EvoLink 费用复用已有 MiniMax和 Luna 价格区块。
这些差异如何影响应用
视频: MiniMax 文档列出视频输入。Luna 需要先抽帧为图片或转录为文本。预处理由应用承担,不能算作原生视频能力;发送前还要确认网关支持的请求结构。
思考: MiniMax 五档控制深度,思考始终开启。Luna 多出
none,默认 medium。切换时明示目标设置。要求不思考的任务,不能把 MiniMax 的 low 当成 Luna none 的相同契约。工具: MiniMax 保留完整 assistant 历史,包括存在时的
reasoning_content、tool_calls 或全部 Anthropic 内容块。Luna 结合思考与函数调用应走 Responses;Chat Completions 的函数调用必须关闭思考。“OpenAI 兼容”本身不保证工具行为完全一致,也不证明网关提供所有原生功能。在 EvoLink 上完成两款模型的选择
EvoLink 为鉴权、模型配置和用量记录提供统一网关。先匹配输入与协议要求,再评估实际任务。更大窗口说明能装入多少输入,不说明证据使用是否准确;更低 Token 单价也不能证明验收成功成本更低。
尽量保持提示词、输入版本和工具定义可比。检查实际设置、最终回答、工具 ID、结束条件、重试、总时间和真实扣费。比较完整任务,不只看流式生成速度。所需输出语言和格式应写进验收,本篇不提供未经测量的语言质量排名。
继续查看 Luna 配置页或 MiniMax 工具调用文档。路由与恢复逻辑由应用实现;使用统一网关不等于已经具备按质量自动回退的策略。
查看两款模型当前配置
准确规格、费率与请求入口复用已有模型页。