Gemini 4 Carbon vs Claude Fable 5.2:编程、推理与任务成本怎么选?
对比 Carbon 与 Fable 5.2 的仓库评测、CursorBench 档位和完整任务成本,按编程场景选择,并通过 EvoLink 安排主力、升级与审查模型。
 EvoLink Team产品团队
文章目录
这个选择有两组依据:Carbon 在当前 CursorBench 中取得了接近 Fable max 的成绩,榜单列出的费用更低;Fable 则在 Anthropic 公布的仓库工程评测中更高。两者的优势随任务和推理档位变化,值得为具体工作建立各自的使用范围。
先按任务决定用 Carbon 还是 Fable
| 你要解决的问题 | 优先选择 | 决定是否保留它的标准 |
|---|---|---|
| 复杂多文件修改,希望控制高能力模型的消耗 | Carbon medium | 测试通过、改动可接受,完整任务费用符合预算 |
| 跨模块迁移、困难 Bug,失败后需要大量人工返工 | Fable 5.2 | 能否减少推翻重做、遗漏和人工排查时间 |
| 跨工具执行业务流程 | 先评估 Carbon,再与现有模型对照 | 动作顺序、参数和最终业务状态正确 |
| 日常工作已能稳定交付,偶尔遇到难题 | 保留现有主力,增加升级路径 | 升级是否解决了原流程确实卡住的问题 |
| 审查另一个模型生成的代码 | 选择另一款模型独立审查 | 问题能复现,修复后通过回归,误报可控 |
这张表是首次试用的优先次序。Carbon 的较低基础单价,适合先建立预算基线;Fable 的仓库评测表现,使它值得优先承担失败成本较高的代码任务。审查环节则应根据你已有的实现模型选择,避免实现和复核完全依赖同一套判断。
例如,支付服务重构既要维持幂等,又不能改变历史重试行为。此时更值得比较的是模型是否识别旧接口约束、提出可验证的迁移方案,并补齐回归测试。若一次更好的方案能省掉几小时返工,Token 单价在决策中的权重就会下降。
编程评测怎样支持这组选择?
Fable 在部分仓库工程评测中更高
Anthropic 的 Fable 5.2 发布表包含两款模型的共同项目:
| 评测任务 | Gemini 4 Carbon | Claude Fable 5.2 |
|---|---|---|
| FrontierSWE v2,仓库软件工程 | 61.2% | 69.9% |
| FrontierCode 2.0,代码改动是否达到可合并标准 | 41.1%,medium | 49.1%,xhigh |
| AutomationBench,业务工作流 | 53.9% | 51.4% |
| OSWorld 2.1,离线桌面操作子集、部分计分 | 81.5% | 89.3% |
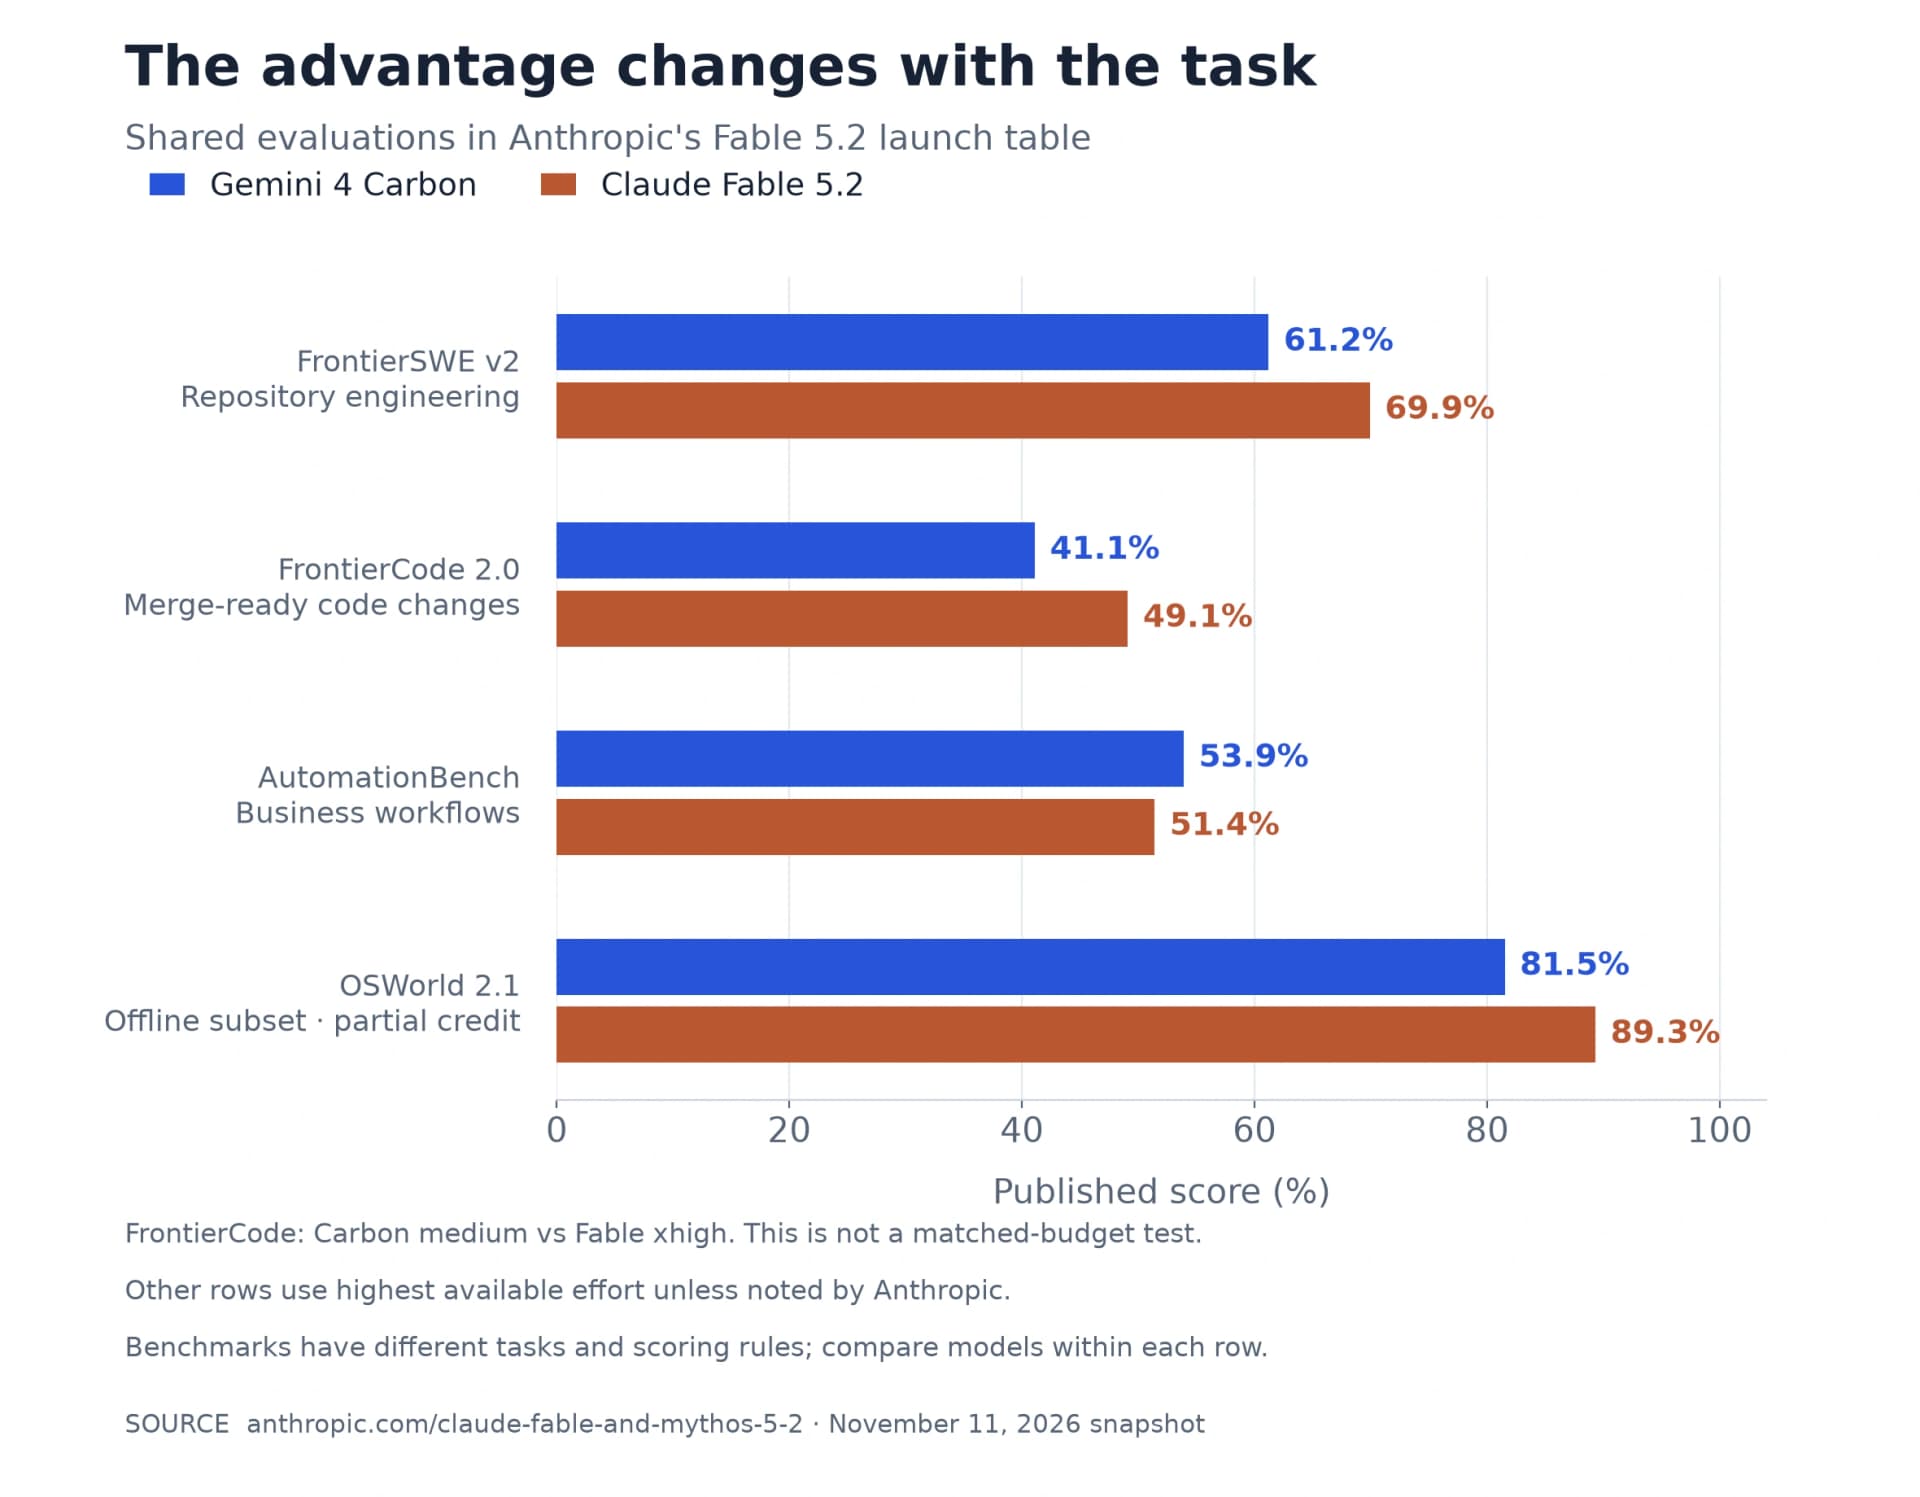
这组结果支持优先用 Fable 测试困难仓库修改,也为 Carbon 的业务工作流试用提供了依据。桌面操作、仓库修改和业务自动化有不同的完成标准,应对应到你要交付的任务。
Carbon 在 CursorBench 中有更有吸引力的高档配置组合
CursorBench 4.0 使用来自真实 Cursor 会话的模糊、多文件任务。11 月 11 日读取的部分配置如下:
| 配置 | 成绩 | 榜单列出的平均每任务费用 |
|---|---|---|
| Carbon high | 60.4% | $9.22 |
| Carbon medium | 60.1% | $8.49 |
| Carbon low | 58.6% | $11.89 |
| Fable 5.2 max | 60.0% | $32.79 |
| Fable 5.2 high | 56.9% | $9.70 |
| Fable 5.2 medium | 54.8% | $4.66 |
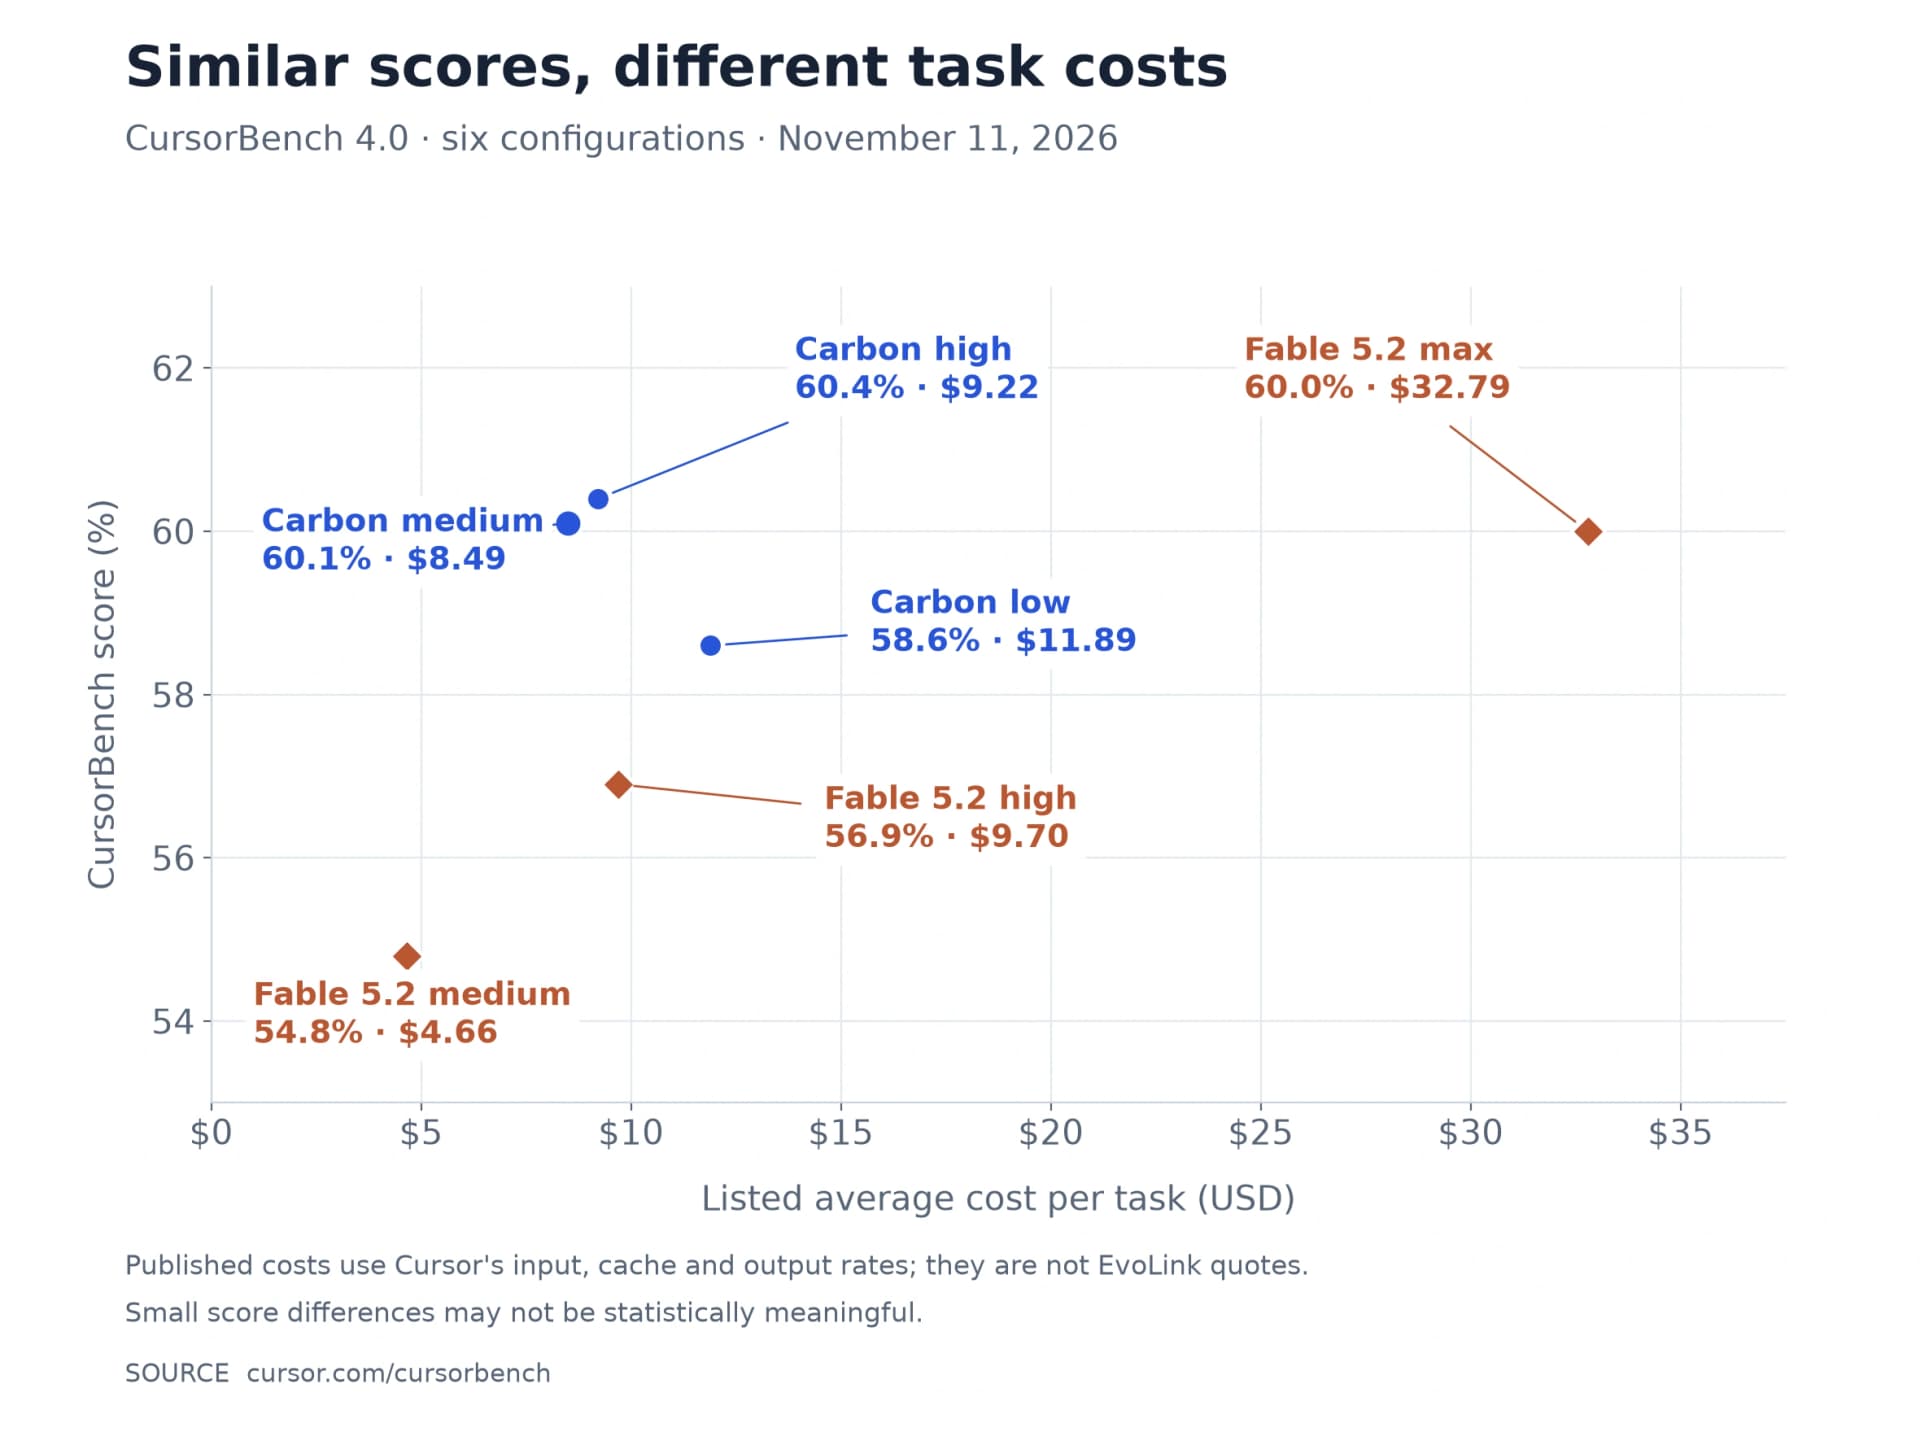
Carbon medium 与 Fable max 的成绩接近,费用差距较大,因此它值得成为复杂编码的首轮候选。但 Fable medium 在这组任务中费用更低,成绩也更低。如果这个质量水平已满足需求,较低档位的 Fable 同样可能合适。
Carbon low 的平均费用还高于 medium。对多步骤 Agent,降低单轮思考强度后,整个任务的执行路径和总用量也会变化。选档位时应比较最终完成情况与总账单。
Fable 的更高单价,什么时候值得付?
以下为厂商 Standard 基础费率,单位均为美元/每百万 Token,不包含缓存、Batch、Fast mode 和额外工具费用。
| 模型与计费时期 | 输入 | 输出 |
|---|---|---|
| Carbon,截至 2026 年 11 月 30 日 | $2 | $10 |
| Carbon,自 2026 年 12 月 1 日起 | $4 | $20 |
| Fable 5.2 | $8 | $40 |
- Carbon 首发期:$0.30。
- Carbon 常规期:$0.60。
- Fable 5.2:$1.20。
实际任务中,两款模型的分词、思考消耗、工具调用和重试路径可能不同。选择 Fable 的理由,是它在某类任务中减少了失败、人工重写或排查时间;选择 Carbon 的理由,是它在达到相同验收要求时,让你的完整任务费用更低。
创意编程可以从公开作品开始比较
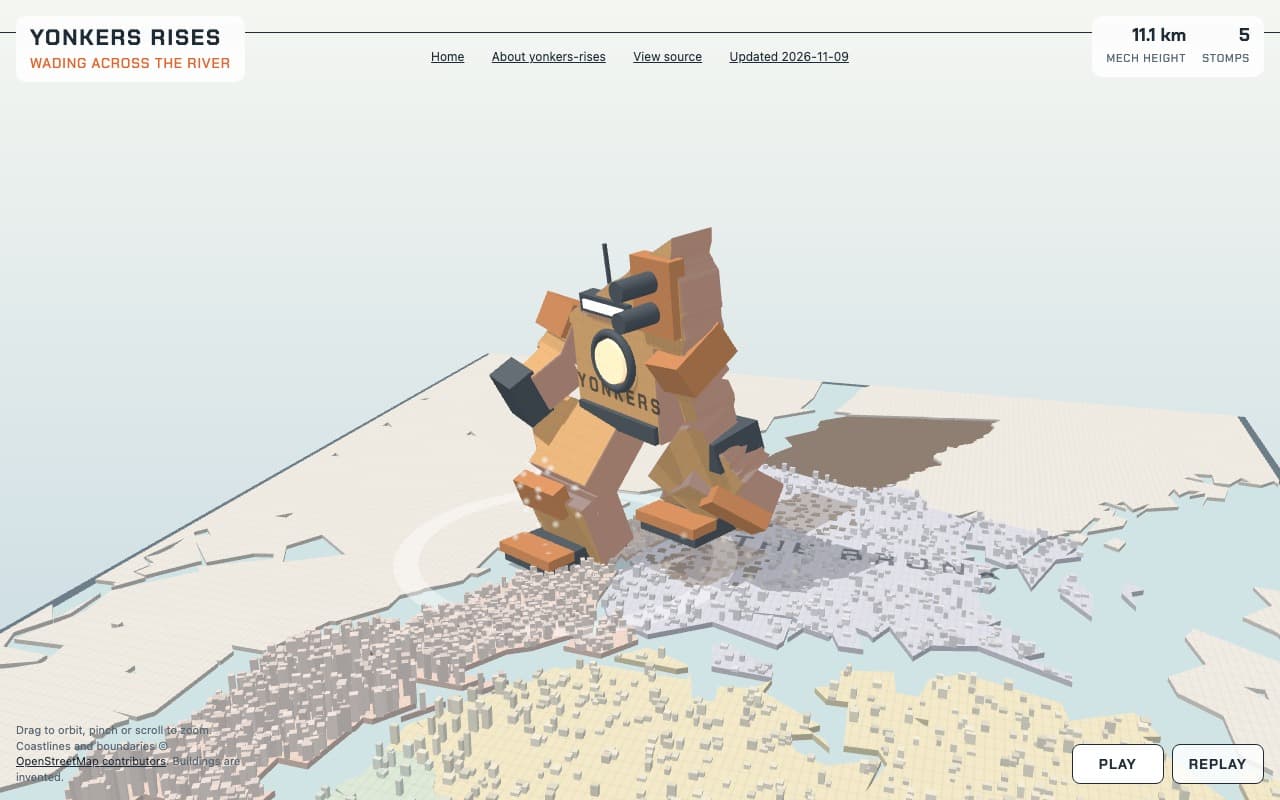
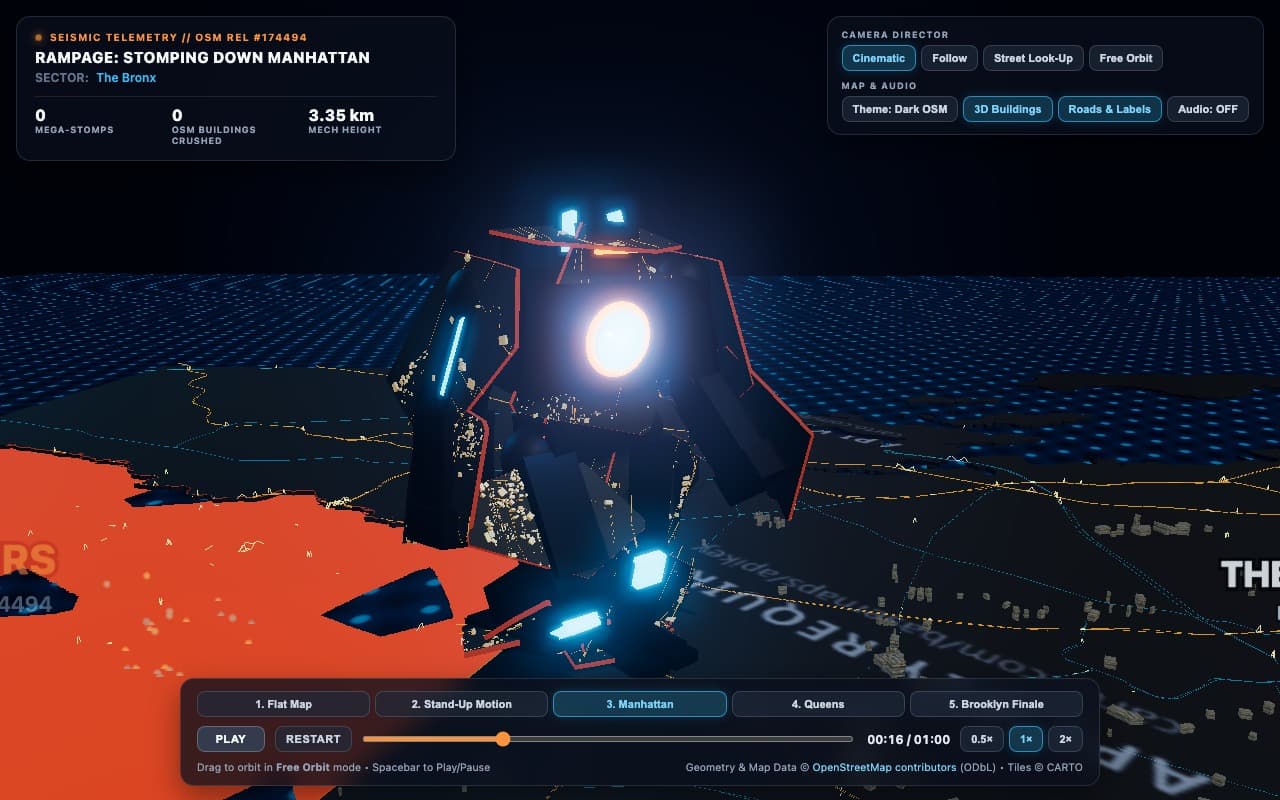
以上为原作者公开作品的选定画面截图。可以打开原作重播动作,截图不用于比较运行速度。
打开作品后,可以具体看这三个方面:
- 地理约束: 看 Yonkers 的轮廓如何变成机甲,地图、道路与当前区域标签是否对应。Fable 作品明确标注建筑为虚构,应按演示用途理解。
- 动作连贯性: 完整重播变形、起身和行走,观察过渡、落脚与地面接触,避免只凭一帧截图判断动画表现。
- 交互是否实用: 尝试 Fable 的拖拽、缩放与重播,以及 Carbon 的镜头、章节和倍速控制,检查这些操作是否便于查看和导航结果。
这个案例适合检查两款模型如何完成空间、动画与数据要求。两次实验的工具环境、提示细节和请求轮次不同,也没有匹配的总费用与耗时,因此不能据此判定整体胜负。作者注明 Fable 使用 medium,Carbon 的推理档位未在这份记录中说明。
如果你在做交互原型,给双方相同输入,检查场景是否满足要求、代码能否运行、修改是否容易,以及追加多少轮才交付。首屏效果和后续可维护性都应进入验收。
在 EvoLink 中怎样安排主力、升级与审查模型?
对已有产品,建议先保留稳定的主力流程,只把已识别的困难任务交给 Carbon 或 Fable。统一 API 的价值,是让你沿用密钥、余额和调用管理方式,把选择模型落实为应用配置,而每款模型的工具与推理参数仍按对应文档处理。
可以从三种安排中选一个开始:
/swarm 和 Claude Advisor 也各有产品与渠道条件,使用统一 API 时需要由所选框架或应用负责对应编排。用真实任务确定最终配置
从最近工作中选一组有明确验收标准的 Bug 修复、多文件修改或工具任务,为双方提供相同的代码版本、输入资料和工具权限。
每项任务保存四类结果:是否通过验收、全部模型与工具费用、开始到交付的总时间,以及人工介入和返工。对值得继续的失败任务,再提高档位或升级模型,并沿用相同的重试规则。
常见问题
预算有限,先试哪一个?
需要接近高档编程成绩时,先试 Carbon medium;若质量要求允许,也应比较 Fable medium。CursorBench 中后者费用更低、成绩更低,最终以自己的任务验收为准。
Fable 更贵,是否一定更适合编程?
Fable 在部分仓库工程评测中更高,Carbon 在当前 CursorBench 中也有很强的表现。优先按任务选择,再比较不同档位的交付与返工。
Carbon 是否便宜 75%?
按厂商未缓存输入与输出基础单价,首发期确实低 75%,常规期低 50%。这个比例不等于实际任务节省比例,也不直接代表 EvoLink 账户报价。
两边都设 medium,就是公平比较吗?
可以比较实际配置的使用效果,但相同档位名不代表相同计算预算。应同时记录模型、工具、用量、耗时与验收结果。
哪个更快?
按实际部署渠道与档位分别测量首字等待、完整响应和最终任务完成时间。思考、工具调用和返工都会改变结果。
切换模型只改名字就够了吗?
统一接入能减少客户端重复配置,但工具调用、推理参数、消息格式和错误处理仍要按模型检查。尤其是跨模型交接,应传递必要的任务材料,并按目标模型重建消息。
能直接用另一款模型审查代码吗?
可以先做独立审查试用,要求每条问题有触发条件和复现依据。模型之间意见一致,也需要经过测试验证;审查费用和误报处理时间应计入总成本。