Gemini 4 Hydrogen vs Gemini 3.8 Flash: guía de actualización
Cómo decidir la actualización a Hydrogen: contexto compartido, razonamiento predeterminado, cambios de caché, evaluación justa, coste total y reversión.
 EvoLink TeamEquipo de producto
En este artículo
Este artículo no contiene un benchmark controlado de cargas de trabajo de EvoLink. Combina diferencias documentadas con un método reproducible de evaluación y despliegue. Pretende ayudarte a decidir antes de cambiar el tráfico de producción, no declarar un ganador universal a partir de demostraciones comunitarias.
Decide qué tipo de actualización necesitas
Un flujo estable de clasificación y un agente de programación pueden llegar a conclusiones distintas sobre el mismo modelo. Al clasificador puede quedarle poco margen de mejora, mientras que la tasa de fallos iniciales de un agente puede justificar una respuesta más cara. Trátalos como decisiones de ruta independientes.
| Situación actual | Decisión inicial | Evidencia necesaria para cambiarla |
|---|---|---|
| 3.8 cumple calidad, coste y tiempo de respuesta | Mantenerlo como control | Una mejora concreta que importe al negocio |
| Fallos repetidos en documentos o código | Probar Hydrogen en esas clases de fallo | Resultados correctos y aceptados, no una explicación más convincente |
| La tarea necesita superar el límite actual de respuesta | Investigar la arquitectura de salida larga | Continuación compatible, presupuestos acumulados y manejo de interrupciones |
| El cliente depende de cachés explícitas de prompts | Auditar la compatibilidad antes de probar | Estrategia funcional de caché implícita y conciliación correcta del uso |
| El tráfico mezcla tareas fáciles y difíciles | Evaluar por clase | Comparar errores, latencia y gasto total de cada clase |
Gemini 4 Hydrogen vs Gemini 3.8 Flash: diferencias de migración
| Área | Referencia de 3.8 Flash | Cambio en Hydrogen | Comprobación de migración |
|---|---|---|---|
| Contexto | Límites separados de 1M de entrada y 64K de salida | Una ventana de 1,048,576 tokens para entrada, razonamiento y salida | Reservar espacio para la respuesta en vez de llenar la entrada |
| Razonamiento | low, medium, high; medium predeterminado en la comparación de Google | Añade xhigh; high pasa a ser el valor predeterminado del proveedor | Configurar explícitamente un valor compatible con la ruta |
| Salida larga | Límite de salida documentado de 65,536 | Long decode puede superar un tramo síncrono de 65,536 tokens | Conservar el estado de continuación y conciliar el uso total |
| Caché | Los clientes antiguos pueden crear y referenciar cachés explícitas | No se admite crear cachés explícitas | Eliminar esa dependencia y medir aciertos implícitos |
| Controles de muestreo | El código existente puede enviar campos de muestreo | Google indica que temperature, top_p y top_k personalizados se ignoran | No asumir que ajustan el comportamiento de Hydrogen |
| Declaración de herramientas | Los envoltorios antiguos de prompts pueden pedir «llamadas a herramientas» como JSON de texto sin formato | Google advierte de que, sin declarar herramientas nativas, puede producirse MALFORMED_FUNCTION_CALL | Declarar funciones o un esquema de salida estructurada y seguir el contrato de la pasarela elegida |
| Historial de herramientas | El estado gestionado por el cliente exige manejo específico del protocolo | Conservar turnos del modelo y firmas de razonamiento según la documentación | Probar varios turnos, no solo la primera solicitud |
El ejemplo más fácil de pasar por alto es el contexto compartido: una solicitud que antes cabía cerca del límite independiente de entrada puede dejar poco espacio compartido en Hydrogen. Por separado, el límite de salida elegido restringe razonamiento y respuesta juntos. Reducirlo no recupera capacidad de respuesta visible cuando el razonamiento la consume. Comprueba tanto el espacio libre de la ventana compartida como el límite configurado, además del motivo de finalización y el uso, antes de atribuir una respuesta más corta a menor inteligencia.
La caché merece su propia prueba de compatibilidad. Un prefijo repetido permite un posible acierto implícito, pero no garantiza que la caché se haya preparado, siga válida o se transfiera entre modelos. Prueba prefijos estables y variables y usa las lecturas de caché observadas. No hagas depender el presupuesto de migración de aciertos hipotéticos.
Compara una tarea completa, no una demostración seleccionada
Una prueba útil contiene tareas que ya ejecutas, criterios de aceptación escritos y un entorno fijo. Los tres ejemplos siguientes son diseños de evaluación, no resultados publicados de modelos.
Programación: un parche que supera ejecución y revisión
Elige un fallo con prueba de regresión, como conservar un filtro al cambiar de página. Fija la revisión del repositorio, dependencias, archivos permitidos e instrucciones. Proporciona a ambos modelos la misma evidencia pertinente, acceso a pruebas y límites de permisos.
Para pasar, debe funcionar el comportamiento esperado sin regresiones inaceptables ni cambios ajenos. Registra pruebas, correcciones del revisor y turnos necesarios para obtener un parche utilizable. Si un modelo imprime una solución elegante rápidamente pero el parche falla, no ha superado a otro más lento cuyo parche se acepta. Compara el tiempo de finalización tras pruebas y correcciones, y separa el tiempo al primer token como medida de respuesta interactiva.
Incluye al menos un caso con evidencia incompleta. No penalices al modelo que pide el contrato que falta en vez de inventarlo; define esa regla de puntuación antes de revisar las salidas.
Extracción: campos correctos y respaldados
Usa una ficha de producto o un contrato de servicio con esquema fijo y referencia etiquetada. Incluye conversión de unidades, campos ausentes y conflictos entre dos versiones del documento. Ambos modelos deben ver la misma fuente y recibir las mismas instrucciones para valores ausentes.
Puntúa por separado precisión por campo y aceptación del registro completo. Un importe crítico incorrecto puede invalidar un registro por lo demás preciso. La validación del esquema es necesaria, pero no comprueba la veracidad. Marca explícitamente las salidas que requieren revisión para no confundir una abstención segura con un registro completado automáticamente.
Agentes: completar herramientas correctamente ante fallos
Prepara respuestas de prueba deterministas para una consulta, un timeout y una denegación de permisos. Registra argumentos válidos, operaciones completadas y respuestas finales veraces. Planear una llamada no equivale a completarla, y un resultado ficticio tras un timeout debe fallar.
Mantén las herramientas de evaluación en modo de solo lectura o simuladas. En una prueba en sombra, no dupliques pagos, devoluciones o avisos al cliente porque ambos modelos los propongan. La aplicación debe imponer idempotencia, autorización y responsabilidad de ejecución con independencia del modelo.
Haz comparables las configuraciones sin ocultar las diferencias
Ejecuta dos comparaciones complementarias. Primero, evalúa la configuración que desplegarías realmente en cada modelo. Eso responde a la decisión de producción. Después, si es compatible, aproxima el nivel de razonamiento y los límites de tarea para investigar por qué cambió el comportamiento. Informa de ambas configuraciones; no las llames idénticas solo porque un campo tenga el mismo nombre.
Una respuesta Hydrogen en low y otra de 3.8 en high pueden servir para comparar políticas de producto, pero no para afirmar de forma controlada cuál es más rápido con el mismo razonamiento. Los valores predeterminados son especialmente peligrosos: el cambio documentado por Google de medium a high modifica el experimento de forma silenciosa.
Congela el conjunto de tareas antes de ver los resultados. Separa casos fáciles, habituales y propensos a fallar. Vincula los pesos a su frecuencia en producción o declara que se trata de un conjunto diagnóstico sin ponderar. De otro modo, añadir muchos ejemplos fáciles puede esconder regresiones en un flujo poco frecuente y caro.
| Registro de evaluación | Qué guardar | Por qué importa |
|---|---|---|
| Tarea y referencia | ID de tarea, versión de entrada, resultado esperado, reglas de error crítico | Mantiene estables etiquetas y alcance |
| Contrato de solicitud | Modelo solicitado, identidad devuelta si está disponible, canal, razonamiento, presupuesto, herramientas | Expone cambios de valores predeterminados y rutas |
| Resultado | Aceptación inicial, aceptación final, categoría de fallo, estado de revisión | Impide sustituir corrección por estilo |
| Tiempo | Primer token, fin de generación, momento del resultado aceptado | Separa respuesta interactiva y tarea completada |
| Uso | Entrada sin caché, lecturas de caché, salida visible, razonamiento, búsqueda y reintentos | Permite conciliar toda la factura |
| Contexto de despliegue | Versión de aplicación, datos de prueba de herramientas, concurrencia y timeout | Hace reproducibles los cambios |
Repite las tareas variables cuando sea necesario e informa de su variación. Una muestra pequeña puede detectar una regresión obvia, pero no demuestra una latencia estable en la cola de la distribución ni una tasa de errores raros. Decide el tamaño y la ventana de producción según el fallo que necesites detectar. Registra las medidas ausentes como ausentes, no como cero.
Calcula el umbral de coste para trabajo aceptado
Como referencia del proveedor con fecha, las tarifas Standard de Google comprobadas el 12 de noviembre sitúan Hydrogen en $1.50 por millón de tokens de entrada y $7.50 de salida, frente a $0.75 y $3.75 de 3.8 Flash hasta el 31 de diciembre de 2026. Ambas tarifas actuales son el doble, pero eso no demuestra que el coste por tarea se duplique. Google publica para 3.8 tarifas de $1.50 y $7.50 desde el 1 de enero de 2027. Revisa el periodo de vigencia, la caché y las condiciones de herramientas; son tarifas de referencia del proveedor directo, no precios de una cuenta EvoLink.
Usa una definición consistente:
Coste API por tarea aceptada = todo el gasto API y de herramientas del lote / tareas aceptadasEl numerador incluye intentos fallidos, reintentos y llamadas a modelos alternativos. Cuenta cada ID de tarea original como máximo una vez en el denominador. Separa las tareas completadas de aclaraciones o revisiones seguras pero sin finalizar, salvo que el contrato escrito de antemano defina esa resolución como el resultado completado. Si el denominador es cero, el resultado no está definido, no es una ganga. Informa de la proporción de tareas aceptadas: rechazar solicitudes difíciles puede abaratar una política sin entregar trabajo equivalente. Si importa la corrección humana, informa por separado del coste combinado usando el mismo precio unitario del trabajo, por ejemplo dólares por minuto de revisión, pero con la frecuencia y el tiempo de revisión observados en cada ruta.
| Escenario para 1,000 tareas entrantes | Gasto total API/herramientas | Tareas aceptadas | Coste por tarea aceptada |
|---|---|---|---|
| Referencia funcional | $8 | 800 | $0.0100 |
| Candidato A | $12 | 960 | $0.0125 |
| Candidato B | $9 | 960 | $0.009375 |
El candidato A consigue más tareas aceptadas, pero no es más barato por tarea aceptada. Aun así, puede valer la pena si la cobertura adicional es valiosa; es una decisión de negocio, no una afirmación de ahorro. El candidato B mejora ambas métricas bajo las hipótesis indicadas. Ninguna fila predice el comportamiento real de un modelo.
c_H / a_H < c_F / a_F, donde c es el gasto medio API/herramientas por tarea entrante y a la proporción aceptada con los mismos criterios. Usa gasto real de todo el ciclo. No pongas en c el precio de una sola respuesta si la política incluye varios intentos.Concilia también las categorías de tokens. Si el uso del prompt informado incluye aciertos de caché, réstalos antes de introducir la entrada sin caché en la calculadora. Si el razonamiento ya está dentro de completion_tokens, no lo sumes dos veces. Los campos de uso nativos y compatibles necesitan mapeos separados a las mismas categorías contables.
Pasa por reproducción, sombra y un despliegue canario reversible
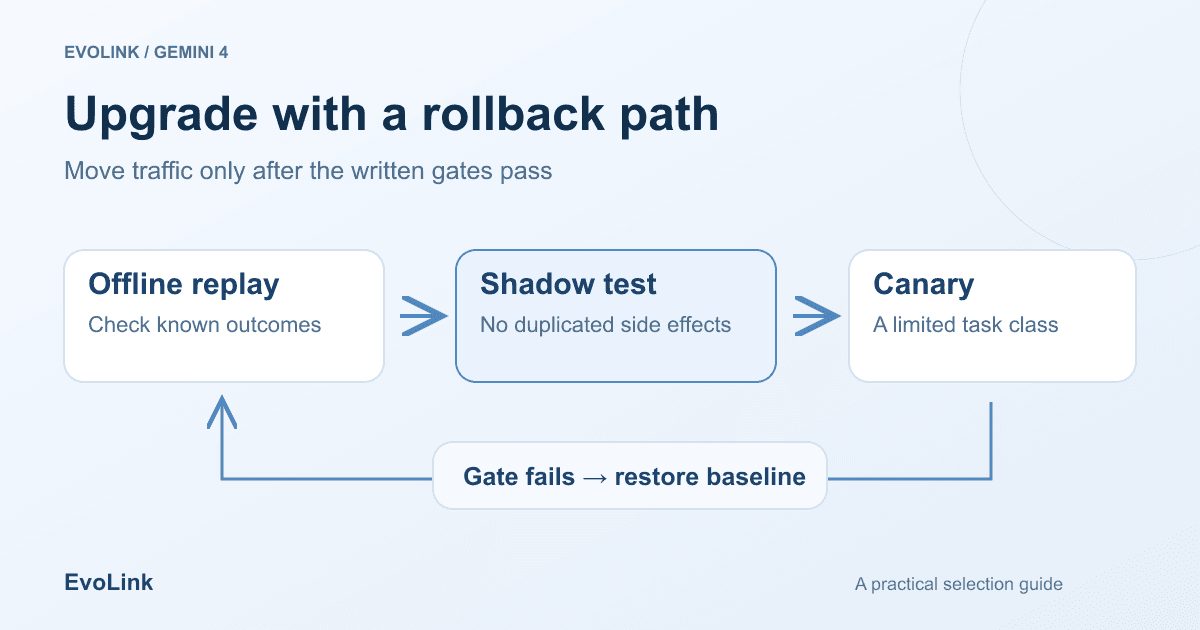
La API unificada de EvoLink reduce la integración necesaria para mantener disponibles varias opciones de modelo. La aplicación sigue siendo responsable de evaluación, reparto del tráfico y reglas de alternativa. Esta guía no implica una migración automática ni una política incorporada que elija siempre el modelo exitoso más barato.
¿Qué justificaría seguir con 3.8?
Conserva 3.8 si cumple la aceptación y el candidato añade coste o riesgo sin una mejora sustancial. Es especialmente razonable en cargas estables con poco margen de precisión restante, presupuestos de latencia sensibles al razonamiento o clientes cuya caché y estado necesitan cambios antes de migrar.
Preguntas frecuentes
¿Hydrogen es mejor que Gemini 3.8 Flash?
Google recomienda actualizar, pero este artículo no establece un ganador universal. Evalúa resultados aceptados, fallos críticos, tiempo de finalización y coste completo del ciclo en tu tarea.
¿Tengo que migrar inmediatamente después del lanzamiento?
Aquí no se establece un plazo de migración. Conserva una referencia funcional mientras validas al candidato y comprueba de forma independiente cualquier aviso de retirada del proveedor.
¿Basta con cambiar el ID del modelo?
Inicia la selección, pero no resuelve presupuesto de contexto compartido, razonamiento predeterminado, cachés explícitas, estado de herramientas ni salidas largas. Verifica todo con el protocolo elegido.
¿Puedo comparar con el razonamiento predeterminado de cada modelo?
Sí, si comparas las políticas de despliegue previstas e informas de la diferencia. No es un benchmark con ajustes iguales. Fija niveles explícitos para una comparación adicional controlada donde sea compatible.
¿Puedo reutilizar una caché explícita creada para 3.8?
No dependas de ello: la guía de migración de Hydrogen elimina la caché explícita. Valida el comportamiento implícito de tu pasarela y concilia el uso real de caché.
¿Un stream más rápido significa terminar antes la tarea?
No necesariamente. Pruebas, herramientas, reintentos y revisión pueden dominar la espera. Separa el tiempo al primer token del tiempo hasta un resultado aceptado.
¿Cómo evito contar dos veces el razonamiento?
Mapea el uso a las categorías facturables del protocolo. El razonamiento desglosado dentro de completion_tokens ya forma parte del total. Suma el razonamiento nativo separado solo cuando no esté incluido en el recuento de salida visible.
¿Qué debe activar una reversión?
Incumplimientos predefinidos de los límites de error crítico, calidad, coste por tarea aceptada o tiempo de finalización. Restaura el modelo anterior y su configuración compatible e investiga con logs por tarea.
Fuentes y notas de verificación
- Guía de migración de Google Hydrogen: valores predeterminados, caché y contexto del proveedor.
- Especificaciones de Google Hydrogen: límites y capacidades del modelo nuevo.
- Especificaciones de Google 3.8 Flash: referencia de su predecesor.
- Precios de Google Gemini API: referencia comercial específica del canal.
- Referencia de la API nativa Gemini de EvoLink: contrato de solicitudes de la pasarela.
Comprobado el 12 de noviembre de 2026. Los diseños de tareas, umbrales y ejemplos en dólares son orientación analítica, no resultados de pruebas controladas de modelos. Durante el despliegue, usa las tarifas actuales de tu cuenta EvoLink y los controles compatibles con la ruta elegida.